





|
关于ST库函数的代码性能对比 前言' S9 B8 |4 z' z, F! V' F8 b ST已经推出了三种库函数,用以方便客户快速开发STM32系列的MCU。从最早的标准外设驱动库,到后来的Cube HAL,再到 Cube LL,还有直接写寄存器。这几种库的代码效率到底如何呢?本文将针对这个问题进行分析和对比,最后提供对比数据供大家参考。 问题分析 我们以GPIO翻转、TIM PWM 输出、ADC DMA 数据采集和DMA M2M这四个常用功能,通过不同的库函数来实现,最终来对比各个库函数的性能。四个工程代码的内容简述如下: W0 Y4 F6 G" k8 q% z. ?% z; @9 z GPIO翻转:切换GPIO的输出电平,其中包含了系统时钟初始化和GPIO翻转的代码。& _; T" V3 b4 z2 v% h5 z TIM PWM输出:通过TIM1 的通道1输出频率是36KHz的PWM,循环修改其占空比从25%到50%,其中包含了系统时钟初始化、TIM1的初始化和切换占空比的代码。; i- Z, W4 W/ }% y! X ADC DMA数据采集:通过ADC的模拟通道1,采集100次ADC的结果,并使用DMA传输到到用户缓冲区,其中包含了系统时钟初始化、ADC初始化和DMA的初始化的代码。- d" z! B! D/ S. }, k DMA M2M:使用DMA1的通道1,从Flash中传输100字节的数据到片内的SRAM中。其中包含了系统时钟的初始化和DMA的初始化代码。- L4 }7 ~3 r; ~/ D/ c8 x 主要对比三个参数:Flash 占用量、SRAM占用量和执行代码的效率。 Flash和SRAM的占用量可以通过查看IAR生成的*.map文件了解到。 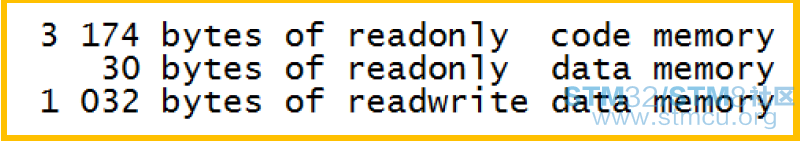
在*.map文件中,会有如上图的内容,其中的readonly code memory加上readonly data memory的和,就是Flash的占用量。而Readwrite data memory的大小即为SRAM的占用量。那么上图所示的Flash占用量即为3204=3174+30,SRAM占用量即为1032。因用户堆(Cstack)我们设置的为1024,所以真正应用代码所占用的SRAM量为8=1032-1024. 代码的运行效率部分,我们是通过IAR提供的内核运行周期数(CYCLECONTER)来计算的。在功能函数的开始处和结束处分别设置断点,两次内核运行周期数的差值,就是此处代码的运行周期。 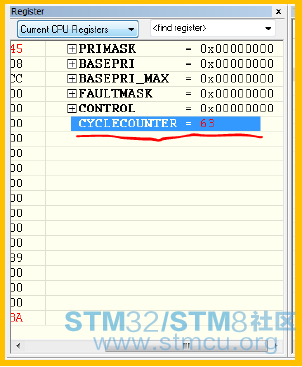
测试硬件选用了Nucleo-F302评估板。' g4 m7 z: r! }9 Y9 ~# y; e 软件环境和库函数详情如下:5 S/ O! x; C* T6 z. n/ d) E • IAR V7.60 • Optimizations Level High (Size)7 T+ w! u7 V0 c( O5 W! ~ v1 [# _ • STM32CubeMX V4.17 • Create Project with Copy the necessary library files- C2 M$ T% s/ \- Y+ P9 P4 I- k • STM32CubeF3 V1.60: E4 d' H8 P/ T l5 W3 x • STM32F30x_DSP_StdPeriph_Lib_V1.2.3 • STM32F3xx CMSIS V2.3.0 测试结果如下: 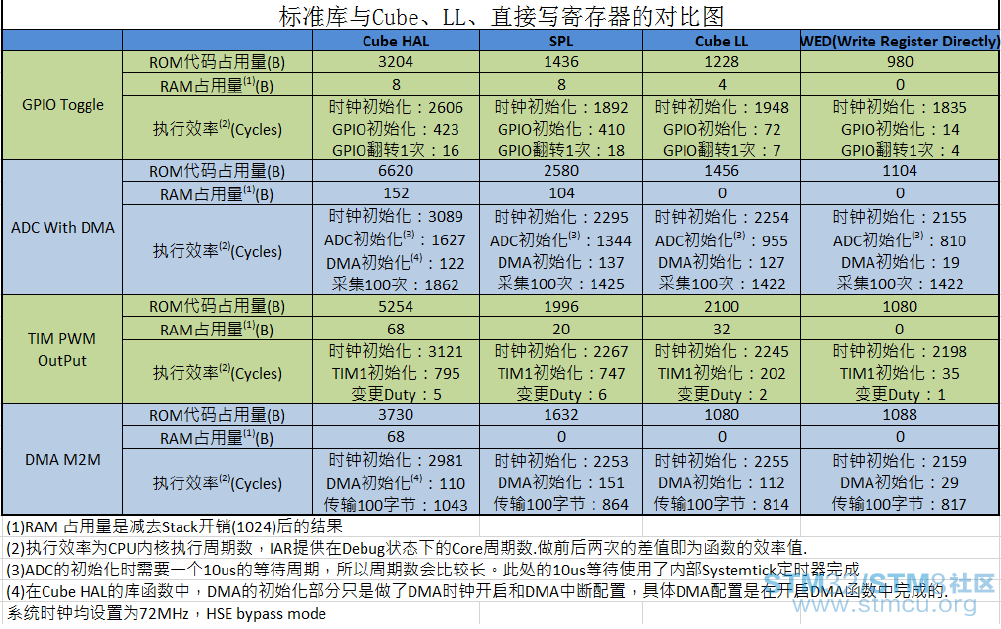
总结: 总体来看,代码效率与移植性成反比的规律是明显的。但与Cube HAL相比, Cube LL的效率优势还是很明显的,几乎和直接写寄存器的效率相差无几。而且目前STM32cubeMX已经开始支持直接生成使用Cube LL的工程,对于以后追求效率的开发应用人员来说,非常值得推荐给大家使用。 , x9 c0 [# U7 M3 ]& k# F  STM32åºå½æ°æ§è½å¯¹æ¯.pdf
(240.74 KB, 下载次数: 66) |
 微信公众号
 手机版


移植性对比:
按我的理解,Cube HAL还是主流,Cube LL是Cube HAL的有效补充,并不是说在小容量MCU上HAL就不能用,而是说,根据实际项目需求适不适合的问题。Cube HAL依然是ST的主流。
0 V& K" |% H4 h5 N, }0 q' B- E3 Z3 q
第一次听到CUBE LL。1 f, \ w& ^( e8 _& i
HAL库会不会被放弃?
---------------------------------
搜了下,还发现了个STM32Snippets,这又是个啥?
请问此类文有没有出处?
,谢谢楼主,支持分享, ^5 X, g! c5 ^1 Q) ~% y- Y% ^* f