




|
本帖最后由 QianFan 于 2015-12-5 16:43 编辑 5 k* n7 b+ j- q9 F * Q8 D/ ?/ ?! m/ ?( `9 Z% S 看了creep发的一篇帖子https://www.stmcu.org.cn/module/forum/forum.php?mod=viewthread&tid=602444&highlight=hardfault,讲解的是如何找出程序中的HardFault。creep的帖子中提到了一个老外的链接http://blog.feabhas.com/2013/02/developing-a-generic-hard-fault-handler-for-arm-cortex-m3cortex-m4/,讲解的是如何使用keil mdk找出因除0导致的HardFault。keil mdk自然是挺好用的,可是linux下开发调试和windows下开发调试稍有不同。下面就在linux环境下讲解一下如何进行调试。" V% N- I$ n1 }7 C7 \ 工程使用的是硬件浮点。要注意的是,如果是小数除法,不管是不是打开了DIV_0_TRP,结果在使用printf输出的时候都是inf。只有整数除法在开启DIV_0_TRP的时候,才会触发HardFault。下面是main函数的测试代码:
将代码编译好之后,使用gdb进行调试。先在HardFault_Handler处点一个断点:之后输入continue。使代码继续运行。这时候,在开启' V% ^. i0 x; ]( ?# y/ Z, q. t0 ^ DIV_0_TRP之前,进行除0运算的结果是0。没有引发HardFault。当开启了DIV_0_TRP之后,进入了HardFault。这时候可以使用info reg查看一下相关的寄存器。& D" N2 T8 ]- o* r 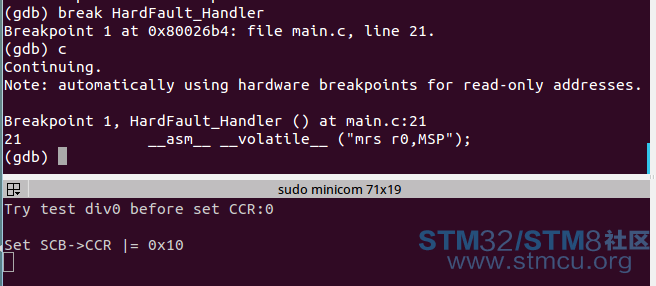
查看reg发现LR寄存器的数值是0xFFFF_FFF9。具体为什么是这个值,可以查看creep的原帖。7 L/ h+ r h6 I$ G 
进入中断之后,需要知道是什么原因导致了HardFault。有两个相关的寄存器。分别是SCB->HFSR, SCB->CFSR.他们的地址分别是0xE000_ED2C,0xE000_ED28.使用x命令查看这两个地址:(从0xE000_ED28出查看了两个字)。关于这两个寄存器的详细解释请参考网址:HFSR和CFSR。说明问题是由除0导致的。具体导致这个HardFault的地址在入栈的PC处。: Y8 s, B0 O, h. M2 u& t 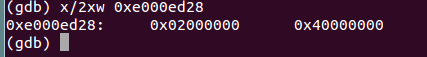
! ~$ A s6 K/ i9 |: c8 Q+ c 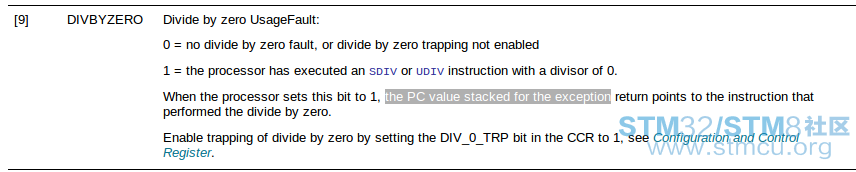
从info reg的信息中,我们可以找到进入HardFault的时候栈的地址。同样,使用x命令从sp的地方读取几个字看看:ARM在发生异常的时候会在SP中将R0-R3,R12,LR,PC,PSR进行压栈。只要我们找出栈中的PC,这个值也就是导致异常的代码处。你可能会从0x2000_FFF0开始数,认为他是R0。但是在ARM GCC中,这样是不对的。 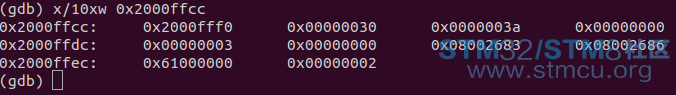
3 o: i& U3 v2 n- _! H) H- a " }9 A* k, w6 s- N. j( ] 使用disasseble查看当前位置的汇编代码:发现在当前的位置(也就是图中=>指向的位置)之前,已经发生过一次push了。因此sp中最新的一个数据应该是push的R7。所以x/10xw读出来的第一个数据是进入HardFault之后push的R7。从0x30处开始的数据才是进入中断之前自动压栈的。这样说,读出的PC也就是0x0800_2686. 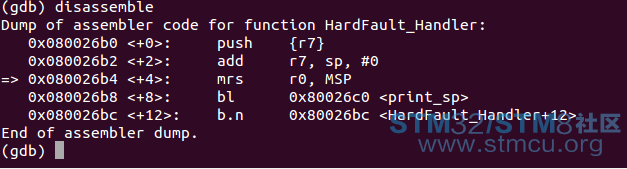
0 N1 Y* e' l" @* ?, N+ x 对elf文件进行反汇编,查看0x0800_2686处的指令:从这个地方可以找到我们的硬件除法的指令。因为除0导致的HardFault。2 Q3 A% H& \; Y/ _) Z$ ]1 s 
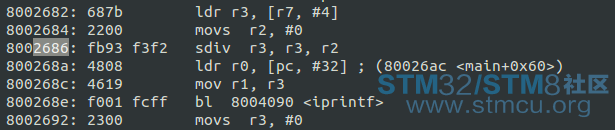
& j9 a( V0 ~$ K! W7 X5 M& W% J3 l 整个Makefile的工程在附件中可以下载。3 ]. M# c. B" ~0 \+ U: v1 g 另外,感到ARM GCC比较任性。看HardFault_Handler的代码,因为代码最后是一个死循环,代码索性连之前push的R7也不pop了。8 t& d1 Q) F6 L7 y+ _ |

div0_hardfault.zip
下载594.59 KB, 下载次数: 38
 微信公众号
 手机版


谢谢分享
https://www.stmcu.org.cn/module/forum/thread-603753-1-1.html