




|
机器学习算法数不胜数,要想找到一个合适的算法并不是一件简单的事情。通常在对精度要求较高的情况下,最好的方法便是通过交叉验证来对各个算法一一尝试,进行比较后再调整参数以确保每个算法都能达到最优解,并从优中择优。但是每次都进行这一操作不免过于繁琐,下面小编来分析下各个算法的优缺点,以助大家有针对性地进行选择,解决问题。" j6 y+ K8 B6 Q7 _ 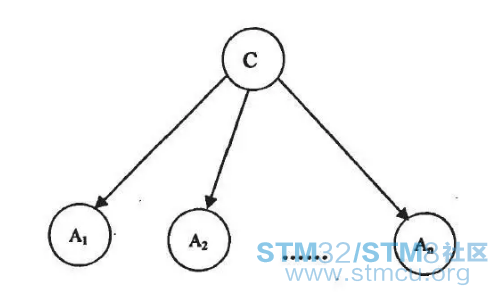
1.朴素贝叶斯; o6 K4 k( f+ @% Y3 _6 U) N* v $ s8 z! Q0 k6 z" r- v" v6 c, h' b- k. q! l 朴素贝叶斯的思想十分简单,对于给出的待分类项,求出在此项出现的条件下各个类别出现的概率,以概率大小确定分类项属于哪个类别。 7 d& ]$ R) M, _) U) O! W 优点: 7 w: w/ G+ Q; `8 W* d4 O. ^ 1)朴素贝叶斯模型发源于古典数学理论,因此有着坚实的数学基础,以及稳定的分类效率; 2)算法较简单,常用于文本分类; : A% D- R; b! N, P/ j4 I 3)对小规模的数据表现很好,能够处理多分类任务,适合增量式训练。 / q8 D" o: h9 e8 U" D# F. {$ H 缺点:, p" |6 d) G$ @ % U. j; P+ f% h0 x% L2 B 1)需要计算先验概率; 2)对输入数据的表达形式很敏感; 3)分类决策存在错误率。3 b3 {, T" ? n- [+ ^( @ 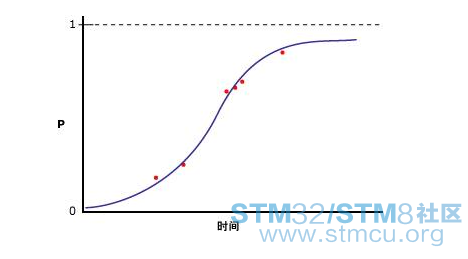
2.逻辑回归 6 ?7 ?5 l# A8 Q4 N) h. `: Y0 \ 优点: 1 n' M8 a# [1 X7 r& r! [ 1)实现简单,广泛地应用于工业问题上; ) v0 b& L6 Y j, p" s 2)可以结合L2正则化解决多重共线性问题;% [$ E1 B: b8 T7 `% a" b7 U3 v7 S 3)分类时计算量非常小,速度很快,存储资源低;" F% F! q+ i3 M K5 w! ~ : D, I: j) }8 e3 b: f 缺点:: i* G! N$ z" Z 1)不能很好地处理大量多类特征或变量;) h! P8 |2 \: `4 i 2)容易欠拟合,一般准确度较低;- T& ?9 |5 r6 d* Y1 _- t( P 3)对于非线性特征,需要进行转换;+ w( Y0 z' ?9 D; C" \ 4)当特征空间很大时,逻辑回归的性能不是很好;+ p5 k" {0 l; P" M" T3 K 5)只能处理两分类问题(在该基础上衍生出来的softmax可以用于多分类),且必须线性可分。, O: J& t! H5 ]( b7 w* G- o/ Q+ ~ 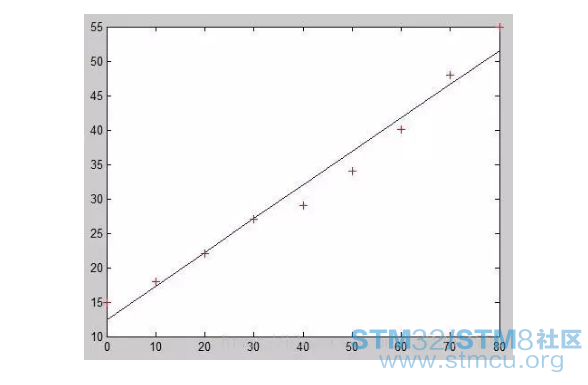
3.线性回归) K- X6 L% {/ n4 E* F; y 0 B4 a6 Z1 n! `) p5 i线性回归与逻辑回归不同,它是用于回归的,而不是用于分类。其基本思想是用梯度下降法对最小二乘法形式的误差函数进行优化。& A g1 G/ y* s" ?1 D) m 优点:实现简单,计算简单; 缺点:不能拟合非线性数据。5 E4 i1 b" @ o9 l4 y- R$ U 4.最近邻算法" t/ `/ c0 I& t# L7 D, T$ U6 B + G5 V0 p7 h+ s+ V& P+ {- P 优点: 2 r! `& O! t8 {3 @; c 1)对数据没有假设,准确度高; 2)可用于非线性分类; 3)训练时间复杂度为O(n); % K. x. Y5 ?6 O 4)理论成熟,思想简单,既可以用来做分类也可以用来做回归。 / b* d8 Q- D% V 缺点:* z7 f3 S3 ?7 c; G \. D8 c/ o ^+ e2 c5 S4 ~( l8 b 1)计算量大;) Z# }4 h1 c# X$ r3 t) [ 2 l3 Q3 q! |) X ]/ T 2)需要大量的内存;2 u9 S+ P) ?# I0 X. a- g+ y: U 3)样本不平衡问题(即有些类别的样本数量很多,而其它样本的数量很少)。, g; R/ }8 J3 `, ~: R9 H 
5.决策树; W" y* S. b1 f : q6 d5 A* q9 w1 J/ R% T; `, H3 c( A1 ^2 } 优点:* I2 k* _5 H7 H* ^% C7 Z' i * K7 ?( H1 G5 p: H" J) K 1)能够处理不相关的特征;" Z* ?/ t) Z+ t6 O9 P2 _ 7 Y- I/ x% p4 ?. G9 o- | 2)在相对短的时间内能够对大型数据源做出可行且效果良好的分析;$ N, m P$ g$ d& v, E 3)计算简单,易于理解,可解释性强; 4)比较适合处理有缺失属性的样本。* ^, Y2 I9 O% B# w+ ^2 f$ N# d 4 j9 ]* b- f' d3 z9 | 缺点:' Y9 v: P8 T3 I7 E ? $ }% F( H; d, K. q" \ 1)忽略了数据之间的相关性;/ b* o; a" Y: _ 2)容易发生过拟合(随机森林可以很大程度上减少过拟合); 3)在决策树当中,对于各类别样本数量不一致的数据,信息增益的结果偏向于那些具有更多数值的特征。 |
学习了 |
卧槽,感觉有点太高级啊!!! |
 微信公众号
 手机版


