




|
对于每天奋斗在一线,用Java,C++,C#,Python等高级编程语言写程序的程序员们来说,理解编译器是如何将高级语言编译成汇编语言,有助于我们更好的理解计算机编程。 编译器将高级语言转化成汇编语言主要经过三个步骤:词法分析、语法分析、语法树解析。 7 @( V, N; Q7 m2 z3 R3 y' q本文用简洁易懂的方式描述了这一过程,相信不需要很深的计算机背景知识,也能轻松读懂本文。 第一步:词法分析 最开始的时候,高级语言编写的程序对编译器来说只是一连串的单个字符组成的字符串。为了让编译器识别这一连串的字符串,需要逐个字符的读取源程序,然后将其切分成有意义的单词,这些被切分后的单词在编译器眼里是以 <标识,语义值>对的形式存在。 为了从源程序字符串中依次找出单词,编译器需要具有扫描功能,通常这种扫描器可以用一组有限状态机来实现。为了说明有限状态机是怎么一回事,下面给出一个实例。 下图为一个识别数字的有限状态机,数字由整数部分和可选的小数部分组成。因此,根据这个有限状态机,250和3.14159都能被识别成一个有效的数字。 3 }9 m7 Z& S* H: b7 g2 v# X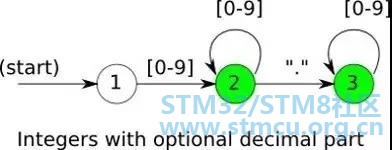
图一:有限状态机4 k* A6 x! D# w1 ]/ ^. m0 P : Y% l4 }2 v2 u+ [! q" y2 G, g绿色的结点用环形标志,表示他们是“可接受”的状态,也就是说,只要我们的状态达到了绿色的结点,就表示我们之前读取到的数据是一个有效的数字。例如,从图中的start处开始,如果我们读到的数字是42.15,那么依次经历的状态是(1,2,2,3,3,3),由于这一系列状态最终以“可接受”的状态结束(也就是图中的状态3),因此我们就读取到了一个有效的数字。而且读取到的数字42.15用<标识,值>对的形式表示成<NUMBER,42.15>。这里的NUMBER是用于标识我们读取到的内容是一个数字,而文本“42.15”是标识对应的语义元素值。 我们可以用为不同类型的单词定义不同的类似上述的小状态机,例如变量名可以由字母、下划线组成,操作符可以取+=、->,关键字则可以是“if”“while”等单词,类型则可以是“int”“char”等等单词。为每一类单词构造一个小的有限状态机,最终组成一个可以接受不同类型单词的大状态机。可以用表的形式存放我们得到的大状态机。至此,我们通过构造一个大状态机得到一个能识别各类单词的自动扫描器。 至此,第一步大功告成,这一步我们通常称之为“语法分析”阶段。 3 \0 x+ q g" b. c高级源程序通过语法分析后,我们得到的结果是<标识,值>对,以方便后续处理。 `; y% c" v. G3 h为方便理解,这里举个简单的例子。 比如,我们程序语句: # J7 d* Z0 u2 c9 Uif ( x == 2 ) { x = a + b; } 通过词法分析后,得到<标识,值>对如下:* ~( x4 j% Y% X5 O3 M5 n( Y: ] 2 k; o- L% X% W. @' f* [! J" d (KEYWORD,”if”), (IDENTIFIER,”x”), (OPERATOR,”==”), (NUMBER,”2″), (DELIMITER, “{“), (IDENTIFIER,”x”), (OPERATOR,”=”), (IDENTIFIER,”a”), (OPERATOR,”+”), (IDENTIFIER,”b”), (DELIMITER,”;”), (DELIMITER,”}”). 第二步:语法分析完成了“词法分析”后,接下来就是激动人心的“语法分析”阶段。通过语法分析得到语法树。 ! J( m" U; v" ?/ ]9 f, |例如,对于第一步中的程序语句if ( x == 2 ) { x = a + b; }。我们得到的语法树如下图所示。 ( C2 U* l5 g$ ]3 r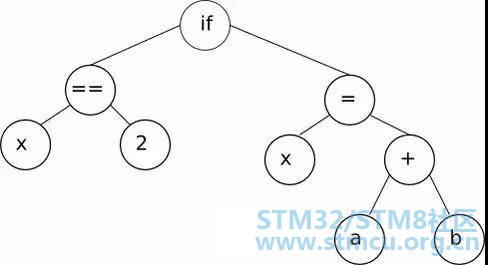
图2:语法树 f! [& u4 F: U8 R0 t( n3 O, K Y1 f9 g# s0 h. k# I9 d% l- z# u- _生成语法树的方法有很多,这里只介绍一种最简单的方法:预测分析法(predictive parsing)。具体做法是:从数据流的一端开始扫描,用占位符为所有之前没遇到的元素创建一个临时语法树,然后依次读取后续的数据来填充完这颗语法树。(听起来可能很抽象,请看下面的实例) f% r- E% [- ^" [ z* d4 O对于图2的语法树,具体生成过程如下: 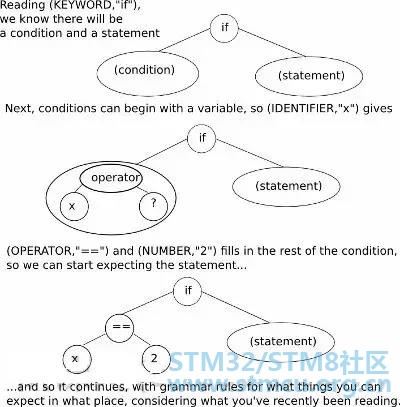
图3:语法树生成实例 ' A$ F( B8 `( ~* c5 s后续的statement部分可以同理生成,这里略去。 + O/ S; }" ]& k; y/ g4 m# B! O第三步:翻译语法树5 Q% |, ~9 @2 S! Q# W$ y 有了语法树后,我们接下来要做的事情是构建符号表,以便确定各个元素在存储器中的存放位置。 0 B3 h$ P( ~$ f" o具体做法:遍历语法树,将语法树中不同的变量依次取出,放入可用的存储位置。编译器自己决定如何分配存储位置 。 / s2 J3 D) ]/ ^具体过程可以用下图表描述: 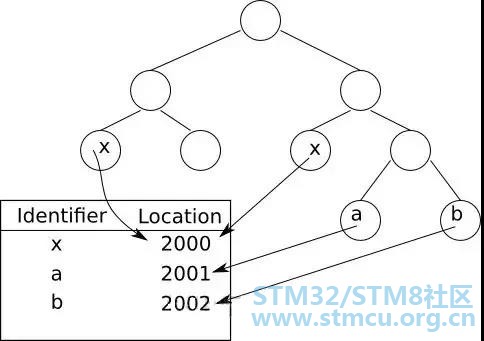
图4:为变量分配存储地址7 @+ z& [, d) X1 i# j 语法树中多次出现的变量指向同一地址。从上到下,从左往右依次遍历语法树,遇到一个if结点,执行if相关的操作,遇到赋值结点,执行赋值相关的操作,详细步骤如下所示: 1 o, `: \7 i/ G, [3 \: n首先,寻找最小表达式,如下图中绿色、蓝色圈中的即为一个最小表达式。 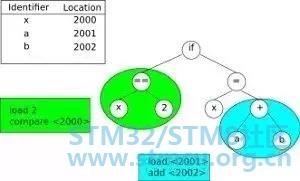
图5:寻找最小表达式 8 i. u0 W7 a; w, S1 N' Z接下来,将最小表达式与其周边的表达式合并。 . N X- G2 m) C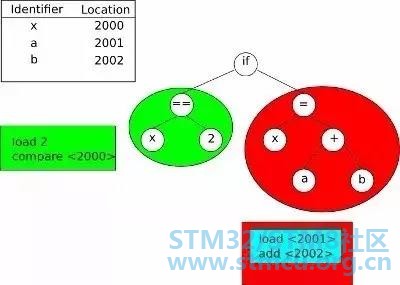
图6:表达式合并 最后,将所有的表达式有序的进行合并,得到最终的汇编语言描述,如图7所示。 * g6 a2 ]3 T1 X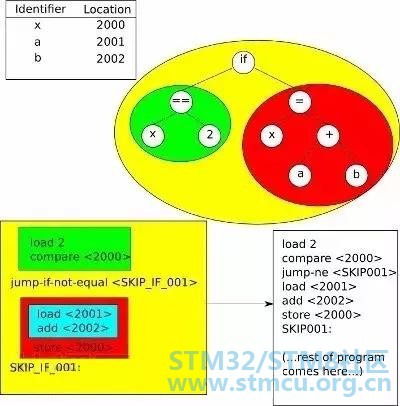
图7:最终生成的汇编语言 % u2 \. ^6 {1 M% ?至此,我们便将高级语言翻译成了汇编语言。 |
 微信公众号
 手机版


