




|
什么是内存对齐 元素是按照定义顺序一个一个放到内存中去的,但并不是紧密排列的。从结构体存储的首地址开始,每个元素放置到内存中时,它都会认为内存是按照自己的大小(通常它为4或8)来划分的,因此元素放置的位置一定会在自己宽度的整数倍上开始,这就是所谓的内存对齐。 以一个例子开始了解 理论上,int占4byte,char占一个byte,那么将它们放到一个结构体中应该占4+1=5byte;但是实际上,通过运行程序得到的结果是8 byte,这就是内存对齐所导致的。 #include<stdio.h>struct{, f6 J. f4 x/ d int x;, ]- p5 e4 A- k. _; Q1 p% I0 y char y;- E0 F+ j; Q- [" e }Test; int main()6 S- c0 e3 B" ^. n. z) I/ w { printf("%d\n",sizeof(Test)); // 输出8不是5/ Q Z. M5 R3 U* u return 0; } 为什么要内存对齐
#include<stdio.h> struct7 }, U6 U- h6 U" M7 Q; ~+ a { int i; char c1; char c2; }Test1;) Y7 |& ~% a- w) u6 G, W4 @7 d struct{* H2 ?7 G; w( p% s+ f% p8 @9 ^ char c1; int i; char c2; }Test2;% P# w1 N7 g8 w2 O6 P6 `& T( R 6 o0 o' l6 _( O3 ^( y struct{5 C4 @5 I6 P" K# D/ _ char c1; char c2; int i;$ k' g) Z0 h2 q& s n: Z }Test3;( [. y( k' X& T0 j / N3 c, l) a D3 ` int main() {, r0 d1 ]* c5 S" d printf("%d\n",sizeof(Test1)); // 输出8 printf("%d\n",sizeof(Test2)); // 输出12 printf("%d\n",sizeof(Test3)); // 输出8 return 0; } 默认#pragma pack(4),且结构体中最长的数据类型为4个字节,所以有效对齐单位为4字节,下面根据上面所说的规则以第二个结构体来分析其内存布局:首先使用规则1,对成员变量进行对齐:
然后使用规则2,对结构体整体进行对齐: 第二个结构体中变量i占用内存最大占4字节,而有效对齐单位也为4字节,两者较小值就是4字节。因此整体也是按照4字节对齐。由规则1得到s2占9个字节,此处再按照规则2进行整体的4字节对齐,所以整个结构体占用12个字节。 根据上面的分析,不难得出上面例子三个结构体的内存布局如下: 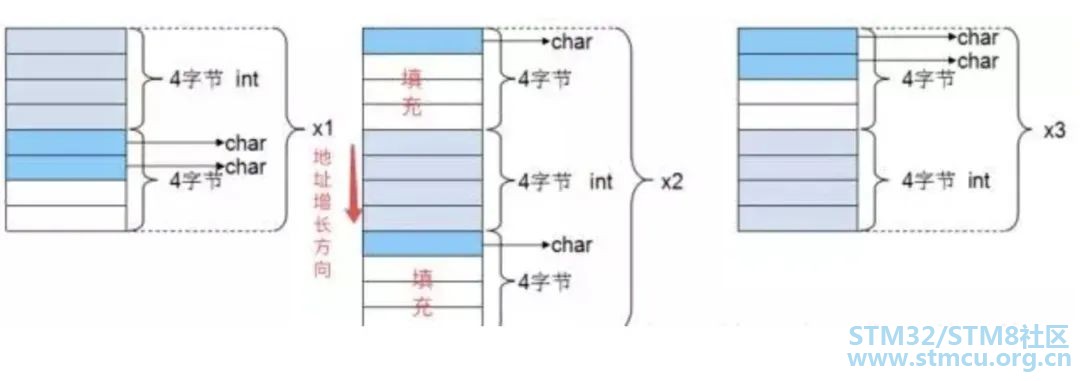
更改C编译器的缺省字节对齐方式:
不同平台上编译器的 pragma pack 默认值不同。而我们可以通过预编译命令#pragma pack(n), n= 1,2,4,8,16来改变对齐系数。 例如,对于上个例子的三个结构体,如果前面加上#pragma pack(1),那么此时有效对齐值为1字节,此时根据对齐规则,不难看出成员是连续存放的,三个结构体的大小都是6字节。 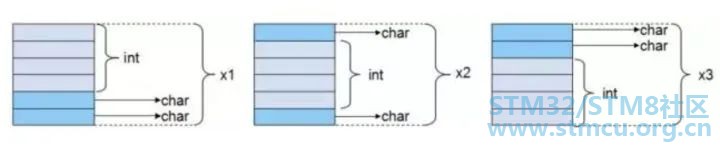
如果前面加上#pragma pack(2),有效对齐值为2字节,此时根据对齐规则,三个结构体的大小应为6,8,6。内存分布图如下: 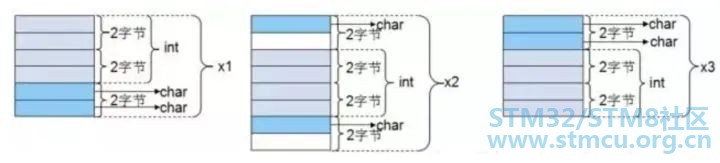
请写出以下代码的输出结果: #include<stdio.h>struct S1 {: a3 m$ Z7 V1 A8 m/ d6 W int i:8; char j:4; int a:4; double b; }; struct S29 V6 j: d; R1 k {) y" D: R% E4 j: C int i:8;* T- a3 E) D6 G( P char j:4; double b;; t2 Z# O' z4 n/ n2 L# R5 N int a:4; }; struct S3 { int i;6 ]7 a/ i4 G7 w4 ` char j;1 {5 M! N6 D+ v' ] double b; int a; }; 5 q+ \$ y: c* K9 ?8 q" ] z int main()" C8 F. V/ n$ T9 j# I- v# G" _ {! A8 v$ M3 s3 s5 s# A2 [# ]1 p! H printf("%d\n",sizeof(S1)); // 输出8 printf("%d\n",sizeof(S1); // 输出12: J: h; Y2 h' f( S1 B printf("%d\n",sizeof(Test3)); // 输出8 return 0; }5 W) [8 e4 j* c% H- u- p! h 分析问题 在存储某些数据时,其实际需求的数据长度可能要小于一个字节,只占一位或几位。为了节省空间,处理方便,在C中引入了另一种结构,称为“位域”或“位段”。 所谓“位域”,就是把一个字节中的“位”按照实际的需求分成不同的区域,表明每个区域位数、区域的域名,并允许程序按照域名进行操作。如此就可以把不同的对象用一个字节来表示。 位域的定义与结构定义相仿,其形式为: struct 位域的结构体名* H( x% U) ~. p' \7 D( x. d6 k3 M{+ ^5 L# D4 C7 \$ \ //位域列表 }$ N3 j5 r* U* A" v* S9 Y. j 位域列表的形式为:【类型说明符】 【位域名】:【位域的长度】例如: struct ab{0 e# U) @1 \0 ^% B8 y8 N2 f7 S int a:8; int b:2; int c:6;% k$ ^! }8 Z1 t }8 S' M- G7 T8 J; ~ 对于位域的定义,有以下几点说明: (1)一个位域必须存储在同一个字节中,不能跨两个字节。如一个字节所剩空间不够存放另一位域时,应从下一单元起存放该位域。也可以有意使某位域从下一单元开始。 例如: struct wy* g9 X- I9 |( Q5 u" X% P$ L _) _% c{* s2 S) H5 \) c8 t% E unsigned a:6;; w( ~- t( c$ \: S3 n unsigned 0; //空域 unsigned b:4; //从一单元开始存放 unsigned c:4;* g; S3 w( P" h: z, u4 h# L" d } 在这个位域定义中,a占第一字节的6位,后2位填0表示不使用,b从第二字节开始,占用4位,c占用4位。内存结构如下图所示。 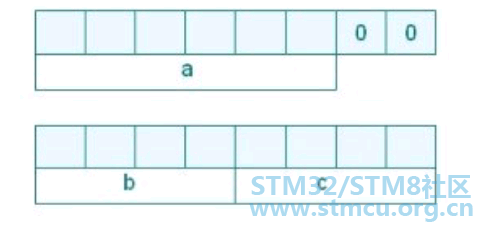
(2)由于位域不允许跨两个字节,因此位域的长度不能大于一个字节的长度,也就是不能超过8位二进位。 (3)位域可以无位域名,这时它只用来填充或调整位置。无名的位域是不能使用的。 例如: struct wk{ int a:1; int :2; //不能使用. ?$ h& C; O. L4 L int b:3; int c:2;0 D. }4 b9 @# ?9 ]& t; v } 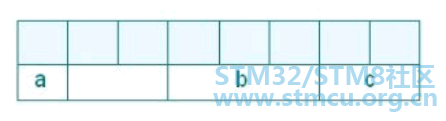
从以上述分析可以看出,位域可以看做是一种结构类型,其特点是成员均按二进位分配。 根据以上分析可知,在s1中i在相对0的位置,占8位即第1个字节。j就在相对第2个字节的位置。由于一个位置的字节数是4位的倍数,因此不用对齐,可以就放在那里。a要放在4位倍数关系的位置上,因此不用对齐,就放在那里。 目前总共是16位,2字节,由于double是8字节的,因此要在距相对0位置为8个字节的位置处放下。所以从16位开始到8个字节之间的位置被忽略,直接放在相对第8字节的位置,因此,s1总共占16字节。存储结构如下图所示。 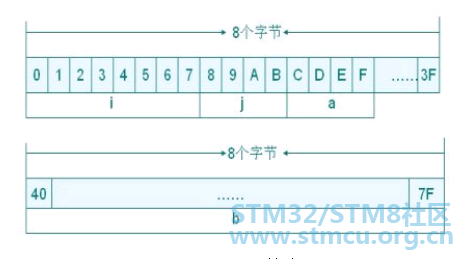
在s2中,每个数据都要对照结构体内最大数据的最小公倍数补齐。如i,j共12位,小于double的8个字节需按8字节补齐,a位也要按8字节补齐,共24个字节,存储结构如下图所示。 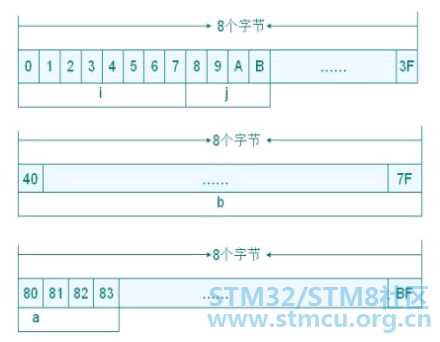
在s3中,i是int型数据(按32位机分析)占4个字节,j是char型数据占一个字节,a是int型数据占4个字节,b是double型数据占8个字节。在此b是最大的数据类型,因此i、j、a都要向b的double型对齐,即i、j、a的数据长度要向b对齐为8个字节,四个数据共占据32个字节。s3的存储结构如下图所示。 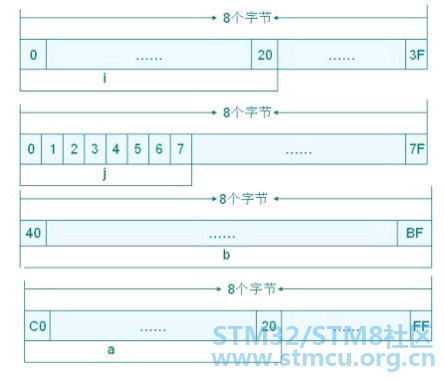
sizeof(S1)=16 sizeof(S2)=24 sizeof(S3)=32 说明:结构体作为一种复合数据类型,其构成元素既可以是基本数据类型的变量,也可以是一些复合型类型数据。对此,编译器会自动进行成员变量的对齐以提高运算效率。默认情况下,按自然对齐条件分配空间。各个成员按照它们被声明的顺序在内存中顺序存储,第一个成员的地址和整个结构的地址相同,向结构体成员中size最大的成员对齐。 许多实际的计算机系统对基本类型数据在内存中存放的位置有限制,它们会要求这些数据的首地址的值是某个数k(通常它为4或8)的倍数,而这个k则被称为该数据类型的对齐模数。 6 G% x8 G& b3 }* l |
| 谢谢分享 |
| 干货满满,感谢分享 |
 微信公众号
 手机版


