|
一战封神的 0x5f375a86 / G1 |$ }6 Z* X& I: {
雷神之锤3是一款九十年代非常经典的游戏,内容画面都相当不错,作者是大名鼎鼎的约翰卡马克。由于当时游戏背景原因,如果想要高效运行游戏优化必须做的非常好,否则普通人的配置性能根本不够用,在这个背景下就诞生了“快速开平方取倒数的算法”。
- ?4 V/ V; Z5 D3 m4 K+ E8 }7 ^- i9 i% j! C8 Q3 i
在早前自雷神之锤3的源码公开后,卡马克大神的代码“一战封神”,令人“匪夷所思”的0x5f375a86 ,引领了一代传奇,源码如下:
" L/ S9 u/ l% C" D5 I: E: R- float Q_rsqrt( float number ) {
. w% Q7 m. M9 e2 E5 q+ o& M - long i;4 |! t/ H% e7 @- X9 B: X
- float x2, y;
3 U3 \% [; h, I4 J( H - const float threehalfs = 1.5F;
+ S& x$ Z; H) F6 C - x2 = number * 0.5F;# ? W+ M" a, N2 _# y3 @9 p1 i
- y = number;: i, m0 @+ Y3 \
- i = * ( long * ) &y;
" t7 q1 \& d8 c) J - // evil floating point bit level hacking
+ G& [7 U, P- J6 ~/ q4 i* r7 J - i = 0x5f3759df - ( i >> 1 ); // what the fuck?( {6 j, p: g l, |+ m( C( d3 f- m
- y = * ( float * ) &i;
: W) I3 B1 ^% [4 {( n5 i - y = y * ( threehalfs - ( x2 * y * y ) ); / x( H' L2 n& k$ C/ O
- // 1st iteration
( [) ~% a) N, t - // y = y * ( threehalfs - ( x2 * y * y ) );% @- G4 N% ?0 ^ l1 \
- // 2nd iteration, this can be removed6 g3 y. Z& ]% @; h
- #ifndef Q3_VM
7 Z, ^4 o3 B3 N2 Q; f, t8 I - #ifdef __linux__
4 Y0 o$ F1 Q- o9 M" i6 c+ K! t) E+ a - assert( !isnan(y) );
; s+ [! @: e) P- x& L0 I - // bk010122 - FPE?
0 G1 y/ j+ K& x: S% F% k; u% ^7 I - #endif 6 b; I, Q- R8 u2 Z1 U0 Y
- #endif : G& V, K/ R- a
- return y; }
: d0 N8 T+ I$ O! ?
相比 sqrt() 函数,这套算法要快将近4倍,要知道,编译器自带的函数,可是经过严格仔细的汇编优化的啊!% G A5 Q2 m9 s& L
& f1 k9 L7 l8 x9 x" @ 牛顿迭代法的原理是先猜测一个值,然后从这个值开始进行叠代。因此,猜测的值越准,叠代的次数越少。卡马克选了0x5f3759df这个值作为猜测的结果,再加上后面的移位算法,得到的y非常接近1/sqrt(n)。这样,我们只需要2次牛顿迭代法就可以达到我们所需要的精度。$ K6 Q# Q! \4 p( r- c, |
函数返回1/sqrt(x),这个函数在图像处理中比sqrt(x)更有用。
" x( n$ y6 b. P( o/ ?0 F- R3 ^ q$ }
注意到这个正数只用了一次叠代!(其实就是根本没用叠代,直接运算)。编译、实验,这个团数不仅工作的很好,而且比标准的sqrt()函数快4倍!
% t* o; Y1 K% {: @! i+ y3 C4 J2 [4 l0 D( C7 g) D" Q* H7 m1 {
这个简洁的定数,最核心,也是最让人费解的,就是标注了what the fuck的一句 i = 0x5f3759df - ( i >> 1 );再加上y = y * ( threehalfs - ( x2 * y * y ) )。' I- e: ]- Y6 d+ H# f
两句话就完成了开方运算!而且注意到,核心那句是移位运算,速度极快!特别在很多没有乘法指令的RISC结构CPU上,这样做是极其高效的。0 m. n; s, T7 ~9 ]! g
5 [2 X- l; x$ v
算法的原理就是使用牛顿迭代法,用 x-f(x)/f'(x) 来不断的逼近 f(x)=a 的根。$ @+ q0 f3 c9 @: c
求平方根:f(x)=x^2=a ,f'(x)= 2*x, f(x)/f'(x)=x/2,把 f(x) 代入 x-f(x)/f'(x)后有(x+a/x)/2,6 n+ Z) T% }0 U$ N# H
现在我们选 a=5,选一个猜测值比如 2, 那么我们可以这么算 5/2 = 2.5; (2.5+2)/2 = 2.25; 5/2.25 = …… 这样反复迭代下去,结果必定收敛于 sqrt(5)。
; x9 i% R; m0 P+ `; ~
但是卡马克作者真正厉害的地方是他选择了一个神秘的常数 0x5f375a86来计算那个梦“值,6 k" T: o6 x. E" p
5 _$ D4 ` g" w4 F& s" P# C$ W$ N8 k# c- y就是我们加注释的那一行那行算出的值非常接近1/sqrt(n)这样我们只需要2次牛顿迭代就可以达到我们所需要的精度。
5 }. F& N3 t$ b8 N' Y/ o6 h% b J" N p ~* b4 g
当然目前也已有翻译过C++语言的版本:
. w9 W+ j: R) R+ C- & K$ p [' V4 J$ P
- float Q_rsqrt( float number )6 M c: V5 M9 B( s d) m- v
- {
" U5 j5 l) U$ F1 D7 ]2 j% R - long i;
: g7 N% H5 b0 Z/ m - float x2, y;* A6 L- c u& F) b
- const float threehalfs = 1.5F;
. Z( {6 Z. Q. m+ n- s" o
. d8 ?+ t" a; n! W- x2 = number * 0.5F;
& T% L9 l2 ?9 k, h - y = number;7 P& r! |* y, D
- i = * ( long * ) &y;1 c0 h% T+ h+ N1 u* Y
- i = 0x5f3759df - ( i >> 1 ); // what the fuck?; X" Y3 J0 {! c" a! k! t4 I
- y = * ( float * ) &i;
0 R6 H/ {" O. O7 S - y = y * ( threehalfs - ( x2 * y * y ) ); // 1st iteration! u- Y( ~" b# ` `: A( X T2 c
- // y = y * ( threehalfs - ( x2 * y * y ) ); // 2nd iteration, this can be removed P0 [% \3 S' q3 c9 [6 \
- ( Y# s' \& s7 A8 A4 u# y
- #ifndef Q3_VM
6 i' H$ z- g& v- L - #ifdef __linux__& [0 c2 c( z( H, F
- assert( !isnan(y) ); // bk010122 - FPE?
( E1 H6 X6 H+ h$ r - #endif' ^2 b: D. P7 A# R
- #endif+ j _5 \& j8 `
- return y;
- }) M# U: R6 c3 k* \ - }
4 x# K4 q5 z7 t4 M/ S2 ]: j; N3 ?+ c$ O* _4 i8 u
7 m0 m+ d8 S7 S w1 D% E
当然,更加魔幻的是,普渡大学的数学家Chris Lomont看了以后觉得有趣,但也不服气,决定要研究一下卡马克弄出来的这个猜测值有什么奥秘。
) B5 F; s1 h* m! \- y, X
在精心研究之后,Lomont从理论上也推导出一个最佳猜测值,和卡马克的数字非常接近, 0x5f37642f。Lomont计算出结果以后非常满意,于是拿自己计算出的起始值和卡马克的神秘数字做比赛,看看谁的数字能够更快更精确的求得平方根。结果是卡马克赢了...
0 }3 O9 [* Y b; k3 J
Lomont怒了,采用暴力方法一个数字一个数字试过来,终于找到一个比卡马克数字要好上那么一丁点的数字,虽然实际上这两个数字所产生的结果非常近似,这个暴力得出的数字是0x5f375a86。0 C. w [, I- e, b
6 B# w6 l$ r; C$ B$ l/ d1 d; F
囊括世界万物的一段代码
) s' }% t1 ~6 G
这是一段使用Processing语言的代码,这短短的几行代码永无休止的就在做一件事——“穷举”。那么它又有什么特殊之处吗?. |* z* `6 h1 v$ C. T
忽略机器本身的性能限制,假设 frameCount 可以无限大(frameCount代表当前帧数)。只需安安静静地盯着屏幕,就可以看到所有像素的所有组合可能。
7 s8 z( ~; u; q) R" o
这意味着你可以在上面看到所有艺术大师的作品,蒙娜丽莎、向日葵甚至是初音……人类历史上所有光辉的瞬间都将闪现在眼前。
s% D6 M$ |" b* H
但是这又需要多久时间呢?计算机里的每个像素都是由 256 级的 RGB 组成的。因此可以表示 256 ³ (1600万)种颜色。假如图形的分辨率为 1000 × 1000,所有的像素可能的色值相互组合,将会产生 256 的 3000000 次方张不同图片。
/ H% W* z( P* b' i' t" ^
如果将图片排在一个长廊上,人以一秒一张的速度去浏览。由于一年有 31536000 秒,因此要走完这条长廊,就需要 10⁷²²⁴⁷¹² 年。6 e& l- c6 ?) B$ y/ o7 b1 C
这个数字已经大得很难用人类的常用单位去表示了。硬是要用,那就是 10亿亿亿亿亿亿......年(90万个亿)。要清楚,宇宙的年龄也仅仅是 140 亿年(1.4 × 10¹⁰年)。。8 @! U" i. C: P3 h2 j* d
这也意味着,即使你从宇宙大爆炸看到现在,也无法将这个程序看完。但如果把图片像素的精度降低呢?用 100 × 100 的分辨率并且只用黑白二值去表示图形?此时总数就会缩减到 2⁷⁰⁰⁰⁰ ,也就约等于 10³⁰¹⁰。8 |% P) c- z2 r* B9 P6 X
看似缩小很多了。如果同时动用全人类的力量,将这个任务分配给70亿人。每人还是要不眠不休地看上 3.17 × 10³⁰⁰² 年,才能看完。$ R* B! R3 d/ X3 t. X
即使化到最简,结果仍是大得恐怖。但如果能看完,我手上说不准会有一张 100 × 100 的HelloKitty头像,他手上或许能有一张爱因斯坦吐舌头的照片。9 u9 I; X$ x8 s8 {8 a* U
可以用这么简洁的形式去展现万物,用近乎无限的时间去换取无限的可能,我觉得这就是这段代码的魅力所在。
: E4 M, d R9 i% i \, b- void setup(){+ V; f; k: ?; Z3 F
- size(500,500);7 o" p: G- M9 o; k- K8 L9 O% `& _
- }
: x: H' n1 N( r/ O2 ^ - void draw(){3 H2 C E- h7 B' V9 V
- for(int i=0;i<width;i++){
7 g; o9 a( b& \ - for(int j=0;j<height;j++){
, O5 }8 D. p. E4 ]0 g3 D3 ? - stroke(frameCount/pow(255,i+j*width)%255,frameCount/pow(255,i+j*width+1)%255,frameCount/pow(255,i+j*width+2)%255);
+ m/ x9 R/ W3 x- G - point(i,j);6 z4 I) L5 k& w6 |: Y
- }: V( x* I! \4 x3 [5 u1 c
- }$ c7 s( [* p$ F5 h0 e4 g
- }
; |) H+ b3 I! t3 G1 z- _* s0 q4 K* o5 Y$ j* b9 i/ T$ l
这段代码也有5x5的精简加速版本,当然其中的参数也是可以任意修改的,代码如下:- * E3 t+ D( K% o2 h3 |
- int num,w,frame,level;( A( g# c; E' ~0 V8 F* |/ k
- ( @: w4 ?9 ?. ^( U+ h2 X
- void setup(){
* N3 U" {- A% Z! [" I* Q - size(400, 400);
8 Q/ F0 k6 Q% n" s. i" }% L - num = 5;" t: H7 b- L7 F
- w = width/num;: k6 F. R3 f; }* K# @& h
- level = 2; //色值精度
2 @9 e& y/ t) @2 r+ v - }9 n( g' ~! e" O! s* O
3 F; q' ?, [' j( J4 h; [) `- void draw(){$ t4 ^7 l- T4 }% \( x
- for(int i = 0; i < num; i++){
7 V# u; J7 ~) f/ }3 X! y! k - for(int j = 0; j < num; j++){
+ Y9 f% R: Y8 [" a( j \) P. V - fill((int(frame/pow(level,i + j * num)) % level)* (255 / (level - 1)));) u( ~/ l: |# m
- rect(w * i, w * j, w, w);
# g- j7 T. V. i! J7 s5 @; D2 Z0 F% \ - }: l* _% o6 O4 Z
- }
: g( T6 i# ?5 ^$ D6 d; } - // frame++; 匀速播放 3 F/ a7 F, e, \; F
- frame = int(pow(frameCount,2)); //加速播放
0 M1 @! d3 N) E$ x - }
0 s- X- ?8 K. z i& P$ h& N
只有13个字符的Linux Fork炸弹( [( c1 @# ]6 O2 w N9 M
$ d0 r$ X6 m. q: L {; c3 m5 e% b
早在2002年,Jaromil设计了最为精简的一个Linux Fork炸弹,整个代码只有13个字符,在 shell 中运行后几秒后系统就会宕机:
$ V0 R2 E& M$ l8 L J3 e6 e3 ^4 m& q8 _0 Q5 O1 B& I
这样看起来不是很好理解,我们可以更改下格式:
5 c9 [9 r; J# ?) Z' h* Q2 s- + R& Z1 f* q/ s" f# G f
- :()
4 a5 A- y( @0 Y$ J - {+ f- @. H4 T& ~
- :|:&
, {8 Y( J0 T7 k' P$ B) d$ z' } - };
' _2 V$ `/ @$ K/ S7 b: \& f, X - :
& w6 a4 \4 b$ ?, Z更好理解一点的话就是这样:- : z, L1 ~7 y; L/ y R
- bomb()
4 y* L) R" d# f2 Z5 y/ `, u. B - {
1 B( L G3 a# L4 a5 m# J5 _: i - bomb|bomb&
, s- w# D. `8 _% ?8 M/ s: q3 j - };
- J5 s. o O+ R" |4 U - bomb8 E( K4 `5 Y# b, i- G% X5 m% b
* W. v0 d" O3 f1 c/ Y因为shell中函数可以省略function关键字,所以上面的十三个字符是功能是定义一个函数与调用这个函数,函数的名称为:,主要的核心代码是:|:&,可以看出这是一个函数本身的递归调用,通过&实现在后台开启新进程运行,通过管道实现进程呈几何形式增长,最后再通过:来调用函数引爆炸弹。因此,几秒钟系统就会因为处理不过来太多的进程而死机,解决的唯一办法就是重启。
1 O5 k, x5 Q! }9 e# C
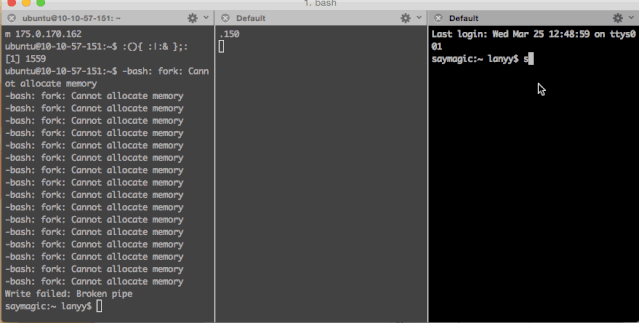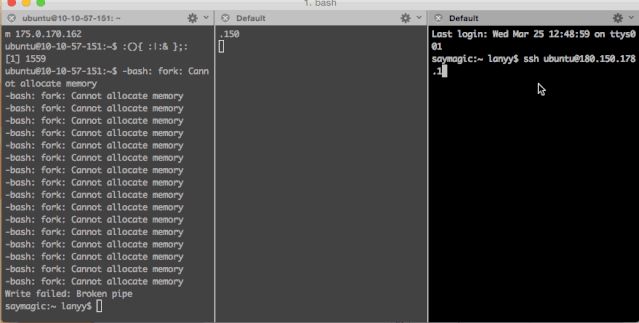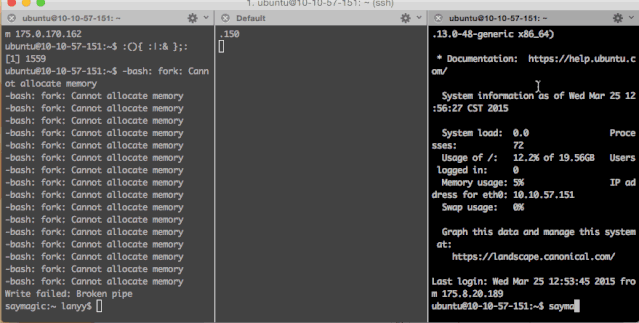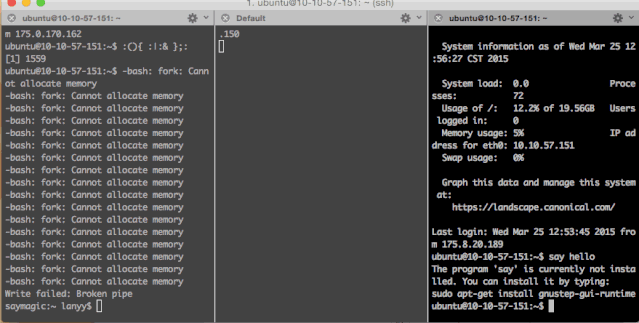
; ]' S# B, A/ k N) N当然有“不怕死”的小伙伴用了云主机试了一试:$ z r7 K7 @6 b/ ?2 `6 K* @
4 t4 _4 J9 I H) H+ ]
( F5 @ N) g( ~7 i p: `+ V
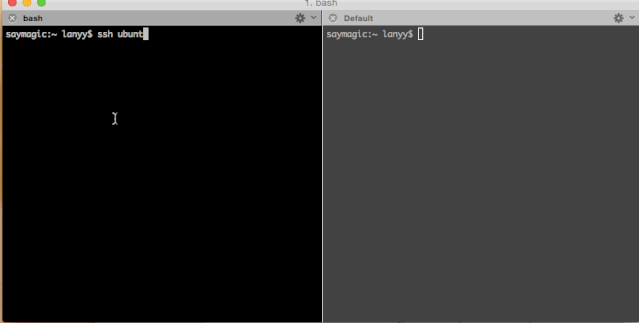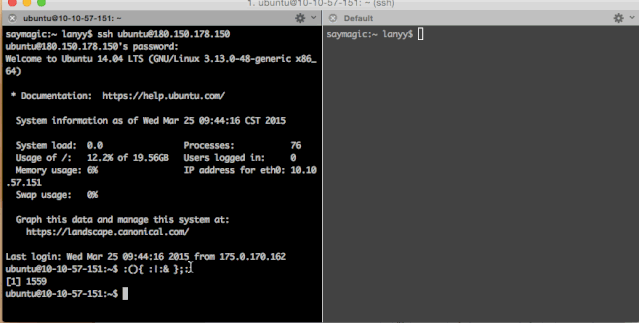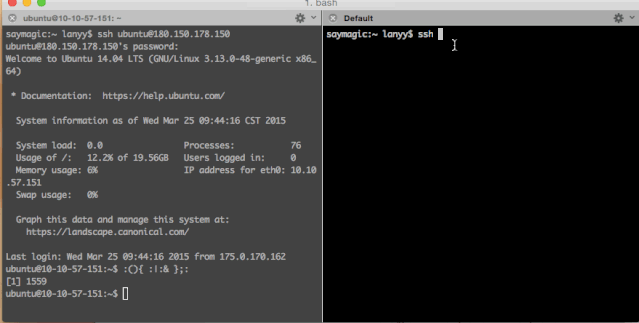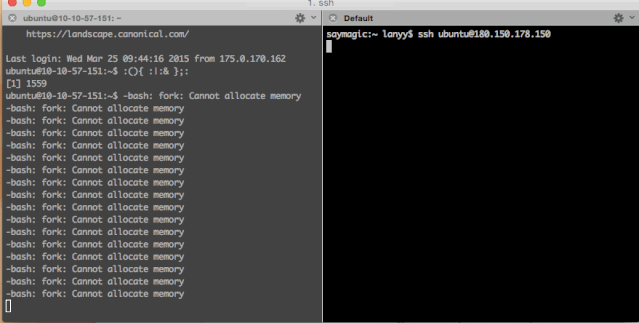
结果,运行一段时间后直接报出了-bash: fork: Cannot allocate memory,说明内存不足了。
. Y C/ B2 _$ b2 b6 B
2 L+ x2 n7 `5 r4 u; |9 F6 c! Q并且在二号终端上尝试连接也没有任何反应。因为是虚拟的云主机,所以我只能通过主机服务商的后台来给主机断电重启。然后才能重新登录:$ z% u6 Q% l7 x9 T4 N
' `, S3 x7 ~$ q- _0 @
8 {/ E. ], g- K" k0 ^( u
当然,Fork炸弹用其它语言也可以分分钟写出来一个,例如,python版: - * a3 l3 l3 i; O% ~( ^ _& K6 O/ a
- import os, f! i# }' y/ ]7 S$ j
8 ^- \2 C7 G ^- while True: os.fork()
# p& M" p( h* }" \0 E: L- 6 f9 ?; h$ p8 z& y; }) F& k( F+ M
- ubuntu@10-10-57-151:~$ ulimit -a5 H5 M7 P/ x3 L0 {8 z, ~
- core file size (blocks, -c) 0
+ h% \: Q: ~0 A2 T - data seg size (kbytes, -d) unlimited, s! X3 I5 h1 ] ?% W; l/ Q5 s
- scheduling priority (-e) 0
" R( {8 X/ }; |9 l. `& [ - file size (blocks, -f) unlimited
$ |9 z5 B. `; M3 M2 f4 j( G1 s - pending signals (-i) 7782* A5 Y0 ? H4 f4 ^7 q! N$ n
- max locked memory (kbytes, -l) 641 Y5 q' s \/ x* q1 ? Y; x
- max memory size (kbytes, -m) unlimited
* S% p' x5 r9 Z; b - open files (-n) 1024
0 q4 u( f( s9 u - pipe size (512 bytes, -p) 8: ]6 Q' P) |9 a/ q& \, \* U! D
- POSIX message queues (bytes, -q) 819200
. t0 }4 M% P# ?0 b" K - real-time priority (-r) 03 ?. ]/ A1 u; R* }9 h7 a, J+ O/ e# E
- stack size (kbytes, -s) 8192; ~7 @4 X1 J; v9 x U7 M8 @# f
- cpu time (seconds, -t) unlimited! I/ {$ X- g U: f
- max user processes (-u) 77825 b% p, i* e; I( h& Y" F
- virtual memory (kbytes, -v) unlimited( P! {1 s3 r# L$ r. d
- file locks (-x) unlimited
/ y% }+ Z) I" E! p6 [$ o9 ^. B8 ~4 g
可以看到,-u参数可以限制用户创建进程数,因此,我们可以使用ulimit -u 20来允许用户最多创建20个进程。这样就可以预防bomb炸弹。但这样是不彻底的,关闭终端后这个命令就失效了。我们可以通过修改/etc/security/limits.conf文件来进行更深层次的预防,在文件里添加如下一行(ubuntu需更换为你的用户名):
# t5 R* L2 t7 Y3 d2 m6 `" u
- ubuntu - nproc 20
% ^7 D" m5 s7 ~' q
这样,退出后重新登录,就会发现最大进程数已经更改为20了,这个时候我们再次运行炸弹就不会报内存不足了,而是提示-bash: fork: retry: No child processes,说明Linux限制了炸弹创建进程。
; Z& ^* |- [* E- i
东尼·霍尔的快速排序算法 4 ~# k5 T, H8 f4 k, }6 A+ Y, g' k
这个算法是由图灵奖得主东尼·霍尔(C. A. R. Hoare)在1960年提出的,从名字中就可以看出,快速就是他的特点。 快速排序采用了“分治法”策略,把一个序列划分为两个子序列。在待排序列中,选择一个元素作为“基准”(Pivot)。
( i3 T8 }: @8 M. e ; g% T t) F4 A7 n) F
所有小于“基准”的元素,都移动到“基准”前面,所有大于“基准”的元素,都移动到“基准”后面(相同的数可以到任一边)。此为“分区”(partition)操作。
( N5 i/ g' O: S- f0 m& ~' @
8 L+ i& E t7 u分别对“基准”两边的序列,不断重复一、二步,直至所有子集只剩下一个元素。 8 a# \$ x8 S/ S# P2 V) G, [0 I1 `1 {
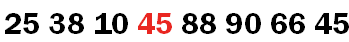
假设现有一数列:. d ~4 m# [& j2 a
$ }7 z4 f3 U( f1 y4 @$ q8 X
% H _; z3 C" v# c4 R( n对此数列进行快速排序。选择第一个元素 45 作为第一趟排序的“基准”(基准值可以任意选择)。
" h( {3 {" {0 n5 O0 u" T
3 ?8 k) s; m: L: L' t
第一趟:将元素 45 拿出来,分别从数列的两端开始探测1 u _/ q) i1 T) }) S
6 q$ w. _' L% h _ {* ]* Z; L
首先从右向左开始,找到第一个小于 45 的元素为 25,然后将 25 放置到第一个元素 45 的位置上。此时数列变为:
9 U8 c2 g# l. Q, N" x" B5 Y4 \0 v3 H. G' o) D8 D/ g
: d9 a; b, U0 R% M! V
然后从左向右开始,找到第一个大于 45 的元素为 66 ,然后将 66 放置到原先元素 25的位置上。此时数列变为:$ k( I3 A1 I. \. p G! Z
, q9 @1 _# g# c: u3 C; O6 x
) o. V4 R5 y2 f' I# N7 X" f, b
继续从右向左开始,找到第二个小于 45 的元素为 10 ,然后将 10 放置到原先元素 66的位置上,此时数列变为:; f& b( g2 b, y7 M" L7 C4 ?
$ @* t w( D$ Q% B, A7 U9 C$ I* D4 { $ f! U4 A: ?+ M6 I0 b. o
继续从左向右开始,找到第二个大于 45 的元素为 90 ,然后将 90 放置到原先元素 10的位置上,此时数列变为:- k5 B- N, L) ~4 K/ ]) G
4 I* l+ S: M, `/ ~8 o1 k 0 x0 D x b9 [# ~0 m
继续从右向左开始,此时发现左右碰面,因此将“基准”45 放置到原先元素 90 的位置上,此时数列变为:2 h4 t" P0 R3 S& v* X. E
! Y |7 _& O( O7 ~$ J" p
4 c2 I: o# v8 y1 P- `' f4 ?
至此,第一轮结束,“基准”45 左侧为小数区,右侧为大数区。同样的分别对小数区和大数区应用此方法直至完成排序。
7 D/ C# J* i2 v5 {: w4 ~$ c3 ?
分析完成后通过C++的源代码如下:8 {0 V6 N& L/ |8 O$ R5 ?2 b: W
4 H! T9 x r. n6 a% ?
快速排序核心算法:
! C8 S8 e* G# l$ z, F( C
5 o: [9 }3 O: \6 A9 n* F; {- //每一轮的快速排序# {5 ~$ r! S$ V$ ?: {
- int QuickPartition (int a[],int low,int high)4 | i& s5 Z, Y; U$ N, M
- {
# t4 I2 v7 I) N4 P - int temp = a[low];//选择数组a的第一个元素作为“基准”
- E+ C7 @6 p: Z2 L - while(low < high) ?8 Y/ O- H8 D3 g0 n6 g
- {0 V) l: P/ b: Q/ z* F; E2 E
- while(low < high && a[high] >= temp )//从右向左查找第一个小于“基准”的数
, D. s8 _. H! q5 F: m6 g1 i) ` - {9 }* F( `, U2 d4 m& a
- high--;/ X+ x6 o' T7 W' o$ {
- }
|# R# A! E* e+ A - if (low < high)
@" m% r3 K' }. U, C5 i, w: m - {
; R, g3 o* S. I& ` b- C- l - a[low] = a[high];//将第一个找到的大于“基准”的数移动到low处
& T) m# S! [: J; y - low++;
' c2 T0 ?$ T5 e7 c2 x - }9 t# T- j. Y) v L4 }
- - D& h' `3 D \6 b0 ^+ G% t9 V0 _4 l
- while(low < high && a[low] <= temp)//从左向右查找第一个大于“基准”的数- x: A! J# Z2 l ^3 ~. u4 g. A4 u# {
- {
9 B1 }( e( _5 w- m1 ] - low++;# K1 g z& l& x0 O4 e
- }
; P/ a( X4 S C! ?- x - if(low < high)
7 a9 t. j6 l' S+ O* u; ?4 R1 F/ I - {* W7 T5 ~7 {! ^* X0 I
- a[high] = a[low];//将第一个找到的小于“基准”的数移动到high处 b4 B2 u& H" r, P4 L
- high--;# X, S( g* u5 v* g" a! O
- }
3 q7 k/ ]" M; ^: d5 Q1 y
v* K) R( M" t4 }- a[low] = temp;//将“基准”填到最终位置
- \% C# n& K( k: `; g" p8 H$ r# c' T - }
2 ~8 D6 e& \0 o4 ?; z& t9 n, _% q, p* ~ - return low;//返回“基准”的位置,用于下一轮排序。
7 C4 y/ h b# x% V5 B& z0 U- z* \ - }
; v+ m! w( A1 a' W: d3 L; I5 E) ~( C% ^ ~3 r
递归调用QuickSort(分治法):9 x) |8 j9 a; ]+ F% A- ~% O0 `- r
+ i) o3 a: t9 {2 z2 o# @3 t- //快速排序-递归算法
4 a4 N' U+ S5 o# p7 e' i - void QuickSort (int a[],int low,int high)3 l, [/ V) W; p; \
- {
6 w7 v9 {8 S! g - if(low < high)
" B1 m0 Z) ^8 y0 B4 h; t" y - {
1 C/ x! y% z3 M0 D ]9 y - int temp = QuickPartition(a,low,high);//找出每一趟排序选择的“基准”位置
, O) `9 |& |- j9 { - QuickSort(a,low,temp-1);//递归调用QuickSort,对“基准”左侧数列排序+ \, M5 U1 h* Z7 G1 F
- QuickSort(a,temp+1,high);//对“基准”右侧数列排序* w, Q3 ~3 {% [6 k% x% s+ s
- }
) a6 [# E/ g0 G5 t1 \5 m - }
主函数调用:' }5 b, k" v- [" [+ w7 W
- : x$ [7 |9 ]. W9 o9 _% i) E
- void main()
k6 [3 ?3 Y4 l+ ]( @$ y8 m - {3 d8 s$ S! P/ e: v
- int a[8]={45,38,66,90,88,10,25,45};//初始化数组a) c# D& g! s- [4 s" K* P y
- QuickSort(a,0,7);
6 O7 Q( e) h' E: T: o0 o' k, k5 d# z - / y8 G2 E9 U, T9 q$ F$ x
- cout<<endl<<"排序后:";3 L+ D# h; Z5 z% h7 n* q }7 Z5 o
- for(int i = 0;i <= 7;i++)
9 X- e2 _+ e1 `# D$ `; w - {
# N3 G( R8 f4 s5 {8 f; w8 R - cout<<a[i]<<" ";
0 s8 T @; S* Z - }' N: q" I/ o! |1 D7 t
- getchar();- {/ K- |! F# p" L" p$ w. P
- }
8 T4 V: P# i) v* m4 K+ a q) H. ?0 z: Z' V0 B
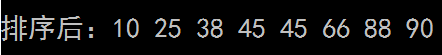
排序后结果:
6 \4 ~7 }5 t+ P/ f) Z
+ K: Z; ?- P, }9 K4 j. ]$ h+ v D8 r, e
毫无炫技又惊为天人的二分图的最大匹配、完美匹配和匈牙利算法) W! r W8 W# u3 j* P+ g6 S
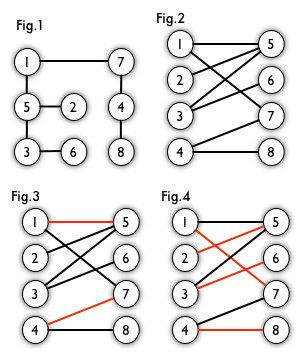
二分图:简单来说,如果图中点可以被分为两组,并且使得所有边都跨越组的边界,则这就是一个二分图。准确地说:把一个图的顶点划分为两个不相交集U和V,使得每一条边都分别连接U、V中的顶点。如果存在这样的划分,则此图为一个二分图。二分图的一个等价定义是:不含有「含奇数条边的环」的图。图 1 是一个二分图。为了清晰,我们以后都把它画成图 2 的形式。
+ B0 K8 x. Z. F% c- I( W1 Y匹配:在图论中,一个「匹配」(matching)是一个边的集合,其中任意两条边都没有公共顶点。例如,图 3、图 4 中红色的边就是图 2 的匹配。/ ?/ M* n; O/ d( i# D5 h
# r, V7 q2 g3 e; w6 r4 y- ^# i; S
我们定义匹配点、匹配边、未匹配点、非匹配边,它们的含义非常显然。例如图 3 中 1、4、5、7 为匹配点,其他顶点为未匹配点;1-5、4-7为匹配边,其他边为非匹配边。
& }- j- Y$ ] d最大匹配:一个图所有匹配中,所含匹配边数最多的匹配,称为这个图的最大匹配。图 4 是一个最大匹配,它包含 4 条匹配边。
! c& G" A6 j' w2 `3 f, b" h完美匹配:如果一个图的某个匹配中,所有的顶点都是匹配点,那么它就是一个完美匹配。图 4 是一个完美匹配。显然,完美匹配一定是最大匹配(完美匹配的任何一个点都已经匹配,添加一条新的匹配边一定会与已有的匹配边冲突)。但并非每个图都存在完美匹配。
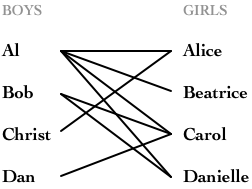
1 }# z: V1 Q1 _' i9 |+ N3 p8 [举例来说:如下图所示,如果在某一对男孩和女孩之间存在相连的边,就意味着他们彼此喜欢。是否可能让所有男孩和女孩两两配对,使得每对儿都互相喜欢呢?图论中,这就是完美匹配问题。如果换一个说法:最多有多少互相喜欢的男孩/女孩可以配对儿?这就是最大匹配问题。: t2 x8 E8 z2 J+ X4 Y
0 s; @, _- u$ Y8 {1 E0 f; L
 5 I* u( L( \( t) ~3 O1 c5 r: Y
基本概念讲完了。求解最大匹配问题的一个算法是匈牙利算法,下面讲的概念都为这个算法服务。
( w5 k4 ]% A' x; _: b* F
1 B4 @. {7 @# S3 M" t' a6 G' j5 C
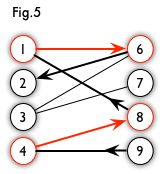
; ^# W# x, t8 P- F& `+ a交替路:从一个未匹配点出发,依次经过非匹配边、匹配边、非匹配边…形成的路径叫交替路。: S H; Y/ @# S( x
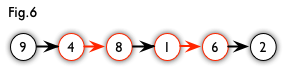
增广路:从一个未匹配点出发,走交替路,如果途径另一个未匹配点(出发的点不算),则这条交替路称为增广路(agumenting path)。例如,图 5 中的一条增广路如图 6 所示(图中的匹配点均用红色标出):
 0 K; T# ?- b3 m7 Y3 ]4 B
增广路有一个重要特点:非匹配边比匹配边多一条。因此,研究增广路的意义是改进匹配。只要把增广路中的匹配边和非匹配边的身份交换即可。由于中间的匹配节点不存在其他相连的匹配边,所以这样做不会破坏匹配的性质。交换后,图中的匹配边数目比原来多了 1 条。
3 V; v1 g) g) Q$ h; `我们可以通过不停地找增广路来增加匹配中的匹配边和匹配点。找不到增广路时,达到最大匹配(这是增广路定理)。匈牙利算法正是这么做的。在给出匈牙利算法 DFS 和 BFS 版本的代码之前,先讲一下匈牙利树。 j# b, q f# D- ~
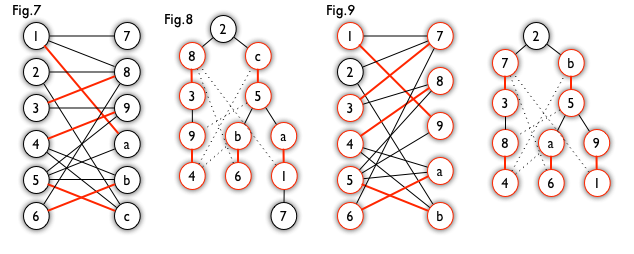
匈牙利树一般由 BFS 构造(类似于 BFS 树)。从一个未匹配点出发运行 BFS(唯一的限制是,必须走交替路),直到不能再扩展为止。例如,由图 7,可以得到如图 8 的一棵 BFS 树:
' @: y: s1 W* ~+ ] b& p0 ?9 `$ L {$ | b
) i& Q* {6 w& S3 c这棵树存在一个叶子节点为非匹配点(7 号),但是匈牙利树要求所有叶子节点均为匹配点,因此这不是一棵匈牙利树。如果原图中根本不含 7 号节点,那么从 2 号节点出发就会得到一棵匈牙利树。这种情况如图 9 所示(顺便说一句,图 8 中根节点 2 到非匹配叶子节点 7 显然是一条增广路,沿这条增广路扩充后将得到一个完美匹配)。4 F+ s3 s7 x4 X6 J# V! M/ S( Y
下面给出匈牙利算法的 DFS 和 BFS 版本的代码:9 I+ T3 t9 `4 t5 p) J2 w/ }
- 8 T; f" R' m8 k# G* a, }
- // 顶点、边的编号均从 0 开始- r- Q( o8 |: m% L4 ~: ^
- // 邻接表储存4 r0 s; f& b/ ?' L
5 y# f7 m9 {$ q( h) s- struct Edge: Z' L" U" j) C! ~* Y+ V
- { O- M) z$ N/ B( F0 L
- int from;
8 P$ S8 Z' |8 ~2 E - int to;
: u) V0 f/ D. X Q1 D - int weight;
& U0 U8 @3 P7 |& L" ~& D& h
" d. }) l1 Y( r- Edge(int f, int t, int w):from(f), to(t), weight(w) {}4 S5 f# V# U+ t: c7 n2 l
- };1 F! ?3 N6 P0 @+ [5 d
- % N" q* I/ u9 }/ V, H) d
- vector<int> G[__maxNodes]; /* G[i] 存储顶点 i 出发的边的编号 */6 B% M$ J- G {; z6 j
- vector<Edge> edges;% L6 ~/ t3 I e' S& N: }/ f8 G
- typedef vector<int>::iterator iterator_t;
4 K; x, J" \8 s$ g' h! ^ - int num_nodes;3 [& y4 s0 |2 _& O
- int num_left;6 {/ F" E7 y) q! Z& Q) l$ o& n
- int num_right;
( j% P N4 |, ^2 {+ x- C7 T - int num_edges;+ V) @1 |2 ?, o. o& N4 z, c
& E, x3 Y. j) f- v% M0 c- int matching[__maxNodes]; /* 存储求解结果 */
' G" w" r# h! n: z( l - int check[__maxNodes];
6 ^7 _. I# ?9 w& s - bool dfs(int u)
0 T+ ?" d- R$ T8 } - {& Y6 y2 J2 V4 r# o6 L
- for (iterator_t i = G[u].begin(); i != G[u].end(); ++i) { // 对 u 的每个邻接点. J. D9 l8 z- e
- int v = edges[*i].to;4 h/ a! \6 r4 |% g* g/ V
- if (!check[v]) { // 要求不在交替路中; W u, X% s& A5 k; B! R
- check[v] = true; // 放入交替路
$ ~+ v0 a, o* R* J/ z- B - if (matching[v] == -1 || dfs(matching[v])) {
6 ?8 m V, a4 z5 P6 n - // 如果是未盖点,说明交替路为增广路,则交换路径,并返回成功! [( |1 f! I# a0 a4 G5 M+ r
- matching[v] = u;- r6 ]* P! h9 S" o4 L3 E9 z$ |
- matching[u] = v;
6 E% y7 f( o6 W/ V - return true;( D2 u9 h1 ^9 w) ]0 j
- }
0 P# x" O8 U1 W H1 \4 M; A/ D - }4 E0 u; K" C5 S8 X- u' y( l
- }6 {# _& I4 l0 y
- return false; // 不存在增广路,返回失败6 H( _* j$ r1 o, N
- }
3 i5 g6 W* Z( H! a1 { - int hungarian()6 }8 I' x1 N. N; N$ s
- {5 R& e, x0 H5 x0 ? Z I0 ]2 K/ c
- int ans = 0;
) V" ?3 x. y( X& P" i - memset(matching, -1, sizeof(matching));
7 m2 D- @' v- ~ - for (int u=0; u < num_left; ++u) {6 Q7 A" C9 p. t. z' Q
- if (matching[u] == -1) {9 y0 K& p6 c6 t p' Q
- memset(check, 0, sizeof(check));
4 J- I+ O3 l$ ? - if (dfs(u))# m7 T7 l! I" @% E
- ++ans;
& C( m b7 W4 e - }
" G. h/ K) W, [- b$ ?5 j4 M - }
7 w# Z* F& ~$ p+ j$ k$ ?. t - return ans;0 w8 g. z9 T. q
- }<u></u>
' }% D1 p6 f: [7 H ~
- " N8 m6 v2 j1 w( j
- queue<int> Q;- s. b! d) X& h0 @
- int prev[__maxNodes];9 _0 R$ z5 S5 X6 }5 { I
- int Hungarian()4 G1 g6 L8 G$ c3 w' N' u
- {2 n7 X4 o X1 n+ A" u) e
- int ans = 0;) E0 J& Z4 ?$ W3 F1 _
- memset(matching, -1, sizeof(matching));
& e- R3 h- ~3 h- ?9 O& r% H( B) X - memset(check, -1, sizeof(check));
7 ^8 y1 a! O! M9 f9 j8 ~& z - for (int i=0; i<num_left; ++i) {
+ W+ W0 R$ [. |7 }, e* c% S- N - if (matching[i] == -1) {) S8 v$ i U1 u0 w* T& o$ Q
- while (!Q.empty()) Q.pop();
: S& t- u% N& Y/ V; X# Q# E ?/ S' ], X - Q.push(i);. n8 L2 o- S1 c
- prev[i] = -1; // 设 i 为路径起点
! h8 Q4 a1 {$ p0 U K9 n( R/ h - bool flag = false; // 尚未找到增广路5 r" K1 d0 r0 y3 z) p1 ^% a' k
- while (!Q.empty() && !flag) {
7 p8 g: [. n2 {& |- K; b - int u = Q.front();( W4 q( _+ t. D1 o8 Y2 _9 \$ M
- for (iterator_t ix = G[u].begin(); ix != G[u].end() && !flag; ++ix) {# Z, q0 D3 V; i7 X4 I* T' f# ~
- int v = edges[*ix].to;
+ Z5 e6 O3 `' M* G0 ?+ Y% _! [ - if (check[v] != i) {, q. F8 N! ~9 P% m% z
- check[v] = i;6 h$ Y* `( J( u! Q3 v( T
- Q.push(matching[v]);
# ~! b5 i3 _7 f$ A0 R - if (matching[v] >= 0) { // 此点为匹配点- Q; g. ?- r0 l7 d" L+ _2 ]
- prev[matching[v]] = u;
y6 v6 W/ I" I. d - } else { // 找到未匹配点,交替路变为增广路
4 W( Z5 y7 p( E% B+ t) n6 r - flag = true;
- |* z R* y3 E5 S E' c8 K2 M% O - int d=u, e=v;: b" ~" y5 m; z* u: O
- while (d != -1) {
8 e- s' k$ `' n P; ?3 | - int t = matching[d];
) m' _. p; |2 O0 y. z( T - matching[d] = e;
& v0 I2 u$ P$ Y - matching[e] = d;
' H8 u/ O% H% X% {6 w - d = prev[d];
. @/ R; b' X: @: q2 R8 |8 X T - e = t;
1 c6 p0 [$ @. x% [8 u4 C - }4 `1 `; ]; B) a5 q4 `. Z4 U& M, R
- }
j: F" F. Y( Z1 ? - }
: V! l" V* ]. R1 V; P - }
2 n) M7 \1 Y, r8 y# o- {- p# y - Q.pop();
9 J h8 { |* j1 S) V2 D% y - } `8 c! C7 C# F# m2 z9 {
- if (matching[i] != -1) ++ans;. ?' u) i8 z6 p& {& o. T! P
- }
, E0 q r4 H# Q - }
6 M( P, ^" b) B0 D' w - return ans;- V0 D; f6 u9 S! [
- }
i5 B9 S$ H1 z6 b& d# U- D C# P6 c# U3 `2 t
# c' l v6 t4 P* I# z
匈牙利算法的要点如下( p* o! k7 Z; ~5 n% k! i# [& g
5 W0 ~& J( ~- r1 Q( a# B1 K# t3 \
- 从左边第 1 个顶点开始,挑选未匹配点进行搜索,寻找增广路。
; z/ P. a8 Q* n# N5 h( ~- 如果经过一个未匹配点,说明寻找成功。更新路径信息,匹配边数 +1,停止搜索。
- 如果一直没有找到增广路,则不再从这个点开始搜索。事实上,此时搜索后会形成一棵匈牙利树。我们可以永久性地把它从图中删去,而不影响结果。8 I9 v% Y4 N6 g6 A/ d
- 由于找到增广路之后需要沿着路径更新匹配,所以我们需要一个结构来记录路径上的点。DFS 版本通过函数调用隐式地使用一个栈,而 BFS 版本使用 prev 数组。0 o$ A: N/ u) M1 c( v# |
: Y; b' S( R- r" P
性能比较 Q5 j( a7 |% W* f% G, X! S
两个版本的时间复杂度均为O(V·E)。DFS 的优点是思路清晰、代码量少,但是性能不如 BFS。我测试了两种算法的性能。对于稀疏图,BFS 版本明显快于 DFS 版本;而对于稠密图两者则不相上下。在完全随机数据 9000 个顶点 4,0000 条边时前者领先后者大约 97.6%,9000 个顶点 100,0000 条边时前者领先后者 8.6%, 而达到 500,0000 条边时 BFS 仅领先 0.85%。补充定义和定理:
& U9 p b7 x+ y" U最大匹配数:最大匹配的匹配边的数目; [1 y2 s( }4 F1 |
最小点覆盖数:选取最少的点,使任意一条边至少有一个端点被选择9 T: y5 }' Y0 o5 _ a; i5 t" ^
最大独立数:选取最多的点,使任意所选两点均不相连
; j0 l: d7 }4 u. M- o最小路径覆盖数:对于一个 DAG(有向无环图),选取最少条路径,使得每个顶点属于且仅属于一条路径。路径长可以为 0(即单个点)。
/ r; `. I- t! t8 v p2 C定理1:最大匹配数 = 最小点覆盖数(这是 Konig 定理)定理2:最大匹配数 = 最大独立数定理3:最小路径覆盖数 = 顶点数 - 最大匹配数
: \% \' J! Y5 I5 s |





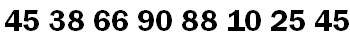
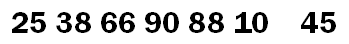
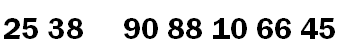
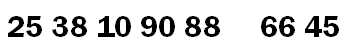
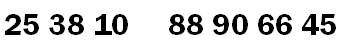
 微信公众号
 手机版


