




|
1为什么使用指针 假如我们定义了 char a=’A’ ,当需要使用 ‘A’ 时,除了直接调用变量 a ,还可以定义char *p=&a ,调用 a 的地址,即指向 a 的指针 p ,变量 a( char 类型)只占了一个字节,指针本身的大小由可寻址的字长来决定,指针 p 占用 4 个字节。 但如果要引用的是占用内存空间比较大东西,用指针也还是 4 个字节即可。
变量为了表示数据,指针可以更好的传递数据,举个例子: 第一节课是 1 班语文, 2 班数学,第二节课颠倒过来, 1 班要上数学, 2 班要上语文,那么第一节课下课后需要怎样作调整呢?方案一:课间 1 班学生全都去 2 班, 2 班学生全都来 1 班,当然,走的时候要携带上书本、笔纸、零食……场面一片狼藉;方案二:两位老师课间互换教室。 显然,方案二更好一些,方案二类似使用指针传递地址,方案一将内存中的内容重新“复制”了一份,效率比较低。
一个数据缓冲区 char buf[100] ,如果其中 buf[0,3] 为命令号, buf[4,5] 为类型, buf[6~10] 为该类型的数值,类型为 int ,使用如下语句进行赋值: *(short*)&buf[0]=DataId;2 f; j1 R' V4 x*(short*)&buf[4]=DataType;0 f5 p2 v+ y6 O *(int*)&buf[6]=DataValue;
操作系统将硬件和软件结合起来,给程序员提供的一种对内存使用的抽象,这种抽象机制使得程序使用的是虚拟存储器,而不是直接操作和使用真实存在的物理存储器。所有的虚拟地址形成的集合就是虚拟地址空间。 内存是一个很大的线性的字节数组,每个字节固定由 8 个二进制位组成,每个字节都有唯一的编号,如下图,这是一个 4G 的内存,他一共有 4x1024x1024x1024 = 4294967296 个字节,那么它的地址范围就是 0 ~ 4294967296 ,十六进制表示就是 0x00000000~0xffffffff ,当程序使用的数据载入内存时,都有自己唯一的一个编号,这个编号就是这个数据的地址。指针就是这样形成的。 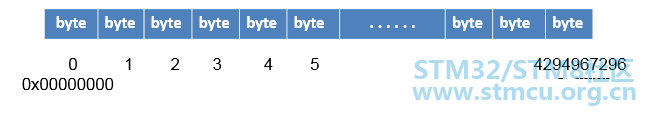
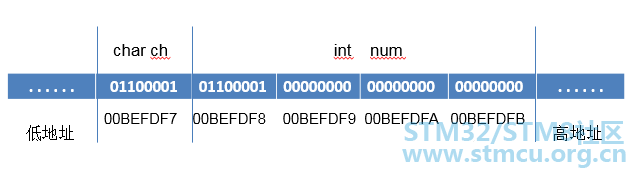
int main(void) {0 ?% H' o- J; e; @$ H4 S) ]0 l char ch = 'a';7 Q/ z$ @6 ]+ ^2 G( w5 I int num = 97;2 }! k; Y+ a) ~- ]5 g- }0 ^ printf("ch 的地址:%p\n",&ch); //ch 的地址:00BEFDF7 printf("num的地址:%p\n",&num); ( U% q. s5 d# b; f9 t //num的地址:00BEFDF8 return 0;. K* g) X# R# A" [; t } 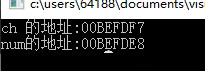
指针不仅可以表示变量的地址,还可以存储各种类型数据的地址,指针变量是用来保存这些地址的变量,与数组类似,依据地址存放的数据类型,指针也分为 int 指针类型, double 指针类型, char 指针类型等等。 综上,指针的实质就是数据在内存中的地址,而指针变量是用来保存这些地址的变量。 指针变量 和 指向关系用来保存 指针 的变量,就是指针变量。如果指针变量p保存了变量 num的地址,则就说:p指向了变量num,也可以说p指向了num所在的内存块,指针变量pp指向了p所在的内存块,以下面为例: #include <stdio.h>+ C- |6 n& E @$ T0 `$ Nint main(void) { int num = 97;' j% d1 Y$ d8 b, W+ C char ch = 'a';3 s! v2 c8 E ^# ]1 X! V/ Q int *p = & num;* @' N- q8 \& f, A+ ], W int **pp = &p; char *p1 = & ch; printf("num 的地址:%p\n",&num); - N: X( K$ j) T, x$ f printf("指针p的值:%p\n",p); - P9 H, H* J/ ^" P) C printf("指针p的地址:%p\n",&p); 9 |0 q; S( L, E printf("指针pp的值:%p\n",pp); 3 u: |7 r, S% P. @- c. g* m printf("ch 的地址:%p\n",&ch); & @, w; R; u6 G* @ return 0;' ]4 \# V6 U$ n" t6 m }- o! ^3 i7 V( X7 P 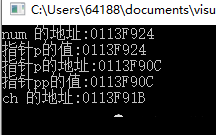
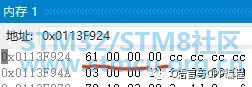
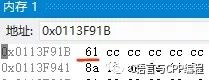
char型占1个字节
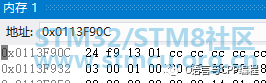
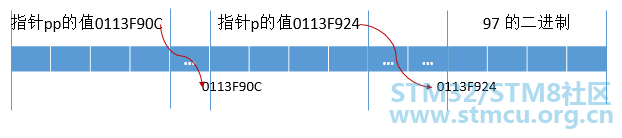
C语言中,定义变量时,在变量名 前 写一个 * 星号,这个变量就变成了对应变量类型的指针变量。必要时要加( ) 来避免优先级的问题。 引申:C语言中,定义变量时,在定义的最前面写上typedef ,那么这个变量名就成了一种类型,即这个类型的同义词。 int a ; //int类型变量 aint *a ; //int* 变量a; E1 ]2 @1 m) F7 T3 j1 M/ ~ int arr[3]; //arr是包含3个int元素的数组 int (* arr )[3]; //arr是一个指向包含3个int元素的数组的指针变量 ! Y8 w& \5 Z& W6 {( Z! E& U int* p_int; //指向int类型变量的指针 double* p_double; //指向idouble类型变量的指针 struct Student *p_struct; //结构体类型的指针5 N7 D3 \; t3 ~' d+ U% v int(*p_func)(int,int); //指向返回类型为int,有2个int形参的函数的指针 int(*p_arr)[3]; //指向含有3个int元素的数组的指针 & T# U R7 _! F int** p_pointer; //指向 一个整形变量指针的指针" Y9 f9 B6 e/ T- ^7 j! C 取地址 既然有了指针变量,那就得让他保存其它变量的地址,使用& 运算符取得一个变量的地址。 int add(int a , int b); k. J, d) ?: l; ?$ T1 b# u/ b{, s1 }0 `; t" @5 T! l; s return a + b;& Z0 `( {9 M3 R' P3 m5 V7 O3 ^ }, d- Q( t( d6 h* I7 o7 ^$ p( Z ) d, f# r: O; k int main(void) {, M' N) G( z# ?$ H7 M- T int num = 97;" o9 ]0 a5 t1 E* N9 E8 t float score = 10.00F; int arr[3] = {1,2,3};: {% f, ]1 S8 E1 Y int* p_num = #; p/ O& K/ ?1 I1 V- o9 F float* p_score = &score; int (*p_arr)[3] = &arr; int (*fp_add)(int ,int ) = add; //p_add是指向函数add的函数指针/ B& B5 S4 I; C2 Z4 e return 0;9 V( W" r+ E; g2 d: M( S } 特殊的情况,他们并不一定需要使用&取地址:
return a + b;- t/ t5 @/ m B" x9 g, {3 E } int main(void) { int arr[3] = {1,2,3}; int* p_first = arr; int (*fp_add)(int ,int ) = add; const char* msg = "Hello world"; return 0;1 h+ X V% J; C( p) ]$ Z$ G }4 m1 f0 O5 L. I7 S5 w2 ~ 解地址 对一个指针解地址,就可以取到这个内存数据,解地址 的写法,就是在指针的前面加一个 * 号。 解指针的实质是:从指针指向的内存块中取出这个内存数据。 int main(void): Z, x% _3 A* \, o9 r{ int age = 19;- P% m% r+ V( z' Y! E$ [+ _ int*p_age = &age; *p_age = 20; //通过指针修改指向的内存数据 # ~% c! t3 G* L( W! Y; u/ N printf("age = %d",*p_age); //通过指针读取指向的内存数据; _3 H0 }5 U6 s: ^& s printf("age = %d",age);8 l, R1 y) c: | S6 v 8 K, }$ v' }0 X5 J/ c8 ] return 0; }' q9 j* b/ d- P! s 空指针 空指针在概念上不同于未初始化的指针。空指针可以确保不指向任何对象或函数;而未初始化的指针则可能指向任何地方。空指针不是野指针。 在C语言中,我们让指针变量赋值为NULL表示一个空指针,而C语言中,NULL实质是 ((void*)0) , 在C++中,NULL实质是0。 #ifdef __cplusplus#define NULL 0/ u4 l. ]9 H) G( }; x #else #define NULL ((void *)0)5 g4 i3 I2 r' C: d3 e1 M( ] #endif' ?5 p& _" @- `+ d3 j void*类型指针 void是一种特殊的指针类型,可以用来存放任意对象的地址。一个void指针存放着一个地址,这一点和其他指针类似。不同的是,我们对它到底储存的是什么对象的地址并不了解。 double a=2.3;int b=5;& ^4 e: ~. P- ]) g. a void *p=&a; cout<<p<<endl; //输出了a的地址 ! g+ P- U5 b9 Z" ?+ l# K9 W4 R p=&b;' Q! n, S" [2 P cout<<p<<endl; //输出了b的地址 + L% \8 B! `. ~: {* ^# i //cout<<*p<<endl;这一行不可以执行,void*指针只可以储存变量地址,不可以直接操作它指向的对象& {8 d; S8 m& d! D$ E. a3 W( z4 G 由于void是空类型,只保存了指针的值,而丢失了类型信息,我们不知道他指向的数据是什么类型的,只指定这个数据在内存中的起始地址,如果想要完整的提取指向的数据,程序员就必须对这个指针做出正确的类型转换,然后再解指针。 数组和指针
{4 m1 l0 X: T1 G; R) G. R7 M int arr[5] = {1,2,3,4,5};7 Q; x8 d$ P5 U* v int *p_first = arr;2 \+ U& e. n# d U9 c! \3 b printf("%d",*p_first); //1/ j% V8 j$ V) A$ P return 0; }
C语言中,实参传递给形参,是按值传递的,也就是说,函数中的形参是实参的拷贝份,形参和实参只是在值上面一样,而不是同一个内存数据对象。这就意味着:这种数据传递是单向的,即从调用者传递给被调函数,而被调函数无法修改传递的参数达到回传的效果。 void change(int a)2 }. r. v% j. M9 m) I( o6 y6 P{ [: M6 ~/ j' B a++; //在函数中改变的只是这个函数的局部变量a,而随着函数执行结束,a被销毁。age还是原来的age,纹丝不动。 }; Q5 l9 X! I' {- h+ U int main(void), j8 b& ]2 T: U% r6 q { int age = 60;! ?" S" N4 `/ d K( P, z change(age); printf("age = %d",age); // age = 600 u5 L6 p5 @1 D7 [4 d. W return 0;( M) c/ B& z; l" Q% L6 ?2 O; ~+ K c }9 W7 Y+ a+ ^3 }5 y 有时候我们可以使用函数的返回值来回传数据,在简单的情况下是可以的,但是如果返回值有其它用途(例如返回函数的执行状态量),或者要回传的数据不止一个,返回值就解决不了了。 传递变量的指针可以轻松解决上述问题。 void change(int* pa)8 Z, J s3 P( o{8 {+ l! A7 g- Q' U (*pa)++; //因为传递的是age的地址,因此pa指向内存数据age。当在函数中对指针pa解地址时,! T3 U1 J" U( Y# f! A6 Q1 ?/ H //会直接去内存中找到age这个数据,然后把它增1。4 m9 [% A w3 S9 e; _) \9 `7 ^ }2 d2 ^+ D* Q/ c# ] int main(void) { int age = 160; P# Q: X( A+ ?% Z change(&age); printf("age = %d",age); // age = 61 return 0; } J. L- k; e. T" c& k 比如指针的一个常见的使用例子: #include <stdio.h>#include <stdlib.h>! r7 y) s n) @- f: O #include <string.h> + c( L( Y+ p5 _( r void swap(int *,int *); int main() { int a=5,b=10;' @' g7 c" s! E9 f1 f L printf("a=%d,b=%d\n",a,b); swap(&a,&b); printf("a=%d,b=%d\n",a,b); return 0; } void swap(int *pa,int *pb) {2 G$ y$ X0 ~: p4 Q, N/ i. }; z2 }+ w3 d int t=*pa;*pa=*pb;*pb=t; } 在以上的例子中,swap函数的两个形参pa和pb可以接收两个整型变量的地址,并通过间接访问的方式修改了它指向变量的值。在main函数中调用swap时,提供的实参分别为&a,&b,这样就实现了pa=&a,pb=&b的赋值过程,这样在swap函数中就通过*pa修改了 a 的值,通过*pb修改了 b 的值。因此,如果需要在被调函数中修改主调函数中变量的值,就需要经过以下几个步骤:
指针作为函数的形参的另一个典型应用是当函数有多个返回值的情形。比如,需要在一个函数中统计一个数组的最大值、最小值和平均值。当然你可以编写三个函数分别完成统计三个值的功能。但比较啰嗦,如: int GetMax(int a[],int n)4 |1 F2 o0 u# J t; b* e{ int max=a[0],i;7 e: i8 ~# \% o6 o4 E: m for(i=1;i<n;i++)9 S) |$ D2 L6 F m! N3 v+ H; x9 s' q { if(max<a) max=a; } return max;1 ?' ]: [# i/ b2 W( a( n, {+ U } int GetMin(int a[],int n), e L) M/ x5 E8 f% ?2 M4 d { int min=a[0],i; for(i=1;i<n;i++) {! w) n# X0 F+ k, O if(min>a) min=a; } return min;: b1 O. T/ [6 H" g } double GetAvg(int a[],int n)" u. h. q0 e1 {7 ?; K( `+ A { q7 J# ~, T, M8 `5 R+ f' | double avg=0; int i; for(i=0;i<n;i++) { avg+=a;" {8 ?: q5 x+ P6 J9 W. C4 d" y( c7 m } return avg/n; }5 u8 s. d A( x K" J v 其实我们完全可以在一个函数中完成这个功能,由于函数只能有一个返回值,可以返回平均值,最大值和最小值可以通过指针类型的形参来进行实现: double Stat(int a[],int n,int *pmax,int *pmin)3 y% g! A0 \+ I{, W5 b/ e1 ~. ?* I0 I. E0 I' Z: g double avg=a[0];# M7 i+ I# z" P- W: e2 y int i;" i$ U, [0 ]2 Z0 O7 w4 I8 P* Z *pmax=*pmin=a[0]; for(i=1;i<n;i++) {. d' r9 p0 w1 _+ k f3 Y- j avg+=a; if(*pmax<a) *pmax=a; ?2 v0 L5 }: x7 |$ [9 f1 I9 Y$ ] if(*pmin>a) *pmin=a;! e1 _& N* u( ?) s+ B& L m } return avg/n; A* P |1 @4 C/ L* Z. F9 {9 F w G } 函数的指针 一个函数总是占用一段连续的内存区域,函数名在表达式中有时也会被转换为该函数所在内存区域的首地址。我们可以把函数的这个首地址赋予一个指针变量,使指针变量指向函数所在的内存区域,然后通过指针变量就可以找到并调用该函数。这种指针就是函数指针。 函数指针的定义形式为: returnType (*pointerName)(param list); returnType 为函数返回值类型,pointerNmae 为指针名称,param list 为函数参数列表。参数列表中可以同时给出参数的类型和名称,也可以只给出参数的类型,省略参数的名称,这一点和函数原型非常类似。 用指针来实现对函数的调用: #include <stdio.h>//返回两个数中较大的一个 int max(int a, int b) { return a>b ? a : b; } int main() {( d, Z7 s. Q$ _ [8 G int x, y, maxval;2 q2 |9 e/ ? }# z1 Q* ~! o2 j //定义函数指针3 S6 i. H K8 Q int (*pmax)(int, int) = max; //也可以写作int (*pmax)(int a, int b) b6 f9 |; Q' i: u R$ D r printf("Input two numbers:");# e; ]7 i5 Z% s3 w3 R scanf("%d %d", &x, &y); maxval = (*pmax)(x, y);' V! j2 q' U( n5 f% f4 G7 @ printf("Max value: %d\n", maxval);( y! X" o) Q2 c! h return 0;' D% L7 I2 q7 S( l2 r+ G _ }/ @8 H# S' D+ H8 h$ G3 n2 \7 ]' `7 { 结构体和指针 结构体指针有特殊的语法: -> 符号 如果p是一个结构体指针,则可以使用 p ->【成员】 的方法访问结构体的成员 typedef struct: x% y+ i7 ?9 y- c{9 D! E* O$ i. c char name[31];3 @# a8 V7 ]' q& q# W& T. w int age;' b5 ^1 v$ \: F/ W( i I float score; }Student;1 {$ q. |( N1 {$ o+ h int main(void)( }) i6 O8 @: B' \5 g! ~ { Student stu = {"Bob" , 19, 98.0}; Student*ps = &stu; , v/ W/ g5 i8 O+ T4 [* r# d ^ ps->age = 20; ps->score = 99.0;9 i* F( o& X. j% Q: c+ p1 F. ^& d printf("name:%s age:%d ",ps->name,ps->age);- C% B8 \3 l* n return 0;0 ]7 `5 l F6 ?+ V. [3 w _ } const 和 指针
# Y) M Z0 }9 f* K int main(). q$ J* `( [* {1 [ { // 1 可改变指针% x9 c/ O' h4 h E# Z% G const int a = 10;% R: n( S# g( o1 Z0 W/ ?( p. z, { int *p = &a; ^9 }0 J l' _- m *p = 1000; printf("*p = %d\n", *p); 9 l; \' W. f( P // 2 可改变指针 const b = 10; int *pb = &b;+ R) ^. b" B+ \: g# F pb = p; printf("*pb = %d\n", *pb);7 Z0 j" K2 m! g& E/ K* i0 d( P // 3& x C9 e5 j @# w% W: e% I6 a, c const c = 10; int * const pc = &c; *pc = 1000;4 S) Z) {. [0 ]2 u7 I //pc = pb;不能改变 0 i5 b) O& z% z) l //49 x" q( ^ c. |6 A9 {, z7 d+ Z const d = 10; const * int const pd = &d;, i3 X* t! k A! @ //*pd = 1000; 不能改变! y. T" l. U, l+ I ' m) q, s# k5 g+ T9 K% D printf("\n"); return 0; } 深拷贝和浅拷贝 如果2个程序单元(例如2个函数)是通过拷贝 他们所共享的数据的 指针来工作的,这就是浅拷贝,因为真正要访问的数据并没有被拷贝。如果被访问的数据被拷贝了,在每个单元中都有自己的一份,对目标数据的操作相互 不受影响,则叫做深拷贝。 #include <iostream>: G3 f# `! X t4 b* e7 b: d) e using namespace std;, ^% O% n! ]2 P1 [ class CopyDemo { public:+ ]* h$ i2 n+ a CopyDemo(int pa,char *cstr) //构造函数,两个参数 F9 D. q" x7 | {) |7 Q8 L9 q3 R% t; M7 Z this->a = pa;2 S* o/ X. |( R. ?6 M6 ? this->str = new char[1024]; //指针数组,动态的用new在堆上分配存储空间 strcpy(this->str,cstr); //拷贝过来 } //没写,C++会自动帮忙写一个复制构造函数,浅拷贝只复制指针,如下注释部分! q5 j, u: s5 c; O' A4 R+ w6 ^5 G. R //CopyDemo(CopyDemo& obj) //{ // this->a = obj.a;8 Z9 X$ @$ q9 b! q: R' c, A1 |8 A, { // this->str = obj.str; //这里是浅复制会出问题,要深复制) i) z+ {4 A D- d- N //}8 P( t0 v0 D3 C CopyDemo(CopyDemo& obj) //一般数据成员有指针要自己写复制构造函数,如下# C: L2 z' q- w8 u9 u0 B { this->a = obj.a; // this->str = obj.str; //这里是浅复制会出问题,要深复制 this->str = new char[1024];//应该这样写1 @! n$ c# L$ _9 K" X/ \6 ` if(str != 0)* w3 L; l9 Q& h4 U2 B$ X& Q strcpy(this->str,obj.str); //如果成功,把内容复制过来) o7 A6 S7 R- I/ @ }: ~( X! c* `- D7 [" Y9 _# F5 O, v7 g ' ~/ v' }% u- `+ a. g ~CopyDemo() //析构函数 {/ [+ p) \ `; V: F1 }& v3 c delete str; }1 f& i2 q1 g* s0 p5 h% e public:$ z3 k- {7 \* ]" ]6 r int a; //定义一个整型的数据成员 char *str; //字符串指针 }; 1 D0 w4 U4 z9 Y+ U8 W4 A int main() { CopyDemo A(100,"hello!!!"); CopyDemo B = A; //复制构造函数,把A的10和hello!!!复制给B cout <<"A:"<< A.a << "," <<A.str << endl; //输出A:100,hello!!! cout <<"B:"<< B.a << "," <<B.str << endl;" O+ M( L/ [0 r. c/ `, M6 F //输出B:100,hello!!! //修改后,发现A,B都被改变,原因就是浅复制,A,B指针指向同一地方,修改后都改变 B.a = 80;, d0 t+ Z7 ^7 q9 a) w2 u B.str[0] = 'k';5 ?. ] @; w* N/ W; d' d5 t cout <<"A:"<< A.a << "," <<A.str << endl;( j. A9 r; t7 e/ s! L //输出A:100,kello!!!. n1 W/ C: I& B9 M- { cout <<"B:"<< B.a << "," <<B.str << endl; //输出B:80,kello!!!" @, J [: l9 g9 | 8 O6 r6 c& {! I9 D9 v return 0; }' B S4 s- F0 h* j2 } F 根据上面实例可以看到,浅复制仅复制对象本身(其中包括是指针的成员),这样不同被复制对象的成员中的对应非空指针会指向同一对象,被成员指针引用的对象成为共享的,无法直接通过指针成员安全地删除(因为若直接删除,另外对象中的指针就会无效,形成所谓的野指针,而访问无效指针是危险的; 除非这些指针有引用计数或者其它手段确保被指对象的所有权);而深复制在浅复制的基础上,连同指针指向的对象也一起复制,代价比较高,但是相对容易管理。 |
| 谢谢分享~~~ |
| 好文章 |
 微信公众号
 手机版


