|
1 前言 今天一起学习一下堆和优先队列,重点是堆排序的理解和优先队列的用法。 通过本文你将了解到以下内容:
数据结构中的堆区别于内存分配的堆,我们说的用于排序的堆是一种表示元素集合的结构,堆是一种二叉树。 看看维基百科中对于堆的定义和说明: 2.2 堆的两个特性 堆有两个决定性特性:元素顺序和树的形状
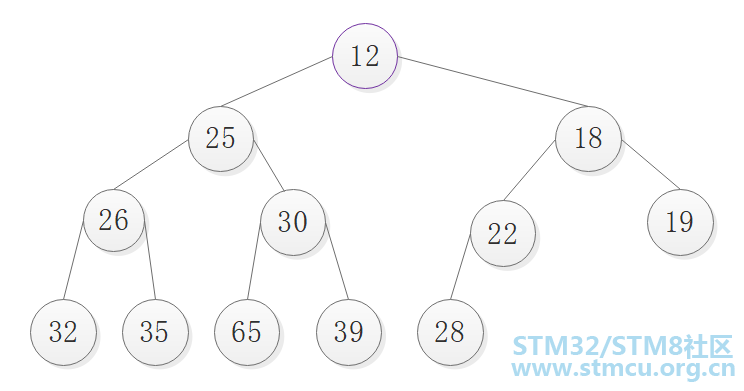
在堆中任何结点与其子结点的大小都遵守数值大小关系。 A. 如果结点大于等于其所有子结点,也就是堆的根是所有元素中最大的,这种堆称为大根堆(大顶堆、最大堆); B. 如果结点小于等于其所有子结点,也就是堆的根是所有元素中最小的,这种堆称为小根堆(小顶堆、最小堆); C. 大根堆/小根堆只是约定了父结点和子结点的大小关系,但是并不约束子结点的相对大小和顺序; 如图为小根堆结构:
堆这种二叉树最多在两层具有叶子结点,并且最底层的叶子结点靠左分布,该树种不存在空闲位置,也就是堆是个完全二叉树。 上述的两种性质可以保证快捷找到最值,并且在插入和删除新元素时可以实现重新组织再次满足堆的性质。 2.3 堆的数组表示堆中没有空闲位置并且数组是连续的,但是数组的下标是从0开始,为了统一,我们统一从1开始,也就是root结点的数组index=1,那么可以通过数组的index可以通过父结点找到左右子结点,也可以通过子结点找到父结点。 数组的元素遍历就是堆的层次遍历的结果,因此数组存储的堆具备以下性质: //数组下标范围; ]$ t; o3 g Z% k# Ji<=n && i>=1+ s5 U- p: n: Q //根结点下标为11 S: \# I g! r( U9 g root_index = 1 //层次遍历第i个结点的值等于数组第i个元素 value(i) = array# w9 t! _* v; k6 w/ ^ //堆中第i个元素的左孩子下标i*2 left_child_index(i) = i*2 //堆中第i个元素的右孩子下标i*2+10 z% x& _( V" W" ~ right_child_index(i) = i*2+1 //堆中第i个元素的父结点下标i/2 parent(i) = i/2# J/ |+ Z1 b; ^' }9 ]: R 堆和数组的对应关系如图: 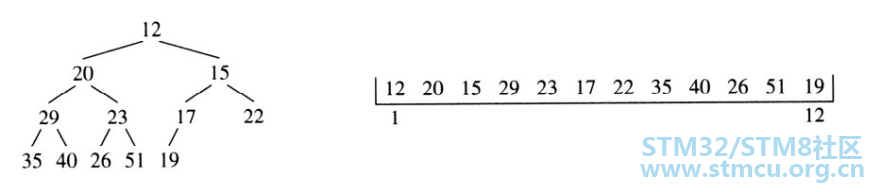
堆调整的过程非常像数学归纳法的递推过程,看一下就知道,敲黑板!以下两个函数对于掌握堆非常重要。 2.4.1 siftup函数的原理以小根堆为例,之前a[1...n-1]满足堆的特性,在数组a[n]插入新元素之后,就产生了两种情况: 循环过程:自底向上的调整过程就是新加入元素不断向上比较置换的过程,直到新结点的值大于其父结点,或者新结点成为根结点为止。 heap(1,n-1) == True void siftup(n)- X: m" S8 K) Z9 [2 Y% \ i = n loop: // 循环停止条件一 // 已经是根结点6 P0 D! g$ Q+ ~ if i == 1:# |+ `% A, Q/ z6 {' F5 H7 ? break; p = i/2 // 循环停止条件二 // 调整结点大于等于在此位置的父结点6 E6 t( v3 I' i( p if a[p] <= a break; swap(a[p],a)7 l, j) {" v5 m! e9 D& M // 继续向上循环 i = p siftup调整过程演示 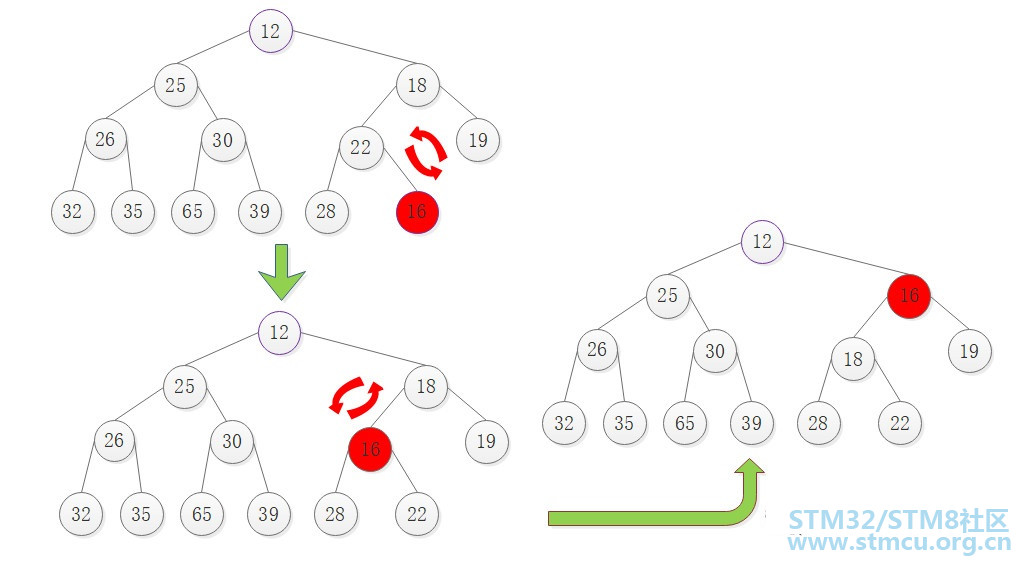
以小根堆为例,之前a[1...n]满足堆的特性,在数组a[1]更新元素之后,就产生了两种情况:! n. z, \8 P( r& B( J8 ^ 循环过程:自顶向下的调整过程就是新加入元素不断向下比较置换的过程,直到新结点的值小于等于其子结点,或者新结点成为叶结点为止。 void siftdn(n)1 C$ D5 C; y& P& @' y i = 1 loop:) L' \: u& g! `0 j // 获取理论上的左孩子下标1 |5 y7 {: q3 F+ e7 J# P c = 2*i // 如果左孩子下标已经越界 // 说明当前已经是叶子结点* H% [3 o' C# P4 ~" r+ B3 B- e9 k if c > n:3 l& h! f. U. M break;: s5 y! A) D9 ?9 \6 G& @! k/ I //如果存在右孩子 // 则获取左右孩子中更小的一个 // 和父结点比较4 o9 y! b$ S4 ? if c+1 <= n:* I! ]3 W; ]7 O; d; [: t; Z if a[c] > a[c+1]) v" p6 d0 E# G7 a6 s4 U" V c++- T- u: N) ~9 h1 ^2 M" ]& w- d // 父结点小于等于左右孩子结点则停止$ X; e1 j' c, ~/ r$ { C4 I4 S if a <= a[c] break; // 父结点比左右孩子结点大 // 则与其中较小的孩子结点交换' t7 C0 s0 ^% v. f/ g [' T // 也就是让原来的孩子结点成为父结点 swap(a,a[c])5 e; h% j( N# y* c+ X // 继续向下循环 i = c siftdn调整过程演示 在头部元素更新为21的调整过程如图: 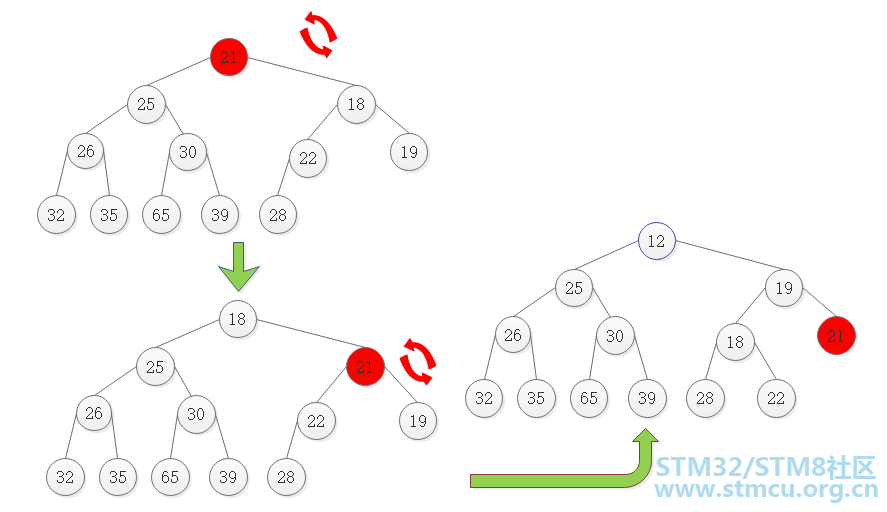
场景:假如有200w数据,要找最大的前10个数。 分析:那么就需要先建立大小为10个元素的小顶堆,然后再逐渐把其他所有元素依次渗透进来比较或入堆淘汰老数据或跳过,直至所有数据渗透完成,最后小根堆的10个元素就是最大的10个数了。 小根堆:选择最大的TopN个数据使用小根堆,因为堆顶就是最小的数据,每次进来的新数据只需要和堆顶比较即可,如果小于堆顶则跳过,如果大于堆顶则替换掉堆顶进行siftdn调整,来找到新进元素的正确位置,以及产生新的堆顶。 建堆过程:可以自顶向下自底向上均可,以下采用自底向上思路分析。可以将数组的叶子节点,是单个结点满足二叉堆的定义,于是从底层叶子结点的父结点从左到右,逐个向上构建二叉堆,直到第一个节点时整个数组就是一个二叉堆,这个过程是siftup和siftdn的混合,宏观上来看是自底向上,微观上每个父结点是自顶向下。 渗透排序过程:完成堆化之后,开处理N之后的元素,从N+1~200w,遇到比当前堆顶大的则与堆顶元素交换,进入堆触发siftdn调整,直至生产新的小根堆。 代码实战:leetCode 第215题 数组中的第K个最大元素。 这道题可以用堆排序来完成,建立小根堆取堆顶元素即可,验证通过的代码举例: //leetcode 215th the Kth Num//Source Code:C++! t& G1 f \4 M' F class Solution { public:1 |3 L& V s }( |$ _: W //调整以当前节点为根的子树为小顶堆6 ]; m7 n- l9 I/ |# K, G' c, J int heapadjust(vector<int> &nums,int curindex,int len){ int curvalue = nums[curindex];3 [$ }/ B* I r int child = curindex*2+1;8 f3 k5 O& c3 y, u9 P' F: m while(child<len){8 W* O% C* u# P, ~ //左右孩子中较小的那个 if(child+1<len && nums[child] > nums[child+1]){ child++; } //当前父节点比左右孩子其中一个大" T# q) t* U$ J J) B6 k1 U' b if(curvalue > nums[child]){ nums[curindex]=nums[child]; curindex = child;' Q& L+ B, U( o8 g+ n D* a child = curindex*2+1; 5 R$ [" }6 d; J4 x$ j }else{ break;1 ?" }5 o& A, Z2 j } } nums[curindex]=curvalue; return 0; }' ^: U" ?' L# \ int findKthLargest(vector<int>& nums, int k) { //边界条件 if(nums.size()<k)+ V2 y/ _' V0 E8 U, G return -1; //建立元素只有K个的小顶堆, j/ B$ n. G' \ //截取数组的前k个元素# C# B! K8 n( N& V/ A+ \. T; u- Q vector<int> subnums(nums.begin(),nums.begin()+k); int len = nums.size(); int sublen = subnums.size();# d# t+ R% a, e8 L1 |; K- S4 R //将数组的前k个元素建立小顶堆 for(int i=sublen/2-1;i>=0;i--){ heapadjust(subnums,i,sublen);' o) t3 O x7 V# G5 e } //建立好小顶堆之后 开始逐渐吸收剩余的数组元素6 `1 M" v# j" w3 J" X //动态与堆顶元素比较 替换3 A+ k+ k% S7 n2 a! E0 c3 Y# w for(int j=k;j<len;j++){: @, p4 d. H& D8 T5 ~ if(nums[j]<=subnums[0])6 k2 H6 v$ Z# S0 \4 ^ continue; subnums[0] = nums[j]; heapadjust(subnums,0,sublen); }8 j4 p# o; o) R+ _ return subnums[0]; ; Z% {1 c+ _' Q+ ~% e j }' ?- g5 p( W; P6 @4 N0 @ };2.6 堆小结 从实践来看,堆的重要用途是堆排序,堆排序重点是初始化堆和调整堆两个过程,然而这两个过程都离不开siftup和siftdn两个函数,因此掌握这两个函数,基本上就掌握了堆。 由于堆是二叉树,因此在实际使用中需要结合树的遍历和循环来实现堆调整,掌握堆调整过程和二叉树遍历过程,拿下堆,指日可待。 3 优先队列先来看看维基百科对优先队列的定义:
由于优先队列的元素既可以是基础类型,也可以是复合类型,因此在C++中一般使用模板来定义优先队列,从而提高其可扩展性,简单定义: template<class T>class priqueue {+ a# e; f3 c* [4 ` public: //构造函数 初始化 priqueue(int maxsize);) t; n. J4 v/ M) H //将T类型新元素添加到队列中& o% y# C O; c void insert(T t); //获取队列中最小的元素4 d& R5 N5 j' l. R, A- }" D1 @8 j T extractmin(); };3.1 优先队列的理论实现 实现优先队列的候选数据结构包括:有序序列、无序序列、堆。
综上可知,堆结构在实现优先队列的插入和删除操作时复杂性都很稳定,在大量数据的场景下优于有序序列和无序序列,因此权衡之下选择堆作为优先队列的底层数据结构。 3.2 优先队列的工程实现考虑优先队列的灵活性和效率,可以基于模板化和堆来实现优先队列: template<class T>class priqueue { private:4 g! O' @- s. A/ F int n,maxsize; T *x;0 h6 r9 O6 v" K: a1 Y$ ` void swap(int i,int j) { T t = x; x = x[j]; x[j] = t; }. u+ ?5 |/ H( P: h: I# `! I8 { public:; N A# Y, j! P7 t { //初始化5 k' }. X, D' F | priqueue(int m)$ Z3 n6 J" O1 R# n" s. u1 ` { maxsize = m;* s% I z% S1 v- l2 k3 S) q x = new T[maxsize+1]; n = 0; }2 R( V) o, [5 ~ //插入新数据2 U2 g, Y8 {3 e# S6 a; W8 ]) t7 F1 M- f" J void insert(T t) { int i,p;% H& J1 Z" ^+ i4 r x[++n] = t; //末尾添加新数据 执行siftup操作: p6 J$ A5 E$ U% ^1 @. \5 M for (i = n; i > 1 && x[p=i/2] > x; i = p) swap(p,i); q! m9 _9 y$ s1 q( M( s }5 B0 _1 C0 G7 b+ s& b3 r1 o //提取操作( ^+ V5 g. d8 m% U* W T extractmin()# m6 e3 t3 H& o { int i,c;9 k" b+ J: w; t3 p/ V/ I7 g9 ^ //提取堆顶元素 T t = x[1]; //将尾部元素放到堆顶 x[1] = x[n--];+ Z) R! ?! N' z, _9 T5 x //针对新堆顶进行siftdn操作 for (i = 1; (c = 2*i) <= n; i = c) { if (c+1 <= n && x[c+1] < x[c])/ P) N/ c+ d8 o" V$ I7 N3 D c++;% o7 ~, X8 F2 P1 n4 T/ ~' D1 ]2 ~ if (x <= x[c]) break; swap(c,i);# G; _, v2 [. U; {% _ V' y5 ~2 N } return t; }' ]+ c8 a4 c! B& c5 L: P5 x }; 上述代码摘自编程珠玑并不是STL关于优先队列的实现,只是一部分简洁的代码,旨在表现insert和extract操作时如何运用堆的siftup和siftdn操作来封装成优先队列类的基础成员函数。 3.3 优先队列的自定义优先级 模板化的优先队列扩展了使用场景,但是也产生了新的问题,就是默认的优先级比较函数不一定满足所有要求,因此很多时候都需要自己来定义优先级判定函数。 实现了一个模板优先队列需要三个参数:
// 队列和优先队列的声明! t; {$ t, E: [) Q) V) C. i6 ~ std::queue<T> pq;' [( s/ G2 O+ t( x. j$ [1 N, e std::priority_queue<T, std::vector<T>, cmp> pq; //模板化优先队列的主要参数 priority_queue<Type, Container, Func>+ @9 Q; Q$ V: I# J; N5 P: \ //举例6 A. c& v! g8 c priority_queue<pair<char,int>,vector<pair<char,int>>,compare> pq;/ j# Z# Y' [$ f. t. t* q //自定义比较函数 struct compare { bool operator()(const pair<char,int> a,const pair<char,int> b){+ h$ A& ^5 G4 G return b.second > a.second; w/ j; {- h! {6 M } }; 3.4 优先队列的应用 可以认为优先队列是对堆的工具化封装,加上模板和自定义比较函数两个利器加持,优先队列让使用者不再苦于堆排序的原始造轮子。 TopN问题和优先队列 仍以LeetCode 215题为例,获取数组第K大元素。 上一节中我们直接使用堆,但是构建的是小顶堆,并且大小是K个元素,遍历完成之后直接取堆顶即可,但是在数据量不大或者内存足够的情况下,可以直接建立优先队列。 默认的优先队列本质上是大顶堆,那么堆顶就不是第K大元素了,但是从堆顶开始依次pop出K-1个元素,堆顶也就是第K大元素了。 当然也可以修改比较函数实现小顶堆,取堆顶元素也是可以的,要灵活运用。使用优先队列实现LeetCode 第215题,代码如下: //默认的比较函数是less 也就是优先队列相当于最大堆//堆顶元素为最大值 priority_queue<int,vector<int>,less<int>> q; int findKthLargest(vector<int>& nums, int k) {6 M# N! i5 _ @& S: f7 F priority_queue<int> q(nums.begin(),nums.end());: }: z. s+ L" N! n- c6 L% O for(int i=0;i<k-1;i++) q.pop(); return q.top(); } 优先队列是贪心算法的重要组成部分,借助于优先队列贪心算法可以解决非常多的实际问题包括:
|
 微信公众号
 手机版