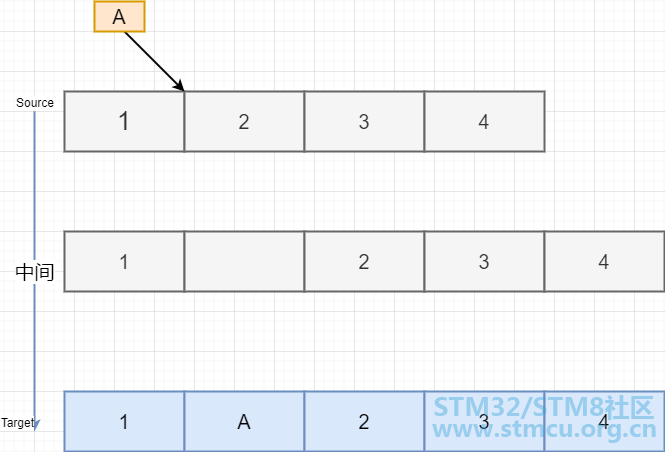
顺序存储和链式存储数组—顺序存储 数组作为一个顺序储存方式的数据结构,可是有大作为的,它的灵活使用为我们的程序设计带来了大量的便利; 但是,但是,数组最大的缺点就是我们的插入和删除时需要移动大量的元素,所以呢,大量的消耗时间,以及冗余度难以接受了。 以C语言数组插入一个元素为例,当我们需要在一个数组{1,2,3,4}的第1个元素后的位置插入一个’A’时,我们需要做的有:
上图可以看出,使用数组都有这两大缺点:
由于数组的这些缺点,自然而然的就产生链表的思想了。 链表通过不连续的储存方式,自适应内存大小,以及指针的灵活使用,巧妙的简化了上述的内容。 链表的基本思维是,利用结构体的设置,额外开辟出一份内存空间去作指针,它总是指向下一个结点,一个个结点通过NEXT指针相互串联,就形成了链表。
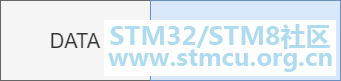
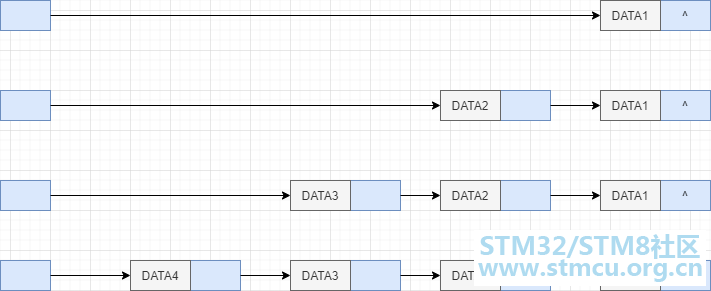
其中DATA为自定义的数据类型,NEXT为指向下一个链表结点的指针,通过访问NEXT,可以引导我们去访问链表的下一个结点。 对于一连串的结点而言,就形成了链表如下图:
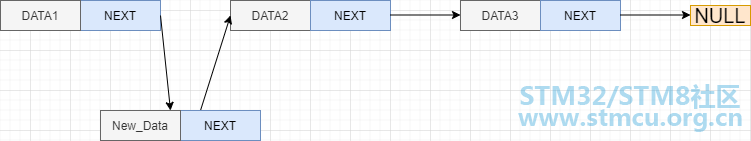
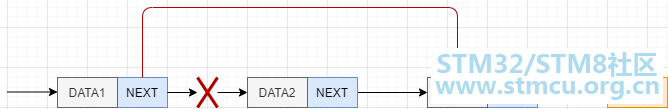
上文所说的插入删除操作只需要修改指针所指向的区域就可以了,不需要进行大量的数据移动操作。如下图:
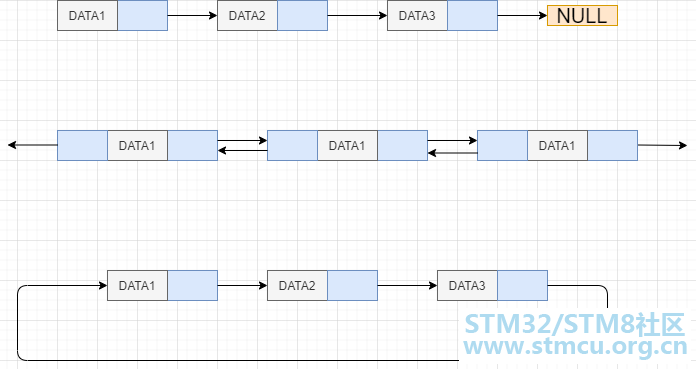
相比起数组,链表解决了数组不方便移动,插入,删除元素的弊端,但相应的,链表付出了更加大的内存牺牲换来的这些功能的实现。 链表概述包含单链表,双链表,循环单链表,实际应用中的功能不同,但实现方式都差不多。
单链表概念和简单的设计 单链表是一种链式存取的数据结构,链表中的数据是以结点来表示的,每个结点由元素和指针构成。 元素表示数据元素的映象,就是存储数据的存储单元;指针指示出后继元素存储位置,就是连接每个结点的地址数据。 以结点的序列表示的线性表称作线性链表,也就是单链表,单链表是链式存取的结构。 对于链表的每一个结点,我们使用结构体进行设计,其主要内容有:
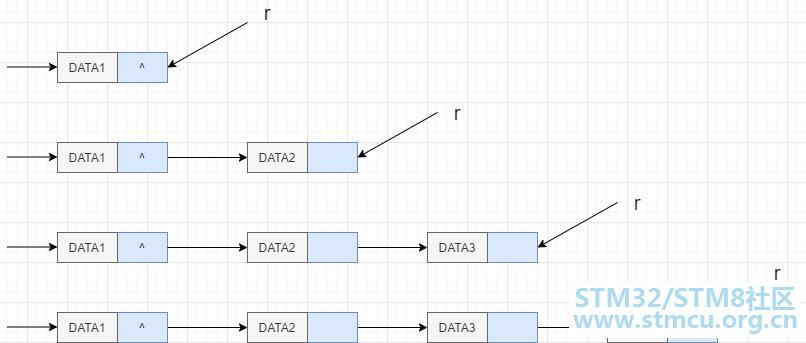
其中,DATA数据元素,可以为你想要储存的任何数据格式,可以是数组,可以是int,甚至可以是结构体(这就是传说中的结构体套结构体) NEXT为一个指针,其代表了一个可以指向的区域,通常是用来指向下一个结点,链表的尾部NEXT指向NULL(空),因为尾部没有任何可以指向的空间了 故,对于一个单链表的结点定义,可以代码描述成: //定义结点类型typedef struct Node {) \ @8 C( m) f3 S2 C% Q int data; //数据类型,你可以把int型的data换成任意数据类型,包括结构体struct等复合类型( I1 Z ^4 e" ?3 y2 m# I( U struct Node *next; //单链表的指针域 } Node,*LinkedList; //Node表示结点的类型,LinkedList表示指向Node结点类型的指针类型 链表的初始化 初始化主要完成以下工作:创建一个单链表的前置节点并向后逐步添加节点,一般指的是申请结点的空间,同时对一个结点赋空值(NULL),其代码可以表示为: LinkedList listinit(){; N3 l0 B u8 p! ?% ZNode *L; L=(Node*)malloc(sizeof(Node)); //开辟空间 if(L==NULL){ //判断是否开辟空间失败,这一步很有必要8 \2 q% C# I9 f' { printf("申请空间失败"); //exit(0); //开辟空间失败可以考虑直接结束程序 }# p. Y" S' W- O+ g8 U% t L->next=NULL; //指针指向空( r+ j! c/ S0 u; v2 n: S } 注意:一定要判断是否开辟空间失败,否则生产中由于未知的情况造成空间开辟失败,仍然在继续执行代码,后果将不堪设想啦,因此养成这样的判断是很有必要的。 头插入法创建单链表利用指针指向下一个结点元素的方式进行逐个创建,使用头插入法最终得到的结果是逆序的。如图所示:
从一个空表开始,生成新结点,并将读取到的数据存放到新结点的数据域中,然后将新结点插入到当前链表的表头,即头结点之后。 //头插法建立单链表 v/ Y6 E; {/ wLinkedList LinkedListCreatH() {( k8 e ]. P7 N0 j Node *L; L = (Node *)malloc(sizeof(Node)); //申请头结点空间% `: n/ R* f, M- W: p& u$ { L->next = NULL; //初始化一个空链表 3 F3 k) ?( |( u' D1 w1 B int x; //x为链表数据域中的数据! V* `. t7 o! U- B8 O* \! ^ while(scanf("%d",&x) != EOF) { Node *p;8 u* n& |8 T8 `& m { \/ @$ O p = (Node *)malloc(sizeof(Node)); //申请新的结点 p->data = x; //结点数据域赋值9 L6 }9 o# x b" _/ k$ x: F p->next = L->next; //将结点插入到表头L-->|2|-->|1|-->NULL L->next = p;4 E- R+ R5 }5 h: h4 Q }! J) e, }( _$ X1 J% ?+ s return L;# J s9 [( T, S$ ^8 w9 c2 e5 J }4 g0 c2 {! e* ]3 I9 U: T; k" ^ 尾插入法创建单链表 如图所示为尾插入法的创建过程。
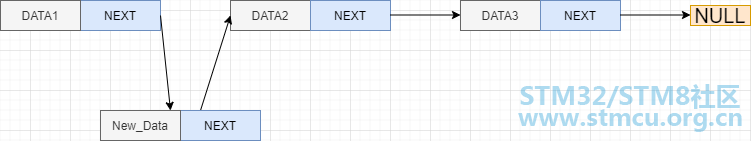
头插法生成的链表中,结点的次序和输入数据的顺序不一致。若希望两者次序一致,则需要尾插法。 该方法是将新结点逐个插入到当前链表的表尾上,为此必须增加一个尾指针r, 使其始终指向当前链表的尾结点,代码如下: //尾插法建立单链表% j% S/ C- g0 F. G LinkedList LinkedListCreatT() { Node *L; L = (Node *)malloc(sizeof(Node)); //申请头结点空间6 g0 F; g* m. q1 M/ `; [! K L->next = NULL; //初始化一个空链表- ?# r- \2 m" U5 z* H) w/ { Node *r; r = L; //r始终指向终端结点,开始时指向头结点) n& w7 I; k- F. w6 ~- j, ~ int x; //x为链表数据域中的数据: S+ b! z1 C0 l) ]$ N. R4 x while(scanf("%d",&x) != EOF) {; X% @$ N$ {! t Node *p;6 G+ m# _: x! E p = (Node *)malloc(sizeof(Node)); //申请新的结点: R+ P* G0 _: I, w, R4 S p->data = x; //结点数据域赋值 r->next = p; //将结点插入到表头L-->|1|-->|2|-->NULL r = p; }- `1 ^5 M# x% o# r7 e r->next = NULL;9 A ]6 j6 S! i0 p. L- n, @& d; O return L;- @' T2 }2 T, w" Q7 q }( h y7 L- h6 i 遍历单链表如打印、修改 从链表的头开始,逐步向后进行每一个元素的访问,称为遍历。 对于遍历操作,我们可以衍生出很多常用的数据操作,比如查询元素,修改元素,获取元素个数,打印整个链表数据等等。 进行遍历的思路极其简单,只需要建立一个指向链表L的结点,然后沿着链表L逐个向后搜索即可,代码如下: //便利输出单链表. t, O4 z' h2 N: `. @5 zvoid printList(LinkedList L){ Node *p=L->next; int i=0; while(p){ printf("第%d个元素的值为:%d\n",++i,p->data); p=p->next; }2 k! {* E, M$ L4 x }& Q& E9 C* ?. j% N1 N2 r: G 对于元素修改操作,以下是代码实现: //链表内容的修改,在链表中修改值为x的元素变为为k。& O2 ~3 j" P, z) A, e7 _' C! `LinkedList LinkedListReplace(LinkedList L,int x,int k) {9 Z( ~( b3 p5 R, ~ Node *p=L->next;# E3 M$ ?+ M' J7 ~! D6 a6 a) H int i=0;# F1 f" O: Z6 M% S. o5 g while(p){ if(p->data==x){ p->data=k;! A3 W4 J. L2 y" W/ D. f; y }# z$ a# A2 X9 i2 X* T4 k p=p->next;# m; H+ w w/ V( Y }; p! X5 i6 `, o- P& y1 {2 o return L; } 简单的遍历设计的函数只需要void无参即可,而当涉及到元素操作时,可以设计一个LinkedList类型的函数,使其返回一个操作后的新链表。 插入操作链表的插入操作主要分为查找到第i个位置,将该位置的next指针修改为指向我们新插入的结点,而新插入的结点next指针指向我们i+1个位置的结点。 其操作方式可以设置一个前驱结点,利用循环找到第i个位置,再进行插入。 如图,在DATA1和DATA2数据结点之中插入一个NEW_DATA数据结点: 从原来的链表状态
到新的链表状态:
代码实现如下: //单链表的插入,在链表的第i个位置插入x的元素LinkedList LinkedListInsert(LinkedList L,int i,int x) { Node *pre; //pre为前驱结点 pre = L; int tempi = 0;% s/ R9 T' B* k) I3 j3 M for (tempi = 1; tempi < i; tempi++) {& I6 Y8 Q( {3 T, d, W( [ pre = pre->next; //查找第i个位置的前驱结点* t5 k% Q1 e; t/ F9 ? }$ L/ ]5 ?' {. i$ ?$ Z) B Node *p; //插入的结点为p3 ~( f- i; X. p/ l' D9 O' w p = (Node *)malloc(sizeof(Node)); p->data = x; P; G3 {+ U) \* W6 q p->next = pre->next; pre->next = p; return L; }" [8 a, D+ h1 s% ~7 L& K1 Q 删除操作 删除元素要建立一个前驱结点和一个当前结点,当找到了我们需要删除的数据时,直接使用前驱结点跳过要删除的结点指向要删除结点的后一个结点,再将原有的结点通过free函数释放掉。如图所示:
代码如下: //单链表的删除,在链表中删除值为x的元素; N8 w+ y- w, w3 z+ S( }2 J3 `) E; v. z% _: f1 @$ y% v( R LinkedList LinkedListDelete(LinkedList L,int x) { Node *p,*pre; //pre为前驱结点,p为查找的结点。" j7 J; E# E, i+ |% x# w8 j% A p = L->next; while(p->data != x) { //查找值为x的元素. r* [: J+ M+ L0 I pre = p;* v, @2 f$ `, f+ j4 |1 t8 y/ t p = p->next;, f- { S2 Q- e) s: G2 j' b }$ M! R; ?- {) S" r+ e pre->next = p->next; //删除操作,将其前驱next指向其后继。 free(p); / J! A; n( [8 P% h return L;" x2 ]" {* [3 @ } + s1 m5 m6 m, h 双向链表1 o9 ?' o @* d4 O& w+ [ 双向链表的简介以及概念 单链表是指结点中只有一个指向其后继的指针,具有单向性,但是有时需要搜索大量数据的时候,就需要多次进行从头开始的遍历,这样的搜索就不是很高效了。 在单链表的基础上,对于每一个结点设计一个前驱结点,前驱结点与前一个结点相互连接,构成一个链表,就产生了双向链表的概念了。 双向链表可以简称为双链表,是链表的一种,它的每个数据结点中都有两个指针,分别指向直接后继和直接前驱。所以,从双向链表中的任意一个结点开始,都可以很方便地访问它的前驱结点和后继结点。 
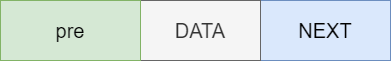
一个完整的双向链表应该是头结点的pre指针指为空,尾结点的next指针指向空,其余结点前后相链。 双向链表的结点设计对于每一个结点而言,有:
其中,DATA表示数据,其可以是简单的类型也可以是复杂的结构体; pre代表的是前驱指针,它总是指向当前结点的前一个结点,如果当前结点是头结点,则pre指针为空; next代表的是后继指针,它总是指向当前结点的下一个结点,如果当前结点是尾结点,则next指针为空 其代码设计如下: typedef struct line{+ `4 j9 Q `& v G1 S, S9 hint data; //data& d; w. Z( x, x struct line *pre; //pre node4 S8 \. [1 y! C3 `3 N struct line *next; //next node }line,*a; //分别表示该结点的前驱(pre),后继(next),以及当前数据(data)
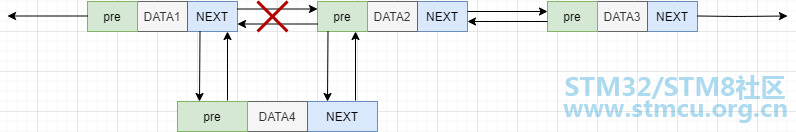
创建双向链表需要先创建头结点,然后逐步的进行添加双向链表的头结点是有数据元素的,也就是头结点的data域中是存有数据的,这与一般的单链表是不同的。 对于逐步添加数据,先开辟一段新的内存空间作为新的结点,为这个结点进行的data进行赋值,然后将已成链表的上一个结点的next指针指向自身,自身的pre指针指向上一个结点。 其代码可以设计为: //创建双链表* X, d+ d5 j- t) F3 k0 P# s" Y. bline* initLine(line * head){ int number,pos=1,input_data; //三个变量分别代表结点数量,当前位置,输入的数据5 Q9 |% R: @0 ~. O* x- D printf("请输入创建结点的大小\n"); scanf("%d",&number);, f3 a5 w4 K+ M+ x' B if(number<1){return NULL;} //输入非法直接结束 //////头结点创建/////// head=(line*)malloc(sizeof(line)); head->pre=NULL; head->next=NULL;# Q# k. ~/ {" P printf("输入第%d个数据\n",pos++);7 _' X6 T p0 d" D scanf("%d",&input_data); head->data=input_data;7 {+ E) @ r4 z9 J) _ j7 ^" D+ b# a& f0 x8 G9 m+ t line * list=head; while (pos<=number) { line * body=(line*)malloc(sizeof(line)); body->pre=NULL;/ e/ R b0 r* H7 a) x( C+ {5 v F body->next=NULL; printf("输入第%d个数据\n",pos++); scanf("%d",&input_data); body->data=input_data;/ i* g W' b' y# I2 ]) | ' C9 O9 z; [0 @" x4 R9 k list->next=body; body->pre=list;9 l* a7 M) l8 ~8 D" H/ C list=list->next;, e5 G6 @8 F8 p2 M# s. @ } return head;" o' H/ j) E s5 |/ M9 |# w5 q, A } 双向链表创建的过程可以分为:创建头结点->创建一个新的结点->将头结点和新结点相互链接->再度创建新结点,这样会有助于理解。 双向链表的插入操作如图所示:
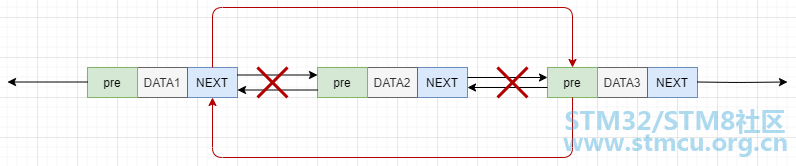
对于每一次的双向链表的插入操作,首先需要创建一个独立的结点,并通过malloc操作开辟相应的空间; 其次我们选中这个新创建的独立节点,将其的pre指针指向所需插入位置的前一个结点; 同时,其所需插入的前一个结点的next指针修改指向为该新的结点,该新的结点的next指针将会指向一个原本的下一个结点,而修改下一个结点的pre指针为指向新结点自身,这样的一个操作我们称之为双向链表的插入操作。 其代码可以表示为: //插入数据8 q3 Y* J; v) a- W5 H3 r' Sline * insertLine(line * head,int data,int add){ //三个参数分别为:进行此操作的双链表,插入的数据,插入的位置 W7 k+ s( U. g- @2 t, U4 B; B //新建数据域为data的结点. e1 d( w4 u7 a6 v& B line * temp=(line*)malloc(sizeof(line));0 H% I' J, ] g1 v temp->data=data; temp->pre=NULL;9 z/ D* b1 b6 |4 ~ temp->next=NULL; //插入到链表头,要特殊考虑% T% B7 s. ]! J5 ` if (add==1) {4 C7 `9 |4 m3 c temp->next=head; head->pre=temp;; i; [7 y/ u! p" J head=temp; }else{' I. H( F1 k2 { v$ ^* B$ p line * body=head;$ {& d. s* y+ X: I1 Y, f2 y //找到要插入位置的前一个结点$ b8 ?( P4 S6 A3 U4 Y for (int i=1; i<add-1; i++) {9 v0 W8 `$ @& ^& [" S body=body->next; } //判断条件为真,说明插入位置为链表尾 if (body->next==NULL) { body->next=temp;! ^7 @& ? \5 a temp->pre=body; }else{ body->next->pre=temp;2 A6 a! ]2 [# C. b2 H! H temp->next=body->next; body->next=temp;+ n7 G) }- e ` temp->pre=body;3 J, U& r, v) ?( Z }- ?$ s: i) X( O2 _- d2 C% O" G }, R x" Y1 }5 W! ` return head; } 双向链表的删除操作 如图:
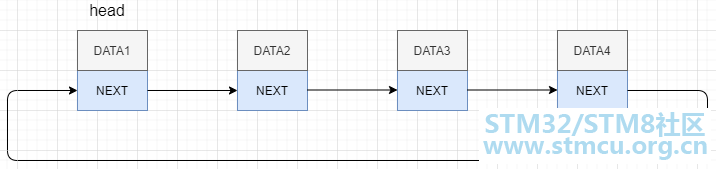
删除操作的过程是:选择需要删除的结点->选中这个结点的前一个结点->将前一个结点的next指针指向自己的下一个结点->选中该节点的下一个结点->将下一个结点的pre指针修改指向为自己的上一个结点。 在进行遍历的时候直接将这一个结点给跳过了,之后,我们释放删除结点,归还空间给内存,这样的操作我们称之为双链表的删除操作。 其代码可以表示为: //删除元素line * deleteLine(line * head,int data){5 O* @% K7 n0 S //输入的参数分别为进行此操作的双链表,需要删除的数据0 a1 r1 w$ _7 y; R3 n) C# e line * list=head;* {+ A1 z c) J* e; d9 Y7 u //遍历链表: V2 N9 S/ u; n, q while (list) { //判断是否与此元素相等 //删除该点方法为将该结点前一结点的next指向该节点后一结点1 k' {# x, }: V$ A. R$ P' a //同时将该结点的后一结点的pre指向该节点的前一结点 if (list->data==data) { list->pre->next=list->next;, S' [) B, ?* `3 C list->next->pre=list->pre;1 h6 }# N- m9 C free(list);+ v! K) V" A' C: [8 P7 b, ~# \/ z printf("--删除成功--\n");( k/ Y& ~8 R! H* X, h1 ` return head;2 P7 O1 H& d" F1 R } list=list->next;" c$ L' J1 z$ I5 h+ A* _- I }+ F% n2 I5 @8 U. b9 l4 W; y2 I7 \ printf("Error:没有找到该元素,没有产生删除\n"); return head;; ?% n; ~! L ~/ ~3 _ }$ n! k6 O V# ^8 v3 ^2 s& p 双向链表的遍历 双向链表的遍历利用next指针逐步向后进行索引即可。 注意,在判断这里,我们既可以用while(list)的操作直接判断是否链表为空,也可以使用while(list->next)的操作判断该链表是否为空,其下一节点为空和本结点是否为空的判断条件是一样的效果。 其简单的代码可以表示为: //遍历双链表,同时打印元素数据void printLine(line *head){ line *list = head; int pos=1; while(list){3 @1 `1 m1 D# l printf("第%d个数据是:%d\n",pos++,list->data);% B5 f' v; D3 a list=list->next;; C! k% G) r+ A- c } } 循环链表循环链表概念 对于单链表以及双向链表,就像一个小巷,无论怎么走最终都能从一端走到另一端,顾名思义,循环链表则像一个有传送门的小巷,当你以为你走到结尾的时候,其实这就是开头。 循环链表和非循环链表其实创建的过程唯一不同的是,非循环链表的尾结点指向空(NULL),而循环链表的尾指针指向的是链表的开头。 通过将单链表的尾结点指向头结点的链表称之为循环单链表(Circular linkedlist) 一个完整的循环单链表如图:
对于循环单链表的结点,可以完全参照于单链表的结点设计,如图: 
data表示数据; next表示指针,它总是指向自身的下一个结点,对于只有一个结点的存在,这个next指针则永远指向自身,对于一个链表的尾部结点,next永远指向开头。 其代码如下: typedef struct list{7 p) l; Q3 E! a+ w% q$ Z e$ E int data; struct list *next; }list; //data为存储的数据,next指针为指向下一个结点 循环单链表初始化 先创建一个头结点并且给其开辟内存空间,在开辟内存空间成功之后,将头结点的next指向head自身,创建一个init函数来完成; 为了重复创建和插入,我们可以在init函数重新创建的结点next指向空,而在主函数调用创建之后,将head头结点的next指针指向自身。 这样的操作方式可以方便过后的创建单链表,直接利用多次调用的插入函数即可完成整体创建。 其代码如下: //初始结点list *initlist(){ list *head=(list*)malloc(sizeof(list)); if(head==NULL){0 C3 E& d3 V/ B% U( L& [ printf("创建失败,退出程序");3 j/ z3 t9 _ g$ \ exit(0); }else{ head->next=NULL;/ ?# X7 O& U% l+ i return head; } } 在主函数重调用可以是这样 //////////初始化头结点//////////////list *head=initlist();7 [ [ t& K0 W7 G T- I1 n head->next=head; 循环链表的创建操作 如图所示: 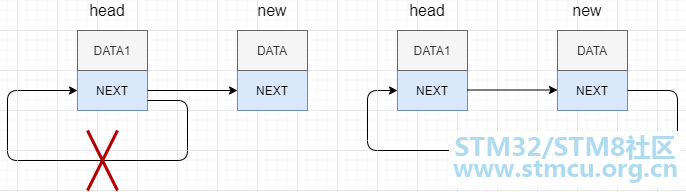
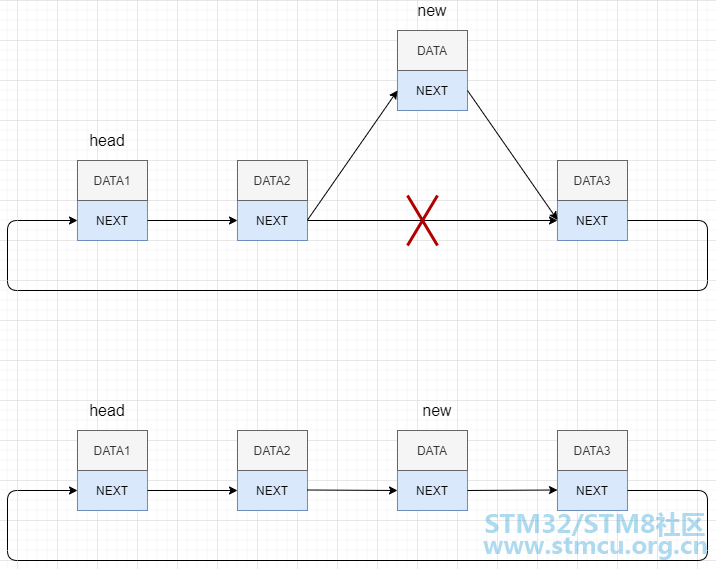
通过逐步的插入操作,创建一个新的节点,将原有链表尾结点的next指针修改指向到新的结点,新的结点的next指针再重新指向头部结点,然后逐步进行这样的插入操作,最终完成整个单项循环链表的创建。 其代码如下: //创建——插入数据) a" `, z# z2 h* r- I# aint insert_list(list *head){6 d$ G+ d1 X8 {. v; d; B" H int data; //插入的数据类型 printf("请输入要插入的元素:"); scanf("%d",&data); ' H0 t8 d& n& A list *node=initlist();( c' ^7 @/ d% `; C node->data=data;5 h& D! E& p+ l, v( N7 }9 A, x L //初始化一个新的结点,准备进行链接0 g( P7 J- o; z3 k" [ if(head!=NULL){ list *p=head;( T% X: @1 A0 ^: t. I P //找到最后一个数据 while(p->next!=head){1 t1 c: n# e1 ~0 h( H0 g p=p->next; } p->next=node;# c& W8 q% w' m node->next=head;9 i: r# c7 b0 L0 ^ return 1; }else{. ~# j* P- t7 `% E: L0 K6 H! L7 F, V printf("头结点已无元素\n"); return 0;: _ c4 ]2 r0 ]0 y0 `. j9 Y# } }+ W% Y. ^0 c b- A % G' e; \4 o* x5 F' y5 e }9 L( w- [" L+ X 循环单链表的插入操作 如图,对于插入数据的操作,可以创建一个独立的结点,通过将需要插入的结点的上一个结点的next指针指向该节点,再由需要插入的结点的next指针指向下一个结点的方式完成插入操作。
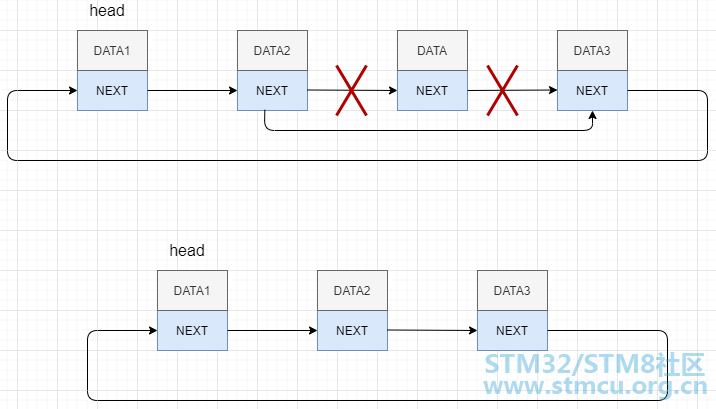
其代码如下: //插入元素list *insert_list(list *head,int pos,int data){ //三个参数分别是链表,位置,参数! K8 |- ?/ h* J% V$ @- E" ^# G list *node=initlist(); //新建结点( J7 C. R# w7 n1 f/ p list *p=head; //p表示新的链表" S$ M6 i$ A* D list *t; t=p;$ [4 b+ r# X, q$ U: |5 e node->data=data;* s0 [! u( ]8 R. G if(head!=NULL){, ]2 @8 o0 F9 M5 o% v/ I for(int i=1;i<pos;i++){; c: o& Z+ i0 k: P C' _5 |# N- m/ h t=t->next; //走到需要插入的位置处& ~. z4 g' G# _$ x8 q } node->next=t->next; t->next=node; return p; } return p; } 循环单链表的删除操作 如下图所示,循环单链表的删除操作是先找到需要删除的结点,将其前一个结点的next指针直接指向删除结点的下一个结点即可。 需要注意的是尾结点,因为删除尾节点后,尾节点前一个结点就成了新的尾节点,这个新的尾节点需要指向的是头结点而不是空。
其代码如下: //删除元素int delete_list(list *head) {, |3 A3 U I3 e- G$ M if(head == NULL) { printf("链表为空!\n"); return 0;, o1 g8 w; f, Z }/ a# T: O) `& M" {7 b //建立临时结点存储头结点信息(目的为了找到退出点)3 _' N9 Z% ?; D& Z" h. t+ g //如果不这么建立的化需要使用一个数据进行计数标记,计数达到链表长度时自动退出 //循环链表当找到最后一个元素的时候会自动指向头元素,这是我们不想让他发生的 list *temp = head; ! e1 q7 H- W! U7 [+ G list *ptr = head->next; 6 B( K$ v1 u5 M" _! m, q% K+ E int del; printf("请输入你要删除的元素:"); scanf("%d",&del); while(ptr != head) { if(ptr->data == del) {' [+ m0 G% z! ?7 A& F* V if(ptr->next == head) { # i% O. \- f) M temp->next = head; free(ptr); return 1; } j: }/ z; H, I. s1 [ temp->next = ptr->next; //核心删除操作代码 free(ptr);4 {( O! r% |) X+ [ //printf("元素删除成功!\n");* p8 F9 N. [/ R% F return 1;' C0 O, q" L3 E" S. I) i: i } temp = temp->next;6 m# {: G/ v/ @3 G1 p ptr = ptr->next;$ T$ \# z q8 J" w } printf("没有找到要删除的元素\n"); return 0; } 循环单链表的遍历 与普通的单链表和双向链表的遍历不同,循环链表需要进行结点的特殊判断。 先找到尾节点的位置,由于尾节点的next指针是指向头结点的,所以不能使用链表本身是否为空(NULL)的方法进行简单的循环判断,我们需要通过判断结点的next指针是否等于头结点的方式进行是否完成循环的判断。 此外还有一种计数的方法,即建立一个计数器count=0,每一次next指针指向下一个结点时计数器+1,当count数字与链表的节点数相同的时候即完成循环; 但是这样做会有一个问题,就是获取到链表的节点数同时,也需要完成一次遍历才可以达成目标。 其代码如下: //遍历元素int display(list *head) { if(head != NULL) { list *p = head; //遍历头节点到,最后一个数据 while(p->next != head ) {% G8 c+ S1 G+ H& I printf("%d ",p->next->data);3 i8 g6 T. u8 C1 w/ b& @ p = p->next;' q! x! D/ F* D+ F/ {! a/ N }) y3 C, C$ q {' ?1 P printf("\n"); //换行 //把最后一个节点赋新的节点过去 return 1; } else { printf("头结点为空!\n"); return 0; }6 R% x- f$ I# t/ K) [3 _- F0 A } 进阶概念——双向循环链表 循环单链表也有一个孪生兄弟——双向循环链表,其设计思路与单链表和双向链表的设计思路一样,就是在原有的双向链表的基础上,将尾部结点和头部结点进行互相连接。交给大家了。 关于链表的总结在顺序表中做插入删除操作时,平均移动大约表中一半的元素,因此对n较大的顺序表效率低。并且需要预先分配足够大的存储空间,而链表恰恰是其中运用的精华。 基于存储,运算,环境这几方面考虑,可以让我们更好的在项目中使用链表。 今天链表基础就讲到这里,下一期,我们再见! * E: A4 ]7 Q8 O# [. ^, B7 b |
跟你学!有没有pdf版的?图片都被社区LOGO覆盖了 |
 微信公众号
 手机版