




|
背景 由于在多处理器环境中某些资源的有限性,有时需要互斥访问(mutual exclusion),这时候就需要引入锁的概念,只有获取了锁的任务才能够对资源进行访问,由于多线程的核心是CPU的时间分片,所以同一时刻只能有一个任务获取到锁。 内核当发生访问资源冲突的时候,通常有两种处理方式:
Spinlock 是内核中提供的一种比较常见的锁机制,自旋锁是“原地等待”的方式解决资源冲突的。即,一个线程获取了一个自旋锁后,另外一个线程期望获取该自旋锁,获取不到,只能够原地“打转”(忙等待)。 由于自旋锁的这个忙等待的特性,注定了它使用场景上的限制 —— 自旋锁不应该被长时间的持有(消耗 CPU 资源)。 自旋锁的优点自旋锁不会使线程状态发生切换,一直处于用户态,即线程一直都是active的;不会使线程进入阻塞状态,减少了不必要的上下文切换,执行速度快。 非自旋锁在获取不到锁的时候会进入阻塞状态,从而进入内核态,当获取到锁的时候需要从内核态恢复,需要线程上下文切换。(线程被阻塞后便进入内核(Linux)调度状态,这个会导致系统在用户态与内核态之间来回切换,严重影响锁的性能)。 自旋锁的使用在linux kernel的实现中,经常会遇到这样的场景:共享数据被中断上下文和进程上下文访问,该如何保护呢? 如果只有进程上下文的访问,那么可以考虑使用semaphore或者mutex的锁机制,但是现在中断上下文也掺和进来,那些可以导致睡眠的lock就不能使用了,这时候,可以考虑使用spin lock。 在中断上下文,是不允许睡眠的,所以,这里需要的是一个不会导致睡眠的锁——spinlock。 换言之,中断上下文要用锁,首选 spinlock。 使用自旋锁,有两种方式定义一个锁: 动态的: spinlock_t lock;spin_lock_init (&lock);( ?) r! r. n4 U9 [* I 静态的: DEFINE_SPINLOCK(lock);5 C* L4 T/ ^, n2 C& s# I4 v使用步骤 spinlock的使用很简单:
使用实例 static spinlock_t lock;static int flage = 1;) |$ v( _1 i3 C spin_lock_init(&lock); * u9 j, P, V) B. E9 T( S5 ` static int hello_open (struct inode *inode, struct file *filep) { spin_lock(&lock);: V. {3 v8 [0 F3 W: S9 k, E if(flage !=1)9 j$ m7 ]$ N1 v f' } {3 a% F, T. K; G4 R8 H spin_unlock(&lock);! P, K( z, n; ~" z2 N) U return -EBUSY;, V8 \$ P& I2 b5 @" o" T }# l7 q C B2 Y; ^6 ^ flage =0; spin_unlock(&lock); return 0;4 z$ }: h1 K2 e& t5 G }9 O- ?$ n5 u! x5 K static int hello_release (struct inode *inode, struct file *filep) { flage = 1;( n* p: _# d/ C" n3 J4 O$ C3 ]1 T return 0; } 补充 中断上下文不能睡眠的原因是:
但在中断处理程序里,CPU寄存器的值肯定已经变化了吧(最重要的程序计数器PC、堆栈SP等),如果此时因为睡眠或阻塞操作调用了schedule(),则保存的进程上下文就不是当前的进程context了.所以不可以在中断处理程序中调用schedule()。
BUG();, _6 U4 y, w( W G3 b$ p1 l 因此,强行调用schedule()的结果就是内核BUG。
自旋锁不可递归,自己等待自己已经获取的锁,会导致死锁。 自旋锁可以在中断上下文中使用,但是试想一个场景:一个线程获取了一个锁,但是被中断处理程序打断,中断处理程序也获取了这个锁(但是之前已经被锁住了,无法获取到,只能自旋),中断无法退出,导致线程中后面释放锁的代码无法被执行,导致死锁。(如果确认中断中不会访问和线程中同一个锁,其实无所谓)。 一、考虑下面的场景(内核抢占场景): (1)进程A在某个系统调用过程中访问了共享资源 R (2)进程B在某个系统调用过程中也访问了共享资源 R 会不会造成冲突呢? 假设在A访问共享资源R的过程中发生了中断,中断唤醒了沉睡中的,优先级更高的B,在中断返回现场的时候,发生进程切换,B启动执行,并通过系统调用访问了R,如果没有锁保护,则会出现两个thread进入临界区,导致程序执行不正确。OK,我们加上spin lock看看如何:A在进入临界区之前获取了spin lock,同样的,在A访问共享资源R的过程中发生了中断,中断唤醒了沉睡中的,优先级更高的B,B在访问临界区之前仍然会试图获取spin lock,这时候由于A进程持有spin lock而导致B进程进入了永久的spin……怎么破?linux的kernel很简单,在A进程获取spin lock的时候,禁止本CPU上的抢占(上面的永久spin的场合仅仅在本CPU的进程抢占本CPU的当前进程这样的场景中发生)。如果A和B运行在不同的CPU上,那么情况会简单一些:A进程虽然持有spin lock而导致B进程进入spin状态,不过由于运行在不同的CPU上,A进程会持续执行并会很快释放spin lock,解除B进程的spin状态。 二、再考虑下面的场景(中断上下文场景):
在这样的场景下,使用spin lock可以保护访问共享资源R的临界区吗? 我们假设CPU0上的进程A持有spin lock进入临界区,这时候,外设P发生了中断事件,并且调度到了CPU1上执行,看起来没有什么问题,执行在CPU1上的handler会稍微等待一会CPU0上的进程A,等它立刻临界区就会释放spin lock的,但是,如果外设P的中断事件被调度到了CPU0上执行会怎么样?CPU0上的进程A在持有spin lock的状态下被中断上下文抢占,而抢占它的CPU0上的handler在进入临界区之前仍然会试图获取spin lock,悲剧发生了,CPU0上的P外设的中断handler永远的进入spin状态,这时候,CPU1上的进程B也不可避免在试图持有spin lock的时候失败而导致进入spin状态。为了解决这样的问题,linux kernel采用了这样的办法:如果涉及到中断上下文的访问,spin lock需要和禁止本 CPU 上的中断联合使用。 三、再考虑下面的场景(底半部场景) linux kernel中提供了丰富的bottom half的机制,虽然同属中断上下文,不过还是稍有不同。我们可以把上面的场景简单修改一下:外设P不是中断handler中访问共享资源R,而是在的bottom half中访问。使用spin lock+禁止本地中断当然是可以达到保护共享资源的效果,但是使用牛刀来杀鸡似乎有点小题大做,这时候disable bottom half就可以了。 四、中断上下文之间的竞争 同一种中断handler之间在uni core和multi core上都不会并行执行,这是linux kernel的特性。如果不同中断handler需要使用spin lock保护共享资源,对于新的内核(不区分fast handler和slow handler),所有handler都是关闭中断的,因此使用spin lock不需要关闭中断的配合。bottom half又分成softirq和tasklet,同一种softirq会在不同的CPU上并发执行,因此如果某个驱动中的softirq的handler中会访问某个全局变量,对该全局变量是需要使用spin lock保护的,不用配合disable CPU中断或者bottom half。tasklet更简单,因为同一种tasklet不会多个CPU上并发。 自旋锁的实现原理数据结构 首先定义一个 spinlock_t 的数据类型,其本质上是一个整数值(对该数值的操作需要保证原子性),该数值表示spin lock是否可用。初始化的时候被设定为1。当thread想要持有锁的时候调用spin_lock函数,该函数将spin lock那个整数值减去1,然后进行判断,如果等于0,表示可以获取spin lock,如果是负数,则说明其他thread的持有该锁,本thread需要spin。 内核中的spinlock_t的数据类型定义如下: typedef struct spinlock {struct raw_spinlock rlock; } spinlock_t; typedef struct raw_spinlock {8 U7 Z8 _& t* n& t arch_spinlock_t raw_lock;' c( [! h6 o1 ~4 B, B" v } raw_spinlock_t;0 f4 y3 t( X- \ 通用(适用于各种arch)的spin lock使用spinlock_t这样的type name,各种arch定义自己的struct raw_spinlock。听起来不错的主意和命名方式,直到linux realtime tree(PREEMPT_RT)提出对spinlock的挑战。 spin lock的命名规范定义如下:
同样的,这里也只是选择一个典型的API来分析,其他的大家可以自行学习。我们选择的是 arch_spin_lock,其ARM32的代码如下: static inline void arch_spin_lock(arch_spinlock_t *lock){ unsigned long tmp; u32 newval;% Y8 S8 _9 P P8 D. A arch_spinlock_t lockval; prefetchw(&lock->slock);---------(0)4 ~# D6 r5 {% S) x __asm__ __volatile__( "1: ldrex %0, [%3]\n"---------(1)& L7 P2 E* Y, ^2 ]2 L4 i " add %1, %0, %4\n" ----------(2) " strex %2, %1,[%3]\n"---------(3) " teq %2, #0\n"-------------(4) " bne 1b"( [3 J! I, U: J) ? : "=&r" (lockval), "=&r" (newval), "=&r" (tmp)# {# o# m+ M: X+ ] : "r" (&lock->slock), "I" (1 << TICKET_SHIFT)$ [% Y; H( l) b : "cc");8 U1 k8 d# r! E6 x$ Y: z while (lockval.tickets.next != lockval.tickets.owner) {----(5)+ b5 `! Z4 s- q2 r5 r; Z wfe();------------(6) lockval.tickets.owner = ACCESS_ONCE(lock->tickets.owner);----(7) } ) `' K. r. B9 q( t0 A% r3 F) A* x1 c smp_mb();-----------(8) p5 p. {8 k4 X$ x: h } (0)和preloading cache相关的操作,主要是为了性能考虑% d+ B: i- q- \) _$ S (1)lockval = lock->slock (如果lock->slock没有被其他处理器独占,则标记当前执行处理器对lock->slock地址的独占访问;否则不影响)4 L( Q" D5 c, e9 j3 }. j (2)newval = lockval + (1 << TICKET_SHIFT) (3)strex tmp, newval, [&lock->slock] (如果当前执行处理器没有独占lock->slock地址的访问,不进行存储,返回1给temp;如果当前处理器已经独占lock->slock内存访问,则对内存进行写,返回0给temp,清除独占标记) lock->tickets.next = lock->tickets.next + 1 (4)检查是否写入成功 lockval.tickets.next (5)初始化时lock->tickets.owner、lock->tickets.next都为0,假设第一次执行arch_spin_lock,lockval = *lock,lock->tickets.next++,lockval.tickets.next 等于 lockval.tickets.owner,获取到自旋锁;自旋锁未释放,第二次执行的时候,lock->tickets.owner = 0, lock->tickets.next = 1,拷贝到lockval后,lockval.tickets.next != lockval.tickets.owner,会执行wfe等待被自旋锁释放被唤醒,自旋锁释放时会执行 lock->tickets.owner++,lockval.tickets.owner重新赋值 (6)暂时中断挂起执行。如果当前spin lock的状态是locked,那么调用wfe进入等待状态。更具体的细节请参考ARM WFI和WFE指令中的描述。 (7)其他的CPU唤醒了本cpu的执行,说明owner发生了变化,该新的own赋给lockval,然后继续判断spin lock的状态,也就是回到step 5。 (8)memory barrier的操作,具体可以参考memory barrier中的描述。 释放锁static inline void arch_spin_unlock(arch_spinlock_t *lock) {# J6 ^2 U8 @- u8 ~ smp_mb(); - K& B! ]- r/ c: h lock->tickets.owner++; ---------------------- (0) dsb_sev(); ---------------------------------- (1); P8 b* p& ?6 O. a/ ` }5 S9 `. ^7 p8 N5 \5 e# o. ^
1)拥有自旋锁的进程A在内核态阻塞了,内核调度B进程,碰巧B进程也要获得自旋锁,此时B只能自旋转。而此时抢占已经关闭,不会调度A进程了,B永远自旋,产生死锁。 2)进程A拥有自旋锁,中断到来,CPU执行中断函数,中断处理函数,中断处理函数需要获得自旋锁,访问共享资源,此时无法获得锁,只能自旋,产生死锁。 如何避免死锁
因为自旋锁持有时间非常短,没有直观的现象,下面举一个会导致死锁的实例。 运行条件
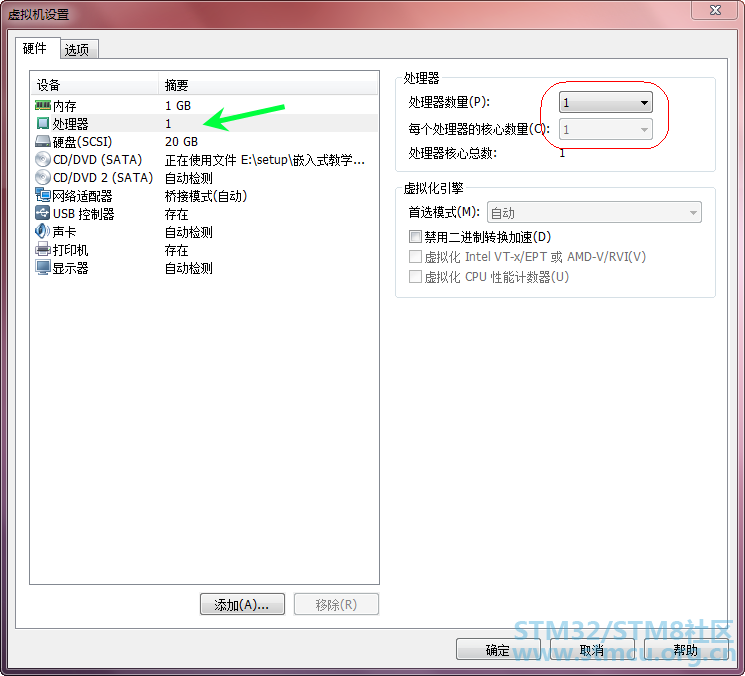
针对单CPU,拥有自旋锁的任务不应该调度会引起休眠的函数,否则会导致死锁。 步骤:
驱动代码如下: #include <linux/init.h>. I& x t/ g* X3 E1 t$ I#include <linux/module.h>7 _1 C: M; V; H #include <linux/kdev_t.h> #include <linux/fs.h> #include <linux/cdev.h>( w& W$ p) t- W1 C3 R* u& k #include <linux/device.h>3 P7 ~/ ~7 ]( v( s #include <linux/spinlock.h> ( O3 {7 s3 k. D! m- x static int major = 250; static int minor = 0;2 D4 A) W# Z6 R0 e: b+ o/ F5 l5 W static dev_t devno;, W+ e; Z; X7 E5 b static struct cdev cdev;: Z! g2 g6 h8 z4 y% F, ?( t6 i static struct class *cls;+ F: Y6 h6 N# q static struct device *test_device; static spinlock_t lock; static int flage = 1; 7 s: u1 v) [: r- _1 j1 W #define DEAD 15 G8 t0 {0 J+ R1 @0 G- ~! Q static int hello_open (struct inode *inode, struct file *filep): F* X% S5 Z+ l( E8 P7 B( t# ` { spin_lock(&lock); if(flage !=1): L& P$ u7 Q" g0 m6 p) G# a" M1 p { spin_unlock(&lock);: h4 J* |5 J6 ]! A return -EBUSY;, P/ G5 \5 \- O3 [8 _; D }6 c- j& T. l" M v$ d* Y ^: ?$ `! s flage =0; #if DEAD5 y+ k4 Q" B. o7 y #elif spin_unlock(&lock); #endif return 0;2 N0 [$ I# [' x) w } static int hello_release (struct inode *inode, struct file *filep)! ]- K/ n" }! P) U { flage = 1;: C# r. V8 T* f0 c #if DEAD spin_unlock(&lock);# n8 O/ m% q! y3 @; ?% ` #endif return 0; }( D3 @1 _* F. ^( `7 @% ~; u static struct file_operations hello_ops = {# l" a" I) B' H |: k1 S .open = hello_open, .release = hello_release, }; static int hello_init(void). n8 I( p+ ^4 X: @! t3 ? { int result;' f9 ?- m) X, f3 ?% O/ O int error; printk("hello_init \n");) y4 X4 ^' N( P L. p- h result = register_chrdev( major, "hello", &hello_ops);5 {- @4 q7 ~9 ~* W7 G, i7 p- n if(result < 0) {) n) g& _# \+ M% x! x) `8 O, I printk("register_chrdev fail \n"); return result; } devno = MKDEV(major,minor); cls = class_create(THIS_MODULE,"helloclass"); if(IS_ERR(cls)) { unregister_chrdev(major,"hello");$ U j) l3 F7 x6 N' Q" D return result;6 ?- z7 ~/ i' u! i( Y }, m+ u% y" c. b6 o* y test_device = device_create(cls,NULL,devno,NULL,"test"); if(IS_ERR(test_device ))1 a7 c- ^; q1 P7 Y+ d6 A' F( x { w5 W6 P! ?: S. A class_destroy(cls); unregister_chrdev(major,"hello"); return result; }9 Q- _# A0 {) q2 P) ~( @* m2 p spin_lock_init(&lock);3 o- `. O0 e n/ U% g( e# d. q return 0;6 G; d a# ~) U& U' t& l9 N } static void hello_exit(void) {& m0 J% V& Q9 c9 u: ^, O7 j/ |) { printk("hello_exit \n");/ I8 Z$ V$ }8 s( @6 ?2 z5 F* B device_destroy(cls,devno); class_destroy(cls); unregister_chrdev(major,"hello");% N+ m" S5 j6 }! |+ [8 A" B return; }+ y9 {3 s- ~1 F; @. Q2 R module_init(hello_init); i* h7 f/ ]2 K4 X+ _- s module_exit(hello_exit);5 M6 R3 C R) E9 P( t3 O MODULE_LICENSE("GPL");2 C/ n7 e% [, ^# ~7 ~/ b0 t; |- Z' M 测试程序如下: #include <stdio.h>#include <sys/types.h>* V! C5 J Z- Z #include <sys/stat.h>) W$ Q% A: Y* A+ ^( k/ w* ]# I #include <fcntl.h> main()8 ^3 L7 P+ {7 b {7 ]& t5 x X5 a; I/ C# o' D _ int fd; fd = open("/dev/test",O_RDWR); if(fd<0)' c) ?9 G @ S { perror("open fail \n"); return; } Q" Z% o( b/ X7 @5 K sleep(20); close(fd); 3 y9 `. H( e& b& [$ i printf("open ok \n ");1 P( n- q3 P p: C; l/ v }! Q/ W. }9 ]. S9 @& M 测试步骤:
insmod hello.ko
./a + h( S- `' Q! J$ q( w3 S
./b 注意,一定要在进程A没有退出的时候运行进程B。 |
 微信公众号
 手机版


