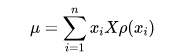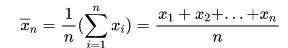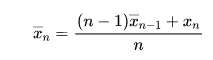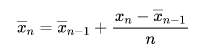|
[导读] 在嵌入式产品开发中,有时会需要利用一些数学统计的一些知识,并利用代码的方式实施在产品的应用中。有人会说均值有啥好聊的,不就是加起来除一下嘛?不妨来读一读。 本文目的不是数学,而在于分享如何进行工程应用实现。 什么是均值?对于离散数据集,算术平均值也称为期望值或简称为平均值,是离散数据集合的中心值。假设有这样的数据序列: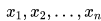
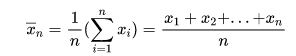
对,你说的没错就是加起来求平均。有盆友或许会问,为什么均值有的地方写的是 

弄这样两个概念有什么必要呢?总体均值反应的是事务的总体规律,实际研究中,往往很难得到所有的数据,比如产品的某项指标规律,如果每一个产品都去测,代价可能极其高昂,实际往往是对产品进行抽样检测。(公式中多写了个X)
如此一来这就有实用意义了。 均值除了上面这种算术平均值之外,还有几何平均值、谐波均值、功率均值、加权均值、截断均值、函数泛化均值等,有兴趣的可以去了解一下。 如何计算均值?这里主要讨论对于嵌入式电子系统编程中,样本均值的计算方法以及C代码。分享直接法和递推法计算均值,重点介绍递推法。 直接法按照公式定义,加和求平均。这个编代码很容易: float mean(float *pSample,int size){ if(pSample==NULL || size<=0)3 @* a- T' d. l5 G3 W2 X% _ \ return NAN; 1 ]2 L+ T/ Y& f6 F& y$ R. b float sum = 0; for(int i=0;i<size;i++) { sum += *pSample; pSample++; }7 I/ n" {# @; K$ d0 K: n 9 _# n" M' q; ] return (sum/size); } 该方法简单直接,但是缺点是在内存比较小的单片机系统中如需要计算大样本集的场合,就捉襟见肘了。比如几万样本时,内存可能就不够了! 递推法因为样本均值计算公式如下:

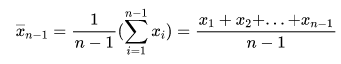
不难得出:
从而
这样就可以编代码了: float recursive_mean(float xn,int size)5 m D* F" A9 F9 c4 [{3 L5 K: b3 g8 C6 j! h static int index = 0; static float last_mean = 0.0f;' |0 X5 f- W7 D/ E' M& F& L float mean = 0.0f; if(index<size-1) { index++;' V f6 e; j$ ^/ W4 V mean = last_mean+(xn-last_mean)/index;: o- j+ f, N/ ~ {. F% v) t } else3 a" ] k* ?0 |. p- O$ |$ e9 \ { mean = last_mean+(xn-last_mean)/size;; t6 q: z# j& B/ u index = 0; last_mean = 0.0f;# ^" @. o! \" l( A2 V" o } 1 F0 z: E7 i. w2 a: D1 }6 K last_mean = mean; return mean;6 w% Y. T$ Y! V- @- J } 这个代码很容易理解:
函数内静态变量不推荐使用,但这里函数使用了内部静态变量,为什么使用静态变量呢?因为所实现的需求对外部不可见,这种需求本身的作用域就在函数本体内部。这样写个人理解会更好一些。 关于static的用法,前面写过两篇文章,有兴趣的可以去点进去看看:
在嵌入式应用中,如果所需要统计的样本非常大时,这种算法将非常有实用价值,只需要极小的内存开销。尤其在一些传感器测量应用中,该方法非常有价值。 测试一下#include <stdio.h>0 R( p* s3 A# m, @ #include <stdbool.h>4 f9 c9 w2 L. j' d3 D ` #include <math.h> float mean(float *pSample,int size) { if(pSample==NULL || size<=0) return NAN; float sum = 0; for(int i=0;i<size;i++) { sum += *pSample; pSample++; }- |' Z. m% v1 ^. A return (sum/size); }2 U5 k: e& e$ v6 }( q5 n# @ float recursive_mean(float xn,int size) { static int index = 0; static float last_mean = 0.0f; float mean = 0.0f; if(index<size-1) { index++; mean = last_mean+(xn-last_mean)/index;) D# q7 |4 E# a& p4 t2 d8 u8 H } else { mean = last_mean+(xn-last_mean)/size;/ L# l. r5 d: v8 k5 q index = 0;+ @( m/ J8 v4 K last_mean = 0.0f;! a& t! ?, @% F N9 W }+ u! u7 M1 U$ W: Y last_mean = mean;9 l* M; w! o+ y8 G7 g r1 ^ return mean; } #define N (1000) #define SAMPLE_SIZE (100) int main(int argc, char *argv[])3 G) ^$ | P7 P' s7 W' k9 p { float sim[N]; float out[N/SAMPLE_SIZE];- z8 n1 t% n$ A W) K6 i+ u! X for(int i=0;i<N;i++)$ v" M1 M( [5 Z" a+ F& h {% p- u( j! E- ]3 R) F9 ] sim=i*5+rand()%10;4 O( F N* D: W: w }3 G% }* n3 z* y9 c$ _5 m4 r printf("\n\n"); int j=0;7 h1 W/ D* S( y9 `9 C! v' z0 b2 D for(int i=0;i<N;i=i+SAMPLE_SIZE) {! v! f* X+ k+ b out[j] = mean(&sim,SAMPLE_SIZE);! F0 G# x* r5 g: a" h/ ] j++;* N( p7 B+ s. m }5 ]/ N @$ V7 X! z3 X; s$ O( I $ g7 ~+ L7 Z2 V4 o. D for(j=0;j<N/SAMPLE_SIZE;j++) { printf("%.2f,",out[j]); } printf("\n"); j = 0;1 _! S( X p$ z for(int i=0;i<N;i++) {9 y9 E4 W) s6 U! H! C: B* _6 g out[j]=recursive_mean(sim,SAMPLE_SIZE); if((i+1)%SAMPLE_SIZE==0) j++; }4 ]3 m" `( R! P! h! @ for(j=0;j<N/SAMPLE_SIZE;j++)' k+ S. E9 A/ g, Z# M {, m$ d! y4 C9 M' ?: D0 e0 ^. c printf("%.2f,",out[j]); }! m: Z. f ^7 J8 b# ] printf("\n");" k: V" l$ g1 Y J return 0; }3 t8 c* i9 K# D 看一下结果: 252.14,752.38,1251.85,1751.82,2252.57,2752.25,3251.78,3751.58,4252.06,4752.02,5 C& }9 |; c1 ], B252.14,752.38,1251.85,1751.82,2252.57,2752.25,3251.78,3751.58,4252.06,4752.02, 两种计算方法效果一样,但是第二种方法消耗极小的内存。当然这增加了函数调用次数,但是在大样本计算时非常有利。 总结一下在实际应用中,常常需要求取测量的均值,或者依据均值做相应的应用,而且均值是计算信号序列或者样本集其他数学统计规律的基础计算,比如要计算方差、协方差等等。那么实际应用中学会如何计算均值并进行编码实现时很必要的。尤其在一些内存受限的场景,学会利用递推规律进行计算很有学习掌握的价值。 5 @* k1 V, ~! A4 H. n& ] |
| 递推法 |
 微信公众号
 手机版