




|
大家早上好,今天为大家总结整理了关于操作系统内存管理的知识点,更文不易,请各位兄弟别忘分享或者点个在看,多谢 目录 1. 什么是物理内存 2. 使用物理内存有什么缺点? 3. 什么是虚拟内存? 4. 虚拟内存如何映射到物理内存 5. 什么是分页内存管理? 6. 什么是缺页中断? 7. 页面置换算法都有哪些? 8. 什么是分段内存管理? 1 U# B- o3 r% `3 w01什么是物理内存? 我们常说的物理内存大小就是指内存条的大小,一般买电脑时都会看下内存条是多大容量的,话说如果内存条大小是100G,那这100G就都能够被使用吗?不一定的,更多的还是要看CPU地址总线的位数,如果地址总线只有20位,那么它的寻址空间就是1MB,即使可以安装100G的内存条也没有意义,也只能视物理内存大小为1MB。 02使用物理内存有什么缺点? 这种方式下每个程序都可以直接访问物理内存,有两种情况: 7 D- j* _1 Z5 [( L( r; b 1.系统中只有一个进程在运行:如果用户程序可以操作物理地址空间的任意地址,它们就很容易在不经意间破坏了操作系统,使系统出现各种奇奇怪怪的问题; / L* [, u! A2 ]/ a7 y 2.系统有多个进程同时在运行:如图,理想情况下可以使进程A和进程B各占物理内存的一边,两者互不干扰,但这只是理想情况下,谁能确保程序没有bug呢,进程B在后台正常运行着,程序员在调试进程A时有可能就会误操作到进程B正在使用的物理内存,导致进程B运行出现异常,两个程序操作了同一地址空间,第一个程序在某一地址空间写入某个值,第二个程序在同一地址又写入了不同值,这就会导致程序运行出现问题,所以直接使用物理内存会使所有进程的安全性得不到保证。 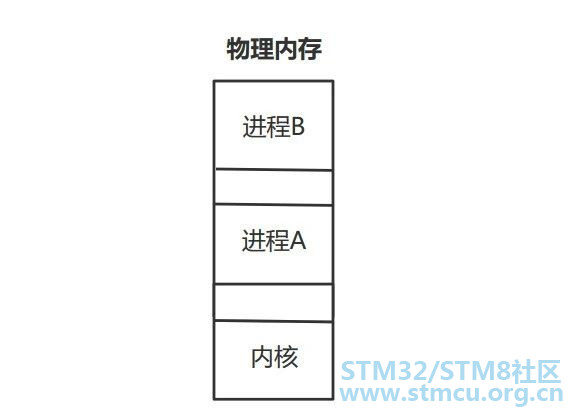
可以考虑为存储器创造新的抽象概念:地址空间,地址空间为程序创造了一种抽象的内存,是进程可用于寻址内存的一套地址集合,同时每个进程都有一套自己的地址空间,一个进程的地址空间独立于其它进程的地址空间。 最简单的办法就是把每个进程的地址空间分别映射到物理内存的不同部分。这样就可以保证不同进程使用的是独立的地址空间。 ; p2 S. a" U5 R. ]) x/ x, ] 给每个进程提供一个基址A和界限B,进程内使用的空间为x,则对应的物理地址为A + x,同时需要保证A + x < B,如果访问的地址超过的界限,需要产生错误并中止访问。为了达到目的CPU配置了两个特殊硬件寄存器:基址寄存器和界限寄存器,当一个进程运行时,程序的起始物理地址和长度会分别装入到基址寄存器和界限寄存器里,进程访问内存,在每个内存地址送到内存之前,都会先加上基址寄存器的内容。 缺点:每次访问内存都需要进行加法和比较运算,比较运算很快,但是加法运算由于进位传递事件的问题,在没有使用特殊电路的情况下会显得很慢。 $ w% N3 G8 p* z2 K 此外,每个进程运行都会占据一定的物理内存,如果物理内存足够大到可以容纳许多个进程同时运行还好,但现实中物理内存的大小是有限的,可能会出现内存不够用的情况,怎么办? 方法一:如果是因为程序太大,大到超过了内存的容量,可以采用手动覆盖技术,只把需要的指令和数据保存在内存中。 方法二:如果是因为程序太多,导致超过了内存的容量,可以采用自动交换技术,把暂时不需要执行的程序移动到外存中。 U5 C& ]4 }2 S" U* R4 Z9 g F / j9 L6 M Q+ x+ V9 X9 x覆盖技术 把程序按照自身逻辑结构,划分成多个功能相互独立的程序模块,那些不会同时执行的模块可以共享到同一块内存区域,按时间顺序来运行: 4 Q$ n3 @/ f) ]% ^# q将常用功能需要的代码和数据常驻在内存中; $ a& ?5 @* Q) r; i9 r, q5 s4 y1 ? 将不常用的功能划分成功能相互独立的程序模块,平时放到外存中,在需要的时候将对应的模块加载到内存中; 那些没有调用关系的模块平时不需要装入到内存,它们可以共用一块内存区,需要时加载到内存,不需要时换出到外存中; 如图: 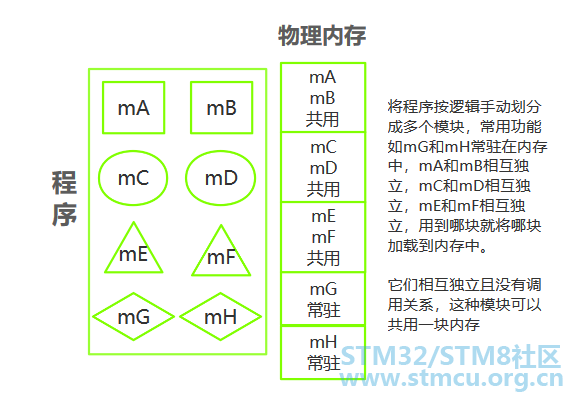
多个程序同时运行,可以将暂时不能运行的程序送到外存,获得更多的空闲内存,操作系统将一个进程的整个地址空间内容换出到外存中,再将外存中某个进程的整个地址空间信息换入到内存中,换入换出内容的大小是整个程序的地址空间。 ; n. }& E) A/ E4 N: k1 N 交换技术在实现上有很多困难: ! k$ S) |. @0 k需要确定什么时候发生交换:简单的办法是可以在内存空间不够用时换出一些程序; ) k4 F% H, B6 J3 v' F 2 b5 P5 S0 u, `9 U) A交换区必须足够大:多个程序运行时,交换区(外存)必须足够大,大到可以存放所有程序所需要的地址空间信息; 程序如何换入:一个程序被换出后又重新换入,换入的内存位置可能不会和上一次程序所在的内存位置相同,这就需要动态地址映射机制。* j$ j5 t; Z9 Y+ e 覆盖只能发生在那些相互之间没有调用关系的程序模块之间,因此程序员必须给出程序内的各个模块之间的逻辑覆盖结构。 ) ?* x% s3 @ F( T $ U( A" M* S. d, z5 [交换技术是以在内存中的程序大小为单位来进行的,它不需要程序员给出各个模块之间的逻辑覆盖结构。 通俗来说:覆盖发生在程序的内部,交换发生在程序与程序之间。- s6 t" e2 n8 W. J7 B {* m* |6 D0 O4 D! E) d3 i 但是这两种技术都有缺点: h/ s& x7 l* W 覆盖技术:需要程序员自己把整个程序划分为若干个小的功能模块,并确定各个模块之间的覆盖关系,增加了程序员的负担,很少有程序员擅长这种技术; 交换技术:以进程作为交换的单位,需要把进程的整个地址空间都换进换出,增加了处理器的开销,还需要足够大的外存。 . U8 V1 z- k9 y, c9 X* P. I8 S. X 那有没有更好的解决上述问题的方法呢?答案是虚拟内存技术。 : ?1 A4 v. C, _$ G9 I 03什么是虚拟内存? 3 s$ v7 ?: @5 [# q9 m" t3 N& O8 ~ ' O E9 I7 T4 U8 `; L* g' @* R 虚拟内存,那就是虚拟出来的内存,它的基本思想就是确保每个程序拥有自己的地址空间,地址空间被分成多个块,每一块都有连续的地址空间,同时物理空间也分成多个块,块大小和虚拟地址空间的块大小一致,操作系统会自动将虚拟地址空间映射到物理地址空间,程序所关注的只是虚拟内存,请求的也是虚拟内存,其实真正使用的是物理内存。 虚拟内存技术有覆盖技术的功能,但它不是把程序的所有内容都放在内存中,因而能够运行比当前的空闲内存空间还要大的程序。它比覆盖技术做的更好,整个过程由操作系统自动来完成,无需程序员的干涉;2 N/ m/ }% O, R; q) ?0 ? 6 `! X* }0 t# b+ J9 l! q$ P 虚拟内存技术有交换技术的功能,能够实现进程在内存和外存之间的交换,因而获得更多的空闲内存空间。它比交换技术做的更好,它只对进程的部分内容在内存和外存之间进行交换。; w- ~, b; _9 J; b$ [$ u+ N 3 n# J/ z( W) X0 |; u 虚拟内存技术的具体实现: 虚拟内存技术一般是在页式管理(下面介绍)的基础上实现 $ }! G4 W7 `1 Z2 u7 Z& G1 X, _: E% d在装入程序时,不必将其全部装入到内存,而只需将当前需要执行的部分页面装入到内存,就可让程序开始执行; , F* R4 c7 |- j 在程序执行过程中,如果需执行的指令或访问的数据尚未在内存(称为缺页)。则由处理器通知操作系统将相应的页面调入到内存,然后继续执行程序; 另一方面,操作系统将内存中暂时不使用的页面调出保存在外存上,从而腾出更多空闲空间存放将要装入的程序以及将要调入的页面。 7 u: b' v& K; ?1 H# D- F2 B 0 W6 v3 r( X1 S8 r/ m- O( Q虚拟内存技术的特点: 大的用户空间:通过把物理内存与外存相结合,提供给用户的虚拟内存空间通常大于实际的物理内存,即实现了两者的分离。如32位的虚拟地址理论上可以访问4GB,而可能计算机上仅有256M的物理内存,但硬盘容量大于4GB;% J4 N7 A: _8 ?2 W& I. n( P% J 部分交换:与交换技术相比较,虚拟存储的调入和调出是对部分虚拟地址空间进行的;$ C6 i9 {8 ?, R1 q- L) P 连续性:程序可以使用一系列相邻连续的虚拟地址来映射物理内存中不连续的大内存缓冲区; 0 M; p+ d1 @( \8 [ v4 M 安全性:不同进程使用的虚拟地址彼此隔离。一个进程中的代码无法更改正在由另一进程或操作系统使用的物理内存。 " y8 r; q0 S' s& F9 \2 {# j |$ y+ { 04虚拟内存如何映射到物理内存?如图,CPU里有一个内存管理单元(Memory Management Unit),简称MMU,虚拟内存不是直接送到内存总线,而是先给到MMU,由MMU来把虚拟地址映射到物理地址,程序只需要管理虚拟内存就好,映射的逻辑自然有其它模块自动处理。 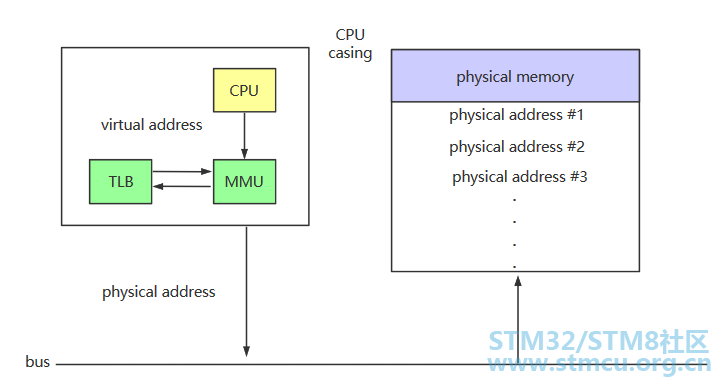
1 E4 ]+ c' W# Y3 {1 ~ 操作系统如何表示的内存被占用还是空闲? " P3 B# }' K9 d* l/ { 05分页内存管理3 T4 b8 a. x' T2 b I 将虚拟地址空间分成若干个块,每个块都有固定的大小,物理地址空间也被划分成若干个块,每个块也都有固定的大小,物理地址空间的块和虚拟地址空间的块大小相等,虚拟地址空间这些块就被称为页面,物理地址空间这些块被称为帧。 9 J' C2 s, N: T, V 关于分页这里有个问题,页面的大小是多少合适呢?页面太大容易产生空间浪费,程序假如只使用了1个字节却被分配了10M的页面,这岂不是极大的浪费,页面太小会导致页表(下面介绍)占用空间过大,所以页面需要折中选择合适的大小,目前大多数系统都使用4KB作为页的大小。 上面关于虚拟内存如何映射到物理内存程序喵只介绍了MMU,但是MMU是如何工作的还没有介绍,MMU通过页表这个工具将虚拟地址转换为物理地址。32位的虚拟地址分成两部分(虚拟页号和偏移量),MMU通过页表找到了虚拟页号对应的物理页号,物理页号+偏移量就是实际的物理地址。 3 h/ Z' M* r5 r# r 具体如图: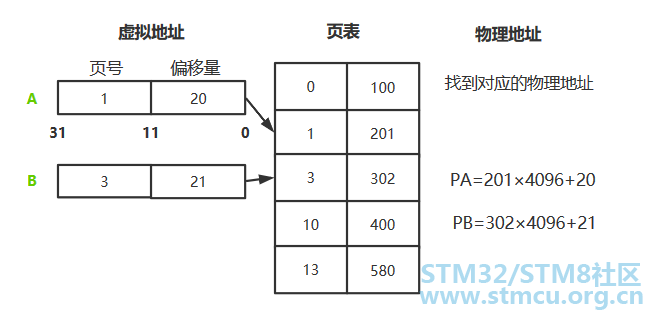
图只表示了页表的大体功能,页表的结构其实还很复杂,下面会具体介绍。0 v( n& } M3 p# a. t5 D) K, g0 t$ U ) o" Z. a& G. @7 M 页表的目的就是虚拟页面映射为物理内存的页框,页表可以理解为一个数学函数,函数的输入是虚拟页号,函数的输出是物理页号,通过这个函数可以把虚拟页面映射到物理页号,从而确定物理地址。不同机器的页表结构不同,通常页表的结构如下: 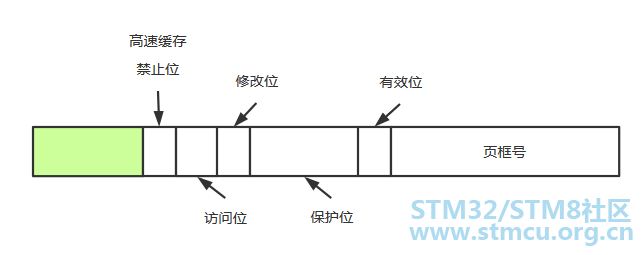
页框号:最主要的一项,页表最主要的目的就是找到物理页号; 有效位:1表示有效,表示该表项是有效的,如果为0,表示该表项对应的虚拟页面现在不在内存中,访问该页面会引起缺页中断,缺页中断后会去物理空间找到一个可用的页框填回到页表中; 保护位:表示一个页允许什么类型的访问,可读可写还是可执行; 修改位:该位反应了页面的状态,在操作系统重新分配页框时有用,在写入一页时由硬件自动设置该位,重新分配页框时,如果一个页面已经被修改过,则必须把它这个脏页写回磁盘,如果没有被修改过,表示该页是干净的,它在磁盘上的副本依然是有效的,直接丢弃该页面即可。 访问位:该位主要用于帮助操作系统在发生缺页中断时选择要被淘汰的页面,不再使用的页面显然比正在使用的页面更适合被淘汰,该位在页面置换算法中发挥重要作用。 高速缓存禁止位:该位用于禁止该页面被高速缓存。# j' }* m7 X# k 5 H+ @8 c7 H' ? 如何加快地址映射速度? 每次访问内存都需要进行虚拟地址到物理地址的映射,每次映射都需要访问一次页表,所有的指令执行都必须通过内存,很多指令也需要访问内存中的操作数,因此每条指令执行基本都会进行多次页表查询,为了程序运行速度,指令必须要在很短的时间内执行完成,而页表查询映射不能成为指令执行的瓶颈,所以需要提高页表查询映射的速度。: ~; a$ d3 U S5 V( X) { , \7 u$ o' s5 W8 J/ d- X; | 如何才能提高速度呢?可以为页表提供一个缓存,通过缓存进行映射比通过页表映射速度更快,这个缓存是一个小型的硬件设备,叫快表(TLB),MMU每次进行虚拟地址转换时,首先去TLB中查找,找到了有效的物理页框则直接返回,如果没有找到则进行正常的页表访问,页表中找到后则更新TLB,从TLB中淘汰一个表项,然后用新找到的表项替代它,这样下次相同的页面过来时可以直接命中TLB找到对应的物理地址,速度更快,不需要继续去访问页表。 * a. z' v7 o0 g4 I3 ^; L 这里之所以认为TLB能提高速度主要依靠程序局部性原理,程序局部性原理是指程序在执行过程中的一个较短时间,所执行的指令地址和要访问的数据通常都局限在一块区域内,这里可分为时间局部性和空间局部性: 时间局部性:一条指令的一次执行和下次执行,一个数据的一次访问和下次访问都集中在一个较短时间内;: c1 @& y. j7 C$ Z7 { 7 t# V0 x& [ ?2 `6 z2 A$ n7 y 空间局部性:当前指令和邻近的几条指令,当前访问的数据和邻近的几个数据都集中在一个较小区域内。 关于程序局部性原理的详细介绍和应用可以看我之前的文章: 通过TLB可以加快虚拟地址到物理地址的转换速度,还有个问题,现在都是64位操作系统啦,有很大的虚拟地址空间,虚拟地址空间大那对应的页表也会非常大,又加上多个进程多个页表,那计算机的大部分空间就都被拿去存放页表,有没有更好的办法解决页表大的问题呢?答案是多级页表。 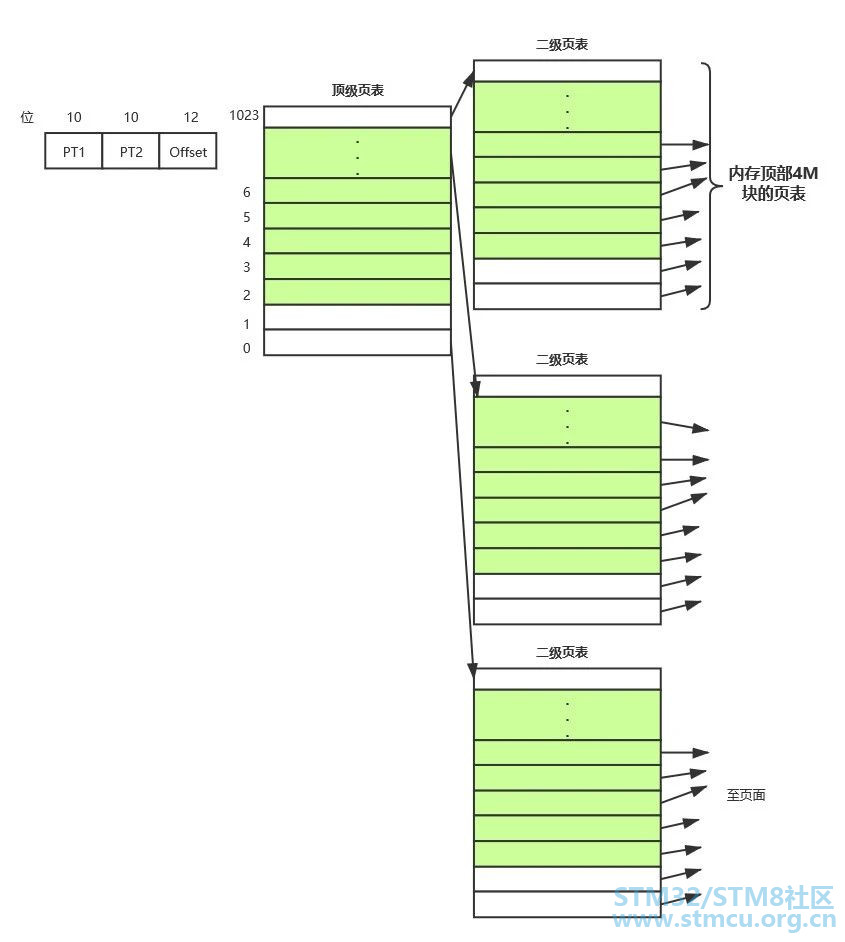
如图,以一个32位虚拟地址的二级页表为例,将32位虚拟地址划分为10位的PT1域,10位的PT2域,以及12位的offset域,当一个虚拟地址被送入MMU时,MMU首先提取PT1域并把其值作为访问第一级页表的索引,之后提取PT2域把把其值作为访问第二级页表的索引,之后再根据offset找到对应的页框号。 5 m4 B4 W9 e2 E- L " S$ o9 u3 `* J32位的虚拟地址空间下:每个页面4KB,且每条页表项占4B: 一级页表:进程需要1M个页表项(4GB / 4KB = 1M, 2^20个页表项),即页表(每个进程都有一个页表)占用4MB(1M * 4B = 4MB)的内存空间。 { e K% f h9 P' t" \ 二级页表:一级页表映射4MB(2^22)、二级页表映射4KB,则需要1K个一级页表项(4GB / 4MB = 1K, 2^10个一级页表项)、每个一级页表项对应1K个二级页表项(4MB / 4KB = 1K),这样页表占用4.004MB(1K * 4B + 1K * 1K * 4B = 4.004MB)的内存空间。 二级页表占用空间看着貌似变大了,为什么还说多级页表省内存呢? 1 i! f: E5 D% m6 r 每个进程都有4GB的虚拟地址空间,而显然对于大多数程序来说,其使用到的空间远未达到4GB,何必去映射不可能用到的空间呢?3 {) L) }' l, f0 W 也就是说,一级页表覆盖了整个4GB虚拟地址空间,但如果某个一级页表的页表项没有被用到,也就不需要创建这个页表项对应的二级页表了,即可以在需要时才创建二级页表。做个简单的计算,假设只有20%的一级页表项被用到了,那么页表占用的内存空间就只有0.804MB(1K*4B+0.2*1K*1K*4B=0.804MB),对比单级页表的4M是不是一个巨大的节约? 那么为什么不分级的页表就做不到这样节约内存呢?我们从页表的性质来看,保存在主存中的页表承担的职责是将虚拟地址翻译成物理地址。假如虚拟地址在页表中找不到对应的页表项,计算机系统就不能工作了。所以页表一定要覆盖全部虚拟地址空间,不分级的页表就需要有1M个页表项来映射,而二级页表则最少只需要1K个页表项(此时一级页表覆盖到了全部虚拟地址空间,二级页表在需要时创建)。 1 g- L6 l% N! E# h: T% T: i" s8 _ 二级页表其实可以不在内存中:其实这就像是把页表当成了页面。当需要用到某个页面时,将此页面从磁盘调入到内存;当内存中页面满了时,将内存中的页面调出到磁盘,这是利用到了程序运行的局部性原理。我们可以很自然发现,虚拟内存地址存在着局部性,那么负责映射虚拟内存地址的页表项当然也存在着局部性了!这样我们再来看二级页表,根据局部性原理,1024个第二级页表中,只会有很少的一部分在某一时刻正在使用,我们岂不是可以把二级页表都放在磁盘中,在需要时才调入到内存?+ @, I1 e9 j1 k0 P9 Y- ^# T - J: S/ N& E! o 我们考虑极端情况,只有一级页表在内存中,二级页表仅有一个在内存中,其余全在磁盘中(虽然这样效率非常低),则此时页表占用了8KB(1K*4B+1*1K*4B=8KB),对比上一步的0.804MB,占用空间又缩小了好多倍!(这里参考的下面知乎链接中大佬的回答) 7 q2 B6 O) v( G( Z" B c/ Q 06 什么是缺页中断?缺页中断就是要访问的页不在主存中,需要操作系统将页调入主存后再进行访问,此时会暂时停止指令的执行,产生一个页不存在的异常,对应的异常处理程序就会从选择一页调入到内存,调入内存后之前的异常指令就可以继续执行。 缺页中断的处理过程如下: ! Y' x g7 C2 W, r
5 d# c- z. B0 {1 m 当缺页中断发生时,需要调入新的页面到内存中,而内存已满时,选择内存中哪个物理页面被置换是个学问,由此引入了多种页面置换算法,致力于尽可能减少页面的换入换出次数(缺页中断次数)。尽量把未来不再使用的或短期内较少使用的页面换出,通常在程序局部性原理指导下依据过去的统计数据来进行预测。 最优页面置换算法:当一个缺页中断发生时,对于保存在内存当中的每一个逻辑页面,计算在它的下一次访问之前,还需等待多长时间,从中选择等待时间最长的那个,作为被置换的页面。注意这只是一种理想情况,在实际系统中是无法实现的,因为操作系统不可能预测未来,不知道每一个页面要等待多长时间以后才会再次被访问。该算法可用作其它算法的性能评价的依据(在一个模拟器上运行某个程序,并记录每一次的页面访问情况,在第二遍运行时即可使用最优算法)。& D& G5 W# [. T" J: `- K 先进先出算法:最先进入的页面最先被淘汰,这种算法很简单,就不过多介绍啦。, S. @) W) E: o- K# t+ G& ` 最近最久未使用算法:传说中的LUR算法,当发生缺页中断时,选择最近最久没有使用过的页面淘汰,该算法会给每个页面一个字段,用于记录自上次访问以来所经历的时间T,当需要淘汰一个页面时,选择已有页面中T值最大的页面进行淘汰。. x& U7 L. s( q& G% K# P% o9 m1 ^ 第二次机会页面置换算法:先进先出算法的升级版,只是在先进先出算法的基础上做了一点点改动,因为先进先出算法可能会把经常使用的页面置换出去,该方法会给这些页面多一次机会,给页面设置一个修改位R,每次淘汰最老页面时,检查最老页面的R位,如果R位是0,那么代表这个页面又老又没有被二次使用过,直接淘汰,如果这个页面的R位是1,表示该页面被二次访问过,将R位置0,并且把该页面放到链表的尾端,像该页面是最新进来的一样,然后继续按这种方法淘汰最老的页面。 时钟页面置换算法:第二次机会页面算法的升级版,尽管二次机会页面算法是比较合理的算法,但它需要在链表中经常移动页面,效率比较低,时钟页面置换算法如图,该算法把所有的页面都保存在一个类似时钟的环形链表中,一个表针指向最老的页面,当发生缺页中断时,算法首先检查表针指向的页面,如果它的R位是0就淘汰该页面,并且把新的页面插入这个位置,然后表针移动到下一个位置,如果R位是1就将R位置0并把表针移动到下一个位置,重复这个过程直到找到一个R位是0的页面然后淘汰。 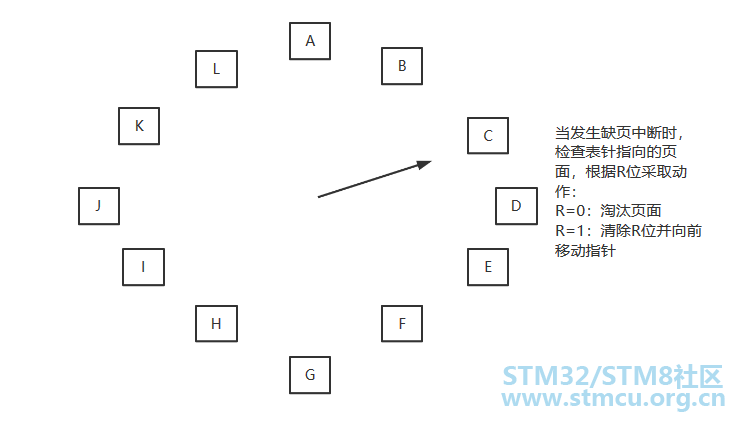
时钟页面置换算法 最不常用算法:当发生缺页中断时,选择访问次数最少的那个页面去淘汰。该算法可以给每个页面设置一个计数器,被访问时,该页面的访问计数器+1,在需要淘汰时,选择计数器值最小的那个页面。 这里有个问题:一个页面如果在开始的时候访问次数很多,但之后就再也不用了,那它可能永远都不会淘汰,但它又确实需要被淘汰,怎么办呢?可以定期把减少各个页面计数器的值,常见的方法是定期将页面计数器右移一位。 6 I+ X/ M" X2 _; j tips:最不常用算法(LFU)和最近最久未使用算法(LRU)的区别:LRU考察的是最久未访问,时间越短越好,而LFU考察的是访问的次数或频度,访问次数越多越好。 . N3 @( Q! |. m) d+ R8 H * v2 e0 w7 K- q7 e5 F/ O6 l) ]1 x. R工作集页面置换算法 介绍该算法时首先介绍下什么是工作集。 6 S: _$ A7 [# u1 `+ e 工作集是指一个进程当前正在使用的页面的集合,可以用二元函数W(t, s)表示:t表示当前的执行时刻)s表示工作集窗口,表示一个固定的时间段 W(t, s)表示在当前时刻t之前的s时间段中所有访问页面所组成的集合 * W( G/ G% C) H& _1 G* t% `1 f8 } 不同时间下的工作集会有所变化,如图:
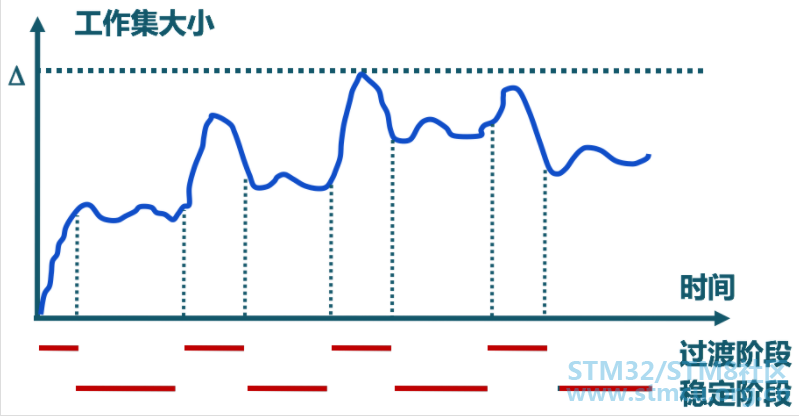
进程开始执行后随着访问新页面逐步建立较稳定的工作集 4 R0 B* m& ]' q* z当内存访问的局部性区域的位置大致稳定时(只访问那几个页面 没有大的改变时) 工作集大小也大致稳定 : p, l% R, [3 k. K; i e局部性区域的位置改变时(进程前一项事情做完 去做下一项事情时) 工作集快速扩张和快速收缩过渡到下一个稳定值 $ i. d, c# ^ z. t5 F" \8 p- }5 o 工作集置换算法主要就是换出不在工作集中的页面,示例如图:
, A; [6 t! O/ @2 D0 a 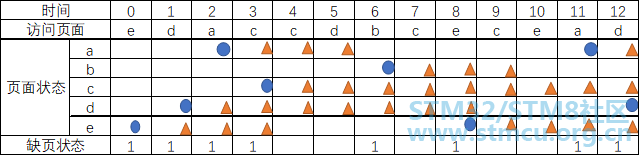
+ E6 n9 U; k/ {1 p3 q 工作集时钟页面置换算法 4 k/ s* b' O: T 在工作集页面置换算法中,当缺页中断发生后,需要扫描整个页表才能直到页面的状态,进而才能确定被淘汰的是哪个页面,因此比较耗时,所以引入了工作集时钟页面算法。与时钟算法改进了先进先出算法类似,工作集页面置换算法+时钟算法=工作集时钟页面置换算法。避免了每次缺页中断都需要扫描整个页表的开销。 08什么是分段内存管理? ) z. M* R6 r1 P' `% M+ b7 q9 }, L 关于分段内存管理我们平时见的最多的应该就是Linux可执行程序的代码段数据段之类的啦,要了解分段最好的方式就是了解它的历史。分段起源于8086CPU,那时候程序访问内存还是直接给出相应单元的物理地址,为了方便多道程序并发执行,需要支持对各个程序进行重定位,如果不支持重定位,涉及到内存访问的地方都需要将地址写死,进而把某个程序加载到物理内存的固定区间。通过分段机制,程序中只需要使用段的相对地址,然后更改段的基址,就方便对程序进行重定位。而且8086CPU的地址线宽度是20位,可寻址范围可以达到1MB,但是它们的寄存器都是16位,直接使用1个16位寄存器不可能访存达到1MB,因此引入了段,引入了段寄存器,段寄存器左移4位+偏移量就可以生成20位的地址,从而达到1MB的寻址范围。 以如今的科技水平,其实已经不再需要这种段移位加偏移的方式来访存,分段更多的是一种历史包袱,没有多大实际作用,而且我们经常见到的可执行程序中代码段数据段这些更多是为了在逻辑上能够更清晰有序的构造程序的组织结构。Linux实际上没有使用分段而只使用了分页管理,这样会更加简单,现在的分段其实更多是为了使逻辑更加清晰。一个公司,为了方便管理都会划分为好多个部门,这其实和分段逻辑相似,没有什么物理意义但是逻辑更加清晰。 关于操作系统的内存知识点就介绍到这里,希望对大家有所帮助! |
| 学习了,点个赞,谢谢分享! |
 微信公众号
 手机版


