|
一些同学可能对计算机运行的速度还没有概念,就是感觉计算机运行速度应该会很快,那么在leetcode上做算法题目的时候为什么会超时呢?1 S0 h/ F7 f5 T! \' s+ r. _ 计算机究竟1s可以执行多少次操作呢?接下来探讨一下这个问题。 超时是怎么回事
大家在leetcode上练习算法的时候应该都遇到过一种错误是“超时”。 也就是说程序运行的时间超过了规定的时间,一般OJ(online judge)的超时时间就是1s,也就是用例数据输入后最多要1s内得到结果,暂时还不清楚leetcode的判题规则,下文为了方便讲解,暂定超时时间就是1s。 如果写出了一个O(n)的算法 ,其实可以估算出来n是多大的时候算法的执行时间就会超过1s了。 如果n的规模已经足够让O(n)的算法运行时间超过了1s,就应该考虑log(n)的解法了。 从硬件配置看计算机的性能计算机的运算速度主要看CPU的配置,以2015年MacPro为例,CPU配置:2.7 GHz Dual-Core Intel Core i5 。 也就是 2.7 GHz 奔腾双核,i5处理器,GHz是指什么呢,1Hz = 1/s,1Hz 是CPU的一次脉冲(可以理解为一次改变状态,也叫时钟周期),称之为为赫兹,那么1GHz等于多少赫兹呢
所以 1GHz = 10亿Hz,表示CPU可以一秒脉冲10亿次(有10亿个时钟周期),这里不要简单理解一个时钟周期就是一次CPU运算。 例如1 + 2 = 3,cpu要执行四次才能完整这个操作,步骤一:把1放入寄存机,步骤二:把2放入寄存器,步骤三:做加法,步骤四:保存3。 而且计算机的cpu也不会只运行我们自己写的程序上,同时cpu也要执行计算机的各种进程任务等等,我们的程序仅仅是其中的一个进程而已。 所以我们的程序在计算机上究竟1s真正能执行多少次操作呢? 做个测试实验在写测试程序测1s内处理多大数量级数据的时候,有三点需要注意:
尽管有很多因素影响,但是还是可以对自己程序的运行时间有一个大体的评估的。 引用算法4里面的一段话:
所以「任何开发计算机程序员的软件工程师都应该能够估计这个程序的运行时间是一秒钟还是一年」。 这个是最基本的,所以以上误差就不算事了。 以下以C++代码为例: 测试硬件:2015年MacPro,CPU配置:2.7 GHz Dual-Core Intel Core i5 实现三个函数,时间复杂度分别是 O(n) , O(n^2), O(nlogn),使用加法运算来统一测试。 // O(n)void function1(long long n) { long long k = 0; for (long long i = 0; i < n; i++) { k++;% O3 R- s( e$ o) ?7 N# } }- ~ U! b: G1 f n }" H/ v" ]# g9 t: ~0 g: R* X! ~ 3 e/ x- d. o: Z) z9 J" Y+ a // O(n^2) void function2(long long n) { long long k = 0;* p7 T* u& y' d+ o: f3 W for (long long i = 0; i < n; i++) {5 U2 i5 T" c* e for (long j = 0; j < n; j++) { k++; }2 }1 _( c# ?* R' W } }1 V2 W' K n8 C) ~% U // O(nlogn), R' b' N3 _+ ~+ Q void function3(long long n) {, |, M: {8 q$ r% l9 w long long k = 0;+ e( W5 j3 r0 L for (long long i = 0; i < n; i++) { for (long long j = 1; j < n; j = j * 2) { // 注意这里j=1 k++;* G7 d5 ?& h2 B, j4 D2 [* @ } } }# j* _9 P, ]3 J6 }4 @ 来看一下这三个函数随着n的规模变化,耗时会产生多大的变化,先测function1 ,就把 function2 和 function3 注释掉 int main() {long long n; // 数据规模$ [0 l3 C1 `; A( ^0 v) d while (1) { cout << "输入n:";" s. U, u. p4 b% P# Y: [ cin >> n;5 p& k1 h; P3 `4 A5 g* M# L milliseconds start_time = duration_cast<milliseconds >( system_clock::now().time_since_epoch() f% {1 ?- R9 c& Z/ C ); function1(n);/ s- t$ }2 b/ _+ |- f% h1 Y+ h, J. V // function2(n); // function3(n);3 W/ g' ?8 f4 w5 g4 N' p- k) u milliseconds end_time = duration_cast<milliseconds >( system_clock::now().time_since_epoch() ); cout << "耗时:" << milliseconds(end_time).count() - milliseconds(start_time).count()9 B3 J# t! V; {. ~$ k! q5 b( p+ D <<" ms"<< endl;$ o9 z i; R+ @6 C3 U }- @& Y2 s( J6 ] }! T$ _/ s# V2 v" v" j 来看一下运行的效果,如下图:
O(n)的算法,1s内大概计算机可以运行 5 * (10^8)次计算,可以推测一下O(n^2) 的算法应该1s可以处理的数量级的规模是 5 * (10^8)开根号,实验数据如下。
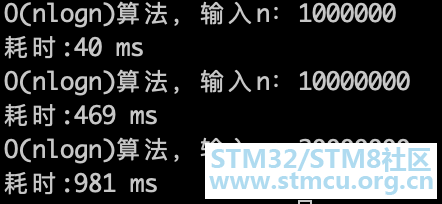
O(n^2)的算法,1s内大概计算机可以运行 22500次计算,验证了刚刚的推测。 在推测一下O(nlogn)的话, 1s可以处理的数据规模是什么呢? 理论上应该是比 O(n)少一个数量级,因为logn的复杂度 其实是很快,看一下实验数据。
这是在我个人PC上测出来的数据,不能说是十分精确,但数量级是差不多的,大家也可以在自己的计算机上测一下。 「整体测试数据整理如下:」
#include <chrono>; L) Y X9 X m #include <thread>3 X1 l' {& s/ ~ using namespace std; using namespace chrono;+ ~1 }/ b+ A0 j3 K- {8 I4 L // O(n) void function1(long long n) {- S6 B; ^ a0 u8 { long long k = 0;& x) Z) B* X0 D8 {" @9 f' C for (long long i = 0; i < n; i++) {2 _/ [( ]7 u, `" {/ @4 t$ i9 N k++;8 M. D; F! R9 b1 K, x } }4 y6 a' A" E% b" k ; Z% S" x8 {/ f5 U* D // O(n^2) void function2(long long n) { long long k = 0;, Q- A% E) Q9 a: n% y& G9 l for (long long i = 0; i < n; i++) { for (long j = 0; j < n; j++) { k++; } } } // O(nlogn): h8 H1 g8 ]: k& f# l: I* s void function3(long long n) {$ e; Y% d/ v, q# ]1 L/ T6 a long long k = 0;: F0 ]/ ]. o6 H# H for (long long i = 0; i < n; i++) { for (long long j = 1; j < n; j = j * 2) { // 注意这里j=1- M* J6 ? _5 x6 C, g k++;7 f4 D1 M9 F+ ~8 }6 r8 L' l2 z$ ~ } `4 N; L% V+ Y: o6 z/ m, e } }0 w2 W& k f0 V1 n int main() { long long n; // 数据规模6 U( \% c7 N/ @3 s/ m; l while (1) {' h) Y W( K' C cout << "输入n:"; cin >> n;' N/ y' e) b" g u9 S milliseconds start_time = duration_cast<milliseconds >(# J3 B: Q U! z% E- t6 \ system_clock::now().time_since_epoch()# Y1 o/ T U+ Z6 Y' Z* @6 T% @3 S" P ); function1(n);: r$ n& O! o/ s$ r // function2(n); // function3(n); milliseconds end_time = duration_cast<milliseconds >( l" _. d4 L: w, M h% m system_clock::now().time_since_epoch()4 {3 H7 s$ v; m& {* \ );. @6 c7 ^! P8 V1 n" C/ |' `6 J cout << "耗时:" << milliseconds(end_time).count() - milliseconds(start_time).count()6 S! i0 X$ e$ Q' r <<" ms"<< endl;; _: V) o7 |- y! ]! J }- c' a/ j/ M: {- u' E# R0 b7 u } 2 Y- I2 z! e, C3 g9 s 总结 本文详细分析了在leetcode上做题程序为什么会有超时,以及从硬件配置上大体知道CPU的执行速度,然后亲自做一个实验来看看O(n)的算法,跑一秒钟,这个n究竟是做大,最后给出不同时间复杂度,一秒内可以运算出来的n的大小。 建议大家也都自己做一做实验,测一测,看看是不是和我的测出来的结果差不多。 这样,大家应该对程序超时时候的数据规模有一个整体的认识了。 |
 微信公众号
 手机版