前言
2 z% r. ?# ~/ Z h" ^( W* QGPU即图形处理器,是现代显卡的核心。在没有GPU的时代,所有图形的绘制都是由CPU来完成的,CPU需要计算图形的边界、颜色等数据,并且负责将数据写入显存。简单的图形还没有什么问题,但随着计算机的发展(尤其是游戏的发展),需要显示的图形图像越来越复杂,CPU也就越来越力不从心。所以后来GPU应运而生,将CPU从繁重的图形计算任务中拯救了出来,大大加速了图形的显示速度。$ ]" C6 h* S+ ]: \" ]# ?, i; b! s9 [/ ]
8 h8 e# \; v( m$ f" X- `5 G' g: q m4 H
而单片机这边也有类似的发展历程。在早期的单片机使用场景中,极少有图形显示的需求。即使有,也只是简单的12864之类的显示设备,运算量不大,单片机的CPU可以很好的处理。但是随着嵌入式图形的发展,单片机需要承担的图形计算和显示任务越来越多,嵌入式系统的显示分辨率和色彩也一路飙升。慢慢地,单片机的CPU对这些计算就开始力不从心了。所以,自STM32F429开始,一个类似GPU的外设开始加入到STM32的单片机中,ST称之为Chrom-ART Accelerator,也叫DMA2D(本文将使用此名称)。DMA2D可以在很多2D绘图的场合提供加速,完美嵌合了现代显卡中“GPU”的功能。2 [/ b. C9 X2 w' H6 U2 j
m/ ~: u( p8 D$ _( z
8 ]( A9 G/ d) G. f
虽然这个“GPU”只能提供2D加速,而且功能非常简单,与PC中的GPU不可同日而语。但是它已经可以满足大多数嵌入式开发中的图形显示加速需求,只要用好了DMA2D,我们在单片机上也可以做出流畅、华丽的UI效果。% O# c7 `) }8 u ?" m8 Z
9 F5 h9 \" _+ D- z
6 c5 R9 g4 @( d! ?# U4 h: x本文将从实例出发,介绍DMA2D在嵌入式图形开发中的可以发挥的作用。目的是使读者能简单、快速地对DAM2D的建立最基本的概念并且学会最基本的用法。为了防止内容过于晦涩和难懂,本文不会对DMA2D的高级功能和特性进行深入地刨析(如详细介绍DMA2D的架构、全部的寄存器等等)。如果需要更加详细、专业地学习DAM2D,可以在阅读完本文后参考《STM32H743中文编程手册》。/ l+ ^- j+ d, f/ _- F
. b/ e6 |8 S' B5 H: g4 e5 }& Y
, y' K" E. Z4 H7 M2 R8 x; K
阅读本文之前需要对STM32中的TFT液晶控制器(LTDC)和基本的图形知识(如帧缓冲framebuffer、像素、颜色格式等概念)有一定的了解。
' ~, p! v) d* T" J3 [2 q# E( r% |; [( D$ U w( g* n/ ?
. }1 s; h- w, C; `; N8 {2 ?另,除了ST之外,其他不少厂商生产的MCU中也存在类似功能的外设(如NXP在RT系列中设计的的PxP),不过这些不在本文的讨论范围内,有兴趣的朋友可以自行了解。
2 e5 [ C% k( u3 N
# i( q' g0 g+ X9 O& d& M7 A/ @! o3 T3 w/ t5 g
准备工作0 x% V$ N( x! J: O7 I% G T
硬件准备5 j7 }+ F( @, T3 [
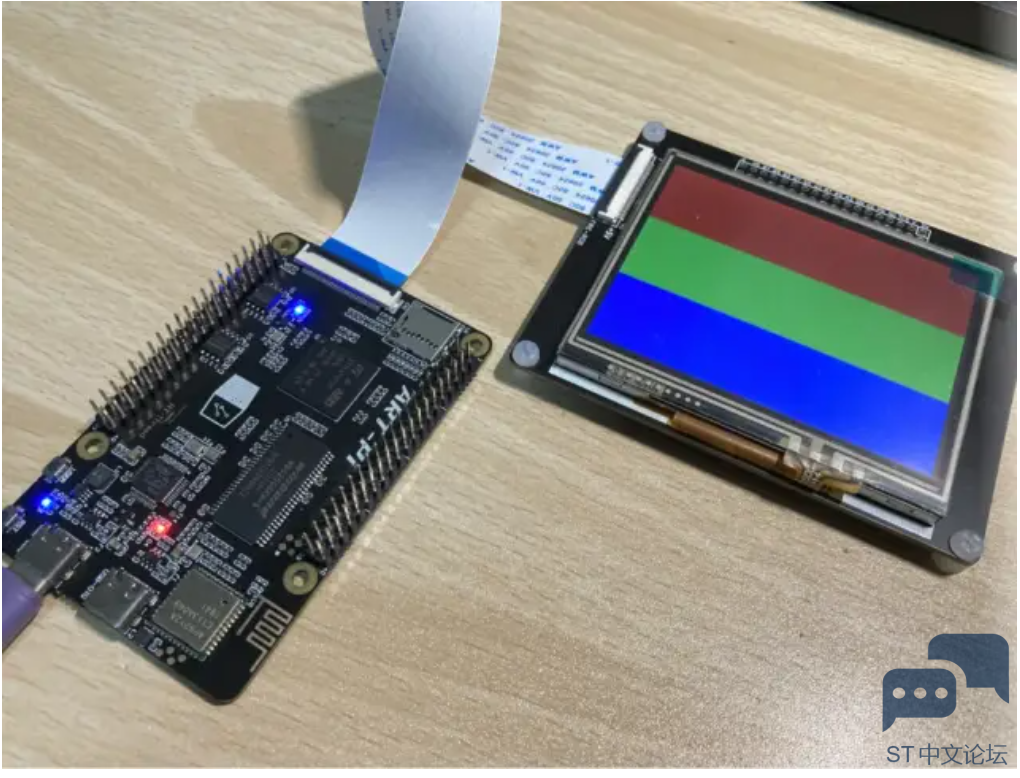
可以使用任何的,带有DMA2D外设的STM32开发板来验证本文中的例子,如STM32F429,STM32F746,STM32H750等MCU的开发板。本文中使用的开发板是ART-Pi 。ART-Pi是由RT-Thread官方出品的开发板,采用了主频高达480MHz的STM32H750XB+32MB SDRAM的强悍配置。而且板载了调试器(ST-Link V2.1),使用起来非常方便,特别适合各种技术方案的验证,用来作为本文的硬件演示平台再合适不过了。% b3 P( u9 n0 i
. E- O& r# V' {! x; D# F$ j& a$ x% r7 |
显示屏可以是任意的彩色TFT显示屏,推荐使用16位或24位颜色的RGB接口显示屏。本文中使用的是一块 3.5‘’ 的TFT液晶显示屏,接口为RGB666,分辨率为320x240(QVGA)。在LTDC中,配置使用的颜色格式为RGB565
* o. }8 s2 ~' H3 W% s B% y# i* ]: y6 E, ?, K# G2 J6 _7 n7 {) t9 t6 q
% C i& C& B1 ?, I. F4 L- S. O4 p
G1 `4 |+ G* o* w0 H( s# d. z- a# z( O, ?
8 _0 @/ W# F* ^& n4 W! d! \# D开发环境准备
/ p( k0 ?" _ Z- Y4 b. t本文中介绍的内容和出现的代码可以在任何你喜欢的开发环境中使用,如RT-Thread Studio,MDK,IAR等。7 H' i2 U3 Y8 p1 [% z
8 }8 R0 F2 x$ [* _. T1 N" L1 Y* `" x* j3 I9 t, {0 ~5 @
开始本文的实验前你需要一个以framebuffer技术驱动LCD显示屏的基本工程。运行本文中所有的代码前都需要预先使能DMA2D。0 g& E2 e& ~# u. r( x, d
7 r; s& s4 P7 Q/ y) X
; ~) O/ _' Z7 ^- _- h6 g: r使能DMA2D可以通过这个宏来实现(硬件初始化时使能一次即可):& A' P- `/ E& G' b/ u
" s$ h( k) c5 X
% p8 e# t7 u( V, U: U" p$ |" W- <font face="微软雅黑" size="3">1// 使用DMA2D之前一定要先使能DMA2D外设! z1 j+ S5 o. s, O% d0 s
- 6 ` E* y9 ~3 ^5 d2 D3 s' k; O
- 2__HAL_RCC_DMA2D_CLK_ENABLE();7 W1 t& D+ I! p# c2 l( f
- * j) Z& A6 J `4 ~- u& ~' u
- </font>
5 s2 _! q/ M4 q7 ~7 D6 l( MDMA2D的简介
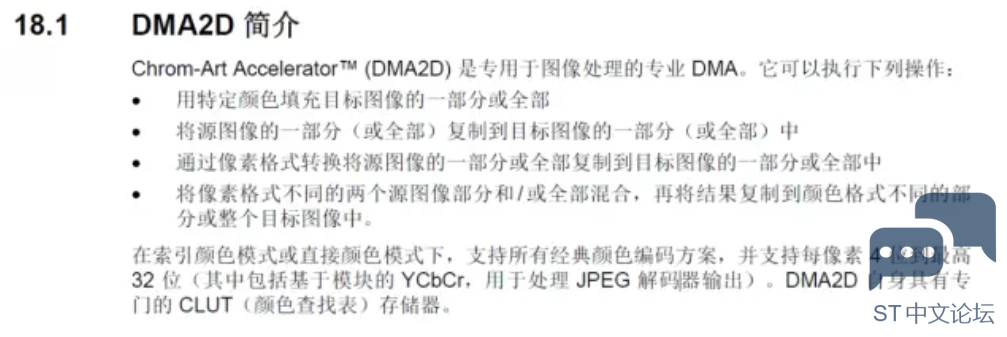
2 w8 \- V1 c; ~$ X7 i我们先来看看ST是怎么描述DMA2D的
$ |: |4 m( h( \6 j5 g4 A. {9 H' m6 ~! z3 x# x" ^9 [
3 t4 a4 F' p' b$ ~, G( W5 u. ]
I0 v; Q3 U e- {% J5 a: f; s) H) Y9 _! `1 p9 Q3 L ?7 [
( I* b; z, ?1 ?4 B o" _7 `乍一看有点晦涩,但其实说白了就以下几个功能:
4 K9 w2 u' K$ m( B- Y3 C- 颜色填充(矩形区域)
- 图像(内存)复制
- 颜色格式转换(如YCbCr转RGB或RGB888转RGB565)
- 透明度混合(Alpha Blend)3 e5 X8 i7 a5 z* ^1 s1 X
4 J1 ]8 x2 H8 N; f7 b9 v
% H3 p( h! t5 p4 u
, S- c! o" T: ~' W* v
前两种都是针对内存的操作,后两个则是运算加速操作。其中,透明度混合、颜色格式转换可以和图像复制一起进行,这样就带来了较大的灵活性。
. h$ {' _- @' ?- M" _. r5 x* G5 _& U# d0 R$ k! k) ]; w
( @& z$ A: I8 p3 s ~( r: P可以看到,ST对DMA2D的定位就像它的名字一样,是一个针对图像处理功能强化过的DMA。而在实际开发的过程中,我们会发现DMA2D的使用方式也非常类似传统的DMA控制器。在某些非图形处理场合,DMA2D甚至也可以代替传统的DMA来发挥作用。
# J8 I4 k/ W2 |1 V- @! h" W6 @* B9 U4 r, \5 q8 W
. A& ]# P1 M" E T3 |- c! V需要注意的是,ST的不同产品线的DMA2D加速器是有微小区别的,比如STM32F4系列MCU的DMA2D就没有ARGB和AGBR颜色格式互转的功能,所以具体需要用到某个功能的时候,最好先查看编程手册看所需的功能是否被支持。
/ R7 D4 j8 ^+ X) C
9 A* R4 ?( T4 X! U' @
$ u! {3 a- \) b5 o+ r本文只介绍所有平台的DMA2D共有的功能。
$ x+ K: [+ d5 T& ^4 S, J. j2 k/ ?# B5 F: a- [5 z+ a
{4 A6 G1 c: } U7 u# G3 z5 cDMA2D的工作模式' @0 n/ [4 \+ Z$ M; N9 B7 I
就像传统DMA有外设到外设,外设到存储器,存储器到外设三种工作模式一样,DMA2D作为一个DMA,也分为以下四种工作模式:+ i( |) D5 b% Z! {+ P0 O1 Q, {0 W
H( N7 h2 @ w, u+ W6 y3 G2 f5 }- o! h5 Y, y$ [: V* j5 i
寄存器到存储器* Q2 X+ ^' G7 x5 _' x2 ^' v
% N' g: `# G2 O0 Z. _7 L% D' B
9 X% }( {0 k' n% P: N! h- W存储器到存储器4 z/ n0 S& ~. X# X% H" r, C: c
# x! M+ B7 S: u* W) C, @
0 _) L+ n. E6 e7 ?存储器到存储器并执行像素颜色格式转换
" S3 r' ]- v o0 O5 b, I6 T& q0 e4 J" {( V: r
$ N8 B& V& @& x- A% D
存储器到存储器且支持像素颜色格式转换和透明度混合
- m' ]7 p ?9 |" H2 S3 M, s% F3 H( T% J
# b }' k# Y/ N& u可以看出,前两种模式起始就是简单的内存操作,而后面两种模式,则是在进行内存复制时,根据需要同时进行颜色格式转换或/和透明度混合。" S/ R& u, H2 Z7 v1 k
0 H' Q( l8 R* F4 a Y
. ^0 t" C; s$ m4 M" E
DMA2D和HAL库' K0 b8 n2 T3 a% |' P
大多数情况下,使用HAL库可以简化代码编写,提高可移植性。但是在DMA2D的使用时则是个例外。因为HAL库存在的最大问题就是嵌套层数再加上各种安全检测过多效率不够高。在操作别的外设时,使用HAL库损失的效率并不会有多大的影响。但是对于DMA2D这种以计算和加速为目的的外设,考虑到相关的操作会在一个屏幕的绘制周期内被多次调用,此时再使用HAL库就会导致DAM2D的加速效率严重下降。
3 E1 U2 ?: k+ `; T) C, f4 C& G) f% R6 K3 Z& [* c
m8 ~6 l& K5 _& N# X; y
所以,我们大多时候都不会用HAL库中的相关函数来对DMA2D进行操作。为了效率,我们会直接操作寄存器,这样才能起到最大化的加速效果。 g% R3 o; k& y8 K; G4 w
$ O7 Q# L4 Q0 `0 j; O. }- n8 O
9 A+ C3 \. `- D; P' \
因为我们使用DMA2D的大多数场合都会频繁变更工作模式,所以CubeMX中对DMA2D的图形化配置也失去了意义。0 q6 \+ R0 L8 s* B0 F0 A. A7 E
1 e4 L: M1 A4 |' w( G
4 E$ `, {+ ~! Q5 |& A! d
DMA2D场景实例
! h7 c, q2 |5 h4 b" q0 M7 {1 u8 G1. 颜色填充
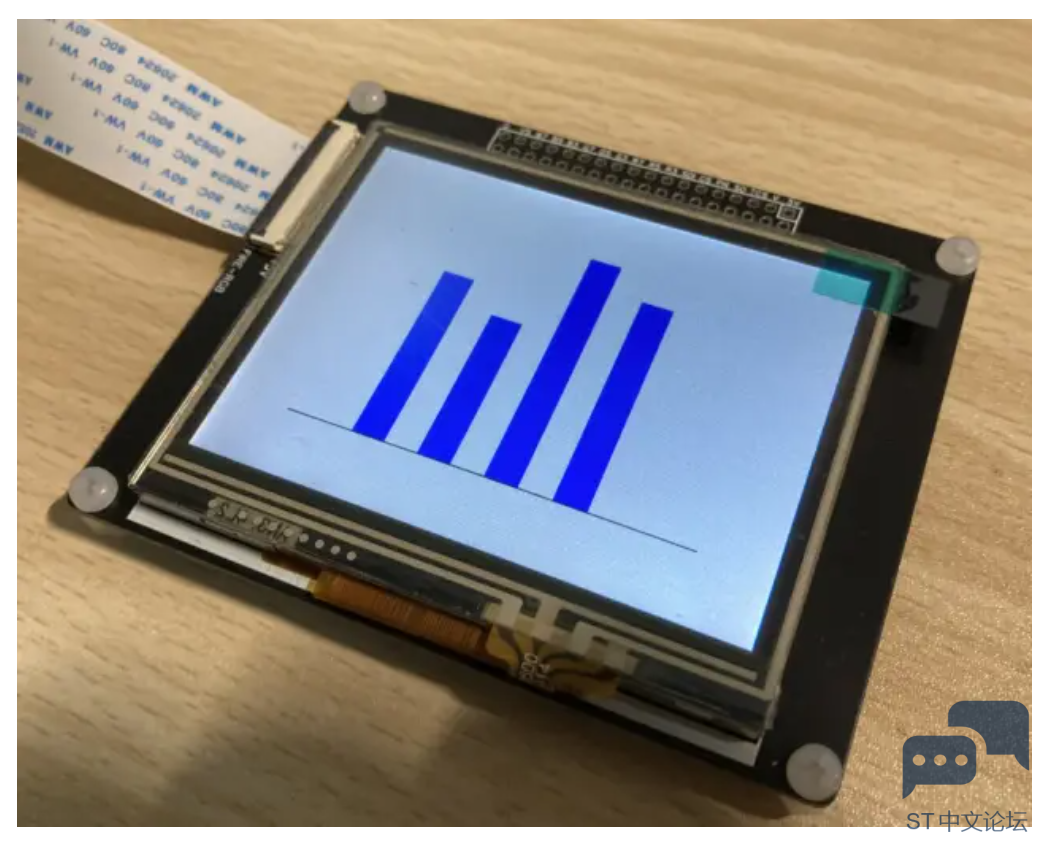
0 u7 e, |7 j% K/ Z: a下图是一个简单的柱状图:
& ?3 R* M5 n' _: \0 O! j) g
: M/ \4 A$ v1 f, Y0 f* T9 r9 L# `3 u2 M2 U3 d' H6 a, F, n

+ W5 m9 F, }8 k) l6 ^0 C$ Q1 Y
7 l ?' M& x4 F
1 Q: @8 i1 g: a3 B7 S我们来思考一下如何把它绘制出来。4 o& j- L# _! p9 H1 O
" o q2 Q; r* S1 F5 i) D
0 t h9 h0 l! g: P+ L! K. Z6 b! N
首先,我们需要使用白色来填充屏幕,作为图案的背景。这个过程是不能忽略的,否则屏幕上原来显示的图案会对我们的主体产生干扰。然后,柱状图其实是由4个蓝色的矩形方块和一条线段构成的,而线段也可以视作一个特殊的,高度为1的矩形。所以,这个图形的绘制可以分解为一系列“矩形填充”操作:
& Q( i/ ~+ s1 {, t
" i% A1 a3 G6 V0 s0 Z8 n; a' G' R# Y" s; a9 A
- 使用白色填充一个大小等于屏幕大小的的矩形
- 使用蓝色填充四个数据条
- 使用黑色填充一根高度为1的线段" n. k9 j3 |/ s# A9 L. {
! ~, X/ t: q% i# t. N
& M6 n+ [% R8 S1 a1 o0 j. ]/ K- r5 W, B1 u, n+ K7 t! h
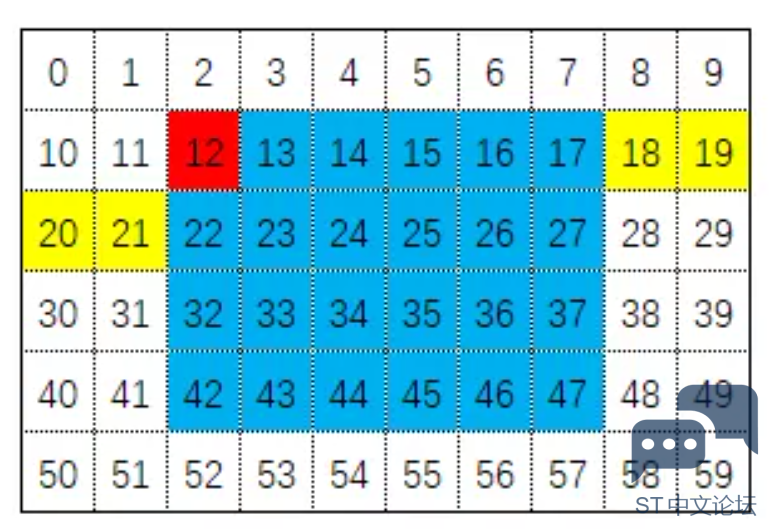
在画布中实现任意位置绘制任意大小的矩形的本质就是将内存区域中对应像素位置的数据设定为指定的颜色。但是因为framebuffer在内存中的存储是线性的,所以除非矩形的宽度正好和显示区域的宽度重合,否看似连续的矩形的区域在内存中的地址是不连续的。
* t! d, K! m8 |, F+ c2 P! z! h( P t( B2 U
: [$ u3 b$ `. U. C0 W* u6 o下图展示了典型的内存分布情况,其中的数字表示了frame buffer中每个像素的内存地址(相对首地址的偏移,这里忽略掉了一个像素占多个字节的情况),蓝色区域是我们要填充的矩形。可以看出矩形区域的内存地址是不连续的。 G( A% x2 \6 x. S9 }8 E
4 F, i/ N7 v1 ?+ s$ h: ]: y- z
; z7 \. h3 X8 z- C3 n" C( c) G# Z

% X5 [8 s4 \- F- o$ q% a! a9 b {framebuffer的这种特性使得我们不能简单使用memset这类高效的操作来实现矩形区域的填充。通常情况下,我们会使用以下方式的双重循环来填充任意矩形,其中xs和ys是矩形左上角在屏幕上的坐标,width和height表示矩形的宽和高,color表示需要填充的颜色:# H" G' z( o% G L X
; t3 \8 ~9 s8 h# \" b
; Q% e+ e4 ^5 b' Y/ s% ]9 p' t7 s- <font face="微软雅黑" size="3">1for(int y = ys; y < ys + height; y++){/ N# i# a1 ]* l% B! e
5 y6 c" w: d# d/ L- 2 for(int x = xs; x < xs + width; x++){4 L. q8 `0 {2 `8 Z3 m
- - o' H( o* e) O# @/ _
- 3 framebuffer[y][x] = color; , d0 A8 z5 }; I! d2 M- M( }
- . v& n" N4 c7 W8 U. x8 c, S( w0 }
- 4 }
7 m0 ]0 N( o' h8 P
. v/ ?# W# z9 F4 I" ?- 5}</font>
* B- F# T8 t- O
代码虽然简单,但实际执行时,大量的CPU周期浪费在了判断、寻址、自增等的操作,实际写内存的时间占比很少。这样一来,效率就会下降。
# ]) X8 q1 S0 L, v
B% S$ A- D' R6 j* o I
8 u3 W! `' W' H' z9 g这时候DMA2D的寄存器到存储器工作模式就可以发挥用场了,DAM2D可以以极高的速度填充矩形的内存区域,即使这些区域在内存中实际是不连续的。
$ F0 m: ]2 ?+ a+ z( j2 r1 w2 l. `1 V
: q9 Y/ ^) k- u- ]& W, Z. r* `; `2 L1 I4 N) U- O7 z6 |
依然以这张图中演示的情况为例,我们来看它是如何实现的:
$ l4 b* j2 X. L5 n% p1 }9 k5 q/ B3 a, d& q3 I! M' `) N3 ?
; I6 p- p( Q2 l5 P
! d& Q" N& \7 m4 W8 o5 r6 G% G1 d; F) k) C
& Z0 K7 i3 D" E$ b- h首先,因为我们只是进行内存填充,而不需要进行内存拷贝,所以我们要让DAM2D工作在寄存器到存储器模式。这通过设置DMA2D的CR寄存器的[17:16]位为11来实现,代码如下:& h" ^" f+ t/ o- e7 a
- <font face="微软雅黑" size="3">1DMA2D->CR = 0x00030000UL;</font>
$ W3 S6 y' Y; A/ [( Z C% \" |9 y* t; n4 b; n$ Q/ K `% Y
9 t8 o3 U U1 V: z+ u% E
区域起始地址是矩形区域左上角第一个像素的内存地址(图中红色像素的地址),这个地址由DAM2D的OMAR寄存器管理。而矩形的宽度和高度都是以像素为单位的,分别由NLR寄存器的高16位(宽度)和低16位(高度)来进行管理,具体的代码如下:, ?- Y. a0 n+ W: p2 y6 n
7 {, L! d& [* P0 e1 C& p6 ^! E) R
0 c" Z8 C* ?1 G- [# G1 R- <font face="微软雅黑" size="3">1DMA2D->OMAR = (uint32_t)(&framebuffer[y][x]); // 设置填充区域的起始像素内存地址1 r% I4 j9 X' |! i5 M
- % K& e+ r6 a+ X& y5 X+ q
- 2DMA2D->NLR = (uint32_t)(width << 16) | (uint16_t)height; // 设置矩形区域的宽高
' x; w6 ]+ B6 X* ?1 C8 t3 V9 b2 F - 0 g @5 j D3 s3 L# d% \6 @0 W: j
- </font>
4 Z, O- R) p2 O+ h" T& N" }$ Z& k' y ?" O" F' G1 T
接着,因为矩形在内存中的地址不连续,所以我们要告诉DMA2D在填充完一行的数据后,需要跳过多少个像素(即图中黄色区域的长度)。这个值由OOR寄存器管理。计算跳过的像素数量有一个简单的方法,即显示区域的宽度减去矩形的宽度即可。具体实现代码如下:
- Y; K( y' t( F X- I2 t2 }- <font face="微软雅黑" size="3">1DMA2D->OOR = screenWidthPx - width; // 设置行偏移,即跳过的像素</font>
3 @' U, g. u! Y' e
最后,我们需要告知DAM2D,你将使用什么颜色来进行填充,颜色的格式是什么。这分别由OCOLR和OPFCCR寄存器来管理,其中颜色格式由LTDC_PIXEL_FORMAT_XXX宏来定义,具体代码如下:1 m5 N1 T( N0 o
$ }% ?9 k' R/ d
: }; t0 ~" S; M7 Y4 I$ Q5 ~- <font face="微软雅黑" size="3">1DMA2D->OCOLR = color; // 设置填充使用的颜色
% z( ~4 }% r, j% |5 e - " O. E0 d/ E. k+ y
- 2DMA2D->OPFCCR = pixelFormat; // 设置颜色格式,比如想设置成RGB565,就可以使用宏LTDC_PIXEL_FORMAT_RGB565</font>
7 q5 w! q% N/ l, @' }5 a7 G: l9 s. ]
+ y" i( @: ^, Q0 Q. e6 _! H4 Q
( @) { \. U; J% Q( j, e) A9 p一切都设置完毕,DMA2D已经获取到了填充这个矩形所需要的全部信息,接下来,我们要开启DMA2D的传输,这通过将DMA2D的CR寄存器的第0位设置为1来实现:
' P& H" J' m' |
0 r) b2 ~" u6 W7 L/ L
, t) U: P4 V( Z( U- G" y( k- <font face="微软雅黑" size="3">1DMA2D->CR |= DMA2D_CR_START; // 开启DMA2D的数据传输,DMA2D_CR_START是一个宏,其值为0x01</font>
) y5 J# [5 ?) i: }6 x
, f8 s, ?' J, C2 l x/ Z
" Y, x; ]* p G* U+ T- v' P" t; q/ d) ~( K# i" Z$ y& J
等DMA2D传输开始后,我们只需要等待它传输完毕即可。DAM2D传输完成后,会自动把CR寄存器的第0位设置为0,所以我们可以通过以下代码来等待DAM2D传输完成:6 ]4 p* t6 Z2 Y. J; F: y
1 Z3 V* A" S* S( D2 S& x1 c t) O1 ~. l m7 v4 T
- <font face="微软雅黑" size="3">1while (DMA2D->CR & DMA2D_CR_START) {} // 等待DMA2D传输完成</font>
& E) H/ j& u9 r. @3 S. L3 |/ F* q5 G- E
: p1 z8 J+ C$ `tips1:当然,由于实际执行时,DMA2D进行内存填充的速度实在是太快了,以至于OS切换任务的开销都比这个时间要长,所以即便使用了OS,我们还是会选择死等  。
. [- S$ D# ^1 b# n# E6 d8 q# C, W) p
9 c6 W8 H0 w0 x8 E- h为了函数的通用性考虑,起始传输地址和行偏移都在函数外计算完毕后传入,我们抽出的完整的函数代码如下:3 m3 v/ ]2 c8 p1 q% M6 v6 d
- <font face="微软雅黑" size="3">1static inline void DMA2D_Fill( void * pDst, uint32_t width, uint32_t height, uint32_t lineOff, uint32_t pixelFormat, uint32_t color) {7 C. h+ R; i% ~1 ?
- 2, l) Q. K8 V1 M, c @7 a! ^$ n
- 3 /* DMA2D配置 */
) E2 `# r; w( b4 @7 [# }; A - 4 DMA2D->CR = 0x00030000UL; // 配置为寄存器到储存器模式8 e/ J% f4 z* Z3 G' J- ~# i
- 5 DMA2D->OCOLR = color; // 设置填充使用的颜色,格式应该与设置的颜色格式相同: G5 G2 s3 ?0 K0 C% I
- 6 DMA2D->OMAR = (uint32_t)pDst; // 填充区域的起始内存地址
- ~# ?3 E# r5 e/ W2 R - 7 DMA2D->OOR = lineOff; // 行偏移,即跳过的像素,注意是以像素为单位, ]8 j, [* i- {% G4 k' |2 i
- 8 DMA2D->OPFCCR = pixelFormat; // 设置颜色格式
! I- O9 ~( ]- o u5 V1 x - 9 DMA2D->NLR = (uint32_t)(width << 16) | (uint16_t)height; // 设置填充区域的宽和高,单位是像素# I0 J% l; Y1 ?0 U* k
- 101 k R! B" I" j. h% m
- 11 /* 启动传输 */
0 u$ s0 C! X& h) i5 z - 12 DMA2D->CR |= DMA2D_CR_START;
! |- b7 B( |( Y: E# J' Y" j - 13! E! \! Y! R1 [5 m! A7 ?' e
- 14 /* 等待DMA2D传输完成 */
7 R# ~. S, O5 P V - 15 while (DMA2D->CR & DMA2D_CR_START) {}
1 p2 \* F" [- h# P0 |$ V - 16}</font>
; U' q B, h+ m
) e: d9 U; m7 m* R9 s- <font face="微软雅黑" size="3">1void FillRect(uint16_t x, uint16_t y, uint16_t w, uint16_t h, uint16_t color){/ G# f* d3 M6 p- ~6 R3 v
- # r$ Y2 j6 ?- G: k+ }4 Q& h' k
- 2 void* pDist = &(((uint16_t*)framebuffer)[y*320 + x]);
$ _7 Y2 a% ?. N3 ~+ L; x4 C - + ~; K# ?; f( I7 w& R# F
- 3 DMA2D_Fill(pDist, w, h, 320 - w, LTDC_PIXEL_FORMAT_RGB565, color);) l z/ T& s3 S/ [, f' m; j. L
8 u+ Q; P4 M( ~ O+ D, L- 4}8 k/ j3 t6 f l8 n( _
- 6 E! k4 j& c; x! z3 \$ f
- </font>
最后我们尝试用代码把本小节刚开始的示例图表画出来:
% A5 T( f, K- G+ [" R( M8 D
T, q2 |: L' E
- T+ |: `1 V2 \* @! p1 @$ b8 P- <font face="微软雅黑" size="3">1 // 填充背景色
( G: L5 l8 ^; g+ x* Z' |
: g& x+ B' N3 J: w$ W+ K2 D) n- 2 FillRect(0, 0, 320, 240, 0xFFFF);
5 K# M+ r( n/ m( X& }
k3 z3 d. m$ L- G, V# A1 U" n- 3 // 绘制数据条
/ h* Z8 [5 d8 o3 H# s; b4 _- r - 2 r0 D( `- Q5 g$ L1 Q: s5 Z( f) _
- 4 FillRect(80, 80, 20, 120, 0x001f);
# \; a1 [. ~4 S8 {1 z4 [ - 9 k6 V+ R! {* R- c0 P w) i
- 5 FillRect(120, 100, 20, 100, 0x001f);" L& {1 P$ F) C- U1 V; y% d5 z# S5 L
2 G& Y% w( I( s; Z+ V# Q) S/ Z2 \- 6 FillRect(160, 40, 20, 160, 0x001f);
6 S9 }% R" h( d* O - 7 g* D. f7 }' j* m2 l
- 7 FillRect(200, 60, 20, 140, 0x001f);
/ w- ~4 Y) ^, `% V7 m2 L# [
0 C2 [. l( ~: T- B; A- 8 // 绘制X轴, {. E i& w4 X/ ?9 h3 Z& |# ]1 \2 i% E
- 5 S% ?' }( s8 a ~$ |( d/ `+ P
- 9 FillRect(40, 200, 240, 1, 0x0000);
* O. M5 Z# C6 ^- R) i
5 T. R3 g" e% g( k- </font>
代码运行效果:
% z7 X+ k0 E: G6 i k9 U" r4 A+ q4 z# I
 4 h9 _4 U7 }+ l! Q
, v' c' \, z8 Q# c
7 }1 y# i# C/ d$ q4 y
, `" Q# ?0 O$ U0 P) E9 ~
0 m: Z; P: T1 E3 O2 m1 ~2.图片显示(内存复制)2 H7 k/ |) j! v3 q, I" _- i
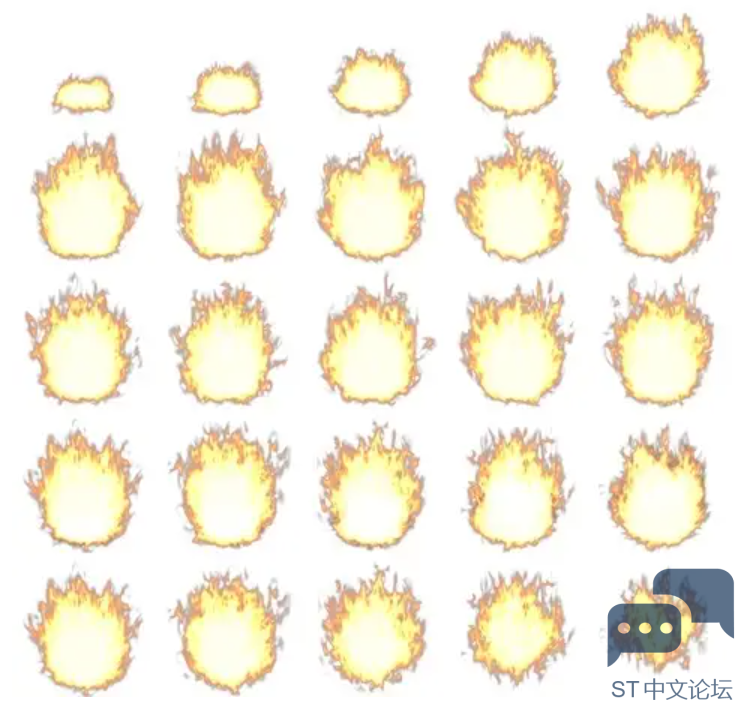
假设我们现在要开发一个游戏,然后想在屏幕上显示一团跳动的火焰。一般是由美工先把火焰的每一帧都画出来,然后放到同一张图片素材里面,如下图所示:# ^4 ~, x0 ?! b; g5 A0 u. s
 2 Q1 R* \) T3 k& A" c* } {# E% F' _
0 v1 U" o; I9 p
$ o: u4 F8 S6 V* t% G: S
然后我们以一定的间隔轮流显示每一帧图像,就可以在屏幕上实现“跳动的火焰”这个效果了。0 t3 s% v2 s. f2 n
# I3 F6 ]) Y9 d# L* b9 F0 u& o- O& w! B0 m7 M' H. O
我们现在略过素材文件加载到内存的过程,假设这张素材图片已经在内存中了。然后我们来考虑如何将其中的一帧图片显示到屏幕上。通常情况下,我们会这样实现:先计算得出每一帧的数据在内存中的地址,然后将这一帧图片的数据复制到framebuffer中相应的位置即可。代码类似于这样:
L) ^8 q+ }- {7 d7 r- <font face="微软雅黑" size="3">1/**
, h% h# x6 `7 i! Y* n - 2 * 将素材中的一帧画面复制到framebuffer中的对应位置
% p. }" s; R4 E+ u - 3 * index为画面在帧序列中的索引
% B7 K3 C f. C; Q - 4 */+ n# K& q6 p3 V. G8 t# I# M; j* D* s* C
- 5static void General_DisplayFrameAt(uint16_t index) {
( B7 @, S+ }& L9 O9 ]- N - 6 // 宏说明+ ?# D3 f E' q. M! Q! U
- 7 // #define FRAME_COUNTS 25 // 帧数量
- V9 N- J! Y+ H7 V' N9 _' P- ]. Y - 8 // #define TILE_WIDTH_PIXEL 96 // 每一帧画面的宽度(等于高度)6 [: x3 k5 o+ O1 l$ G
- 9 // #define TILE_COUNT_ROW 5 // 素材中每一行有多少帧
% j0 ^0 e3 ]6 f1 z/ \" z# o$ q - 10
: x! L q$ Y+ g3 x# b - 11 // 计算帧起始地址; H' M0 Q; y1 ~. y
- 12 uint16_t *pStart = (uint16_t *) img_fireSequenceFrame;: K+ A# P7 N) }3 O1 A- g& f
- 13 pStart += (index / TILE_COUNT_ROW) * (TILE_WIDTH_PIXEL * TILE_WIDTH_PIXEL * TILE_COUNT_ROW);
% K% G/ L! ?' c - 14 pStart += (index % TILE_COUNT_ROW) * TILE_WIDTH_PIXEL;2 V) s9 w/ L/ _# M: i8 A7 K( |
- 152 N0 J# ~9 N6 c- d+ {3 q* ^' H F
- 16 // 计算素材地址偏移, p( e w) T# e, @/ N0 W7 O, q
- 17 uint32_t offlineSrc = (TILE_COUNT_ROW - 1) * TILE_WIDTH_PIXEL;
; u& d/ z2 Q V4 p6 \ - 18 // 计算framebuffer地址偏移(320是屏幕宽度)4 x% k- k5 a4 Y$ t9 @- ~3 J# g
- 19 uint32_t offlineDist = 320 - TILE_WIDTH_PIXEL;, R- Q9 q" K/ M- f* _
- 206 o2 P2 |$ c/ d, c5 t8 Z$ D5 ^
- 21 // 将数据复制到framebuffer
- U6 E: J3 Z6 N' ^9 x - 22 uint16_t* pFb = (uint16_t*) framebuffer;
4 z3 @+ ~4 ]. R8 Q( j# H" d* @ - 23 for (int y = 0; y < TILE_WIDTH_PIXEL; y++) {
( `" k4 ?- o/ {4 @$ K - 24 memcpy(pFb, pStart, TILE_WIDTH_PIXEL * sizeof(uint16_t));+ | \& h7 H. {3 H O8 S) `/ [
- 25 pStart += offlineSrc + TILE_WIDTH_PIXEL;
9 T& J" C3 `- A: |/ L; c) J& N - 26 pFb += offlineDist + TILE_WIDTH_PIXEL;
4 s- v! O& |7 D% a E7 ~ - 27 }4 H2 O1 I! M2 I2 G5 f" d- c' B7 t
- 28}</font>
( K- f4 L7 ? b, q& b' _
9 H1 g" }! t& k9 E7 C R所以,虽然我们实现了目标,但是效率不高(或者说没有达到最高)。
9 T8 e; i+ H! l: C, d! s5 b$ F+ Z
. K4 a/ e4 P1 ]3 n, Z; ]& s7 {" [- B9 v+ x+ {$ O% H7 o; G" x
为了以最快的速度把素材图片中的某一块数据搬运到帧缓冲中,我们来看如何使用DMA2D来实现。
& g, Y; j1 l7 _- v. F; Y0 J
& |$ x6 N2 J2 W7 X7 q! u+ M# R
+ K+ ?% R7 r0 k. b& [首先,因为这次是要在存储器中进行数据复制,所以我们要把DMA2D的工作模式设定为“存储器到存储器模式”,这通过设置DMA2D的CR寄存器的[17:16]位为00来实现,代码如下:) F8 E2 w( W5 R5 V: N0 l/ y
. u) b$ y/ c/ z: m! D. t8 p+ b, g2 W. \2 V! f+ K, L- V
- <font face="微软雅黑" size="3">1DMA2D->CR = 0x00000000UL;</font>
$ o. p% i o! |8 x3 J V& d! S/ s6 o9 S3 U" [7 D
然后我们要分别设置源和目标的内存地址,与第一节中不同,因为数据源也存在内存偏移,所以我们要同时设定源和目标位置的数据偏移# ~+ B1 j: @& W$ F' \
- <font face="微软雅黑" size="3">
9 j- B" g4 }( d# g - 1DMA2D->FGMAR = (uint32_t)pSrc; // 源地址$ j l3 l V) q: t. n4 J/ {/ i
5 R E. O1 u) J- 2DMA2D->OMAR = (uint32_t)pDst; // 目标地址
, k$ n+ P: }; C2 O! G
& R& @, v& h7 c* S- 3DMA2D->FGOR = OffLineSrc; // 源数据偏移(像素)
8 B ^+ o: s* V5 V, H. _ - 7 W3 W1 L) j3 m
- 4DMA2D->OOR = OffLineDst; // 目标地址偏移(像素)
% y2 h, {- L4 x4 L; I! F8 N - </font>
( k, O) \4 N& Y% L然后依然是设置要复制的图像的宽和高,以及颜色格式,这点与第一小节中的相同
K& S) r% {6 B, [/ L* U' `& L( a1 s( t d9 t
& j7 l- F( `) r3 @" |5 P- <font face="微软雅黑" size="3">1DMA2D->FGPFCCR = pixelFormat;
- ]( q7 \& ?' q. s& C ^9 ~( @1 Y
5 o0 B9 k3 \1 y( [8 _, w' n- 2DMA2D->NLR = (uint32_t)(xSize << 16) | (uint16_t)ySize;</font>
同样的方式,我们开启DMA2D的传输,并等待传输完成:
1 [8 J- L# x6 f4 `7 C' }6 u- <font face="微软雅黑" size="3">1/* 启动传输 */
) P+ x1 X6 d" T4 [1 d/ L
* f$ {* d$ ~, T' J- 2DMA2D->CR |= DMA2D_CR_START;
* B6 ^4 j7 @. O1 a/ ?3 H4 a
! J6 i- @7 T6 N; F' ^- 3
$ _! a5 P& y2 N t T
' B R2 |, v, Z& ^$ V, A7 Z1 n- 4/* 等待DMA2D传输完成 */
! {- h" f: s* A" V7 }6 y+ D - ; G% ?8 p/ c6 U% i/ |, w9 `' D2 [
- 5while (DMA2D->CR & DMA2D_CR_START) {} U. a) l1 f6 P/ k
- </font>
最终我们抽出的函数如下:& U q% a1 H2 S+ _6 H! _
$ O; `2 `2 d8 |- ^& z
7 }7 ~% m" J- ?- <font face="微软雅黑" size="3"> 1static void DMA2D_MemCopy(uint32_t pixelFormat, void * pSrc, void * pDst, int xSize, int ySize, int OffLineSrc, int OffLineDst)* q$ i: F6 M8 _1 V
( q z" ^9 f- S: [( h1 f- 2{! v+ k: M! p |& }
- " ^' W4 w3 R" R6 o7 d& t) f. \
- 3 /* DMA2D配置 */4 ?0 T' ]7 l1 w9 S
- * a0 s5 k) Q, N- ^: x
- 4 DMA2D->CR = 0x00000000UL;( l! R+ `6 g8 p( E9 t
- $ S# o& ]% x; L4 n
- 5 DMA2D->FGMAR = (uint32_t)pSrc;) Y/ }# z2 o7 ? z @
- ! g$ k4 @0 V- H/ e* k. T
- 6 DMA2D->OMAR = (uint32_t)pDst;
% E) F8 Z7 I# U) q9 }" Z, y - 6 v& d6 @: i7 O+ G3 C4 P+ a
- 7 DMA2D->FGOR = OffLineSrc;
# l0 ]6 j: |2 k; S - 1 ]9 V! a7 n+ s# d0 G) j" O* T2 ^! M
- 8 DMA2D->OOR = OffLineDst;
4 W6 p0 h9 M- X6 T F. x: a/ }
' y1 p( B1 P" p/ @/ l4 s' {5 J/ x- 9 DMA2D->FGPFCCR = pixelFormat;! T1 l' F/ v f; O
- + @, i% h" r4 Y( V' X6 \8 H
- 10 DMA2D->NLR = (uint32_t)(xSize << 16) | (uint16_t)ySize;# x& P& G! C" Q6 ~$ j4 \/ ]
& @. ~; r( k, {: A- 11
8 ^, c9 k1 e# `& L) ? i: N - ( x5 L( a, W" K+ r2 Z& ~( \: n6 D
- 12 /* 启动传输 *// ~; `& S0 O0 ^$ | x
- 1 x# d ~: R! R, o' x7 ]
- 13 DMA2D->CR |= DMA2D_CR_START;% t% Y$ [9 P" G( U1 `0 {
; l% v6 G$ f, Y$ n% d- 14
: p$ K- F; x' P0 Y
, v) o) p& V* N+ M- 15 /* 等待DMA2D传输完成 */
" G, m1 p$ U; ]; i - 2 O/ O' B( h, S
- 16 while (DMA2D->CR & DMA2D_CR_START) {}
p+ B i+ J3 i- x7 A7 l$ W9 ^
0 U4 c# W O8 n. N7 P' s' C- 17}9 o3 H7 Q# ^: z: _
- R6 a/ q1 _7 G; f
- </font>
% ^& W5 F9 d: K* H% A: q% e为了方便,我们包装一个调用它的函数:
, N& W# ?3 V4 P* f4 a; F# C' K& S$ d" n! D
- <font face="微软雅黑" size="3">1static void DMA2D_DisplayFrameAt(uint16_t index){
- c P2 o# I$ T# G l6 [7 A) W9 @ - 4 O5 @0 _% m9 }1 T2 W
- 2
, W8 T3 @ H/ ~% M - ; n9 ?# ~* t. R- z; z
- 3 uint16_t *pStart = (uint16_t *)img_fireSequenceFrame;
/ G. |$ h- x( L& C+ N6 [& T. N - 6 v4 l% U, X2 N9 w
- 4 pStart += (index / TILE_COUNT_ROW) * (TILE_WIDTH_PIXEL * TILE_WIDTH_PIXEL * TILE_COUNT_ROW);
' F; A# ^% v, c% v7 z
5 a" p5 Q3 D0 ^' a+ Z- 5 pStart += (index % TILE_COUNT_ROW) * TILE_WIDTH_PIXEL;
* t0 `, R5 U* A+ a
. I/ S/ A3 H$ e- 6 uint32_t offlineSrc = (TILE_COUNT_ROW - 1) * TILE_WIDTH_PIXEL;7 L! }6 o ?' u- h$ _
- 8 v4 g8 B' l* `3 V- ?
- 7: K" \2 Y4 p' v3 g: t U- Z/ T
, f8 q4 V8 y1 c- G: O- 80 X M6 Z6 f. U d7 {
4 o s$ Z: {5 \/ K- 9 DMA2D_MemCopy(LTDC_PIXEL_FORMAT_RGB565, (void*) pStart, pDist, TILE_WIDTH_PIXEL, TILE_WIDTH_PIXEL, offlineSrc, offlineDist);
! l8 |/ C; X! c6 |3 S, l' K - 5 I. J7 `$ ?3 e
- 10}</font>
然后轮流播放每一帧图片,这里设置的帧间隔是50毫秒,并且将目标地址定义到了frambuffer的中央:: e. H1 e' _2 w6 O R/ C& l$ Q
. R* n$ }$ z E5 A* i) S! |8 L
0 S6 P. p0 w: n+ `) V1 ^- <font face="微软雅黑" size="3">1while(1){) j6 R$ Y+ |9 r4 L# s
- ; Q8 z$ Y7 @+ s, _. p6 g4 y: C
- 2 for(int i = 0; i < FRAME_COUNTS; i++){3 N& t1 \. x! ?6 y' t
- & p O0 N2 K; v1 ?& U* r
- 3 DMA2D_DisplayFrameAt(i);7 U$ R/ D2 B+ K: N* ?
7 I, w. l1 W; l; y( D0 X. Q6 d# K2 Y- 4 HAL_Delay(FRAME_TIME_INTERVAL);9 s" H, u& q6 D8 _) K2 O
- 5 ~9 J6 y, s0 k- S
- 5 }2 [" T6 J6 i* i% A
- # ]( t3 p& l/ y ~3 S3 q
- 6}</font>
: E- V7 c5 N( y0 S4 M" d2 h0 w2 j6 [6 O& w! b
最终运行的效果:; B+ \# o& z1 p' y! t
 " r3 I! q+ h4 y' I8 G" b |
* [5 _( a3 [. n ~( u$ l' z# x
/ c( d( }) A. g4 g
5 B5 m. t6 r e6 K
+ g6 j% X; x- Y- [+ v! S8 m5 ~3.图片渐变切换
/ `7 T6 q$ f2 t! I/ ?0 p6 L8 @假设我们要开发一个看图应用,在两张图片进行切换时,直接进行切换会显得比较生硬,所以我们要加入切换时的动态效果,而渐变切换(淡入淡出)是一个很经常使用的,而且看起来还不错的效果。
' B# D( X. i r0 F$ d* {* M7 Q! W* Q& }& }% S
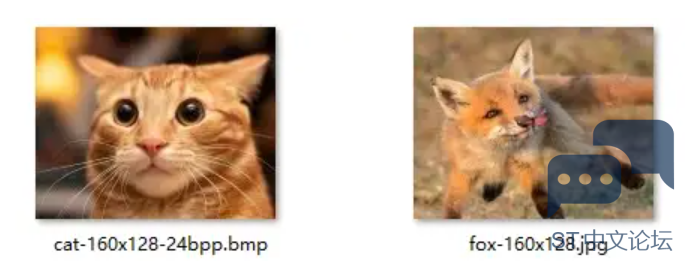
$ O' h4 `8 o2 p# Q9 ]就用这两张图片好了:. a8 E2 m8 E1 |2 e
0 c& k. A( Y, j! o
" E. I5 q+ X" x
 ( b+ H7 W) ]: ]; S/ a( x
; ^9 c- u$ `0 I" I( J
6 n; y: W& R$ S* i2 E6 a这里我们需要先了解一下透明度混合(Alpha Blend)的基本概念。首先透明度混合需要有一个前景,一个背景。而混合的结果就相当于透过前景看背景时的效果。如果前景完全不透明,那么就完全看不到背景,反之如果前景完全透明,那么就只能看到背景。而如果前景是半透明的,则结果就是两者根据前景色的透明度按照一定的规则进行混合。
4 h# g4 a1 m/ I+ [2 ?) O/ \9 g% m
& R8 L& A. Y( N1 Q+ J如果1表示完全透明,0表示不透明,则透明度的混合公式如下,其中A是背景色,B是前景色:
! F( d+ }+ C T- <font face="微软雅黑" size="3">1X(C)=(1-alpha)*X(B) + alpha*X(A)</font>
* B' c2 d7 g- r
$ o- ?8 R) r/ Y w _5 Z因为颜色有RGB三个通道,所以我们需要对三通道都进行计算,计算完成后在进行组合:
7 V7 w# B3 ~' a5 ^. r- X
0 B% \, @+ q8 F3 g8 \! d6 x: V/ M0 ~0 A' Q/ ^8 Y2 _
- <font face="微软雅黑" size="3">1R(C)=(1-alpha)*R(B) + alpha*R(A)7 J6 V# n% |. Q' r
- & C* e5 c/ ^% R1 A
- 2G(C)=(1-alpha)*G(B) + alpha*G(A)
' K9 ]/ H8 @9 U- P* n/ [( X - ) v$ y* R! V9 D- ~
- 3B(C)=(1-alpha)*B(B) + alpha*B(A)</font>
; F# L5 ]( ^, ]9 l& p) F5 u7 k$ @! T# e6 }3 K# E4 x
而在程序中为了效率起见(CPU对于浮点的运算速度很慢),我们并不用0~1这个范围的值。通常情况下我们一般会使用一个8bit的数值来表示透明度,范围从0~255。需要注意的是,这个数值越大表示越不透明,也就是说255是完全不透明,而0表示完全透明(所以也叫不透明度),然后我们可以得到最终的公式:& b5 o" B7 Q5 C! Y% a
% i' X" o+ u. e
0 ~! X- Z. h4 P U0 o% ~) r, V- <font face="微软雅黑" size="3">1outColor = ((int) (fgColor * alpha) + (int) (bgColor) * (256 - alpha)) >> 8;</font>
7 m8 l, e2 Q/ C2 V0 Y
实现RGB565颜色格式像素的透明度混合代码:
9 h: \9 `; Q' L1 M4 {' ~' ~+ |% Z4 P" t: W) i7 m5 c
7 L1 I( P+ ?; l6 C6 {
6 m: `) G2 h5 t! U! _( h0 z: K W- <font face="微软雅黑" size="3">1typedef struct{6 n- t5 F! b) q& h9 a
- : w) d+ ^' G% c8 H' {4 ^. l
- 2 uint16_t r:5;0 \: P0 V6 G6 o3 |
6 K/ \) \. x- Z* v- 3 uint16_t g:6;, t& f, A5 f% o) d* b6 U5 l
- % q1 L- Q+ c Z" N9 P4 w
- 4 uint16_t b:5;
, Y8 o% k$ \. N4 F# N; U1 I - * \1 ] {5 c) L
- 5}RGB565Struct;
/ v; i8 m+ @- Z - . J' L$ s# b. _$ I- J
- 6- t7 G9 }! ~3 V. w& l8 V# P3 k% m5 [
/ B4 t& u: o. k/ e% F- ~- 7static inline uint16_t AlphaBlend_RGB565_8BPP(uint16_t fg, uint16_t bg, uint8_t alpha) {6 q$ j) a& o/ X' J
- 1 Z. B% n* a% X! L, n% W4 c
- 8 RGB565Struct *fgColor = (RGB565Struct*) (&fg);7 b7 K% \7 \# y: A" ^
4 Q2 t {5 }) `+ e+ G0 `6 G, e- 9 RGB565Struct *bgColor = (RGB565Struct*) (&bg);/ J% U$ _- ], v* |5 N3 v' |
% F$ J) m$ C* |0 q) q9 m3 Y- 10 RGB565Struct outColor;
& l( Z% t2 P- K- U
2 R: a7 ~5 C9 `8 F' o5 n- 11
- u* b- o. e! F/ k, k
8 A9 B/ _/ G$ s; E! ^, o( M' w- 12 outColor.r = ((int) (fgColor->r * alpha) + (int) (bgColor->r) * (256 - alpha)) >> 8;
8 e* \3 M; G; r2 l: a1 b - ; j* m4 f/ F8 e" [9 j# W& D
- 13 outColor.g = ((int) (fgColor->g * alpha) + (int) (bgColor->g) * (256 - alpha)) >> 8;
8 }- {4 O& ]* D( v0 n) N6 D - " x% d; `, P* R( M! ? S4 b0 X
- 14 outColor.b = ((int) (fgColor->b * alpha) + (int) (bgColor->b) * (256 - alpha)) >> 8;
# `& W7 x, x2 N' m* R% ?- _- X
7 `3 n8 o6 q& u# U- 15
: _" r6 q: k0 G
6 o' e; W8 T( a( Y) U6 Q. {) D- 16
8 {& [* L6 h# q- \
; h" @ o/ r: O9 |- 17 return *((uint16_t*)&outColor);
! i' y* U- p6 Q - & ^. u( P( C. P3 n [5 G
- 18}</font>
' _2 `$ {9 C: _( I7 L
了解了透明度混合的概念,也实现了单个像素的透明度混合后,我们来看如何实现图片的渐变切换。
, L Y( x. o- `, A, ?$ x( ~. A3 m$ y
5 {. L) J* M/ v, ?
) E& m% F6 b: v; T+ Q假设整个渐变在30帧内完成,我们需要在内存中开辟一块儿大小等于图片的缓冲区。然后我们以第一张图片(当前显示的图片)为背景,第二张图片(接下来显示的图片)为前景,然后为前景设置一个透明度,对每个像素进行透明度混合,并且将混合结果暂存至缓冲区中。待混合结束后,将缓冲区中的数据复制到framebuffer中即完成了一帧的显示。接下来继续进行第二帧、第三帧……逐渐增大前景的不透明度,直到前景色的变为不透明,即完成了图片的渐变切换。7 {+ T; l; y r& @# K
7 A1 k+ G! L2 T+ x' X7 ^, m
3 M' \) V+ H9 F( F因为每一帧都需要对两张图片中的每一个像素都进行混合运算,这带了来巨大的运算量。交给CPU实现是很不明智的行为,所以我们还是把这些工作交给DMA2D来实现吧。
( [6 _* G- ^* P; Q
- {8 N( {" N6 Q& y9 I* W
; ]8 E: P0 V5 Z! @这次用到了DMA2D的混合功能,所以我们要使能DAM2D的带颜色混合的存储器到存储器模式,对应CR寄存器[17:16]位的值为10,即:1 ~* ~1 O* |- E% T
# N; ?9 |8 R% w! A+ | c% M: H2 \% k) ^( J& Q" Z
- <font face="微软雅黑" size="3">1DMA2D->CR = 0x00020000UL; // 设置工作模式为存储器到存储器并带颜色混合
* @( U2 j( t y - </font>
0 G2 O9 Y5 Z/ A2 \: O. ]1 v/ x. g然后分别设置前景、背景和输出数据的内存地址和数据传输偏移、传输图像的宽和高:
4 B/ j: N, _# ^4 J0 H; A, \. I. f) n' l1 a
# G ~9 f1 G7 ?. Z3 n7 ?
- <font face="微软雅黑" size="3">1DMA2D->FGMAR = (uint32_t)pFg; // 设置前景数据内存地址. E& i! R) x9 i; V; T, c! H- y: }
- + j9 o! `6 j( h" L( Z
- 2DMA2D->BGMAR = (uint32_t)pBg; // 设置背景数据内存地址* ]; ]4 Z. V3 l8 H) j
- : A' ~4 E3 x; x8 K2 z
- 3DMA2D->OMAR = (uint32_t)pDst; // 设置数据输出内存地址
2 ]* T5 S* A! k2 w3 B) i - 9 u; w2 `3 P3 S& _" i
- 4
, A- M. G0 D& g' m8 h! ~* ?$ i
. L7 z2 w8 k. p# }: f- 5DMA2D->FGOR = offlineFg; // 设置前景数据传输偏移
/ I9 T+ N. e3 z8 G& h1 o6 S. ` - ) u' {) R/ {0 W- I
- 6DMA2D->BGOR = offlineBg; // 设置背景数据传输偏移
$ F( S: I# f9 q - / G5 O C% L5 S3 s8 z
- 7DMA2D->OOR = offlineDist; // 设置数据输出传输偏移, X" L; [1 u. O
- 6 K) z4 P. S; g: G' b' B9 K c
- 84 r6 N* P; f/ Z+ p$ {9 w: D$ [8 v
9 o" I/ R6 e# i9 i- 9DMA2D->NLR = (uint32_t)(xSize << 16) | (uint16_t)ySize; // 设置图像数据宽高(像素)</font>
; U! g# E; t4 J7 H6 H设置颜色格式。这里设置前景色的颜色格式时需要注意,因为如果使用的是ARGB这样的颜色格式,那么我们进行透明度混合时,颜色数据中本身的alpha通道就会对混合结果产生影响,所以我们这里要设定在进行混合操作时,忽略前景色自身的alpha通道。并强制设定混合时的透明度。2 ]+ W# ?* Q' @$ t' x+ r: S/ X
- x1 @1 ^8 H* Z
, W' I8 x, R* p
输出颜色格式和背景颜色格式
# Y& a: @" F! K9 E/ N, z5 o5 r- <font face="微软雅黑" size="3">1DMA2D->FGPFCCR = pixelFormat // 设置前景色颜色格式% q1 r5 e4 Q$ ^8 d
- 2 z t' r! v- i5 V
- 2 | (1UL << 16) // 忽略前景颜色数据中的Alpha通道6 Z% @( N8 k0 G2 C4 C6 Q' w+ j
- 7 E+ Y' Y* Y5 a- ]0 G D
- 3 | ((uint32_t)opa << 24); // 设置前景色不透明度
7 K) s8 |; J/ c - / K) f A `; T$ `$ F( y+ q
- 4+ S, e# L$ u) y+ ?
- # D' S1 D( l# i
- 5DMA2D->BGPFCCR = pixelFormat; // 设置背景颜色格式; W1 J1 e0 _4 w5 K3 L5 {0 N3 B
7 I H' [% Y% f( V# Z- 6DMA2D->OPFCCR = pixelFormat; // 设置输出颜色格式</font>
) s1 W% [" U* m% ?) Q" O2 J
4 N% {3 D! b4 K. _+ j/ N! C0 O3 Mtips1:这个模式下,我们不仅可以进行颜色混合,还可以同时转换颜色格式,可以根据需要设置前景和背景以及输出的颜色格式
* z* Y- k' a+ g7 ~
4 x6 Z. U1 n' @5 S3 J% f' |: s# J+ E3 ~! h2 L
最后,启动传输即可:
5 f/ u- f p5 W7 E- <font face="微软雅黑" size="3">1/* 启动传输 */! D$ D3 G/ X; s+ ^
- 2DMA2D->CR |= DMA2D_CR_START;6 z$ _8 O: J# v" e9 _
- 3
( z$ X1 P* ^& G! s - 4/* 等待DMA2D传输完成 */
5 |" H% |# P0 i/ q" A. z - 5while (DMA2D->CR & DMA2D_CR_START) {}</font>
! [; F$ D# w' R7 P! S2 v- <font face="微软雅黑" size="3">1void _DMA2D_MixColors(void* pFg, void* pBg, void* pDst,
2 K& Z7 w8 W6 d" O- }7 k - 2 uint32_t offlineFg, uint32_t offlineBg, uint32_t offlineDist,
* [3 u4 z0 u8 y4 i1 C6 B4 ~ - 3 uint16_t xSize, uint16_t ySize,) T! C2 {7 {9 B0 b7 a' D
- 4 uint32_t pixelFormat, uint8_t opa) {
) D3 }7 C% z! N& X8 |2 k0 n - 5. p( ^0 V# w* w6 U0 v& b- x
- 6 DMA2D->CR = 0x00020000UL; // 设置工作模式为存储器到存储器并带颜色混合
f7 I/ ^, W6 U% E - 7
% q/ g6 M% ?: b7 h" F2 q - 8 DMA2D->FGMAR = (uint32_t)pFg; // 设置前景数据内存地址
: P+ Z# y' S% c: x) X8 { }6 a4 t! Q - 9 DMA2D->BGMAR = (uint32_t)pBg; // 设置背景数据内存地址
: j/ R, n& N9 K' \' I - 10 DMA2D->OMAR = (uint32_t)pDst; // 设置数据输出内存地址8 \2 ^! i& K6 e
- 11$ \. }, u6 C" d/ u/ _4 C" @+ g
- 12 DMA2D->FGOR = offlineFg; // 设置前景数据传输偏移- o* A6 U& X7 ^, P5 |( F9 D; y
- 13 DMA2D->BGOR = offlineBg; // 设置背景数据传输偏移
5 u$ C7 {+ ?0 t. l6 [ - 14 DMA2D->OOR = offlineDist; // 设置数据输出传输偏移
9 D& \' s+ j0 @5 D' h' S" [ - 15
% {1 |# z, t$ ^2 Y& G3 } - 16 DMA2D->NLR = (uint32_t)(xSize << 16) | (uint16_t)ySize; // 设置图像数据宽高(像素)
& I7 h# ]1 v4 |0 L" k - 17
6 |: \( E. s( I# z$ q6 h8 t - 18 DMA2D->FGPFCCR = pixelFormat // 设置前景色颜色格式! S* ~+ S" u/ W5 G
- 19 | (1UL << 16) // 忽略前景颜色数据中的Alpha通道6 v6 t% H3 s5 ]& W/ z5 c
- 20 | ((uint32_t)opa << 24); // 设置前景色不透明度
+ E$ B, T8 _' P) P0 L* z4 t9 u - 21
; C; x. C2 }2 p - 22 DMA2D->BGPFCCR = pixelFormat; // 设置背景颜色格式) y& t9 B3 l; ~$ z* ?0 j: e
- 23 DMA2D->OPFCCR = pixelFormat; // 设置输出颜色格式
0 w) z5 Z2 S# v& U. z. g# f - 24
% r& x7 f! @2 x+ |2 C! | - 25 /* 启动传输 */: Q3 Q6 ?; j0 r/ b. o
- 26 DMA2D->CR |= DMA2D_CR_START;
, G# e. Y# T; P- Z9 ? - 27
: | u: ~! E* Z$ V+ T u# K - 28 /* 等待DMA2D传输完成 */% X |7 c3 m4 T/ r7 l0 z
- 29 while (DMA2D->CR & DMA2D_CR_START) {}
: ^5 o; N5 W a - 30}</font>
- <font face="微软雅黑" size="3">1void DMA2D_AlphaBlendDemo(){7 o' r; u' Z) k5 j. k6 z% p. c
- 2
4 ^; L1 ]: D+ |# P - 3 const uint16_t lcdXSize = 320, lcdYSize = 240;' o$ ^4 L, V' ^% h% F
- 4 const uint8_t cnvFrames = 60; // 60帧完成切换
2 c( R- u! V8 d# L/ m# r2 O0 ] - 5 const uint32_t interval = 33; // 每秒30帧" v u1 t3 M8 y0 l
- 6 uint32_t time = 0;& P6 \5 U( K$ ]% E3 k1 q
- 7" |5 W: L* u& R1 {2 F9 N4 T
- 8 // 计算输出位置的内存地址) | ?) J1 D* F* {4 G+ _9 t
- 9 uint16_t distX = (lcdXSize - DEMO_IMG_WIDTH) / 2;% w1 [$ t. A% c4 }! Q
- 10 uint16_t distY = (lcdYSize - DEMO_IMG_HEIGHT) / 2;
2 K8 W( j7 O: [/ U0 o, ^6 Z+ @ - 11 uint16_t* pFb = (uint16_t*) framebuffer;6 c- E/ Z4 g. P8 E9 X: P
- 12 uint16_t* pDist = pFb + distX + distY * lcdYSize;% [' C4 F. X5 r5 u( A! p; g
- 13 uint16_t offlineDist = lcdXSize - DEMO_IMG_WIDTH; B1 J" ~7 [2 i6 q y9 F; U
- 14
- d, m2 F; B2 {+ }# Q) T5 E - 15 uint8_t nextImg = 1;/ _, F8 W: w) T
- 16 uint16_t opa = 0; m9 O/ d. `8 k" j% ?
- 17 void* pFg = 0;/ L) q2 V# h" r( p. O7 P
- 18 void* pBg = 0;! d5 N) B4 {7 y
- 19 while(1){ y( N3 m q/ g' j
- 20 // 切换前景/背景图片& p. I3 |6 U" `- x* ?( B
- 21 if(nextImg){
8 D3 X- |3 k' z' `! m. Y - 22 pFg = (void*)img_cat;3 Z7 X: x. g( ^$ V4 i. w E
- 23 pBg = (void*)img_fox;
% q1 L/ t* e$ y$ t* N: J - 24 }1 n1 k/ M% A" [, u7 M( l
- 25 else{
+ Q- ^# x7 ~, g: ~0 [; F - 26 pFg = (void*)img_fox;
8 m6 _# W/ d. b5 J5 Y n - 27 pBg = (void*)img_cat;
' c) g+ j# |4 C/ T' ~- `! ` - 28 }& v0 |! f" ?6 j7 i- Y+ C) A5 S6 ]
- 297 r# e m7 G5 g% e* s8 W
- 30 // 完成切换
; L/ W" Z. J, ~. l. J1 y - 31 for(int i = 0; i < cnvFrames; i++){, z: P( b! f7 s4 y# a: d
- 32 time = HAL_GetTick(); Y" w- A( c' k% q# v* g8 ?4 _% W. @
- 33 opa = 255 * i / (cnvFrames-1);8 G9 Y9 f; S* i, p" ]9 Z# O
- 34 _DMA2D_MixColors(pFg, pBg, pDist,& U* j& ~6 E8 R0 f+ M) i& H
- 35 0,0,offlineDist, w8 s6 h/ K! t
- 36 DEMO_IMG_WIDTH, DEMO_IMG_HEIGHT, u7 e$ M$ h# M" g% ]
- 37 LTDC_PIXEL_FORMAT_RGB565, opa);* f+ z* \& x/ E+ |
- 38 time = HAL_GetTick() - time;
% s( B1 c& }. M& U* f1 G - 39 if(time < interval){% G( V9 a$ l; }+ L# @
- 40 HAL_Delay(interval - time);/ N8 ~# \0 L" z C# m; k( V
- 41 }- t ~; H- m, X2 z) n
- 42 }$ \! C) S' c% L6 H
- 43 nextImg = !nextImg;
e9 H) m2 k2 l6 k6 S* S/ [3 p - 44 HAL_Delay(5000);; q, G- K$ M) q6 A0 r
- 45 }
* ~& X3 P# [. \ - 46}</font>
 9 g) _$ K& f3 O4 Z! l! s0 t5 g
6 V$ f4 t8 J/ m2 ]' f! [
7 x( C( T) F9 \0 D/ O; y) \% Z性能对比 I8 ?9 u5 ^% Z2 ?
前面介绍了三种嵌入式图形开发种的实例,并对分别介绍了通过传统和DMA2D实现的方法。这时候肯定有朋友会问,DMA2D实现,比起传统方法实现,到底能快多少呢?我们来实际测试一下。
q5 [1 i. v5 w8 x0 {! ]: D2 I% y4 h" ^7 F4 Z% S! g, j
6 m3 L/ Q6 y6 t. t. i共同的测试条件如下:
! t! N" }- S! c) A) I( y* j2 H7 ?; W% U) E9 Z3 J" r
5 p8 i/ X! v7 r+ \' y# r kframebuffer放置在SDRAM中,320x240,RGB565% R, k1 G9 ~' J0 a6 }7 U
: ^( O |2 h4 c) _6 S' C
/ Y7 g& Y0 G) m& B' C% XSDRAM工作频率100MHz,CL2,16位带宽。. Q: {' D4 _4 x6 j8 n& w
' @! s4 y! n( y) q2 p4 o* H8 B7 G2 o! |
MCU为STM32H750XB,主频400MHz,开启I-Cache和D-Cache
3 U, I( l: k0 q9 R* S( H; P) v4 V% D# `, u% `
c- d7 X4 r7 W# ]9 I
代码和资源在内部Flash上,64位AXI总线,速度为200MHz。
% o9 {" C! J/ _
4 A* ] |4 j+ E6 ?2 l3 B$ G4 E9 b/ c" ]3 d+ M
GCC编译器(版本:arm-atollic-eabi-gcc-6.3.1)- C5 u8 m s3 o! k/ X0 d) y
/ C( ], ?7 ? e$ M0 ]
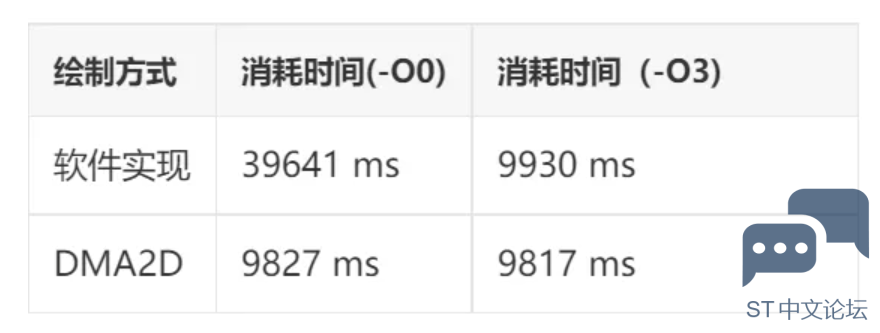
6 \, V8 u3 }" w! z. P, k测试项目:矩形填充: ^8 }% W- v4 K1 T
4 h; U/ B0 Z0 O1 \( T, B1 m+ }% j* k; {5 r- d( l5 B; a3 m
绘制上一章第1节中的图表,绘制10000次,统计结果0 e% |8 E1 {* p8 K ~& D" H
/ C& t) G& ? k3 k
! i# x- ~4 |% |, z5 O) d* J测试结果:' S& ?' ?# s1 y7 e4 i a( C+ g$ k
 3 M1 Z4 }8 W' y W: |/ z" r" I
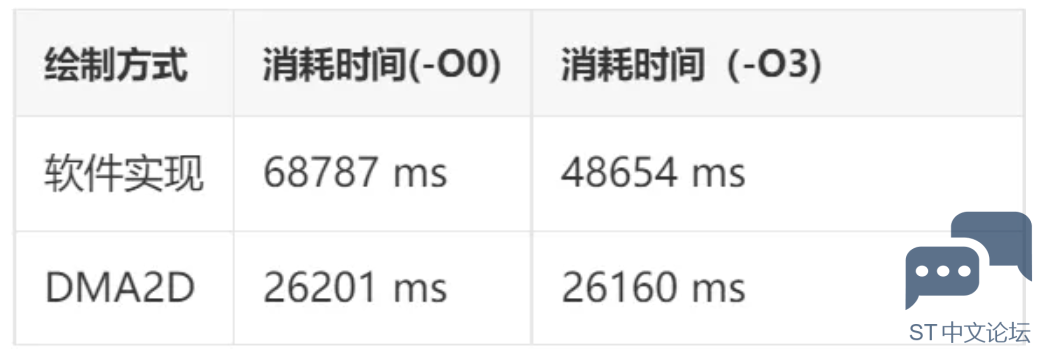
测试项目:内存复制8 _$ X: d7 y' ^$ {0 c
绘制上一章第2节中的序列帧10000帧,统计结果; _ b7 z# ?2 y! u
8 Z' J7 e$ Z0 \. v Q$ u
- O& Z2 Y4 K; W3 J) ~9 c+ G- k
测试结果:. b! t: s3 B$ |/ t4 H! x
) c$ F8 E( y8 p- T; S6 u
$ l }) _4 U; A, t5 V8 l7 ^
- B ~2 ~6 C" O- @: x* a( O6 ]) f
1 _; O- C& P8 y/ M9 B
. J0 q% \, d" a# T2 R9 x3 ^1 k测试项目:透明度混合
1 Q! c8 E/ i0 E5 }1 e! L4 [! R渐变切换上一章第3小节中的两张图片100次,每次30帧完成,共计3000帧4 L" @6 A5 l" u. d9 M
, @+ N. |* b$ Y$ |7 [! c
- q2 u, ]' t# G
混合结果直接输出到framebuffer,不再通过缓冲区缓冲- ?; s& _& ?- q3 D# @* W. A
) l- T! H3 N: [
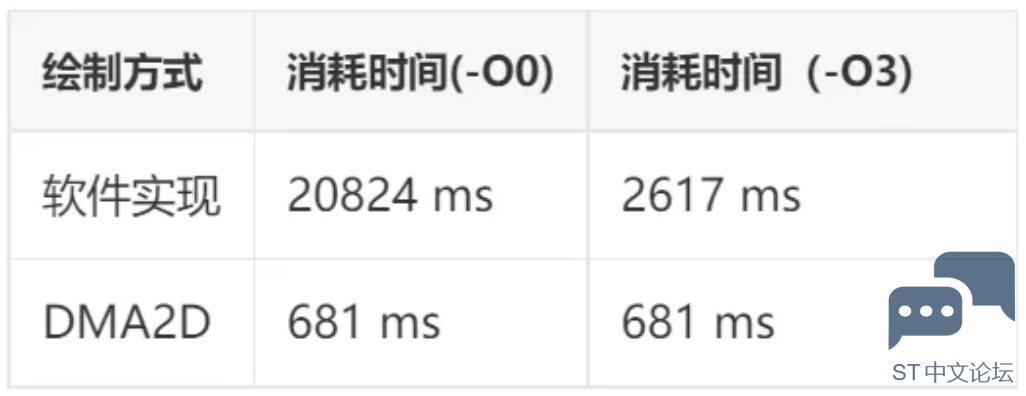
9 c3 n3 l8 o$ \% L% M' J- ^4 m测试结果:
$ v' s* o! e' q( l- R0 ~6 Z" E
m. E2 R' [: Q% Y( l$ ?9 b; p6 Z2 K/ Y. U$ m
7 r1 w/ I1 L0 {# a/ |: M) k9 |' q' A
- B7 v3 y/ \! f+ j x; j
4 j+ @3 D; ~) b3 }$ Y" J; B8 [: \* `* `4 L7 w6 j$ ~
性能测试总结
1 J4 [" U: ]: o由上面的测试结果可以看出,DAM2D至少有2个优势:
0 e$ v" T% D) o# g1 N# y3 I; D: d1 e, f, k# P! L
6 m9 q1 P, S* x* O- E. _, g一是速度更快:在部分项目中,DMA2D实现的速度相比纯软件实现最高可以达到30倍的差距!这还是在主频高达400MHz还带L1-Cache的STM32H750平台上测试的结果,如果是在无cache且主频较低的STM32F4平台上进行测试,差距会进一步拉大。
7 `3 v9 g1 m, y- j- N U. {2 ^8 D
# [0 d( ], y6 N' C! X
$ V/ V6 m1 i2 P2 c- C二是性能更加稳定:由测试结果可以看出,DMA2D实现的方式受编译器优化等级的影响非常小,几乎可以忽略不计,这意味着,无论你使用IAR,GCC或是MDK,使用DMA2D都可以达到相同的性能表现。不会出现同一段代码移植后性能相差很大的情况。& H9 v" e0 X- K5 E* z4 K: U
9 ~# |; L; x* N( C3 ?/ k/ F. d3 _* m
: b) b# _' C( V0 X除这两个直观的结果外,其实还有第三点优势,那就是代码编写更加简单。DMA2D的寄存器不多,而且比较直观。在某些场合,使用起来要比软件实现方便的多。' @! i, ]4 q3 W0 I; l! ^; Y& n
1 \( m9 C2 r: c i9 [+ U) Z6 {" r! ~; e- o# D7 Z- [" ^$ u( d
结语 R9 G. D, Q* O# `& H1 T) Y2 L
本文中的三个实例,都是我本人在嵌入式图形开发中经常遇到的情况。实际上,DMA2D的用法还有很多,有兴趣的话可以参考《STM32H743中文编程手册》中的相关内容,相信有了本文的基础,在阅读里面的内容时一定会事半功倍。5 J$ B6 X9 @% f- q3 {- F" [/ f
' ^7 a& o$ ]7 z; {% @ n
: d- t/ B4 F( x) V4 d4 l
, V/ T3 y# y1 Z3 u/ l1 a4 D受限于作者的技术,文章中的内容无法做到100%的正确,如果存在错误,请大家指出,谢谢。
5 g6 L5 c* J0 `
& j5 O) k& `; w& G5 A6 Z
/ ] O7 o6 J0 B( U, A) b
, \5 ?1 W# p/ G2 y- j7 @
5 B, V8 R! ]( p1 I1 l' u3 Z" Y- R9 H0 y' Z- z5 @! a
! i2 i& ]# d/ Y, H0 O6 }" F/ J
|





 STMCU小助手
发布时间:2021-7-7 11:12
 微信公众号
 手机版


