STMCU小助手
发布时间:2021-7-8 10:18
|
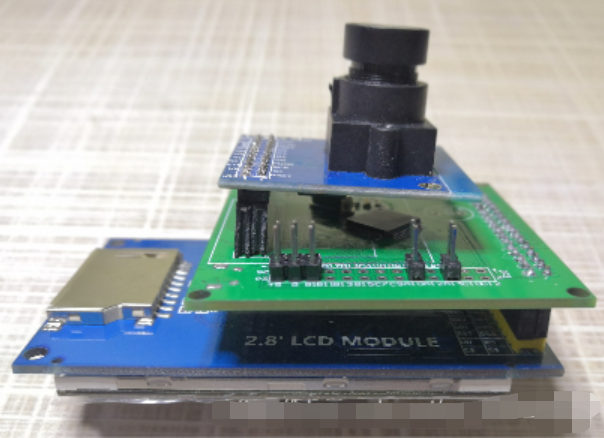
系统介绍 使用STM32F103RCT6作为主控,摄像头使用OV7670(带FIFO)。STM32进行了16倍频。识别过程分别为:图像采集,二值化,识别车牌区域,字符分割,字符匹配。 + e5 e$ l7 z3 ` $ C# v% ~. }, u2 `+ l 识别过程分析8 O$ j+ Z0 D4 r 1.图像采集:' `: I, Q8 K& W4 S2 ` 通过OV7670摄像头进行图像采集,采集的图像大小为320*240像素,像素格式为RGB565。每个像素由两字节组成,第一字节的高五位是Red,第一字节的低三位和第二字节的高三位组成Green,第二字节的低五位是Blue。 + i* |+ d C+ V% t$ h 2.二值化: 二值化就是让图像的像素点矩阵中的每个像素点的灰度值为0(黑色)或者255(白色),让整个图片呈现出只有黑色和白色的效果。二值化后的图像中灰度值范围是0或者255。 怎样让像素点的灰度值转为0或者255?假如灰度值为220的一个像素点,二值化后应该为0还是255?这时候需要设定一个阈值来对像素点进行设置。 常用二值化方法: 1、取中值: @8 g2 _' C% ~+ k/ \0 r. ? 设置阈值为127,灰度值小于127的为0,大于127的为255。这样设置计算量小,计算快。缺点也严重:在不同的图像中,颜色分布差别大,处理效果也不会很好。 程序开始之前设置R,G,B的阈值,通过阈值判断将像素设置为全黑(0x0000)或者全白(0xFFFF).同时根据色彩的变化记录每一行的颜色跳变点,由此识别出车牌区域。. H: f' m; N* T# D 2、取平均值 像素点平均值 = (像素点1灰度值 + 像素点2灰度值 + …… + 像素点n灰度值) / n! T( C; Y: b6 ? 3、双峰法% ?+ R& J! P6 a6 c0 |) L$ y) c6 P 此方法适用于具有明显双峰直方图的图像,不适合直方图中双峰差别很大或双峰间的谷比较宽广而平坦的图像。该方法认为图像由前景和背景组成,在灰度直方图上,前景和背景会形成高峰,在双峰之间的最低谷处就是阈值。! ]( v$ r: B7 x* e! V / e7 S6 k+ T' r% E- q1 {$ B; | 3.识别车牌区域: 根据上一步的二值化,由于车牌区域跳变点多,由此可以得出车牌区域。分别记录车牌区域的上下高度。然后通过RGB-HSV颜色转换,识别出车牌区域的左右边界。 4.字符分割: 我国常见车牌以及排列顺序大部分都是按照如下设计的:汉字、英文字母、点、英文字母、阿拉伯数字、阿拉伯数字、阿拉伯数字、阿拉伯数字。基于这个规律,以及图像采集高度一致,设计了如下的分割方法:9 M9 O) A& P g; N 1、在内存中开辟七个长为车牌长的七分之一和宽为车牌宽的区域 2、从车牌图像长边的巾问向下开始扫描车牌图像,并把扫描到的所有的点灰度值复制到0区域的第四个区域对应位置上。然后再从上向下扫描刚扫描过这一努的左边或右边,直到所扫描的这一峰上的所有点的灰度都是0时为止,并把这一竖认为是字符的分离处。" F# n0 q: i4 s& q3 q) d 3、切割第五到第七个字符。方法就是,切割完了第四个字符之后,再依次扫描剩下的空间,直到所扫描的这一竖上的所有点的灰度值不全为0时,认为是字符的开始并依次扫描直到所扫描的这一竖上的所有点的灰度值全为0时认为是字符的结束。 4、切割第三到第四个字符。这两个字符的切割方式与第五到第七个字符一样。 5、切割第一到第二个字符。当第三个字符切割完之后,我们将遇到一个点,我们也把它看作一个字符,只不过这个点扫描之后就不要了。扫描完这个点之后,我们来切割第二个字符,它的切割方式与前面一样。切割完了第二个字符之后,再向左扫描,直到所扫描的这一竖上的所有点的灰度值不全为0时,认为是字符的开始,并依次扫描直到所扫描所有剩下的,并填到相应的位置,直到剩下的空间填满。经过粗分割后,可以得到一些单个字符区域和多余的空间。下一步我们将把这些多余的空间去掉。这将更有利于下一步字符的识别。- U9 v: T5 z F. I; a$ ?( m 去除图像上多余空间: 车牌上的字符经过了粗切割所得到的是一些单的字符,但在分配空间时是按照车牌的宽和长的七分之一来分配的;所以这个空间可能大于字符应该占的空问。所以,要将多余空间去除。对于第一个字符从第一行开始向下扫描,把那些一行中所有的点的灰度值全为0的点去掉,直到扫描到有一行不全为0时为止。然后再从第一列开始向右扫描把那些一列中所有的点的灰度值全为0的点去掉,直到扫描到有一列不全为0时为止。接下来从最后一行开始向上扫描,把那些一行中所有的点的灰度值全为0的点去掉,直到扫描到有一行不全为0时为止。最后从最后一列开始向左扫描把那些一列中所有的点的灰度值全为0的点去掉,直到扫描到有一列不全为0时为止。重复上面的步骤完成剩下字符的切割# }1 K( W/ @/ U( D9 A2 m0 w 根据二值化的结果,以及记录的跳变点位置,对字符进行分割,同时记录字符的左右边界。 & M d1 b) b- T6 U 5.字符匹配: 对分割出来的字符进行归一化处理,这里用到图片的扩大算法,扩大之后逐一的去进行字符匹配。字符模板事前通过字模软件转换成二进制数据保存在数组中。最后根据匹配结果相似度最大的做为输出结果。! \/ ]* j2 E7 t( \; f+ M 归一化图像就是要把原来各不相同的字符统一到同一尺寸。因为扫描进来的图像中字符大小存在较大的差异,而相对来说,统一尺寸的字符识别的标准性更强,准确率自然也更高。具体算法如下:先得到原来字符的高度和宽度,与系统已存字模的数据作比较,得出要变换的系数,然后根据得到的系数按照插值的方法映射到原图像中。3 J. l; {4 z1 N4 }: A a$ v+ o' C8 ]3 }3 r 实物图 
|
 微信公众号
 手机版