




时间、空间复杂度比较
算法思路: 对于任意一个序列,从一端开始,顺序扫描,依次将扫描到的结点关键字与给定值k相比较,若相等则表示查找成功;若扫描结束仍没有找到关键字等于k的结点,表示查找失败。 代码: #include <stdio.h>#include <stdlib.h># q+ p$ s" S6 X0 {0 k! p #define keyType int //2020.05.24' M) |$ ~) b* P% F4 x5 [ typedef struct/ y+ U- ]( Q3 @4 \5 o {8 d7 w* {2 ~# C; ] keyType key;//查找表中每个数据元素的值4 W# ]. e0 I+ O4 }; F( i }ElemType; typedef struct" z: z6 n5 D7 _, \ { ElemType *elem;//存放查找表中数据元素的数组 int length;//记录查找表中数据的总数量 }SSTable;5 }$ o$ W" P7 m, p3 g: w& l Z. D( {. R- ~& [/ [ //创建查询数据/ B3 G8 P3 v$ k9 @) M void Create(SSTable **st,int length) { (*st)=(SSTable*)malloc(sizeof(SSTable));3 O. M3 h8 d' k$ `+ U (*st)->length=length; (*st)->elem =(ElemType*)malloc((length+1)*sizeof(ElemType));! h Y4 I* @) L% u" w3 Q+ B printf("输入表中的数据元素:\n");/ n1 ]. ^! j" N# Q4 u //根据查找表中数据元素的总长度,在存储时,从数组下标为 1 的空间开始存储数据" V) g7 Y& J% |$ G; c6 q4 O for (int i=1; i<=length; i++) {* I/ z- O* \. j0 L0 J scanf("%d",&((*st)->elem.key)); }3 |- u$ ] w9 ~' ~$ _) C! V* l9 Q } 1 m& S2 a9 A T/ N //顺序查找函数,其中key为要查找的元素" O- u* A- o4 s5 E# ]! Q int Search_seq(SSTable *str,keyType key) { //str->elem[0].key=key;//将关键字作为一个数据元素存放到查找表的第一个位置,起监视哨的作用) G! k- Q: S. d8 F v int len = str->length;. d1 e* {- I( X1 @( C% i //从最后一个数据元素依次遍历,一直遍历到数组下标为0% ^/ I3 V4 o r. V. T8 J for(int i=1; i<len+1; i++) //创建数据从数组下标为1开始,查询也从1开始6 C0 \! [+ H5 y! _) s2 j {( p( u5 Z% \# V; b- _, p1 V( L if(str->elem.key == key), ?. H$ k7 G6 S |; j { return i; }8 ^0 \7 }( N* i! \. g( A0 D0 Q" t, \ } //如果 i=0,说明查找失败;查找成功返回要查找元素key的位置i return 0; } int main() { SSTable *str; int num;- F% T1 n3 J0 K o, f printf("请输入创建数据元素的个数:\n");1 B: F4 z1 r5 }6 N6 M scanf("%d",&num);3 o$ v% x, k8 J" z Create(&str, num);0 p; a4 D ]* p2 L getchar();) W3 \# p$ c) E1 p0 \ printf("请输入要查找的数据:\n"); int key;$ E* E) M, R9 ~' ^ scanf("%d",&key);" T$ n4 r% ^& H/ T, }% Z U/ S int location=Search_seq(str, key);8 O5 w0 X( ^; ~9 C- F; G if (location==0) { printf("查找失败");& D3 E6 L4 Z r) d3 y9 b5 R }else{ printf("要查找的%d的顺序为:%d",key,location); } return 0;: t3 `1 {+ r- t } 运行结果: 
查找成功 [1 ?! S% z( w5 T g 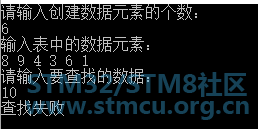
查找失败& @% w% F) ?- ^3 a8 V5 z) k 6 j: k K# |8 H S: W! C/ i 6 e3 e. ?7 S* w/ C% u( F 2 二分查找(折半查找), o [5 L9 Y6 O% g; f 算法思路:
说明:
代码: #include <stdio.h>& y* P% W( @: c' ]& P3 H#include <stdlib.h> #define keyType int typedef struct3 W1 h# C w" L+ x" w6 D {* u) u% ]4 n" {0 f Y& o keyType key;//查找表中每个数据元素的值$ ^9 R$ R/ o& K- i% n5 A }ElemType; typedef struct { ElemType *elem;//存放查找表中数据元素的数组, O8 Q! F2 V: m5 n; r2 T int length;//记录查找表中数据的总数量; e Y* f. K0 l+ k$ N5 Y }SSTable;4 Z) p0 |7 G7 O, E/ m o //创建查询数据; f' ^/ W' a9 R" C- f4 r- m void Create(SSTable **st,int length) { (*st)=(SSTable*)malloc(sizeof(SSTable));* {$ q( p! f% j% b9 k (*st)->length=length;0 h( H: ?! b; H. b* |3 I (*st)->elem =(ElemType*)malloc((length+1)*sizeof(ElemType));! ]! ?- |7 f. q- x' f7 W6 ^9 x printf("输入表中的数据元素:\n");- I1 `+ l4 s A/ b1 x& W //根据查找表中数据元素的总长度,在存储时,从数组下标为 1 的空间开始存储数据 for (int i=1; i<=length; i++)- z# r5 [+ N' t) h( B2 x! H6 [5 e {! T; P# N% l3 v9 L scanf("%d",&((*st)->elem.key)); } }# r9 ?' I$ F I //折半查找函数 key为要查找的元素 int Search_Bin(SSTable *str,keyType key) {+ s' H9 }3 I5 u( I9 C$ Q/ j2 G$ ^4 b int low=1;//初始状态 low 指针指向第一个关键字2 ~6 h1 R+ N6 m) ]' w @6 }. N int high=str->length;//high 指向最后一个关键字4 R/ o0 ~3 t/ r: r int mid; while (low<=high)$ ? Z" ~. L" ~5 W1 d { mid=(low+high)/2;//int 本身为整形,所以,mid 每次为取整的整数 if(str->elem[mid].key==key)//如果 mid 指向的同要查找的相等,返回 mid 所指向的位置( z& }$ _: r9 u& P n: H {) [0 f" E% ^) y* } return mid; } else if(str->elem[mid].key>key)//如果mid指向的关键字较大,则更新 high 指针的位置 { high=mid-1;' j! \) l* x& b/ o5 M& C/ m3 b' F }8 e) S% O& ^, v //反之,则更新 low 指针的位置 else {: |2 @: z# E0 @& T; y E, I9 ?% V low=mid+1; }5 ?2 k" K a3 } } return 0; } int main()5 X- v) `. U1 X { SSTable *str; int num; printf("请输入创建数据元素的个数:\n"); scanf("%d",&num);: G" ?$ e8 ~) P3 T1 _7 {2 h+ n [, u Create(&str, num); getchar(); printf("请输入要查找的数据:\n"); int key; scanf("%d",&key); int location=Search_Bin(str, key);. I! k% E! Q l+ V+ v if (location==0) {) S: w) I; U) [, Z" }$ ^; _ printf("没有查找到");, e, \9 i- k/ g' ~* f4 K }else{ printf("要查找的%d的顺序为:%d",key,location); }' \# P0 f+ E- R% z7 W2 u0 ~+ p return 0; }3 n- h3 h4 c4 L 运行结果: 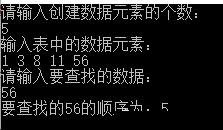
查找成功 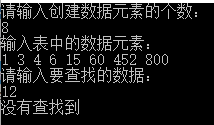
没有查找到; E& E& a- g0 A- o. d& S2 t 3 插值查找 插值查找基于二分查找算法,将查找点的选择改进为自适应选择,可以提高查找效率。当然,差值查找也属于有序查找 算法思路:
说明:
代码: #include<stdio.h>int array[10] = { 1, 4, 9, 16, 27, 31, 33, 35, 45, 64 };1 z) K6 |8 h8 R0 [& ? 8 }9 u( l9 i4 k- Z+ k int InsertionSearch(int data), \- K# p$ _5 P) r { int low = 0;! Q s+ K' U8 V z7 K W e0 _ int high = 10 - 1; int mid = -1;6 p; s6 |7 }/ \, {' T7 w int comparisons = 1;8 ]' j( @; V: I* j4 V9 P+ J int index = -1; while(low <= high) {8 @, j$ y- E& f; Y y" @ printf("比较 %d 次\n" , comparisons );3 h1 U! B$ D# q printf("low : %d, list[%d] = %d\n", low, low, array[low]);9 |, D/ Y- m& j. q printf("high : %d, list[%d] = %d\n", high, high, array[high]);3 c5 S7 e" R$ y9 s+ ~: H4 N t; } comparisons++; mid = low + (((double)(high - low) / (array[high] - array[low])) * (data - array[low]));% j: A7 y( t3 ?; ?' ] printf("mid = %d\n",mid);$ }2 |# N( z* ^0 a % Y. k4 ]. m/ G* i // 没有找到% C2 T3 Q& b$ l9 e3 K! z if(array[mid] == data) {( l/ k9 t6 F" \' a. U q5 t8 D index = mid;& p* B' ~5 g( J9 z: s/ n/ {( n; A break;- g9 B3 b) R& c4 P2 ^ } else+ J% i1 ~) F1 o0 p: J {7 {, i& R' p% U% M if(array[mid] < data) { low = mid + 1; }' `+ A5 H4 h w: i3 X5 ?. h" t! K else {+ R7 L% j, r9 C# \ high = mid - 1;9 T' I6 b! B4 F2 v }$ N, z% R$ }, @' x v% R } } printf("比较次数: %d\n", --comparisons);& u' Y, [- {! r' [/ O# e return index;1 S. S+ m; E2 x$ C- k0 p }. u$ n+ A% h9 k- ?! Z2 z. L g int main()5 P2 D/ ?- w. F( |0 v3 j6 Q: y. } { int location = InsertionSearch(27); //测试代,查27,可以找到+ N/ x& _, C: t- I. y if(location != -1) { printf("查找元素顺序为: %d\n" ,(location+1));, a* L n+ n/ @$ d% _ } else2 U1 {% B3 u9 i2 v {. i* b! h% f9 I' i, t printf("没有查找到"); } return 0; }* R8 t" W! t3 ]: b5 D2 ` 运行结果: 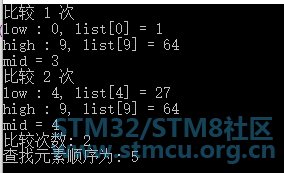
运行结果+ Q/ A2 R* K: O- N$ B- t & M9 A: A' }" q 4 斐波那契查找 斐波那契查找与折半查找很相似,他是根据斐波那契序列的特点对有序表进行分割的。他要求开始表中记录的个数为某个斐波那契数小1,及n=F(k)-1;开始将k值与第F(k-1)位置的记录进行比较(及mid=low+F(k-1)-1). 算法思路:
说明: low=mid+1说明待查找的元素在[mid+1,high]范围内,k-=2 说明范围[mid+1,high]内的元素个数为n-(F(k-1))= Fk-1-F(k-1)=Fk-F(k-1)-1=F(k-2)-1个,所以可以递归的应用斐波那契查找。 代码: #include "stdafx.h"#include <memory>. s2 T8 L8 N4 B; \1 V #include <iostream>" Z! T _3 `5 A& g% Y! z using namespace std;' ^, c3 h& Z7 Y9 A- l const int max_size=20;//斐波那契数组的长度/ V! Z7 y+ i! D2 ]6 I$ \3 O /*构造一个斐波那契数组*/ _+ I$ C7 A# W1 Q; i- e6 U void Fibonacci(int * F) { F[0]=0; F[1]=1;. u+ t6 E$ F" B for(int i=2;i<max_size;++i)! n% [% U* D9 d6 N5 d* X$ _0 J& F F=F[i-1]+F[i-2];. O6 y& @. a$ N& ]5 {, r4 x% R }8 j2 O5 B0 u5 b6 k5 ^0 }$ }# t + V( {) w: u% D4 q# ]& b/ q /*定义斐波那契查找法*/# e0 v+ r4 D3 J' N3 J int FibonacciSearch(int *a, int n, int key) //a为要查找的数组,n为要查找的数组长度,key为要查找的关键字0 d6 ?1 I! O! H. F) N1 O { int low=0; int high=n-1;" R1 [$ `4 r! q2 N int F[max_size]; Fibonacci(F);//构造一个斐波那契数组F. e+ l4 _+ F% I6 l2 r' c0 n* m int k=0;2 a, O. c. j1 r$ w2 a while(n>F[k]-1)//计算n位于斐波那契数列的位置* ]1 o# Q% Z, B, u ++k; int * temp;//将数组a扩展到F[k]-1的长度4 m3 G' n! u' p6 b& @ temp=new int [F[k]-1]; memcpy(temp,a,n*sizeof(int));" H- [7 A& d; d4 x# F, m2 n# {" t7 c# Y , y# e6 Y+ i) s9 f9 | for(int i=n;i<F[k]-1;++i)6 [2 B$ Y% b% O. p temp=a[n-1];+ v1 g& K( n/ u- v4 l8 r while(low<=high) { int mid=low+F[k-1]-1; if(key<temp[mid]) { high=mid-1; k-=1;. a3 N$ z7 p! O# Z% M" X } else if(key>temp[mid])4 Z: K; R: W' S) j) ^; e- O {6 }: w( Z6 @/ ~$ `& t low=mid+1;% B: h: I) C1 J- z, K k-=2;3 R3 q6 a; Z+ _. n+ h8 t/ d! O }; T' \0 a" J, g else { if(mid<n)' V! w- L6 z; h7 f# L return mid; //若相等则说明mid即为查找到的位置 else return n-1; //若mid>=n则说明是扩展的数值,返回n-1 }9 U) R/ r* Q: v( N4 q6 p }) o8 X, R: Z0 A g3 d- J delete [] temp;0 h3 ^% J6 x! {% [$ e2 D return 0;) `9 S7 ]$ F) f; J* B" }% q$ k% z$ j5 z; u }; ?' A2 l, R( N9 f9 K' M2 V `( o3 U( a; M- ~6 s/ J- R int main() { int a[] = {0,1,4,35,47,53,62,78,88,99}; int key=47; int index=FibonacciSearch(a,sizeof(a)/sizeof(int),key);0 a+ f* E1 Y3 T$ f p0 N# { if(index == 0)$ u3 V, T) {" K& I. g7 H { cout<<"没有找到"<<key;+ j* M; {8 z' ?; O- C" i+ c }& Y* Y+ N. a1 R% f else5 |9 ?: o2 y" U* q5 R0 m; W( [# f { cout<<key<<" 的位置是:"<<index; }; N; r% _) A2 d7 x& z return 0; }/ J3 P ?* Y: x6 m6 e 运行结果: 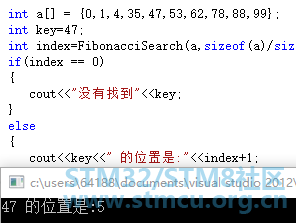
47的位置为5# {$ k- K2 f5 L) P0 Q6 U 5 哈希查找 哈希表: 我们使用一个下标范围比较大的数组来存储元素。可以设计一个函数(哈希函数, 也叫做散列函数),使得每个元素的关键字都与一个函数值(即数组下标)相对应,于是用这个数组单元来存储这个元素;也可以简单的理解为,按照关键字为每一个元素"分类",然后将这个元素存储在相应"类"所对应的地方。但是,不能够保证每个元素的关键字与函数值是一一对应的,因此极有可能出现对于不同的元素,却计算出了相同的函数值,这样就产生了"冲突",换句话说,就是把不同的元素分在了相同的"类"之中。后面我们将看到一种解决"冲突"的简便做法。 "直接定址"与"解决冲突"是哈希表的两大特点。 哈希函数: 规则:通过某种转换关系,使关键字适度的分散到指定大小的的顺序结构中,越分散,则以后查找的时间复杂度越小,空间复杂度越高。 算法思路: 如果所有的键都是整数,那么就可以使用一个简单的无序数组来实现:将键作为索引,值即为其对应的值,这样就可以快速访问任意键的值。这是对于简单的键的情况,我们将其扩展到可以处理更加复杂的类型的键。
代码: #include<stdio.h>" w B6 S3 M1 J#include<stdlib.h> $ }( g# k; e) c5 o, ]7 W/ G" S #define SUCCESS 1' U' ~! D; _! `! ` #define UNSUCCESS 0& d4 P7 Y% C/ l9 M ?' E #define OVERFLOW -1% ?# A% y# i5 k" m8 B #define OK 1* n C8 E6 ]4 d' j2 E* ] #define ERROR -1/ H: H# f' k. C8 m* l, c7 H #define MAXNUM 9999 // 用于初始化哈希表的记录 key typedef int Status; typedef int KeyType; // 哈希表中的记录类型7 |0 T! X% z' f+ F& A. |' l: r typedef struct {' B& O4 q: h8 E9 |$ z; N KeyType key; }RcdType;7 m; A/ r- G0 F9 {4 Z( J // 哈希表类型9 l b2 {: C% |: ?& O1 V" o typedef struct { RcdType *rcd; int size; int count; int *tag; D& k" W7 D# r) S }HashTable; ) A/ s% n( [) J# p // 哈希表每次重建增长后的大小 int hashsize[] = { 11, 31, 61, 127, 251, 503 }; int index = 0; // 初始哈希表, s u$ Q* J$ j9 H) i w0 _ Status InitHashTable(HashTable &H, int size)1 ]. i4 b# Q3 G$ R( v% L1 B: E {) ?/ d6 @( A6 I+ L int i;) F& S5 s# ` c' z/ O H.rcd = (RcdType *)malloc(sizeof(RcdType)*size);% N4 Z! b3 C! `( X4 Y% Q H.tag = (int *)malloc(sizeof(int)*size); if (NULL == H.rcd || NULL == H.tag) return OVERFLOW;1 Q. U* L3 H, h% ]2 ^3 {! @ KeyType maxNum = MAXNUM;: b, H- e, a: r6 n. J for (i = 0; i < size; i++) { H.tag = 0; H.rcd.key = maxNum; }2 p0 T/ A8 h, P% t3 o2 L; ^& i. E+ } H.size = size; H.count = 0; return OK; } // 哈希函数:除留余数法' q8 {$ B! f% I" C% n( {8 w% G int Hash(KeyType key, int m)# q4 f% C$ P6 c& R5 W { return (3 * key) % m; s" g$ }6 B! ]* ~. F, D }! F6 J0 M0 G6 K% a; _ // 处理哈希冲突:线性探测 void collision(int &p, int m) { p = (p + 1) % m;) N. N; ~! u- Z9 Y5 b } // 在哈希表中查询 Status SearchHash(HashTable H, KeyType key, int &p, int &c)( y/ f. S3 U# `9 Z { p = Hash(key, H.size); int h = p; c = 0;6 P1 N c7 |% Y2 I6 p6 s while ((1 == H.tag[p] && H.rcd[p].key != key) || -1 == H.tag[p])! y% W$ ]( T7 X; V/ a7 n4 }, k6 V {9 s% U0 Y6 o q5 K collision(p, H.size); c++;0 T3 r9 y: O+ E m }: X+ U: _$ Z2 A7 f7 |- n 5 B) \$ |( A1 R+ \$ Q& E1 w* j if (1 == H.tag[p] && key == H.rcd[p].key) return SUCCESS; else return UNSUCCESS; }% J( b, j9 b" }8 D/ R0 t8 j7 G 8 f* Q2 E- H! s' A. K //打印哈希表 void printHash(HashTable H) {9 a7 F9 e' m" z/ I y/ x/ h8 D int i; printf("key : ");& e9 l( s6 E& d& {6 f+ m5 H for (i = 0; i < H.size; i++)/ Y, x8 ]8 f+ \3 l9 L7 u# H printf("%3d ", H.rcd.key);' R3 u8 r, R a# _1 L" z \. C2 V printf("\n"); printf("tag : "); for (i = 0; i < H.size; i++)5 ^7 V! [; b4 Y! p) H$ U5 S$ t printf("%3d ", H.tag); printf("\n\n");4 a6 k% J& X: p }$ o% w4 k" P7 g+ ~) i, E0 T 1 t1 F: v0 J+ \; ]' J" p m // 函数声明:插入哈希表& I, U' D% l, l4 V) F) \7 p Status InsertHash(HashTable &H, KeyType key); // 重建哈希表 Status recreateHash(HashTable &H) { RcdType *orcd; int *otag, osize, i;3 c) U' A8 \9 H O" |& Q orcd = H.rcd; otag = H.tag;* [! |) z# Y @0 _+ [ osize = H.size;" O, I0 G, n/ z& x $ k4 r8 F0 d, N! A/ j' T InitHashTable(H, hashsize[index++]); //把所有元素,按照新哈希函数放到新表中5 q- N# W2 K) D" _ for (i = 0; i < osize; i++) { n2 w5 @% x4 V) e if (1 == otag) {0 C& @- }7 i' h: t: o3 K* v. c& b InsertHash(H, orcd.key); } } ^) Q& @- @) O3 b- ?" n return OK; } // 插入哈希表 Status InsertHash(HashTable &H, KeyType key) {5 ~6 R/ i, D; p0 z int p, c;* p0 P9 i6 S! @- h# T9 P" d8 w% u) X if (UNSUCCESS == SearchHash(H, key, p, c))5 m% L+ Z+ B4 u6 Z { //没有相同key if (c*1.0 / H.size < 0.5) { //冲突次数未达到上线 //插入代码8 g) ]+ \+ ]% T6 d H.rcd[p].key = key; H.tag[p] = 1;# v$ ? e9 d1 l8 b2 c) k7 N H.count++; return SUCCESS;3 T6 |" ^% I! [ }) S d, k+ h$ B: S" w/ G else recreateHash(H); //重构哈希表2 d+ Z2 }; R5 X9 M; i' S } return UNSUCCESS;8 d6 U! K: j9 N' \ }( g) {8 g T0 W! Y // 删除哈希表) f' ]: U: I0 ^0 c8 P5 A+ a' y& j Status DeleteHash(HashTable &H, KeyType key) { int p, c; if (SUCCESS == SearchHash(H, key, p, c))8 T8 a+ R. b; w4 J, d) T { //删除代码 H.tag[p] = -1; H.count--; return SUCCESS;6 u5 R, X4 M* \ } else return UNSUCCESS;# i1 a) C" S4 u }& f# | v9 v1 W4 g, {' @ $ Z5 {0 e* u$ n- O# D int main()9 f5 ^7 p5 L" g { printf("-----哈希表-----\n");) S+ f) ~+ \$ u) l7 \ HashTable H;- }1 h) k. [8 N5 H" U3 |3 @ int i; int size = 11;( t9 b8 l. g+ t& U KeyType array[8] = { 22, 41, 53, 46, 30, 13, 12, 67 };* Y: e1 T$ n$ Q' z9 w. F& }% N% M KeyType key; # w8 v" F& Q2 j/ q7 p5 h3 \1 D# L //初始化哈希表 printf("初始化哈希表\n");3 Y4 k" h) L( B9 }4 _2 p& Y% x' u& L if (SUCCESS == InitHashTable(H, hashsize[index++])) printf("初始化成功\n");% ~3 M- ]3 N4 s% t* _ 2 z6 h5 F- o; i4 S# S: ]# ^4 p //插入哈希表 printf("插入哈希表\n");% t, }% O# q0 X/ a! f' G" _ for (i = 0; i <= 7; i++)2 u" y: v4 @, @3 g* h1 P { key = array;5 A# m8 Q4 I) l( _1 b; g InsertHash(H, key); printHash(H); } % E" P- q: a; W //删除哈希表 printf("删除哈希表中key为12的元素\n"); int p, c;1 z2 i$ O) A y7 K9 Z( o7 g( h& D if (SUCCESS == DeleteHash(H, 12)) { printf("删除成功,此时哈希表为:\n"); printHash(H); }: p. q; p2 a9 w9 x6 A9 |7 c 1 }$ R8 z1 t! ^+ { //查询哈希表, r3 ?7 k* P, \( A! @ l% b printf("查询哈希表中key为67的元素\n");+ @* K! k2 ?. o; l0 p$ Q if (SUCCESS == SearchHash(H, 67, p, c)) printf("查询成功\n"); % _9 t5 y& B$ y: {8 m5 \6 C2 \* G' ^ //再次插入,测试哈希表的重建& D. x3 P% H$ Z; G% t0 @2 | printf("再次插入,测试哈希表的重建:\n");/ o4 Z( }7 b7 c( Y1 H9 N KeyType array1[8] = { 27, 47, 57, 47, 37, 17, 93, 67 };0 D3 {- j# d: f for (i = 0; i <= 7; i++) {: K- u/ u! |; c" x, Q key = array1;$ s6 F8 ^3 [' N InsertHash(H, key);. {% E( w( P7 [ printHash(H);- m2 E$ j& _" ]. @" h }3 G1 j1 V: N; ?- J! J) [9 ` `, @5 ~ 7 S; |: X9 [9 W! U2 d$ Z3 ? getchar(); return 0; }4 K0 f# B; {$ _1 W# L1 \4 ? ( R/ @6 q* d1 B1 D! V 6 二叉树查找 二叉查找树是先对待查找的数据进行生成树,确保树的左分支的值小于右分支的值,然后在就行和每个节点的父节点比较大小,查找最适合的范围。这个算法的查找效率很高,但是如果使用这种查找方法要首先创建树。 算法思路:
代码: 递归和非递归 //非递归查找算法! `' ^# w( k; J8 W F3 C. XBSTNode *BST_Search(BiTree T,ElemType key,BSTNode *&p) { //查找函数返回指向关键字值为key的结点指针,不存在则返回NULL p=NULL; while(T!=NULL&&key!=T->data) {3 K- ]+ ~, \$ x, i, {. H: ` {8 H p=T; //指向被查找结点的双亲 if(key<T->data)! l4 ^; r2 r$ S' _9 n T=T->lchild; //查找左子树0 ] E: b+ F2 o+ k5 T else T=T->rchild; //查找右子树* y3 i+ G8 X; w( I7 z# g1 w }0 o) z3 W" a! L6 M return T;3 U9 M! G4 i. y* w, H8 T4 G }$ P x; Z5 m" x. |& B //递归算法 Status Search_BST(BiTree T, int key, BiTree f, BiTree *p)7 R& X q- |2 K) P2 P$ ]3 T6 F5 R {. T; o; s d( k' x8 x //查找BST中是否存在key,f指向T双亲,其初始值为NULL //若查找成功,指针p指向数据元素结点,返回true;4 b# v! [, \7 G: R# h //若失败,p指向查找路径上访问的最后一个结点并返回false if(!T) { *p=f; return false;; n3 g8 x8 c+ H. Q- y } else if(key==T->data), {1 Z/ y$ g0 Z { //查找成功- q* }' H6 C8 E" n" }, N *p=T; return true; }0 V& M! h+ `2 V( H- Q else if(key<T->data) return Search_BST(T->lchild,key,T,p); //递归查找左子树, }+ ]3 k) U* w+ c' v; p else n/ z7 Q4 \$ X/ I3 y return Search_BST(T->rchild,key,T,p); //递归查找右子树4 m, u! ]* b; w; T/ R }3 _/ X0 O* f6 Y) c, T7 ^ 7 2-3树 2-3树运行每个节点保存1个或者两个的值。对于普通的2节点(2-node),他保存1个key和左右两个自己点。对应3节点(3-node),保存两个Key,2-3查找树的定义如下:
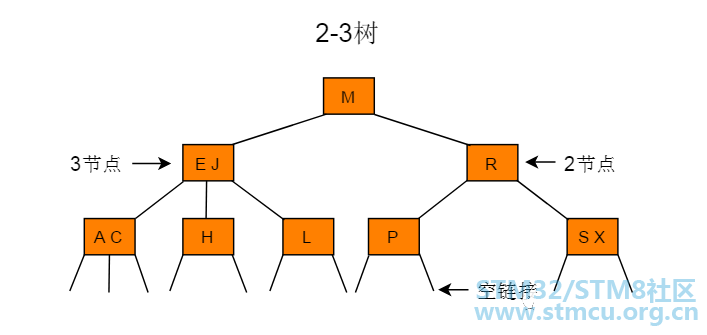
算法思路: 要判断一个键是否在树中,我们先将它和根结点中的键比较。如果它和其中的任何一个相等,查找命中。否则我们就根据比较的结果找到指向相应区间的链接,并在其指向的子树中递归地继续查找。如果这是个空链接,查找未命中。 

代码: two_three *search23(two_three *t, element x){ while(t) {) e( C. ^5 a/ f6 s& C( D+ i if (x < t->data_l) { t = t->left_child;, F2 e# \! w0 h. e } else if (x > t->data_l && x < t->data_r) {2 Y3 t/ A2 D F, _ t = t->middle_child;* C5 |) f# }% G. T( G } else if (x > t->data_r)2 H# X9 L# v3 }/ J- D {) p2 }; A0 y: v1 O5 a- O; m t = t->right_child; }% ]0 l+ f3 o) g+ I" V else {! r( j# @/ s3 d1 s" g# X! I/ @- i return t; } } return NULL; }- Z6 \* J d# j9 U8 B; p 8 红黑树 2-3查找树能保证在插入元素之后能保持树的平衡状态,最坏情况下即所有的子节点都是2-node,树的高度为lgn,从而保证了最坏情况下的时间复杂度。但是2-3树实现起来比较复杂,于是就有了一种简单实现2-3树的数据结构,即红黑树(Red-Black Tree)。 理解红黑树一句话就够了:红黑树就是用红链接表示3-结点的2-3树。 现在我们对2-3树进行改造,改造成一个二叉树。怎么改造呢?对于2节点,保持不变;对于3节点,我们首先将3节点中左侧的元素标记为红色,然后我们将其改造成图3的形式; 再将3节点的位于中间的子节点的父节点设置为父节点中那个红色的节点,如图4的所示;最后我们将图4的形式改为二叉树的样子,如图5所示。图5是不是很熟悉,没错,这就是我们常常提到的大名鼎鼎的红黑树了。如下图所示。 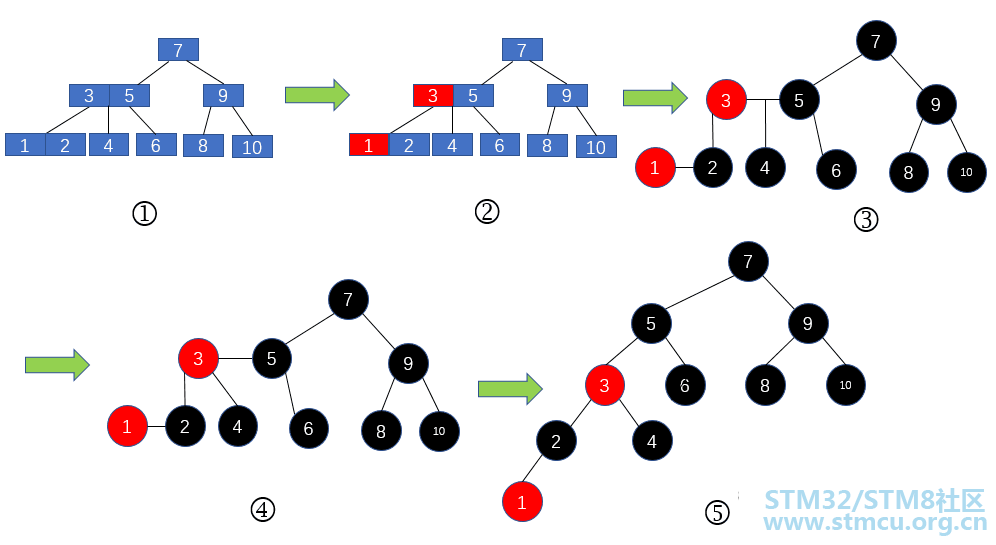
为什么使用红黑树:
红黑树性质:
算法思路: 红黑树的思想就是对2-3查找树进行编码,尤其是对2-3查找树中的3-nodes节点添加额外的信息。红黑树中将节点之间的链接分为两种不同类型,红色链接,他用来链接两个2-nodes节点来表示一个3-nodes节点。黑色链接用来链接普通的2-3节点。特别的,使用红色链接的两个2-nodes来表示一个3-nodes节点,并且向左倾斜,即一个2-node是另一个2-node的左子节点。这种做法的好处是查找的时候不用做任何修改,和普通的二叉查找树相同。 代码: #define BLACK 1#define RED 0 #include <iostream>* R! E) n: ^( t, G5 q$ q5 C using namespace std;: Q/ M% ^( D% K 0 u) J. n* Z& w. s class bst) G3 b, `8 l' Q: S* U- b { private:* X( `" |/ b( ~ struct Node {. ]9 t& `9 K- W) o; L+ g: ~ int value;! r6 T% A. q% `- Y" w bool color; Node *leftTree, *rightTree, *parent; Node() : value(0), color(RED), leftTree(NULL), rightTree(NULL), parent(NULL) { } + g8 A# X+ J3 U9 f5 @ Node* grandparent()# v, l4 R! ]/ h" x { if (parent == NULL)5 k1 @% x+ H) P( P- A+ x+ x; X7 r/ ^ {7 G2 C' }2 n1 f2 r7 W; v3 b" \ return NULL; }$ J! K0 m* M6 `/ n return parent->parent;% x/ C5 p* v+ p' x* u7 e- b2 o3 z }. [- f, I9 q' Y8 b/ L* o: } & p* c8 T9 M" O" u2 J m9 m1 ]; N Node* uncle()7 \2 }8 }; S& T! ]9 {6 N { if (grandparent() == NULL): G1 V& ` O( [9 h+ _" m. }! ~ { return NULL; } if (parent == grandparent()->rightTree) return grandparent()->leftTree; else return grandparent()->rightTree; }. u. H) R" V# @1 R( h. Y Node* sibling() { if (parent->leftTree == this) return parent->rightTree;) l: T; g) [2 h# |# ]- O, K8 e9 F else5 n9 ~7 n% a8 E+ g# U return parent->leftTree;; D% W F8 V$ a/ k }4 e( h. X! F3 n' }% A; R& U }; . R2 ]7 e: Z' f$ u void rotate_right(Node *p)4 D% ]. j8 N( h9 W {0 L" N8 c6 Q5 z8 _7 N D" u: T Node *gp = p->grandparent(); Node *fa = p->parent; Node *y = p->rightTree;' b: x* j' d( G2 c0 M* F fa->leftTree = y; / Q F: q3 Q: T' n4 s' J3 b if (y != NIL) y->parent = fa; p->rightTree = fa; fa->parent = p;9 r8 W4 a* @! D if (root == fa)7 @1 r8 w& d2 E( X T$ Y' R root = p;' c4 R; ~' K. ^( \ p->parent = gp;; Q( n( f; C- v8 G- l # _4 V8 G/ \( S- D7 Z% R4 @" v if (gp != NULL)) L$ x& u+ U& K% ~/ w' U( x" j$ Z; d6 ^ { if (gp->leftTree == fa) M3 C. w0 ^! @" v, E6 Z/ a- | gp->leftTree = p;- u; ]8 M; Y! w else gp->rightTree = p; }$ d6 ?: P. N+ J6 t7 V, O0 Z9 q } void rotate_left(Node *p)4 z! ]; e0 ~% I { if (p->parent == NULL)# u' _) E, J- Y# M: e { root = p; return; } Node *gp = p->grandparent();* V M' ~3 g, T; |) G: ~( t Node *fa = p->parent;, G: b+ d+ N3 ^* R2 {( d) C7 P Node *y = p->leftTree;3 y& E* N& s9 J& v" h/ Y' ? : P$ Y" i% n6 J0 P% v fa->rightTree = y; . Y, K8 U% s1 a' o% R! i( d if (y != NIL) y->parent = fa;" E& r$ Q8 @2 t8 x! \) P" m- E p->leftTree = fa;/ F% ~4 k* A8 Z& m k fa->parent = p; [' P$ [2 B6 G+ h0 q% j# ] if (root == fa)- o+ C( a0 h0 o, f, a) | root = p;6 o+ A- Z( \' P p->parent = gp;/ Y, ?) {8 a/ j$ Y( B ; U9 z# W2 i4 _% P if (gp != NULL) { L. z. l1 ~/ o- _6 E5 E if (gp->leftTree == fa). b. E$ `6 U, y* R+ N2 Q2 s8 l2 ] gp->leftTree = p;$ c4 T8 a8 Q( ?2 F$ l else gp->rightTree = p; } }2 _6 Y& {& q2 ^0 _9 i) O' _2 Y 6 m' g5 y7 E) l3 p void inorder(Node *p) {: I7 L5 d0 [) T( P if (p == NIL) return; & C! ?& x' _" U$ D. ]" X if (p->leftTree)( a1 m( [! f! m6 J) K! s inorder(p->leftTree); cout << p->value << " ";) ~3 A( b8 |/ l9 x$ O + X, t6 G- m: d; \ if (p->rightTree) inorder(p->rightTree); }$ O. D/ p, w+ N6 W6 T 0 D# @, S8 \' m6 W% z4 B' y$ D$ P string outputColor(bool color) { return color ? "BLACK" : "RED"; } 2 Z# {" @; W7 w0 g; b3 H. Z Node* getSmallestChild(Node *p) { if (p->leftTree == NIL) return p;3 ?! v3 x" T+ Q: l9 _" l) V return getSmallestChild(p->leftTree); } ' [' x/ D. p- B* F0 U1 b7 S1 o bool delete_child(Node *p, int data) {) M. ]3 \0 ~ h% C/ F6 { if (p->value > data)* e0 H1 Y! w3 H { if (p->leftTree == NIL) {2 c) [ t. G* {: m3 u return false; } return delete_child(p->leftTree, data); } else if (p->value < data)4 R2 m8 f: u2 ^, {! l8 g# p {+ h% D/ ?6 z4 ?0 \/ \8 X8 s if (p->rightTree == NIL) { return false;. l) n: w! {* t- J } return delete_child(p->rightTree, data);! y' _; A& i1 A) Y7 T2 r1 F- h } else if (p->value == data) { if (p->rightTree == NIL) { delete_one_child(p);0 G2 }5 h* O U1 U5 c& e return true; }0 O; W2 H6 T# T8 L& I6 S Node *smallest = getSmallestChild(p->rightTree); swap(p->value, smallest->value);4 S0 R9 n# _( p* X4 o6 I5 n delete_one_child(smallest);& g0 b' h. d- _4 z; b1 S return true; } else { return false;5 e6 `, m/ ?1 a% } w }$ E- @2 g/ S {* a* C, U8 o! _ } . |7 f+ v$ c2 h; `1 i7 z9 J5 _ D% q1 S+ o void delete_one_child(Node *p)/ F5 q. k0 _: k+ k { Node *child = p->leftTree == NIL ? p->rightTree : p->leftTree; if (p->parent == NULL && p->leftTree == NIL && p->rightTree == NIL)' S0 L' p& g- F, b9 P7 | {$ n. D2 G' `- o) e: E p = NULL; root = p; return; } 6 x% L1 Y# e$ _ A1 x if (p->parent == NULL)% I( D; S! ~4 {2 T& q b# o9 }' v { q; K8 W. j* l4 h delete p; child->parent = NULL; root = child; root->color = BLACK;9 ?# M& L. u. k1 y return;% s4 W) j5 p) A: m4 Y' [" r } if (p->parent->leftTree == p)4 x$ w: l) }0 Y7 W$ z/ t {$ x, i' K# c% s2 @) P p->parent->leftTree = child; } else {( C5 G. U9 C# p% A p->parent->rightTree = child; } child->parent = p->parent; " |0 I/ _) |* O$ |1 q" _ if (p->color == BLACK) {& T4 T0 b. f( s( I) b if (child->color == RED) { child->color = BLACK;+ M+ z5 f9 l, D- Y6 |! G! R } else) k' Z! a% Z, p$ Y- y U& X delete_case(child);) W. S% X3 H1 U1 F8 ^9 K5 [) c& V }7 b) @% T& d" a( E) T. K# P 8 R$ z" @. ]( J; b, e( R delete p;* G* Q2 o8 W7 l M } l! v4 q" ?. P' n : C/ {% _, b" p$ g# ` void delete_case(Node *p)5 r# Z# `: R% |; X. K {& |8 \9 V8 h, e, h9 v if (p->parent == NULL); I# o0 x" l! e( Z {) q, T7 E+ @4 D p->color = BLACK; return; }$ @( o0 v% U0 @/ {8 _. ?: U* O if (p->sibling()->color == RED) { p->parent->color = RED; p->sibling()->color = BLACK; if (p == p->parent->leftTree) rotate_left(p->sibling());, h, E4 A, o- l3 x0 G8 _3 s else1 D0 I5 |' t3 M rotate_right(p->sibling());* V/ |3 m& p1 k' A' o' E1 I$ j! ` }$ b" g% L: U2 I8 q) |5 S, ` if (p->parent->color == BLACK && p->sibling()->color == BLACK && p->sibling()->leftTree->color == BLACK && p->sibling()->rightTree->color == BLACK); u0 B9 J! x3 _5 b& ^" s) t+ V/ B$ I { p->sibling()->color = RED; delete_case(p->parent);' s6 W) p$ n, ?8 f/ H% T8 K& j }( [: o! E6 ~: D0 _$ {- l$ k/ O* y else if (p->parent->color == RED && p->sibling()->color == BLACK && p->sibling()->leftTree->color == BLACK && p->sibling()->rightTree->color == BLACK)9 e; ~; W& K/ r3 {, V$ E& R: x {; j+ K* E1 Z- d' _& K( H7 `1 q p->sibling()->color = RED; p->parent->color = BLACK; }8 A) @: `* _, q4 I' G else { if (p->sibling()->color == BLACK) { if (p == p->parent->leftTree && p->sibling()->leftTree->color == RED && p->sibling()->rightTree->color == BLACK) {' V8 T; u! J, M- P0 n p->sibling()->color = RED; p->sibling()->leftTree->color = BLACK;! U) C: \7 f5 C v0 w rotate_right(p->sibling()->leftTree);% K# U( M8 A6 c4 l8 r; s1 D, J6 V } else if (p == p->parent->rightTree && p->sibling()->leftTree->color == BLACK: c, c! q3 ^# f, [6 M && p->sibling()->rightTree->color == RED) { p->sibling()->color = RED; p->sibling()->rightTree->color = BLACK; rotate_left(p->sibling()->rightTree);, O! V) o$ H8 m1 Z } }% o2 g1 o; X. z2 B/ N p->sibling()->color = p->parent->color;! k2 g5 f8 T- J3 E' I# F) g' A p->parent->color = BLACK; if (p == p->parent->leftTree)9 g6 ?& [ S" Q0 u5 J2 Q, P2 B {1 F) f6 k4 U- u p->sibling()->rightTree->color = BLACK; rotate_left(p->sibling());- o( @5 o( g! V G }5 V2 g j, L( [( Q else) \0 t2 z( ]3 y) o/ v {( M0 y* Y* r& ^+ i6 e% o- R p->sibling()->leftTree->color = BLACK; rotate_right(p->sibling()); } } } # O* U8 p6 U6 l! Z" r" ~ void insert(Node *p, int data) {0 b9 P& ]; o x3 Z0 _& g7 n! p, W if (p->value >= data) {& i+ I0 _& H9 c+ o/ u& m if (p->leftTree != NIL)3 y. S8 v. F8 E0 f insert(p->leftTree, data); else. @0 }' }7 A, d {1 v) [; n4 Y( o7 T Node *tmp = new Node(); tmp->value = data;6 |: I! G8 K1 [ tmp->leftTree = tmp->rightTree = NIL; tmp->parent = p; p->leftTree = tmp; insert_case(tmp);1 Z2 N8 A* v5 d7 \, g' C } } else3 q& l! Y% f. k$ @ O { if (p->rightTree != NIL) insert(p->rightTree, data);; j2 U: h l0 @- j' [ else4 |* r* K/ y* x1 U `' M: L2 T { Node *tmp = new Node();) j/ O8 [6 d3 q0 c tmp->value = data;8 o" } h% Q C6 c5 H& C9 { tmp->leftTree = tmp->rightTree = NIL;4 t% Q2 O Q: q) Z! X1 g) C* x tmp->parent = p;8 O% G/ K$ V4 \$ q8 k" y+ s6 H f p->rightTree = tmp;5 ]/ H; t# M6 _+ @+ ]2 ^, F3 z insert_case(tmp); } }& d0 B* ^6 }% }- E# G } ! J- b+ t8 A, @; j" P; N0 W void insert_case(Node *p) { if (p->parent == NULL) {: a9 _6 c1 }+ G! l4 \ root = p; p->color = BLACK;; Y" W$ I6 p5 }- U1 K return; } if (p->parent->color == RED)0 F; e) l6 k4 u6 a { if (p->uncle()->color == RED) { p->parent->color = p->uncle()->color = BLACK;7 C; r- U& Q, v( w p->grandparent()->color = RED;8 F( Q$ o R; i* g" E, A/ R+ |- b insert_case(p->grandparent());/ _3 d# T Y& u( w } else6 g" P2 B/ T; T+ I, n! {% x { if (p->parent->rightTree == p && p->grandparent()->leftTree == p->parent)( F* }+ J4 ]$ ~8 I) w1 [& i { rotate_left(p); rotate_right(p); p->color = BLACK;5 f$ _! L8 d& ~! {% p" j; Q p->leftTree->color = p->rightTree->color = RED; } I/ F! A6 t5 q# k" Y6 }3 S" ]; ?3 b! }) D else if (p->parent->leftTree == p && p->grandparent()->rightTree == p->parent)1 C- z6 E: Z, O4 E, | {- w3 T g8 D% f& ~ L6 p rotate_right(p); rotate_left(p);% E, g* |, f8 G4 ? p->color = BLACK;4 X! q3 a: k! e' ] p->leftTree->color = p->rightTree->color = RED;! r" U' `3 Y& n# A } else if (p->parent->leftTree == p && p->grandparent()->leftTree == p->parent)& ^. ^. u4 r% ?$ X7 i { p->parent->color = BLACK; c9 P( r8 C+ F1 Z$ G p->grandparent()->color = RED;) w$ |4 r# J3 W3 _- T4 K rotate_right(p->parent); }' ?+ X+ A* ]6 q1 i2 i9 x else if (p->parent->rightTree == p && p->grandparent()->rightTree == p->parent) {2 X& {& L9 R6 }3 e/ `: Q0 d1 w2 i+ I p->parent->color = BLACK; p->grandparent()->color = RED;" N' n6 N( |8 w0 j. [ rotate_left(p->parent);' t& k4 w; D2 n7 m2 \- l- M8 D }/ K% T% d5 _: |( g8 e }1 g& U# X8 a. C3 d, _5 T# { } } : P& O9 ~5 }0 X; ] void DeleteTree(Node *p) {; X3 x" F; U. \' u( J1 ^ if (!p || p == NIL)6 X- `' t# z5 w6 I4 x; ~ {3 U6 R) P) D6 r( H return;* L) A- b: y8 J# [ }" i. l0 B% V' N- b) P$ j. I DeleteTree(p->leftTree);( a }4 [/ @# P+ o4 d4 t% z W DeleteTree(p->rightTree); delete p; m" B1 e, J3 M- A4 `, h2 D } } public: bst()' B& a7 z: D0 x1 ~ { NIL = new Node(); NIL->color = BLACK; root = NULL; }5 d" c4 l: g8 i: e3 w. h4 i ~bst()3 X4 [' x/ l- Z3 }6 J { if (root)5 {& `: Z; s5 W. D/ s" D, c4 j' v DeleteTree(root); delete NIL; }3 F8 H* W4 B5 Q, t4 m void inorder(), m p5 y0 P5 [ m. H& r { if (root == NULL) return; inorder(root); cout << endl;5 R* n: h) P. g; u } $ `5 t8 N6 Z7 d. x* T$ \* Y void insert(int x) { if (root == NULL)3 w$ p' ]' T( `6 R% e9 w- Y! _ { root = new Node(); root->color = BLACK;+ h: i3 \% @+ W* x6 X% B) W root->leftTree = root->rightTree = NIL;4 m+ W0 ]! Z- J/ q- B root->value = x; } else' g5 l& m, Z1 b) \8 F$ G% ]" ` { insert(root, x);+ C4 s* b- W! W8 P5 ~ } } bool delete_value(int data): a8 r8 d; H- N7 e) w {, I+ d! |! `4 Y5 o. \ return delete_child(root, data);7 B+ l4 r6 i0 g+ e, l } private:9 b2 Z: ]8 d2 O0 [/ G Node *root, *NIL; };* p. J% G$ E* c- O4 S int main(); P4 M* j; W: y { cout << "---【红黑树】---" << endl;2 g4 U. q* m s; Q6 {2 o% @ // 创建红黑树( V* A9 k8 F1 S0 S# ], B- w$ S bst tree;$ x0 B: \, m' `% F& G/ | // 插入元素( R7 q& K& p* ]6 P, Z) d2 k tree.insert(2);3 h* v0 G7 B& q tree.insert(9); tree.insert(-10); tree.insert(0); tree.insert(33);$ W1 c: A2 Q# }. T; g tree.insert(-19); // 顺序打印红黑树 cout << "插入元素后的红黑树:" << endl; tree.inorder(); ( Z5 J, X; ^. A' [7 m4 \+ t // 删除元素6 l" T! \( |9 K8 ]9 f tree.delete_value(2); ; X. w. t/ F9 Q // 顺序打印红黑树 cout << "删除元素 2 后的红黑树:" << endl; tree.inorder(); // 析构/ d( ^& r& d: q6 D# d& x tree.~bst();) ? Z9 U' c) V) w2 i : R; p+ J+ d# M* O9 [) B getchar(); return 0;+ v- k& s/ N! U& N5 ?' |, V } * R& d8 h q0 C3 f5 h9 A ! d1 r% ^* ? r. X' u' d1 z- w- F5 L 9 B树/B+树
B 树可以看作是对2-3查找树的一种扩展,即他允许每个节点有M-1个子节点。
如:(M=3)
算法思路: 从根结点开始,对结点内的关键字(有序)序列进行二分查找,如果命中则结束,否则进入查询关键字所属范围的儿子结点;重复,直到所对应的儿子指针为空,或已经是叶子结点;
代码: BTNode* BTree_recursive_search(const BTree tree, KeyType key, int* pos){- F1 m/ n/ `" J6 j int i = 0; j4 l5 x& {) v+ W while (i < tree->keynum && key > tree->key)% x" e9 |# w" |1 V4 n- T' ~ {7 Y# X D/ T* p$ x+ l- H9 t ++i;6 X6 e, i/ |% Z! E; K+ i }0 d/ Y! x7 ?: {; V 4 p! Z% x# e7 f+ N! q // 查找关键字 if (i < tree->keynum && tree->key == key)" u/ j8 D/ I* D0 }# {+ \ {' y, s$ a8 G8 D9 j *pos = i; return tree; } // tree 为叶子节点,找不到 key,查找失败返回 if (tree->isLeaf)2 K; C( i5 D& a; m { return NULL;3 S8 X5 A5 F6 w0 z) {7 J# A } 1 L' n8 A9 d/ Y1 [% D0 S, d // 节点内查找失败,但 tree->key[i - 1]< key < tree->key, // 下一个查找的结点应为 child8 w; f. k5 K" F: m; f6 [1 _ V. d) X 9 v. _, I; Q& k8 A/ f4 m; e6 g // 从磁盘读取第 i 个孩子的数据) H9 Q# a# m6 c disk_read(&tree->child);9 _8 r2 Q8 k# z& a7 O; ` // 递归地继续查找于树 tree->child return BTree_recursive_search(tree->child, key, pos);& x$ R7 D+ E0 v } B+树: B+树是B树的变体,也是一种多路搜索树: 其定义基本与B-树同,除了:
如:(M=3) 
算法思路: B+的搜索与B树也基本相同,区别是B+树只有达到叶子结点才命中(B树可以在 非叶子结点命中),其性能也等价于在关键字全集做一次二分查找;
|
| 顶一下 |
 微信公众号
 手机版


