




|
前言 我在阅读 《Effective C++ (第三版本)》 书时做了不少笔记,从中收获了非常多,也明白为什么会书中前言的第一句话会说: 对于书中的「条款」这一词,我更喜欢以「细节」替换,毕竟年轻的我们在打 LOL 或 王者的时,总会说注意细节!细节!细节~ —— 细节也算伴随我们的青春的字眼 针对书中的前两个章节,我筛选了 10 个 细节(条款)作为了本文的内容,这些细节也相对基础且重要。 针对这 10 细节我都用较简洁的例子来加以阐述,同时也把本文所提及细节中的「小结」总结绘画成了一副思维导图,便于大家的阅读。 正文1 让自己习惯C++细节 01:尽量以const,enum,inline 替换 #define
首先我们要清楚程序的编译重要的三个阶段:预处理阶段,编译阶段和链接阶段。 #define 是不被视为语言的一部分,它在程序编译阶段中的预处理阶段的作用,就是做简单的替换。 如下面的 PI 宏定义,在程序编译时,编译器在预处理阶段时,会先将源码中所有PI 宏定义替换成 3.14: 1#define PI 3.14程序编译在预处理阶段后,才进行真正的编译阶段。在有的编译器,运用了此 PI常量,如果遇到了编译错误,那么这个错误信息也许会提到 3.14 而不是 PI,这就会让人困惑哪里来的3.14,特别是在项目大的情况下。
作为一个语言变量,下面的 const 定义的常量 Pi 肯定会被编译器看到,出错的时候可以很清楚知道,是这个变量导致的问题: 1const doule Pi = 3.14;9 V; A9 S* B- R$ \如果是定义常量字符串,则必须要 const 两次,目的是为了防止指针所指内容和指针自身不能被改变: 1const char* const myName = "小林coding";如果是定义常量 string,则只需要在最前面加一次 const,形式如下: 1const std::string myName("小林coding");
还有另外一点宏无法涉及的,就是我们无法利用 #define 创建一个 class 专属常量,因为 #define 并不重视作用域。 对于类里要定义专属常量时,我们依然使用 static + const,形式如下: 1class Student {2private: 3 static const int num = 10; c8 A$ u' P7 Y& B7 x [ 4 int scores[num];% r$ S9 O7 h2 M 5};5 s' n& Y( X6 O0 h9 h! R# J 6! r0 z/ N! _1 v1 Q7 p0 P6 u' B 7const int Student::num; // static 成员变量,需要进行声明# ]/ [# s3 A/ }! j. W; V" \: H
enum 会帮你约束这个条件,因为取一个 enum 的地址是不合法的,形式如下: 1class Student {, L4 y* v; @/ |1 I4 n" w2private:+ c' L- t( N) H( N2 w6 Q 3 enum { num = 10 }; 4 int scores[num];6 i+ s. d% k, J! s# Z 5};
另外一个常见的 #define 误用情况是以它实现宏函数,它不会招致函数调用带来的开销,但是用 #define 编写宏函数容易出错,如下用宏定义写的求最大值的函数: 1#define MAX(a, b) ( { (a) > (b) ? (a) : (b); } ) // 求最大值这般长相的宏有着太的缺点,比如在下面调用例子: 1int a = 6, b = 5;0 A7 d- f8 Z( o& w- R+ {; U C' W: `2int max = MAX(a++, b); 3 4std::cout << max << std::endl; 5std::cout << a << std::endl;9 p$ I0 u H; O C 输出结果(以下结果是错误的): 17 // 正确的答案是 max 输出 65 b9 ?4 F' n. y. p& [* \! V% n- E28 // 正确的答案是 a 输出 78 V8 w0 w' p, \ 要解释出错的原因很简单,我们把 MAX 宏做简单替换: 1int max = ( { (a++) > (b) ? (a++) : (b); } ); // a 被累加了2次!在上述替换后,可以发现 a 被累加了 2 次。我们可以通过改进 MAX 宏,来解决这个问题: 1#define MAX(a, b) ({ \ ]) V* K1 P: x; w4 q; o# K2 __typeof(a) __a = (a), __b = (b); \! s+ F9 }% V+ F. H4 L" R8 I 3 __a > __b ? __a : __b; \ 4}); Y3 F# p& r4 Z7 U- Q% a; t% S1 n# n 简单说明下,上述的 __typeof 可以根据变量的类型来定义一个相同类型的变量,如 a 变量是 int 类型,那么 __a 变量的类型也是 int 类型。改进后的 MAX宏,输出的是正确的结果,max 输出 6,a 输出 7。 虽然改进的后 MAX 宏,解决了问题,但是这种宏的长相就让人困惑。
用 inline 修饰的函数,也是可以解决函数调用的带来的开销,同时阅读性较高,不会让人困惑。 下面用用 template inline 的方式,实现上述宏定义的函数:: 1template<typename T>0 F! l( }% ~& o. O2inline T max(const T& a, const T& b)6 S- n- V3 W+ K4 y" t5 p' h: T 3{ 4 return a > b? a : b; 5}; F% q$ \7 b1 Y max 是一个真正的函数,它遵循作用域和访问规则,所以不会出现变量被多次累加的现象。 模板的基础知识内存,可移步到我的旧文进行学习 --> 泛型编程的第一步,掌握模板的特性! 细节 01 小结 - 请记住 细节 02:尽可能使用 const
1. 面对指针,你可以指定指针自身、指针所指物,或两者都(或都不)是 const: 1char myName[] = "小林coding";2char *p = myName; // non-const pointer, non-const data! [5 N k; _3 O6 \8 V 3const char* p = myName; // non-const pointer, const data/ [0 [) u7 F/ Q: l5 j$ @: p 4char* const p = myName; // const pointer, non-const data 5const char* const p = myName; // const pointer, const data' T! v- o' Z& V; c2 Y& D* F1 g
2. 面对迭代器,你也指定迭代器自身或自迭代器所指物不可被改变: 1std::vector<int> vec;2: a* G) I" R3 ~# t6 \6 v- r 3const std::vector<int>::iterator iter = vec.begin(); // iter 的作用像 T* const& P) [0 Q% G9 @! Y& X 4*iter = 10; // 没问题,可以改变 iter 所指物 5++iter; // 错误! 因为 iter 是 const 6( J9 k9 n) x( c7 E0 u J, u6 B8 i 7std::vector<int>::const_iterator cIter = vec.begin(); // cIter 的作用像 const T* 8*cIter = 10; // 错误! 因为 *cIter 是 const ! K# o4 |8 L% M- l3 T; h2 ^ 9++cIter; // 没问题,可以改变 cIter
1. 令函数返回一个常量值,往往可以降低因程序员错误而造成的意外。举个例子: 1class Rational { ... };, S& \4 w; O6 j& V2const Rational operator* (const Rational& lhs, const Rational& rhs); 为什么要返回一个 const 对象呢?原因是如果不这样,程序员就能实现这一的暴力行为: 1Rational a, b, c;2if (a * b = c) ... // 做比较时,少了个等号* t/ F- z' W7 }) Q/ p 如果 operator* 返回的 const 对象,可以预防这个没意义的赋值动作。 2. 将 const 实施于成员函数的目的,是为了确认该成员函数可作用于 const 对象。理由如下两个: 理由 1 : 它们使得 class 接口比较容易理解,因为可以得知哪个函数可以改动对象而哪些函数不行,见如下例子: 1class MyString2{ 3public:- H7 i+ k1 E% ^ i 4 const char& operator[](std::size_t position) const // operator[] for const 对象 5 { return text[position]; }" W* n& c5 w3 d5 N 6& c$ E7 W5 C# S9 M9 L% g 7 char& operator[](std::size_t position) // operator[] for non-const 对象 8 { return text[position]; }; x1 o$ x! L; X 9private:1 N' G1 K+ Q$ |7 N, g 10 std::string text;' D& w5 ]4 _: Z0 |& N2 p7 X- q* A% c 11};3 q, C, W7 B+ m# |4 W MyString 的 operator[] 可以被这么使用: 1MyString ms("小林coding"); // non-const 对象! ]3 V5 B) F- |2std::cout << ms[0]; // 调用 non-const MyString:  perator[] 3ms[0] = 'x'; // 没问题,写一个 non-const MyString 4 5const MyString cms("小林coding"); // const 对象7 T+ K$ w4 o p 6std::cout << cms[0]; // 调用 const MyString: perator[]7cms[0] = 'x'; // 错误! 写一个 const MyString 注意,上述第 7 行会出错,原因是 cms 是 const 对象,调用的是函数返回值为 const 类型的 operator[] ,我们是不可以对 const 类型的变量或变量进行修改的。 理由 2 : 它们使操作 const 对象成为可能,这对编写高效代码是个关键,因为改善 C++ 程序效率的一个根本的方法是以 pass by referenc-to-const(const T& a) 方式传递对象,见如下例子: 1class MyString ]9 u. e9 J* u' z6 |$ M. S2{7 i6 W+ Y |6 x9 S. H+ L3 \ 3public:: v m, S) B$ @- e0 L. q 4# s; M' L" g2 _/ y 5 MyString(const char* str) : text(str) 6 { 7 std::cout << "构造函数" << std::endl; 8 }6 e# I5 r' h5 j* V 9+ U" r7 F* Y# P; ?( I 10 MyString(const MyString& myString) 11 {$ f- f6 w/ K5 N9 t 12 std::cout << "复制构造函数" << std::endl;/ @' R6 K2 [5 C5 q0 r 13 (*this).text = myString.text;& K& P4 A$ U3 k# ?# E6 _- a6 d 14 } 15( N( Z# B/ v, Y) y x6 d/ G0 y 16 ~MyString() 0 M) }0 l( ?+ W4 E4 m3 r 17 { . M- ?: { l. O6 L) p 18 std::cout << "析构函数" << std::endl; 19 } 20; c. E5 s+ a1 p 21 bool operator==(MyString rhs) const // pass by value 按值传递 22 { 23 std::cout << "operator==(MyString rhs) pass by value" << std::endl; 24 return (*this).text == rhs.text;. I/ w u8 f' ?3 r, } 25 }" r! N' U( j+ r 26private: 27 std::string text; 28}; operator== 函数是 pass by value, 也就是按值传递,我们使用它,看下会输出什么: 1int main(); x) a) p6 X+ C0 E" I5 z0 l$ E. A2{ 3 std::cout << "main()" << std::endl; 4 MyString ms1("小林coding"); 5 MyString ms2("小林coding");+ c0 {" x# @) i0 Y3 ` 6 7 std::cout << ( ms1 == ms2) << std::endl; ; 8 std::cout << "end!" << std::endl;6 T" v& F3 Y7 b7 }( V* W 9 return 0;& q9 i6 W w. A# E& I) B 10} 输出结果: 1main()2构造函数. O1 B% r3 E) R7 i9 }3 H) X, Q 3构造函数 4复制构造函数 5operator==(MyString rhs) pass by value 61 7析构函数1 ^6 a* J% h% j0 L1 A( j 8end! 9析构函数 10析构函数 可以发现在进入 operator== 函数时,发生了「复制构造函」,当离开该函数作用域后发生了「析构函数」。说明「按值传递」,在进入函数时,会产生一个副本,离开作用域后就会消耗,说明这里是存在开销的。 我们把 operator== 函数改成 pass by referenc-to-const 后,可以减少上面的副本开销: 1bool operator==(const MyString& rhs)2{: R: M$ Z/ G& b: P' k/ }- Q) y 3 std::cout << "operator==(const MyString& rhs) 7 n! A1 k, }' o7 _' N2 y5 H- x 4 pass by referenc-to-const" << std::endl; 5 return (*this).text == rhs.text; 6}4 z- N2 G+ E% e# g4 |& @9 O. x 再次输出的结果: 1main()2构造函数) F6 y2 \% |" g% ^4 g/ O+ @ 3构造函数 4operator==(const MyString& rhs) pass by referenc-to-const 51- i# X! ~- d% ? 6end! 7析构函数 8析构函数: }' u% E# M5 t6 J9 N1 h 没有发生复制构造函数,说明 pass by referenc-to-const 比 pass by value 性能高。
假设 MyString 内的 operator[] 在返回一个引用前,先执行边界校验、打印日志、校验数据完整性。把所有这些同时放进 const 和 non-const operator[]中,就会导致代码存在一定的重复: 1class MyString% C* J0 T* O% a# q: K2{ 3public: 4 const char& operator[](std::size_t position) const 5 { 6 ... // 边界检查 7 ... // 日志记录 8 ... // 校验数据完整性 9 return text[position]; 10 }8 ]: T7 j- U( c 11 12 char& operator[](std::size_t position) 13 { 8 L' ~6 A6 c% Z0 p+ a8 N; ~1 |& g 14 ... // 边界检查0 C; d. c2 u. j. c 15 ... // 日志记录9 T+ O: t, D% ^# y 16 ... // 校验数据完整性% B ]; S j- [7 P0 g 17 return text[position]; 18 } 19private: 20 std::string text; 21}; 可以有一种解决方法,避免代码的重复: 1class MyString; S+ c5 J9 Q6 Q I1 u. E8 J2{ 3public:; I0 V4 w b4 h 4 const char& operator[](std::size_t position) const // 一如既往4 M) [& G9 ~3 K 5 { : u4 e; t/ n% _0 o3 w3 j( R 6 ... // 边界检查5 _/ l2 a2 J+ L- {& o9 u/ u 7 ... // 日志记录$ [5 c3 d1 @; P( A s 8 ... // 校验数据完整性3 { ]/ e2 R2 Y9 ~ K 9 return text[position]; 10 }+ R! f( l( K+ v `0 K# I 11 12 char& operator[](std::size_t position)( S' }; i+ O3 Q6 v 13 { 0 F& x \& P, ^6 U3 i 14 return const_cast<char&>(1 W1 Q) |+ K! g% Q# B5 D 15 static_cast<const MyString&>(*this)[position]$ {# d x1 D( J, ]* D 16 ); / O f! X T# ~! R3 V. ~ 17 } 18private: 19 std::string text; 20};* W! a* Z" C+ z 这份代码有两个转型动作:
虽然语法有一点点奇特,但「运用 const 成员函数实现 non-const 孪生兄弟 」的技术是值得了解的。 需要注意的是:我们可以在 non-const 成员函数调用 const 成员函数,但是不可以反过来,在 const 成员函数调用 non-const 成员函数调用,原因是对象有可能因此改动,这会违背了 const 的本意。 细节 02 小结 - 请记住 细节 03:确定对象被使用前先被初始化
如果你这么写: 1int x;在某些语境下 x 保证被初始化为 0,但在其他语境中却不保证。那么可能在读取未初始化的值会导致不明确的行为。 为了避免不确定的问题,最佳的处理方法就是:永远在使用对象之前将它初始化。例如: 1int x = 0; // 对 int 进行手工初始化2const char* text = "abc"; // 对指针进行手工初始化+ F2 n9 H% g# ~6 G, O
对于内置类型以外的任何其他东西,初始化责任落在构造函数。 规则很简单:确保每一个构造函数都将对象的每一个成员初始化。但是别混淆了赋值和初始化。 考虑用一个表现学生的class,其构造函数如下: 1class Student {2public: 3 Student(int id, const std::string& name, const std::vector<int>& score) 4 { 5 m_Id = id; // 这些都是赋值 6 m_Name = name; // 而非初始化0 r2 i3 \7 {! {$ A1 D6 L. M 7 m_Score = score; 8 }2 w8 l" c, [9 [1 E3 F. O 9private:, Y4 _2 V- }+ j7 S1 P 10 int m_Id; 11 std::string m_Name;6 D- @1 i2 ~3 P+ C 12 std::vector<int> m_Score;3 D4 B: n+ _% L 13}; 上面的做法并非初始化,而是赋值,这不是最佳的做法。因为 C++ 规定,对象的成员变量的初始化动作发生在进入构造函数本体之前,在构造函数内,都不算是被初始化,而是被赋值。 初始化的写法是使用成员初值列,如下: 1 Student(int id,) k9 }/ \# w5 h8 M) d: p2 t2 const std::string &name,9 ^/ a9 J5 Y( Z% E5 S 3 const std::vector<int> &score)' v$ i7 s. c! o9 _' Q 4 : m_Id(id),- B1 M* o' y' y* n" Q% { 5 m_Name(name), // 现在,这些都是初始化5 u# Y* O' |5 a. h/ f3 Z 6 m_Score(score) ) h5 M' w! j6 A0 K 7 {} // 现在,构造函数本体不必有任何动作' D/ N- L. |- n6 x& y! S& P# ] 这个构造函数和上一个构造函数的最终结果是一样的,但是效率较高,凸显在:
另外一个注意的是初始化次序(顺序),初始化次序(顺序):
现在,我们关系的问题涉及至少两个以上源码文件,每一个内含至少一个 non-local static 对象。 存在的问题是:如果有一个 non-local static 对象需要等另外一个 non-local static 对象初始化后,才可正常使用,那么这里就需要保证次序的问题。 下面提供一个例子来对此理解: 1class FileSystem* r" m) `/ r: ~0 X: H- E2 d2{ 3public: 4 ... 5 std::size_t numDisk() const; // 众多成员函数之一* v( R* L% @% r 6 ...9 }6 M' G, L6 l. y' Q4 E7 V 7}; 8 9extern FileSystem tfs; // 预备给其他程序员使用对象 现假设另外一个程序员建立一个class 用以处理文件系统内的目录,很自然他们会用上 tfs 对象: 1class Directory6 s, a5 b1 Z" S7 _1 v4 t: D2{% J3 a% m- c \1 _) V* |' q# D 3public: 4 Directory( params )* ]8 q$ i) j: A0 z+ s 5 { 6 std::size_t disks = tfs.numDisk(); // 使用 tfs 对象 7 }/ j9 ]: x5 g" g2 _: l' z 8 ... 9}; 使用 Directory 对象: 1Directory tempDir( params );% l& g9 c. P% k" I; A5 Z# g4 c那么现在,初始化次序的重要性凸显出来了,除非 tfsd 对象在 tempDir 对象之前被初始化,否则 tempDir 的构造函数会用到尚未初始化的 tfs, 就会出现未定义的现象。 由于 C++ 对「定义于不同的编译单元内的 non-local static 对象」的初始化相对次序并无明确定义。但我们可以通过一个小小的设计,解决这个问题。 唯一需要做的是:将每个 non-local static 对象搬到自己的专属函数内(该对象在此函数内被声明为 static),这些函数返回一个引用指向它所含的对象。 没错也就是单例模式,代码如下: 1class FileSystem- T' ~8 n: g% P" @- `, Y$ P2{ 3public:2 n3 g+ [; o; {7 H' k J# ^+ M$ s 4 ...! i" S9 V5 P. L* r: G 5 static FileSystem& getTfs() // 该函数作用是获取 tfs 对象,4 p6 p% m3 ?7 s1 B* i0 N3 m/ r! b 6 {7 K+ z) n6 y6 P, S1 M. Y+ ~* s 7 static FileSystem tfs; // 定义并初始化一个 local static 对象,, e! g: u( |7 a$ i- R/ h* A 8 return tfs; // 返回一个引用指向上述对象。 9 } 10 ... 11};$ o0 ?( Z) }+ a9 {" n }* ` 12, V( Z8 z. P' V- n" Q( ] 138 q. k, A# S ]( i9 p. ? 14class Directory 15{ 16public:0 n/ s* u- b7 g. L 17 ... 18 Directory( params )6 e3 t+ z' @7 H 19 {. O% e7 i/ |. Z" E! k2 _8 F' @- F 20 std::size_t disks = FileSystem::getTfs().numDisk(); // 使用 tfs 对象2 D0 x: R! E+ a, v' u' G 21 }% b( e* o$ j m M! x2 o+ ~ 22 ...8 f" l) z3 Z0 K6 Y5 q- z' B 23}; 这么修改后,Directory 构造函数就会先初始化 tfs 对象,就可以避免次序问题了。虽然内含了 static 对象,但是在 C++11 以上是线程安全的。 细节 03 小结 - 请记住 2 构造/析构/赋值运算细节 04:了解 C++ 默默编写并调用哪些函数 当你写了如下的空类: 1class Student { };& Q k% q* } H ?& n% I Z编译器就会它声明,并且这些函数都是 public 且 inline:
就好像你写下这样的代码: 1class Student 2{ ( A9 u( l, j% r6 [5 S, [+ |$ b7 a 3 Student() { ... } // 默认构造函数 4 Student(const Student& rhs) { ... } // 复制构造函数! n7 [9 y2 d& o" u) d9 P# i( `7 | 5 Student& operator=(const Student& rhs) { ... } // 赋值操作符函数 6 ~Student() { ... } // 析构函数 7}; 唯有当这些函数被需要调用时,它们才会被编译器创建出来,下面代码造成上述每一个函数被编译器产出: 1Student stu1; // 默认构造函数; _/ w& H1 F! X2 k" c; a! `6 N3 T2 // 析构函数 g! d, n8 m/ |$ j6 ? a, X 3Student stu2(stu1); // 复制构造函数 4stu2 = stu1; // 赋值操作符函数5 y4 [9 ]7 \ A$ _7 J) f 编译器为我们写的函数,来说说这些函数做了什么?
对于赋值操作符函数,只有当生出的代码合法且有适当机会证明它有意义,才会生出operator= ,若万一两个条件有一个不符合,则编译器会拒绝为 class 生出operator= 。 举个例子: 1template<class T># k0 u; t# l& q) _' l2class Student/ {; o- Q. Y% G; e6 K Y 3{6 [, p% z' P, c( `; W 4public: 5 Student(std::string & name, const T& id); // 构造函数; V- J5 s0 ?4 T7 h' t& l+ J; G2 B 6 ... // 假设未声明 operator= 7priavte: 8 std::string& m_Name; // 引用3 {2 q" L; ^, d# h: v5 {6 z1 d. g 9 const T m_Id; // const 10}; 现考虑下面会发生什么: 1std::string name1("小美");2std::string name2("小林"); 3: {$ r; C$ Q9 z2 ?" t7 {4 ~ 4Student<int> p(name1, 1);, c3 A' t8 I# k 5Student<int> s(name2, 2); 6 7p = s; // 现在 p 的成员变量会发生什么? 赋值之前, p.m_Name 和 s.m_Name 都指向 string 对象且不是同一个。赋值之后 p.m_Name 应该指向 s.m_Name 所指的那个 string 吗?也就是说引用自身可被改动吗?如果是,那就开辟了新天地,因为 C++ 并不允许「让引用更改指向不同对象」。 面对这个难题,C++ 的响应是拒绝编译那一行赋值动作,本例子拒绝生成的operator= 原因如下:
最后还有一个情况:如果某个基类将 operator= 函数声明为 private ,编译器将拒绝为其派生类生成 operator= 函数。 细节 04 小结 - 请记住 细节 05:若不想使用编译器自动生成的函数,就该明确拒绝 在不允许存在一模一样的两个对象的情况下,可以把复制构造函数和赋值操作符函数声明为 private,这样既可防止编译器自动生成这两个函数。如下例子: 1class Student2{ 3public:/ c; ]" b7 p' V7 s: j1 Y2 { 4 ... 5private:$ i6 T, h+ k# U 6 ... 7 Student(const Student&); // 只有声明 8 Student& operator=(const Student&); // 只有声明 9}; 这样的话,Student 对象就无法操作下面的情况了: 1Student stu1;6 S# ^0 v; I6 a! `4 I2Student stu2(stu1); // 错误,禁用了 复制构造函数 35 X, [$ i4 z& q4 j( j* Q2 G$ j 4stu2 = stu1; // 错误,禁用了 赋值操作符函数 更容易扩展的解决方式是,可以专门写一个为阻止 copying 动作的基类: 1class Uncopyale2{" H9 q3 M6 D9 m: A 3protect: // 允许派生类对象构造和析构% @' Z5 ]; k( ~% @ 4 Uncopyale() {} 4 L! M2 o3 R3 Q3 C4 Y 5 ~Uncopyale() {}5 K2 h0 |/ g- p& f$ R# f# _7 F 6private: // 禁止派生类对象copying: v8 `! h* q4 H9 a' U4 u 7 Uncopyale(const Uncopyale&);# d Q+ L6 ]$ v. K; U" @! }3 o 8 Uncopyale& operater=(const Uncopyale&); 9};8 l5 @* y, |% \, e 使用方式很简单,只需要 private 形式的继承: 1class Student : private Uncopyale{ 2 ... // 派生类不用再声明复制构造函数和赋值操作符函数# g; l$ ]8 O" }& X1 R* T% F 3}; q3 I/ n4 x$ c. \3 H- A2 Q 那么只要某个类需要禁止 copying 动作,则只需要 private 形式的继承Uncopyale 基类即可。 细节 05 小结 - 请记住 细节 06:为多态基类声明 virtual 析构函数 多态特性的基础内容,可移步到我的旧文进行学习 --> 掌握了多态的特性,写英雄联盟的代码更少啦!
如果在多态性质的基类,没有声明一个 virtual 析构函数,那么在 delete 基类指针对象的时候,只会调用基类的析构函数,而不会调用派生类的析构函数,这就是存在了泄漏内存和其他资源的情况。 如下有多态性质基类,没有声明一个 virtual 析构函数的例子: 1// 基类2class A ; k3 b5 z! X/ J! N 3{" B2 s% ], ]* H( u u8 C 4public: 5 A() // 构造函数" z8 z2 b$ M/ P: n# a# {( v* M 6 { 7 cout << "construct A" << endl;4 A4 E! P0 ?/ Z! q 8 } 9 10 ~A() // 析构函数 11 {! F, N$ l6 `5 ]3 k) @$ p, P% m 12 cout << "Destructor A" << endl;* a# i9 V' u" r. B2 z, O5 j! R 13 } 14};! i+ r) i% A, R# V/ R" _) V. G 15 16// 派生类 17class B : public A . Y2 \0 |* K/ P- { 18{+ a& V0 b. P' e; m. X 19public: ; G! j' t5 ]1 z7 Y 20 B() // 构造函数- ?: z/ G6 Y/ \% k- `! B8 G 21 { 22 cout << "construct B" << endl; 23 } 24 25 ~B()// 析构函数% d9 o, b! s; w; r6 X 26 {8 w' Z5 k- o0 k) a6 B0 C5 m 27 cout << "Destructor B" << endl;8 l# K% B: e- Z/ b x 28 } 29};: e& \, ^4 K* J8 \- L2 P/ S) X 30% }3 `3 U! d* X, g8 K 31int main() 2 \8 {: I6 \! W4 e9 c0 e, l- N9 d+ c 32{ 33 A *pa = new B(); 34 delete pa; // 释放资源 352 G( H1 ^! {9 R 36 return 0; 37} 输出结果: 1construct A- C# p- b, @1 O5 F2 C* Z2construct B* q3 ^! o( p* K$ a# y0 s m 3Destructor A 47 L7 X2 ?8 _( Y% U; j; G j 从上面的结果,是发现了在 delete 基本对象指针时,没有调用派生类 B 的析构函数。问题出在 pa 指针指向派生类对象,而那个对象却经由一个基类指针被删除,而目前的基类没有 virtual 析构函数。 消除这个问题的做法很简单:为了避免泄漏内存和其他资源,需要把基类的析构函数声明为 virtual 析构函数。改进如下: 1// 基类& p3 y0 \: }6 \0 {0 ^2class A 3{$ v0 O1 t" A4 | 4public: ( p1 s" n; H) N5 }4 n 5 .... // 如上- G I: z! |' c; Y$ Y 6 virtual ~A() // virtual 析构函数7 [/ Q* |6 z- m; O$ d 7 {( X& v5 B S! d: W; f' Q1 x& l 8 cout << "Destructor A" << endl;. l% D; R% i9 P" M 9 }' [% f/ @ P* W4 w9 b3 } 10};6 } x2 k5 o) M6 K2 D# |4 _ 11... // 如上* w9 X' t P2 I+ n 此后删除派生类对象就会如你想要的那般,是的,它会销毁整个对象,包括所有派生类成份。
当类的设计目的不是被当做基类,令其析构函数为 virtual 往往是个馊主意。 若类里声明了 virtual 函数,对象必须携带某些信息。主要用来运行期间决定哪一个 virtual 函数被调用。 这份信息通常是由一个所谓 vptr(virtual table pointer —— 虚函数表指针)指针指出。vptr 指向一个由函数指针构成的数组,称为 vtbl(virtual table —— 虚函数表);每一个带有 virtual 函数的类都有一个相应的 vtbl。当对象调用某一 virtual 函数,实际被调用的函数取决于该对象的 vptr 所指向的那个 vtbl,接着编译器在其中寻找适当的函数指针,从而调用对应类的函数。 既然内含 virtual 函数的类的对象必须会携带信息,那么必然其对象的体积是会增加的。
因此,无端地将所有类的析构函数声明为 virtual ,是错误的,原因是会增加不必要的体积。 许多人的心得是:只有当 class 内含至少一个 virtual 函数,才为它声明 virtual 析构函数。 细节 06 小结 - 请记住 细节 07:绝不在构造和析构过程中调用 virtual 函数 我们不该在构造函数和析构函数体内调用 virtual 函数,因为这样的调用不会带来你预想的结果。 我们看如下的代码例子,来说明: 1// 基类7 M* a) p) o& R8 K9 P1 T. R2class CFather 3{) ]7 }1 O+ b3 N" w% R 4public: 5 CFather() 6 {' K: p, T( h3 R& R O* _# I# A/ z 7 hello(); 8 }- _" j( s2 D6 t( v 97 Y" ?. `$ I( q" H7 A/ t 10 virtual ~CFather() 11 { 12 bye(); 13 }! R" }' C9 E& X" t( T 14 15 virtual void hello() // 虚函数 16 {# n3 Y, U; A. b' Q+ c: y 17 cout<<"hello from father"<<endl; ( V( w$ d8 p+ N 18 } 19$ q! D% z# \4 U) T' X2 j 20 virtual void bye() // 虚函数 21 { 22 cout<<"bye from father"<<endl; 23 } 24};1 f ]: ~, I/ G( j# v 25 26// 派生类+ B0 t6 W9 O! y" g 27class CSon : public CFather 28{ ' f1 ]* q0 m' B 29public:5 _" J9 O9 O3 \4 r 30 CSon() // 构造函数 31 { 32 hello(); 9 }3 Q" q1 X& N. Q3 n. G' O 33 }4 ~9 J% m B3 d% R1 Y3 F$ H( x) J 34 35 ~CSon() // 析构函数 36 { 9 x6 H; T- B! p! _) O: S# O5 X 37 bye();% Q E. [9 ^5 R( @8 u 38 } 397 Z% t' s7 M# u, ? a 40 virtual void hello() // 虚函数 41 { Y# ~) Z* C ` 42 cout<<"hello from son"<<endl; 43 } 44* Z, e( k) j0 r0 A4 t 45 virtual void bye() // 虚函数 46 { 47 cout<<"bye from son"<<endl; : J& J7 q) N4 L: y9 w# ? 48 } 49}; 现在,当以下这行被执行时,会发生什么事情: 1CSon son;% U( H8 Y1 z- b2 b1 R1 }5 }先列出输出结果: 1hello from father4 B2 p( c$ @0 a5 G/ s( Y5 z- X2hello from son 3bye from son 4bye from father# T5 [' `1 `( I- g& E/ Q 无疑地会有一个 CSon(派生类) 构造函数被调用,但首先 CFather(基类) 构造函数一定会更早被调用。CFather(基类) 构造函数体力调用 virtual 函数 hello,这正是引发惊奇的起点。这时候被调用的 hello 是 CFather 内的版本,而不是 CSon 内的版本。 说明,基类构造期间 virtual 函数绝不会下降到派生类阶层。取而代之的是,对象的作为就像隶属于基类类型一样。 非正式的说法或许比较传神:在基类构造期间,virtual 函数不是 virtual 函数。 相同的道理,也适用于析构函数。 细节 07 小结 - 请记住 细节 08:令 operator= 返回一个 reference to *this 关于赋值,又去的是你可以把它们写成连锁形式: 1int x, y, z;* o- o. n$ W6 o3 d2x = y = z = 15; // 赋值连锁形式 ' M+ n, G0 k- a) g" Q 同样有趣的是,赋值采用右结合律,所以上述连锁赋值被解析为: 1x = (y = ( z = 15 ));这里 15 先被赋值给 z,然后其结果再被赋值给 y,然后其结果再赋值给 x 。 为了实现「连锁赋值」,赋值操作必须返回一个 reference (引用)指向操作符的左侧实参。这是我们为 classes 实现赋值操作符时应该遵循的协议: 1class A2{ 3public:# e3 E% b: A6 I 4... H1 v! d; u- Q/ K- m 5 A& operator=(const A& rhs) // 返回类型是一个引用,指向当前对象。 6 {& K) z1 m# L8 B 7 ... 8 return *this; // 返回左侧对象1 o0 P: O, _/ U8 P 9 } 10... 11};* G7 m7 d+ t* o$ ~2 D4 r4 R q 这个协议不仅适用于以上标准赋值形式,也适用于所有赋值相关运算(+=, -=, *=, 等等),例如: 1class A0 {; K0 j; T7 |) P2 H4 o2{ 3public: 4...4 V& b. ^& s5 Z+ g4 h 5 A& operator+=(const A& rhs) // 这个协议适用于 +=, -=, *=, 等等。 6 { G7 |, S Q3 [$ N4 ^, b. E s5 e- K 7 ...1 T$ G& }0 D4 @, o; f$ L( _0 H8 p 8 return *this; 9 } 10..., S/ p7 F$ a0 k+ o" }9 C C) L( q 11}; 注意,这只是个协议,并无强制性。如果不遵循它,代码一样可以通过编译,但是会破坏原本的编程习惯。 细节 08 小结 - 请记住 细节 09:在 operator= 中处理「自我赋值」 「自我赋值」发生在对象被赋值给自己时: 1class A { ... };2A a;" j- K k' B6 D# M% u& i* |+ v 3... 4a = a; // 赋值给自己 这看起来有点愚蠢,但它合法,所以不要认定我们自己绝对不会那么做。 此外赋值动作并不总是那么一眼被识别出来,例如: 1a = a[j]; // 潜在的自我赋值1 k. O! B* Z S( f) E如果 i 和 j 有相同的值,这便是个自我赋值。再看: 1*px = *py; // 潜在自我赋值& D0 K. ?; ^ s! z# g- D如果 px 和 py 刚好指向同一个东西,这也是自我赋值,这些都是并不明显的自我赋值。 考虑到我们的类内含指针成员变量: 1class B { ... };( y: c( I6 [- P* r* J* s4 W% W: [2class A 3{ 4...9 T8 W# N7 s: n* N8 ?9 F 5private:) Z9 C' r# W6 a, a8 ~. ^ 6 B * pb; // 指针,指向一个从堆分配而得的对象. Y$ w) T& T% S* F7 T4 ~ 7}: d+ F3 c# V$ v- l7 n 下面是operator = 实现代码,表面上看起来合理,但自我赋值出现时并不安全: 1A& A:perator=(const A& rhs) // 一份不安全的operator = 实现版本& Q8 W- C+ ?! q9 o6 z( Y2{ 3 delete pb; // 释放旧的指针对象) M* ~6 m6 w4 X+ r$ H+ r 4 pb = new B(*rhs.pb); // 生成新的地址 5 return *this;4 W: R2 g+ B, r+ A% a6 I+ j 6}6 B% S5 b% y" q. E4 ]9 }7 L 这里的自我赋值的问题是, operator= 函数内的 *this(赋值的目的端)和 rhs 有可能是同一个对象。果真如此 delete 就不只是销毁当前对象的 pb,它也销毁 rhs 的 pb。 相当于发生了自我销毁(自爆/自灭)过程,那么此时 A 类对象持有了一个指向一个被销毁的 B 类对象。非常的危险,请勿模仿! 下面来说说如何规避这种问题的方式。
要想阻止这种错误,传统的做法是在 operator= 函数最前面加一个 if 判断,判断是否是自己,不是才进行赋值操作: 1A& A:perator=(const A& rhs) / ^. `$ S' k4 o7 u2{5 _; ?, o1 U" [" Q; V 3 if(this == &rhs) ! w3 x) ^7 {( M' z 4 return *this; // 如果是自我赋值,则不做任何事情。 5 C$ T# E- q/ B; w, n6 X 6 delete pb; // 释放旧的指针对象 7 pb = new B(*rhs.pb); // 生成新的地址0 d% \3 a7 q3 K$ \ 8 return *this; 9}7 O' t* y* X' S) O4 m+ k 这样错虽然行得通,但是不具备自我赋值的安全性,也不具备异常安全性:
我旧文里《C++ 赋值运算符'='的重载(浅拷贝、深拷贝)》在规避这个问题试,就采用的是方式 一,这个方式是不合适的。
把代码的顺序重新编排以下就可以避免此问题,例如一下代码,我们只需之一在赋值 pb 所指东西之前别删掉 pb : 1A& A:perator=(const A& rhs) 3 `: z9 u; z$ o8 B0 w8 s% p2{! l- v4 `# X) U2 m0 t 3 A* pOrig = pb; // 记住原先的pb 4 pb = new B(*rhs.pb); // 令 pb 指向 *pb的一个副本 5 delete pOrig; // 删除原先的pb 6 return *this;" x& w! p3 B& t) {) @. A$ I 7} 现在,如果「 new B 」这句发生了异常,pb 依然保持原状。即使没有加 if 自我判断,这段代码还是能够处理自我赋值,因为我们对原 B 做了一份副本、删除原 B 、然后返回引用指向新创造的那个副本。 它或许不是处理自我赋值的最高效的方法,但它行得通。
更高效的方式使用所谓的 copy and swap 技术,实现方法如下: 1class A8 `0 J3 a6 ~; I9 K1 m* i+ z2{! k0 O% |. j8 o 3... 4void swap(A& rhs) // 交换*this 和 rhs 的数据$ I4 z" [. s5 I) i' S0 I; B- S 5{# X3 W# C4 j( M+ w; S 6 using std::swap; 7 swap(pb, rhs.pb); 8} 9... 10private:; B( y# a) q0 {. k 11 B * pb; // 指针,指向一个从堆分配而得的对象 12} 13}; 14, ^) X# ?& g8 r' z0 D; _ 15A& A: perator=(const A& rhs)16{ 17 A temp(rhs); // 为 rhs 制作一份复件(副本)3 S0 k2 o y% E! r( q( t% T" z 18 swap(tmp); // 将 *this 数据和上述复件的数据交换。5 ` m3 K$ t: i; J- R v u( }, t 19 return *this;5 u6 M. p" u( }" L' f* X' F- h 20} 当类里 operator= 函数被声明为「以 by value 方式接受实参」,那么由于 by value 方式传递东西会造成一份复件(副本),则直接 swap 交换即可,如下: 1A& A:perator=(A rhs) // rhs是被传对象的一份复件2{ 3 swap(rhs); // 将 *this 数据和复件的数据交换。 4 return *this;2 l3 W) l9 b! s. S3 `! u& ? 5}2 h* d0 U& E4 W! y/ [- i$ l9 X; I E% o 细节 09 小结 - 请记住 细节 10:复制对象时勿忘其每一个成分 在以下我把复制构造函数和赋值操作符函数,称为「copying 函数」。 如果你声明自己的 copying 函数,那么编译器就不会创建默认的 copying 函数。但是,当你在实现 copying 函数,遗漏了某个成分没被 copying,编译器却不会告诉你。
考虑用一个 class 用来表示学生,其中自实现 copying 函数,如下: 1class Student2{ 3public:0 N2 u7 \' C: y! G, O& V+ ^. |2 F 4 ...: e' G* ^9 H" `, \ 5 Student(const Student& rhs); 6 Student& operator=(const Student& rhs); 7 ... 8private:* V) R' ?! a, e. { B; M 9 std:: string name; 10} 11 12Student::Student(const Student& rhs) 13 : name(rhs.name) // 复制 rhs 的数据0 w. t5 a. k* K+ l+ b5 N2 I 14{ }3 f$ G. s/ C7 m4 |* W 15 16Student& Student: perator=(const Student& rhs) r& P% h2 r* p6 f& Y3 h- u17{* P; U9 W4 H: S. l( K 18 name = rhs.name; // 复制 rhs 的数据' c9 n; @9 a/ p, j5 C) @" H 19 return *this; 20}3 i; Y3 {) T+ `" b9 X 这里的每一件事情看起来都很好,直到另一个成员变量加入战局: 1class Student! x, Q9 P' x3 n1 \/ w2{ 3public: 4 ... // 同前 5private: 6 std:: string name;9 @- P7 g( W9 j2 _/ i 7 int score;* @3 Q' W1 G5 o( @. w 8}' m" h6 ~! b. O5 q$ M0 B8 c& U- \$ y 这时候遗漏对新成员变量的 copying。大多数编译器对此不做任何报错。 结论很明显:如果你为 class 添加一个成员变量,你必须同时修改 copying 函数。
一旦存在继承关系的类,可能会造成此一主题最黑暗肆意的一个潜在危机。试考虑: 1class CollegeStudent : public Student // 继承 Student2{ 3public: 4...3 W: D. G: T1 w7 M 5 CollegeStudent(const CollegeStudent& rhs); 6 CollegeStudent& operator=(const CollegeStudent& rhs);$ b! G, N. H' ?7 V& Q 7... 8private:9 W: K8 Q3 a+ v/ q( X 9 std::string major; 10};! t4 W. ~5 b( J* r$ v! M8 X 11+ D0 g$ r; H' f, E) F, b 12CollegeStudent::CollegeStudent(const CollegeStudent& rhs) 13 : major(rhs.major)6 G9 }( ~4 B. u3 a& F 14{ } 156 o+ V8 D8 f, E 16CollegeStudent& CollegeStudent: perator=(const CollegeStudent& rhs) B% j* A! K5 u; U- z17{* V( L9 c" N, N. q 18 major = rhs.major;+ Y2 c4 ], o8 Q; h7 S 19 return *this;9 u' T5 B( M$ e" ]5 q& o 20}6 }+ O _% T7 Q0 V2 b ? CollegeStudent 的 copying 函数看起来好像复制了 CollegeStudent 内的每一样东西,但是请再看一眼。是的,它们复制了 CollegeStudent 声明的成员变量,但每个 CollegeStudent 还内含所继承的 Student 成员变量复件(副本),而哪些成员变量却未被复制。 所以任何时候只要我们承担起「为派生类撰写 copying 函数」的重则大任,必须很小心地也复制其 base class 成分: 1CollegeStudent::CollegeStudent(const CollegeStudent& rhs). T6 }) p# Y+ l) Q7 y* H# H2 : Student(rhs), // 调用 base class 的 copy构造函数 3 major(rhs.major)" D* C: g& ]6 H: l0 f 4{ } 5 6CollegeStudent& CollegeStudent: perator=(const CollegeStudent& rhs)7{ 8 Student::operator=(rhs); // 对 base class 成分进行赋值动作+ B2 J3 s8 y! q# C( I5 R 9 major = rhs.major;' g+ M7 O J+ P, p: h6 I: C 10 return *this;# a$ \5 S! v) t0 k1 J$ F* b" X* M 11}9 Q2 }4 ~# m( E 所以我们不仅要确保复制所有类里的成员变量,还要调用所有 base classes 内的适当的 copying 函数。
还要一点需要注意的:不要令复制「构造函数」调用「赋值操作符函数」,来减少代码的重复。这么做也是存在危险的,假设调用赋值操作符函数不是你期望的。—— 错误行为。 同样也不要令「赋值操作符函数」调用「构造函数」。 如果你发现你的「复制构造函数和赋值操作符函数」有近似的代码,消除重复代码的做法是:建立一个新的成员函数给两者调用。 细节 10 小结 - 请记住 最后 能看完或滑到这里的小伙伴不容易,给你们点赞,感谢你们! 送上你们要的的思维导图 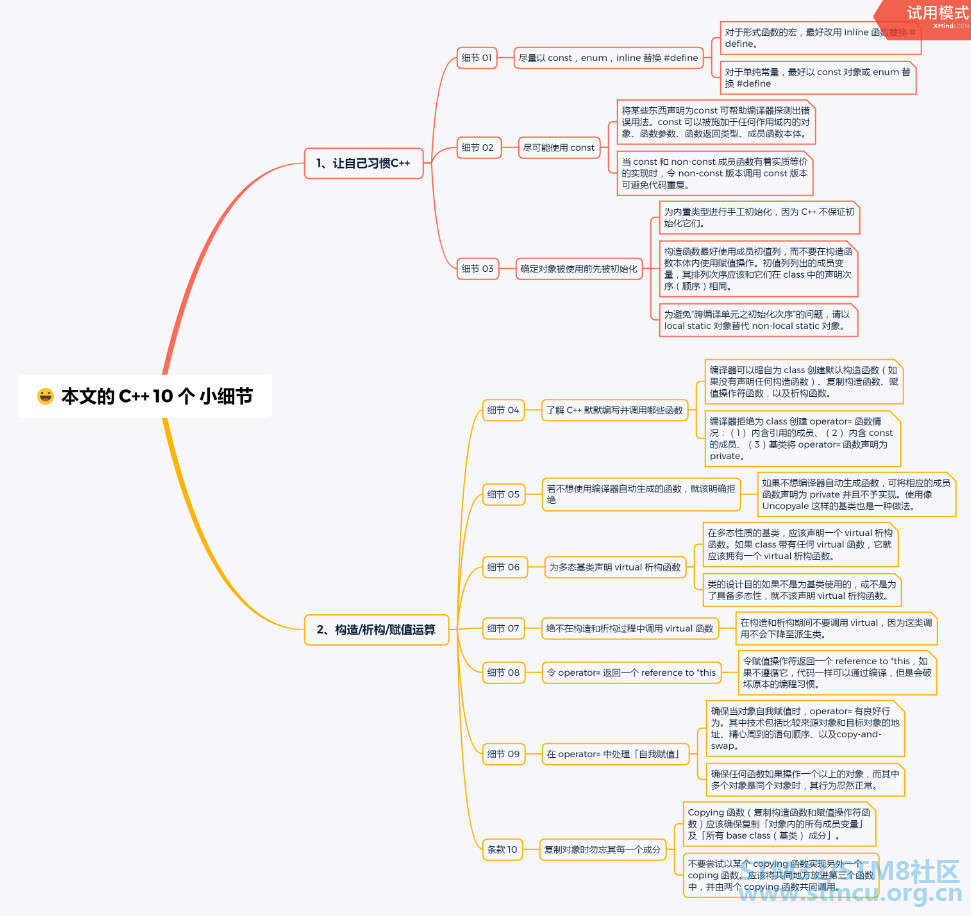
|
| 挺齐全的资料,方便下载,谢谢挺齐全的资料,方便下载,谢谢挺齐全的资料,方便下载,谢谢 |
 微信公众号
 手机版


