|
1. 背景 有时候会遇到一些疑难杂症,并且监控插件并不能一眼立马发现问题的根源。这时候就需要登录服务器进一步深入分析问题的根源。那么分析问题需要有一定的技术经验积累,并且有些问题涉及到的领域非常广,才能定位到问题。所以,分析问题和踩坑是非常锻炼一个人的成长和提升自我能力。如果我们有一套好的分析工具,那将是事半功倍,能够帮助大家快速定位问题,节省大家很多时间做更深入的事情。 2. 说明本篇文章主要介绍各种问题定位的工具以及会结合案例分析问题。 3. 分析问题的方法论套用5W2H方法,可以提出性能分析的几个问题- What-现象是什么样的
- When-什么时候发生
- Why-为什么会发生
- Where-哪个地方发生的问题
- How much-耗费了多少资源
- How to do-怎么解决问题1 t7 V0 T2 b F3 Q) S! ~
4. cpu4.1 说明针对应用程序,我们通常关注的是内核CPU调度器功能和性能。 线程的状态分析主要是分析线程的时间用在什么地方,而线程状态的分类一般分为: 如果大量时间花在CPU上,对CPU的剖析能够迅速解释原因;如果系统时间大量处于off-cpu状态,定位问题就会费时很多。但是仍然需要清楚一些概念:- 处理器
- 核
- 硬件线程
- CPU内存缓存
- 时钟频率
- 每指令周期数CPI和每周期指令数IPC
- CPU指令
- 使用率
- 用户时间/内核时间
- 调度器
- 运行队列
- 抢占
- 多进程
- 多线程
- 字长6 a; j( y- R* E9 N7 `
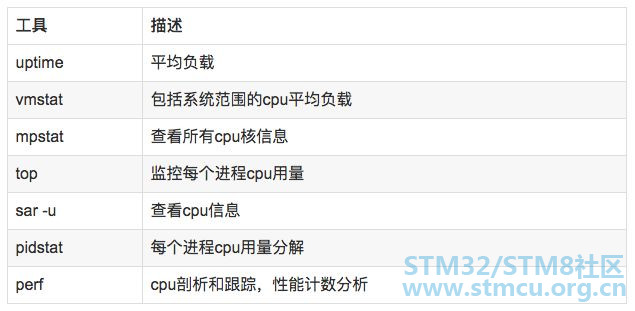
4.2 分析工具说明:- uptime,vmstat,mpstat,top,pidstat 只能查询到cpu及负载的的使用情况。
- perf可以跟着到进程内部具体函数耗时情况,并且可以指定内核函数进行统计,指哪打哪。
" Q: _/ E1 \) V& ~- u
4.3 使用方式# n# o% s. v! v, f$ Y# J
- # I+ o/ H) c! y+ c
- //查看系统cpu使用情况top6 L0 ^4 @4 W! \$ ]6 D; @* F
- //查看所有cpu核信息mpstat -P ALL 1
. f. l4 O1 r3 V7 S1 o1 \3 U - //查看cpu使用情况以及平均负载vmstat 1' c1 B# A9 U* g, s5 G: z+ T5 {
- //进程cpu的统计信息pidstat -u 1 -p pid% z* h7 R8 [+ y' W: L
- //跟踪进程内部函数级cpu使用情况 perf top -p pid -e cpu-clock
2 _; ~' A j s" b( b& \ L/ r
1 `3 q4 V+ b- U& ]% Q: h3 P5. 内存8 o$ F. }1 c( |: `, U& f) d+ d6 N
5.1 说明! s$ q- j9 V/ c3 e( _" U0 p
内存是为提高效率而生,实际分析问题的时候,内存出现问题可能不只是影响性能,而是影响服务或者引起其他问题。同样对于内存有些概念需要清楚:
: T1 b' a3 X/ V7 `- 主存
- 虚拟内存
- 常驻内存
- 地址空间
- OOM
- 页缓存
- 缺页
- 换页
- 交换空间
- 交换
- 用户分配器libc、glibc、libmalloc和mtmalloc
- LINUX内核级SLUB分配器
0 R/ k% D1 T) t- c \( x1 K- W
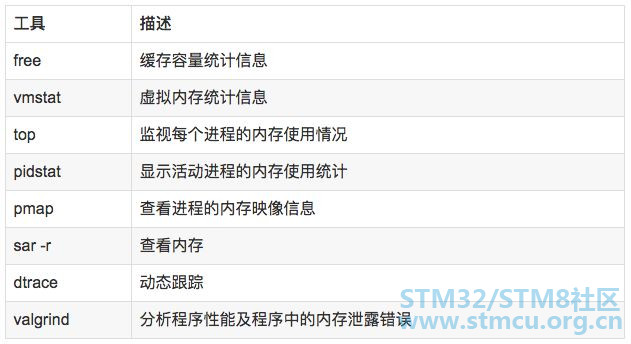
5.2 分析工具说明: 5.3 使用方式& S/ T2 h0 K6 ?9 D4 j
- 6 J8 V q/ u' w8 F% H9 e
- //查看系统内存使用情况free -m
- O- o6 `* o& A - //虚拟内存统计信息vmstat 1/ ~# \8 @$ W4 b" }, n! ]
- //查看系统内存情况top
& ?/ u9 m4 E8 a) ?; G - //1s采集周期,获取内存的统计信息pidstat -p pid -r 1
) ~1 R% V7 ?/ p- x' X- T2 q - //查看进程的内存映像信息pmap -d pid
% j$ k) n0 y! w* ?! r - //检测程序内存问题valgrind --tool=memcheck --leak-check=full --log-file=./log.txt ./程序名
# I+ Q( F: Z8 i& y% H
0 U* j7 d, U0 ~& @& j7 Y" Y6. 磁盘IO
* z" h# B2 |7 L0 ]( i6.1 说明# l. Z, t' o0 ]; Q6 Z$ U
磁盘通常是计算机最慢的子系统,也是最容易出现性能瓶颈的地方,因为磁盘离 CPU 距离最远而且 CPU 访问磁盘要涉及到机械操作,比如转轴、寻轨等。访问硬盘和访问内存之间的速度差别是以数量级来计算的,就像1天和1分钟的差别一样。要监测 IO 性能,有必要了解一下基本原理和 Linux 是如何处理硬盘和内存之间的 IO 的。
$ L3 x- M) ^' y6 u: F- `在理解磁盘IO之前,同样我们需要理解一些概念,例如: - 文件系统
- VFS
- 文件系统缓存
- 页缓存page cache
- 缓冲区高速缓存buffer cache
- 目录缓存
- inode
- inode缓存
- noop调用策略' i% @2 E" p6 _1 @: K' v
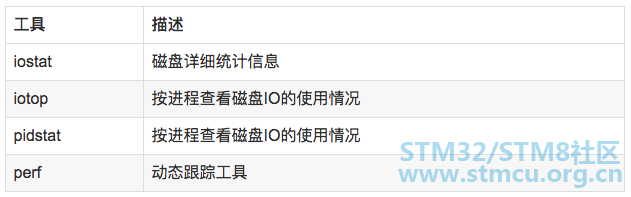
6.2 分析工具6.3 使用方式" ?( W, h/ l9 T
- % y- W8 K& U+ `3 M @# S. ?
- //查看系统io信息iotop; b" W- a; {2 \/ a& o2 R7 a0 ^7 {
- //统计io详细信息iostat -d -x -k 1 103 [! @5 k: ~9 [1 e; g5 O
- //查看进程级io的信息pidstat -d 1 -p pid
6 p: P6 I: L! t$ i - //查看系统IO的请求,比如可以在发现系统IO异常时,可以使用该命令进行调查,就能指定到底是什么原因导致的IO异常perf record -e block:block_rq_issue -ag^Cperf report
8 R6 P% C$ ^. Q! m v: ?, ]5 @% \7. 网络
6 [+ S" P* g8 I7.1 说明, ^6 a7 \! V, p: y4 k7 k3 U7 b
网络的监测是所有 Linux 子系统里面最复杂的,有太多的因素在里面,比如:延迟、阻塞、冲突、丢包等,更糟的是与 Linux 主机相连的路由器、交换机、无线信号都会影响到整体网络并且很难判断是因为 Linux 网络子系统的问题还是别的设备的问题,增加了监测和判断的复杂度。现在我们使用的所有网卡都称为自适应网卡,意思是说能根据网络上的不同网络设备导致的不同网络速度和工作模式进行自动调整。
6 L4 }- ]* y) w/ M i8 V0 G& ^8 e6 f# n) x) v4 c5 V+ K1 A4 x" P
/ a% _" U$ u, |
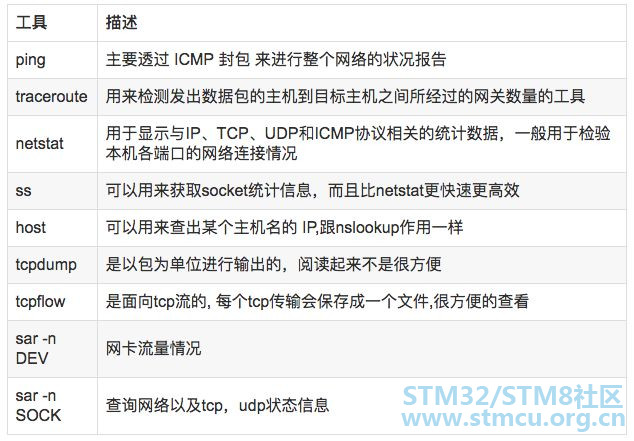
7.2 分析工具
]# t: @& ?$ v: I+ I4 F. a( H7.3 使用方式
8 Q5 ^$ U: P$ U `6 | ]. G
( l6 ?9 e9 T7 K6 [" X/ Q6 n- //显示网络统计信息netstat -s
" ^& N0 x0 _8 V - //显示当前UDP连接状况netstat -nu
, }* q$ G0 b! Q( X9 k - //显示UDP端口号的使用情况netstat -apu
$ g$ h5 `2 O! {0 ~ - //统计机器中网络连接各个状态个数netstat -a | awk '/^tcp/ {++S[$NF]} END {for(a in S) print a, S[a]}'
1 d# C' J6 j) J y2 a) W& R - //显示TCP连接ss -t -a//显示sockets摘要信息ss -s//显示所有udp socketsss -u -a//tcp,etcp状态sar -n TCP,ETCP 1- n! |7 u* K1 i
- //查看网络IOsar -n DEV 1//抓包以包为单位进行输出tcpdump -i eth1 host 192.168.1.1 and port 80 //抓包以流为单位显示数据内容tcpflow -cp host 192.168.1.1
8. 系统负载9 J! I) ]4 f0 g2 n
8.1 说明
+ W2 d% u7 L c0 f7 M( |1 tLoad 就是对计算机干活多少的度量(WikiPedia:the system Load is a measure of the amount of work that a compute system is doing)简单的说是进程队列的长度。Load Average 就是一段时间(1分钟、5分钟、15分钟)内平均Load。; G1 m& J" R& k. s" j
0 r. ~& i2 s7 g+ E {+ z' p
: Y; B+ Y E* m; v5 O! S- Y
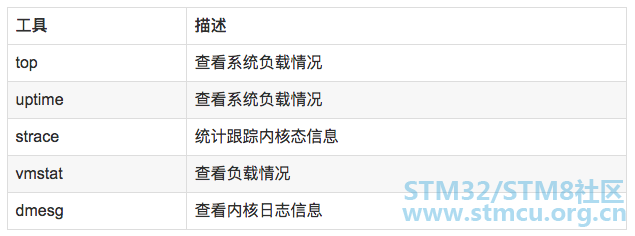
8.2 分析工具
5 I# H0 T* h$ R, U- R" W8.3 使用方式
$ r- T9 C+ y! j4 P) L
1 f4 q- Z2 ^. T- //查看负载情况uptimetopvmstat# `: J$ H4 e8 A1 \$ J& V: d# B9 S
- //统计系统调用耗时情况strace -c -p pid" n. o; q5 V# l6 j
- //跟踪指定的系统操作例如epoll_waitstrace -T -e epoll_wait -p pid" b- Z1 E6 q0 V9 Z; k3 c+ {
- //查看内核日志信息dmesg
( S8 B) g/ u ]+ e8 W9. 火焰图8 j- k6 h8 ?8 o6 w+ u' Q
9.1 说明
& V# Y( n' s1 e4 y3 q4 |2 r; j火焰图(Flame Graph是 Bredan Gregg 创建的一种性能分析图表,因为它的样子近似 ?而得名。火焰图主要是用来展示 CPU的调用栈。y 轴表示调用栈,每一层都是一个函数。调用栈越深,火焰就越高,顶部就是正在执行的函数,下方都是它的父函数。x 轴表示抽样数,如果一个函数在 x 轴占据的宽度越宽,就表示它被抽到的次数多,即执行的时间长。注意,x 轴不代表时间,而是所有的调用栈合并后,按字母顺序排列的。火焰图就是看顶层的哪个函数占据的宽度最大。只要有”平顶”(plateaus),就表示该函数可能存在性能问题。颜色没有特殊含义,因为火焰图表示的是 CPU 的繁忙程度,所以一般选择暖色调。
- ^+ x' K! {$ h. v8 w常见的火焰图类型有 On-CPU、Off-CPU、Memory、Hot/Cold、Differential等等。 9.2 安装依赖库2 J5 q) D8 m6 f) i
- " b3 k* J$ `$ d2 l9 [) a m. t
- //安装systemtap,默认系统已安装yum install systemtap systemtap-runtime
. y. C9 f# e5 V) H R - //内核调试库必须跟内核版本对应,例如:uname -r 2.6.18-308.el5kernel-debuginfo-2.6.18-308.el5.x86_64.rpmkernel-devel-2.6.18-308.el5.x86_64.rpmkernel-debuginfo-common-2.6.18-308.el5.x86_64.rpm$ ^( y- S8 a5 g6 T3 |
- //安装内核调试库debuginfo-install --enablerepo=debuginfo search kerneldebuginfo-install --enablerepo=debuginfo search glibc
) f7 Q- q- I& E6 L/ W7 p
* ]; M% z0 g0 c7 \ _. J ^, K$ s+ N9.3 安装1 K# j, R4 ]6 ?# D- K o) O/ K
- <font face="Tahoma"><font size="3"><font color="black">- B- T" l9 a5 @! ~6 e8 b$ o
- git clone http://github.com/lidaohang/quick_location.gitcd quick_location</font></font></font>
9.4 CPU级别火焰图1 p" v$ }5 z5 V# ]6 n3 B) W
cpu占用过高,或者使用率提不上来,你能快速定位到代码的哪块有问题吗? 一般的做法可能就是通过日志等方式去确定问题。现在我们有了火焰图,能够非常清晰的发现哪个函数占用cpu过高,或者过低导致的问题。 9.4.1 on-CPU
* ?* W; c; K4 Xcpu占用过高,执行中的时间通常又分为用户态时间user和系统态时间sys。使用方式:
. n; _, a& ?4 {5 y9 ~# ?- # p4 a) X& `- G6 u% a
- //on-CPU usersh ngx_on_cpu_u.sh pid
: {9 }' z& @5 t1 y! u* R - //进入结果目录 cd ngx_on_cpu_u' ~( i1 `( D! t e8 U' i
- //on-CPU kernelsh ngx_on_cpu_k.sh pid5 P3 A" N8 e) z+ x9 [
- //进入结果目录 cd ngx_on_cpu_k# j5 P6 M3 a) {3 N- Y
- //开一个临时端口 8088 python -m SimpleHTTPServer 8088//打开浏览器输入地址127.0.0.1:8088/pid.svg
' G8 X- Y% D1 \$ {
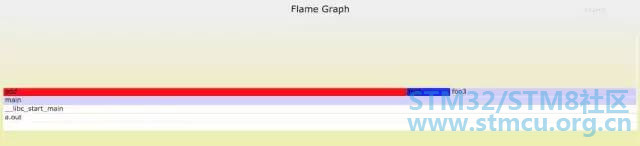
DEMO:4 V/ a/ @0 d8 B: Z$ e, s
- 9 J I. t1 R) Q
- #include <stdio.h>" i. j; [' c: C6 d, N
- #include <stdlib.h>2 k& Z0 G4 q6 S9 e V& Q4 A8 [
- 2 Q, Q/ ^/ Y# i7 O2 e1 k2 {0 {# E
- void foo3()
( _/ D5 Q4 k- K' c' } - { 7 y- d4 T9 E; B4 C' Q
- }
+ s$ N. G) ^7 m1 l! C - 8 X0 i6 t: x& G7 r5 v$ f
- void foo2(){
& U1 Y3 b/ K) c8 u$ `* @7 v - int i;
5 y) U/ |9 Y3 m2 D) K* R9 h: ~$ y - for(i=0 ; i < 10; i++) 8 H% m. w) G9 c
- foo3();
4 B6 O- m) q& _/ z5 q( K/ b - }% U) _8 x" N% I; q' N4 B& E3 q. Q
) N/ {$ f! n/ O- void foo1()' T% i6 Y2 V' w9 a. R8 F& _
- { M! v+ _, V( k# W8 b
- int i;
' s( N1 V! e' r6 J - for(i = 0; i< 1000; i++)0 t6 j+ K1 |/ @% o
- foo3();$ t" {0 s7 F5 c9 R1 M
- }
0 p- ^: J8 n8 F' F' b; F
3 p. O8 S7 n$ D6 ]* Y0 R- int main(void)% n4 i" s3 V7 o6 b, V+ ~. f
- { * Y" b4 v: `5 W1 f1 x6 K M, q: P
- int i;
$ p( g; Y3 |1 ^! X! ^ ` - for( i =0; i< 1000000000; i++) {
4 i8 B/ n/ y% _6 j. y - foo1();
3 U/ c3 H* o9 G4 U' J7 \ - foo2();
6 q8 y3 P( T7 r- {0 Q - }
6 C% M) j4 ]0 w) _ - }
% E' Y+ S, A6 P, E, _" U% s; T( A% ~4 {: ]
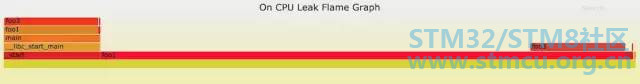
DEMO火焰图: 9.4.2 off-CPUcpu过低,利用率不高。等待下一轮CPU,或者等待I/O、锁、换页等等,其状态可以细分为可执行、匿名换页、睡眠、锁、空闲等状态。 使用方式:
1 V/ L; \. r6 Z. K- // off-CPU usersh ngx_off_cpu_u.sh pid/ v) t) p$ l5 g, r
- //进入结果目录cd ngx_off_cpu_u
# N; o- S# T, y* A: m- [, f - //off-CPU kernelsh ngx_off_cpu_k.sh pid
& h$ e3 B( K! Y/ ~3 b - //进入结果目录cd ngx_off_cpu_k: d% p( ~7 g5 o! R2 e
- //开一个临时端口8088python -m SimpleHTTPServer 8088
* v4 A$ V6 \ W& |2 s9 \/ @4 g g - //打开浏览器输入地址127.0.0.1:8088/pid.svg
1 A, M$ T, Z6 X: F p' o
I* c/ d7 e* B7 J6 R) o4 F
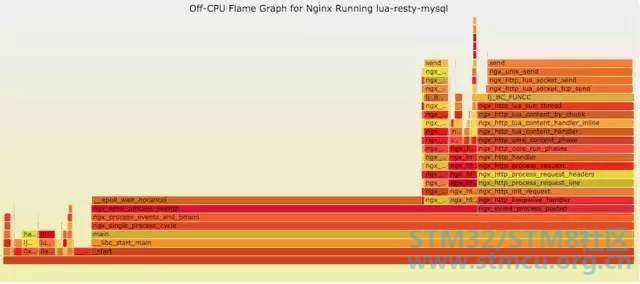
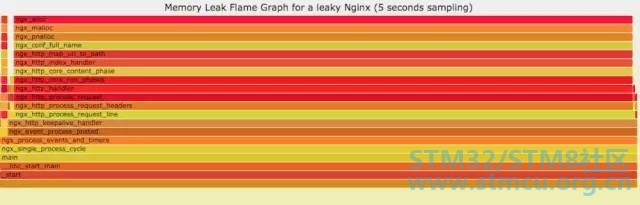
官网DEMO: 9.5 内存级别火焰图如果线上程序出现了内存泄漏,并且只在特定的场景才会出现。这个时候我们怎么办呢?有什么好的方式和工具能快速的发现代码的问题呢?同样内存级别火焰图帮你快速分析问题的根源。 使用方式:
+ W- [/ ] Y9 k$ V- sh ngx_on_memory.sh pid
' H5 \* e; X6 H7 x1 q( M) C - //进入结果目录cd ngx_on_memory, x- L7 D. Z2 n5 T" R2 G
- //开一个临时端口8088python -m SimpleHTTPServer 8088
5 \ W: H i9 P' T& D" { - //打开浏览器输入地址127.0.0.1:8088/pid.svg
5 b( Z; e4 \1 I+ m- q( a" R0 c4 h: P0 e
官网DEMO: 9.6 性能回退-红蓝差分火焰图你能快速定位CPU性能回退的问题么?如果你的工作环境非常复杂且变化快速,那么使用现有的工具是来定位这类问题是很具有挑战性的。当你花掉数周时间把根因找到时,代码已经又变更了好几轮,新的性能问题又冒了出来。主要可以用到每次构建中,每次上线做对比看,如果损失严重可以立马解决修复。 通过抓取了两张普通的火焰图,然后进行对比,并对差异部分进行标色:红色表示上升,蓝色表示下降。差分火焰图是以当前(“修改后”)的profile文件作为基准,形状和大小都保持不变。因此你通过色彩的差异就能够很直观的找到差异部分,且可以看出为什么会有这样的差异。 使用方式:
6 ]+ ~4 t3 S" D5 l5 ^4 i- cd quick_location& i' N2 I' L& Q
- //抓取代码修改前的profile 1文件perf record -F 99 -p pid -g -- sleep 30perf script > out.stacks18 e, r5 h) y) A
- //抓取代码修改后的profile 2文件perf record -F 99 -p pid -g -- sleep 30perf script > out.stacks2
0 l+ _- ] ^% v8 [% P) z( Z; \ - //生成差分火焰图:./FlameGraph/stackcollapse-perf.pl ../out.stacks1 > out.folded1./FlameGraph/stackcollapse-perf.pl ../out.stacks2 > out.folded2./FlameGraph/difffolded.pl out.folded1 out.folded2 | ./FlameGraph/flamegraph.pl > diff2.svg
% @3 ^+ k4 ^3 J, lDEMO: - ( H6 F% o! K( k7 H- W h6 `- T' f
- //test.c$ p+ O7 }" `7 ]5 d Q
- #include <stdio.h>! j. R: u- X! {. a l; _3 Z
- #include <stdlib.h>* V8 `* x3 g. F( f. t6 [! |. h
) i: D. E( f8 M, n- void foo3()) @/ q% K: D! ^( I! w- y
- {
1 K1 @* [1 B4 R9 ?: X- A1 E - }
8 Q3 A' J# q6 j3 j) v
' t+ p" J( X; v8 f! q- void foo2()
0 u' o$ Y) w8 _9 _ - { # Y p. {, F! E% k3 w8 k
- int i;
5 o( r* ^- j8 J% T - for(i=0 ; i < 10; i++)0 |% S3 v" G1 U0 K" A) h: h" f% L7 U
- foo3();# k( G/ l$ {6 A2 S
- }2 b& O) F& U5 c; }
- 5 `& F z/ p1 C% M
- void foo1()" g( d: y# r- L( `4 ]
- {
. c7 v2 q# J; [! O% Y - int i; 0 y, p6 }3 i, M9 h- L& v
- for(i = 0; i< 1000; i++) - P- W& m$ \9 {1 d* D& N
- foo3();
; P8 N( d+ b& T @$ Y; N- A - } D* S8 w% Z% ^3 m
9 r; I8 C. U0 q# }# b- int main(void); `7 `/ W, C( P6 [. r) H
- {
3 g* i6 D& _% E% _/ w, _5 t3 W - int i;5 ]2 W" W1 A- ~5 h" ]& ^4 Y _
- for( i =0; i< 1000000000; i++) {
) }) Q' C p! x - foo1();
; C" S0 f! H7 M: U* k - foo2(); @ x: t8 i U& [* X/ [8 G
- }
/ J! ~5 y' m4 e6 } - }
: ?7 R- k: X d
7 q; k# r h7 N$ o/ p- //test1.c1 \) h6 J( X) q7 u* @2 p g" l
- #include <stdio.h>
3 ^# m# [. u) X - #include <stdlib.h># V0 o# r# j1 H, |5 A
0 ~2 g0 h9 G# f7 g' U- void foo3()
' }9 ^1 U. ~3 n+ n8 S - {
+ } l: |, q5 R6 L - 7 j6 M+ Y1 i& b
- }& V- O$ Z& V- {" W/ ]" K
6 ^8 }' \+ x( _; v1 S9 h- void foo2()
% ^$ M/ p; r# y9 H - {3 o# h9 J/ d. ?/ h" z1 N
- int i;
( s/ J% S: l4 Y$ C+ Y) b. D$ U3 x - for(i=0 ; i < 10; i++)
1 L: u0 h8 p# j! Q- c5 ] - foo3();9 y# d0 _" R/ B9 Z
- }3 T7 J% E* d+ ]( @. M0 b
- 1 {% L6 \4 R& X/ O
- void foo1()* d" [" p3 X' Z" W, B6 Z5 v! k8 s: U' n
- { # x) i* r& U' Z' n
- int i;
5 s. t2 A1 ]* y7 N' P - for(i = 0; i< 1000; i++)
! w- W4 ?$ n. F) [+ U) R; y$ j. _ - foo3();) p& ]1 E9 P8 ]8 N7 G4 |
- }1 C3 u6 M5 N6 P8 ^2 j( l
- $ h2 e, A/ F+ a
- void add()
8 Q" ^3 a8 F; a( H - {
, c! p( L5 [+ u" u- G - int i; % B1 g# E: q+ n) T
- for(i = 0; i< 10000; i++)
/ A+ z% S# j" A( K - foo3();
+ G: p* j. ]. U4 _0 { - }
; R6 C& W, O2 z& J9 x. t9 w8 M - , o) l2 G6 `; p
- int main(void)
- i5 `6 n8 |$ B- | - { " B' u/ E( e% A0 y
- int i;
5 Q1 j( d% Z0 v - for( i =0; i< 1000000000; i++) {
1 I; \* O7 ?3 ~) ?1 v; j - foo1();7 U! Y7 H( h8 A! J
- foo2();
) n7 Z9 W2 @/ K6 Q, M - add();
+ d: x: }2 @- Y* y8 U. j - }
2 |, O) w1 S- y - }2 r: D8 ~! h4 k+ L# H1 _
8 _3 t8 X! I' F& e# kDEMO红蓝差分火焰图: R3 j5 u S5 o2 \9 T
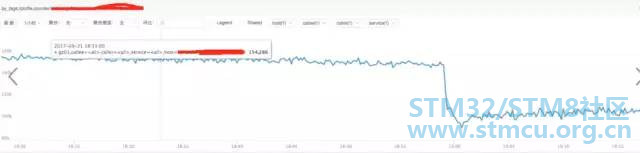
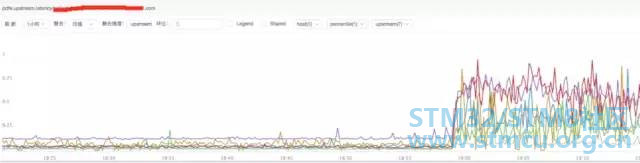
10. 案例分析10.1 接入层nginx集群异常现象通过监控插件发现在 2017.09.25 19 点nginx集群请求流量出现大量的499,5xx状态码。并且发现机器cpu使用率升高,目前一直持续中。10.2 分析nginx相关指标a) **分析nginx请求流量: 结论: 通过上图发现流量并没有突增,反而下降了,跟请求流量突增没关系。 b) **分析nginx响应时间
- t0 h: H- U6 g" I/ l
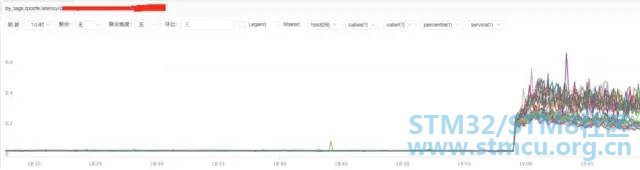
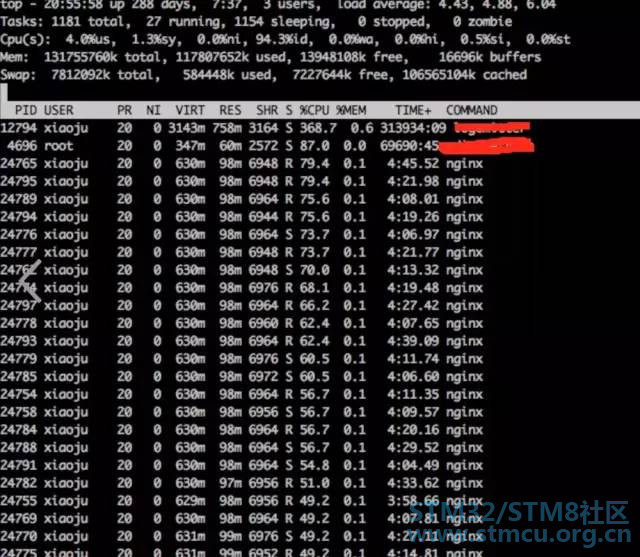
结论: 通过上图发现nginx的响应时间有增加可能跟nginx自身有关系或者跟后端upstream响应时间有关系。 c) **分析nginx upstream响应时间 结论: 通过上图发现nginx upstream 响应时间有增加,目前猜测可能后端upstream响应时间拖住nginx,导致nginx出现请求流量异常。 10.3 分析系统cpu情况a) **通过top观察系统指标 top 结论: 发现nginx worker cpu比较高 b) **分析nginx进程内部cpu情况 perf top -p pid 结论: 发现主要开销在free,malloc,json解析上面 10.4 火焰图分析cpu
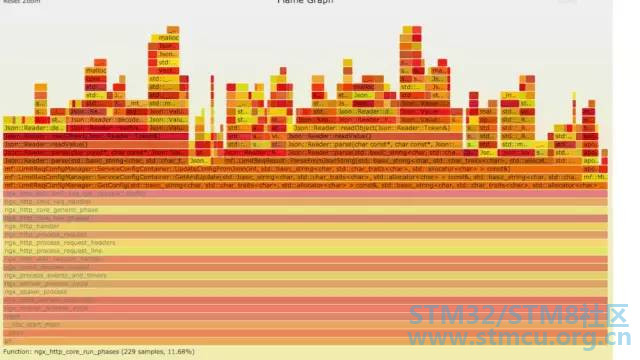
9 Q2 O, z, H& O* W9 u7 K8 |a) **生成用户态cpu火焰图
$ ]( k* G7 [0 U( }" N" v- //on-CPU usersh ngx_on_cpu_u.sh pid' `$ w8 O8 f, t0 M( \, y% J
- //进入结果目录cd ngx_on_cpu_u$ W% U7 g0 t1 H! D8 z. B3 a/ e, E
- //开一个临时端口8088python -m SimpleHTTPServer 8088" E3 `* t, U- M# s' |. i$ C
- //打开浏览器输入地址127.0.0.1:8088/pid.svg
. S- w" l% s5 f5 p+ H2 s
. Z, O0 |8 O; G% R% M结论: 发现代码里面有频繁的解析json操作,并且发现这个json库性能不高,占用cpu挺高。 10.5 案例总结a) 分析请求流量异常,得出nginx upstream后端机器响应时间拉长 b) 分析nginx进程cpu高,得出nginx内部模块代码有耗时的json解析以及内存分配回收操作 10.5.1 深入分析根据以上两点问题分析的结论,我们进一步深入分析。 后端upstream响应拉长,最多可能影响nginx的处理能力。但是不可能会影响nginx内部模块占用过多的cpu操作。并且当时占用cpu高的模块,是在请求的时候才会走的逻辑。不太可能是upstram后端拖住nginx,从而触发这个cpu的耗时操作。 10.5.2 解决方式遇到这种问题,我们优先解决已知的,并且非常明确的问题。那就是cpu高的问题。解决方式先降级关闭占用cpu过高的模块,然后进行观察。经过降级关闭该模块cpu降下来了,并且nginx请求流量也正常了。之所以会影响upstream时间拉长,因为upstream后端的服务调用的接口可能是个环路再次走回到nginx。
! h+ h& v6 ?4 H6 W, r' [: R |





 微信公众号
 手机版


