【NUCLEO-H5E5ZJ评测】HASH硬件加速实测
上一篇《CoreMark移植实录》测了这颗 STM32H5E5 的 CPU 算力,这一篇把目光移到它的安全外设 HASH——一颗硬件哈希加速器。
SHA-256 / SHA-512 是嵌入式开发里最常见的两个哈希算法:固件签名校验、OTA 包完整性、日志防篡改、TLS 握手,都绕不开它们。用纯软件算,CPU 逐字节压缩,大流量场景下开销惊人;H5E5 内置的 HASH 外设宣称 SHA-256 每分组只要 66 个时钟周期。本篇实测四种实现路径的差距:
- 纯软件:根据算法流程实现的标准 C 代码版本(OpenSSL 风格接口,零外部依赖)
- 硬件轮询:
HAL_HASH_Start(),CPU 喂数、原地等结果
- 硬件中断:
HAL_HASH_Start_IT(),DINIS 中断喂数
- 硬件 DMA:
HAL_HASH_Start_DMA(),GPDMA1 喂数,CPU 全程空闲
先说结论(SHA-256 / SHA-512,250MHz,全工程 -O3):
| 路径 |
吞吐 |
加速比 |
| 纯软件 |
4.2 / 2.2 MB/s |
1× |
| 硬件轮询 |
55.5 / 54.2 MB/s |
13× / 25× |
| 硬件中断 |
38.4 / 44.4 MB/s |
9× / 20× |
| 硬件 DMA |
122.1 / 141.6 MB/s |
29× / 64× |
两个反直觉的结果值得一篇测评专门展开:中断模式比轮询还慢 30%,以及它对 CPU 的占用是 100%——原因分析见 5.3 节。
一、准备工作
1.1 HASH 外设概览
先盘家底。翻开数据手册(DS14971),H5E5 的 HASH 外设支持:
- SHA-1、SHA-2 全系(SHA-224/256/384/512 及截断版本)
- SHA-3 全家 + SHAKE128/256(FIPS 202,这是相对 H563 新增的能力)
- HMAC(配合所有支持的算法)
- DMA 喂数、断点续算
手册还给了每分组的硬指标,据此可以算出理论吞吐上限(250MHz 下):
| 算法 |
每分组周期数 |
分组大小 |
理论吞吐上限 |
| SHA-1 |
82 |
512 bit |
195 MB/s |
| SHA-256 |
66 |
512 bit |
242 MB/s |
| SHA-384/512 |
98 |
1024 bit |
326 MB/s |
| SHA3-256 |
58 |
1088 bit |
586 MB/s |
两个有意思的推论:
- SHA-256 压缩函数共 64 轮,硬件每分组 66 个周期——约等于每轮 1 个周期。而纯软件实现每轮需要几十条指令。这个数字直接预言了后面实测的加速比量级,5.6 节会回来对照。
- SHA-3 硬件支持、但当前 HAL(FW_H5 V1.7.0)没有开放 SHA-3 API(
stm32h5xx_hal_hash.h 中查无),想用只能寄存器级开发。本篇聚焦 SHA-256/512,SHA-3 留个坑位。
另外提醒一句:H5E5 没有 AES 对称加速器(无 AES1/AES2/SAES),同代高配 H5F5 和上代 H563 才有。选型做 TLS 全链路加速的话要留意这一点。
1.2 哈希算法简介
哈希函数(散列函数)把任意长度的输入压缩成固定长度的摘要,要求满足:
- 单向性:从摘要反推原文计算上不可行
- 抗碰撞性:找两个不同输入产生相同摘要计算上不可行
- 雪崩效应:输入改 1 个比特,摘要约一半比特翻转
SHA 家族都基于 Merkle–Damgård 迭代结构:把消息切成固定长度的分组,用一个压缩函数把每个分组与当前状态迭代混合,最后输出状态即摘要。第二章会展开 SHA-256 的计算流程。
典型应用:固件镜像签名(先哈希再非对称签名)、OTA 差分包校验、日志/审计记录防篡改、TLS 证书与握手校验。
1.3 软件实现方案
硬件的对照面是软件实现:根据 SHA256/SHA512 算法流程,实现一份 OpenSSL 风格接口的标准 C 代码版本——零外部依赖,只用 <stdint.h> 和 <string.h> 两个标准头,每个算法一对 .h/.c 文件、共约 400 行。
自己写而不引库的理由:SHA-2 是教科书级算法,FIPS 180-4 把每一步都规定得明明白白,照着流程实现一遍,代码干净可控(测评要引用的正是这份代码),又与第二章的算法拆解一一呼应——第二章讲什么,代码里就写什么。接口命名采用 OpenSSL 的经典三件套 Init / Update / Final 加一次性接口,嵌入式工程师闭着眼都会用。实现见 3.3 节。
1.4 对比方案设计
测试矩阵与度量方法:
- 2 个算法 × 4 条路径 × 8 档尺寸(64B / 256B / 1K / 4K / 16K / 64K / 128K / 256K)
- 输入:256KB 全局数组,
buf[i] = i & 0xFF 规律填充——PC 端一行 Python 即可复现同样数据核对摘要
- 计时:DWT->CYCCNT 周期计数(250MHz,1 周期 = 4ns),每档取 5 次最优
- 正确性三重校验:NIST 官方向量、四条路径摘要互证、PC 端 Python 复算
- CPU 占用:DMA/中断哈希期间,主循环跑空转计数器,按校准周期折算占用比
- 编译:全工程统一
-O3(CubeMX 模板 Release 默认 -Os,会同时拖慢软件基线和 HAL 喂数路径,不公平,见 6.2)
二、算法简介
2.1 哈希函数基础
Merkle–Damgård 结构的三个角色:
- 填充(Padding):把消息长度补到分组的整数倍。SHA-256 的规则:末尾补一个
1,再补若干 0 直到长度 ≡ 448 (mod 512),最后附加 64 位大端长度
- 消息分组:SHA-256 按 512 bit(64 字节)一组;SHA-512 按 1024 bit(128 字节)一组
- 压缩函数:
H_i = f(H_{i-1}, M_i),初始值 H_0 由标准给定,最终 H_n 即摘要
理解分组结构对解读实测数据很关键:硬件的喂数粒度就是一个分组(FIFO 深度 16 字),这直接决定了 5.3 节中断模式的表现。
2.2 SHA256 计算流程
SHA-256 对每个 512 bit 分组执行 64 轮压缩。每轮的操作:
- 消息扩展:把 16 个字的分组扩展成 64 个字
W[0..63],前 16 个直接来自分组,后 48 个由 σ0、σ1 两个小函数循环生成
- 轮函数:8 个工作变量
a~h 轮转更新,用到 Ch、Maj、Σ0、Σ1 四个函数和轮常数 K[t]
- 反馈:一轮结束的输出与分组初始状态相加,进入下一轮
轮常数 K[t] 的来历是个冷知识:64 个素数的立方根小数部分的前 32 位。初始哈希值 H[0..7] 则来自素数平方根的小数部分。标准制定者用确定性数学常数保证没有人能在算法里藏后门。
对照硬件:64 轮压缩 ↔ 手册的"每分组 66 周期",硬件基本一轮一个周期;纯软件一轮要几十条指令。29× 的实测加速比(6.1 节)就是从这里来的。
2.3 分组运算示例
拿 NIST 的 "abc" 向量手算一遍最直观:
消息 "abc" = 61 62 63
填充后(512 bit):
61 62 63 80 00 00 00 00 ... 00 00 00 00 00 00 00 18
└─data─┘└─1─┘└────── 0 填充到 448 bit ──────┘└ 24(bit) ┘
最后一节是消息长度 24 bit 的大端表示。这个分组进入 64 轮压缩后:
SHA-256("abc") = ba7816bf 8f01cfea 414140de 5dae2223
                 b00361a3 96177a9c b410ff61 f20015ad
板上四条路径算出的都是这 8 个字——VECT,SHA256,abc,SW/POLL/IT/DMA,ok。SHA-512 的 "abc"、896-bit 向量同样全过(填充规则差异见 2.4)。
2.4 SHA512 差异对比
SHA-512 与 SHA-256 同构,差异全在参数:
| 参数 |
SHA-256 |
SHA-512 |
| 字长 |
32 bit |
64 bit |
| 分组大小 |
512 bit(64 B) |
1024 bit(128 B) |
| 压缩轮数 |
64 |
80 |
| 摘要长度 |
256 bit |
512 bit |
| 每分组周期(H5E5 硬件) |
66 |
98 |
对软件实现有个关键含义:Cortex-M33 是 32 位机,SHA-512 的 64 位加法/移位要拆成两条指令,软件实现相对更吃亏——实测软件 SHA-512 只有 SHA-256 的 52% 吞吐(2.2 vs 4.2 MB/s);而硬件路径两者不相上下(54.2 vs 55.5 MB/s),DMA 模式下 SHA-512 反而更快(141.6 vs 122.1 MB/s,因为 128B 大分组摊薄了搬运次数)。硬件加速把 32 位机的 64 位劣势完全抹平。
三、测试框架
3.1 计时与校验
计时用 Cortex-M33 自带的 DWT 周期计数器:
static void dwt_init(void)
{
    CoreDebug->DEMCR |= CoreDebug_DEMCR_TRCENA_Msk;
    DWT->CYCCNT = 0;
    DWT->CTRL  |= DWT_CTRL_CYCCNTENA_Msk;
}
正确性三重校验:
- NIST 向量:SHA-256 用
"abc"、448-bit 两个向量,SHA-512 用 "abc"、896-bit,期望值逐字节比对
- 路径互证:同一输入四条路径的摘要必须一致
- PC 复现:板上打印 4KB 档的参考摘要,PC 端三行 Python 核对:
import hashlib
data = (bytes(range(256)) * 64)[:4096]   # 板上 buf[i] = i & 0xFF
print(hashlib.sha256(data).hexdigest())  # 与串口 INFO,digest 逐位一致
print(hashlib.sha512(data).hexdigest())
实测 PC 与板端输出逐位相同(c8f5d034... / 034a1bd3...)。
3.2 硬件工程搭建
工程沿用 CoreMark 篇的骨架(CMake + ST-LINK VCP printf + 命令行烧录),在此基础上 CubeMX 增加两个外设。
HASH 外设在 Pinout 界面的 Security 分类下(不在 System Core,找的时候留意):

配置只有两项:Algorithm 选 SHA256、Data Type 选 Byte swap(小端 CPU 按 字节交换 喂数)。中断默认开启(HASH_IRQn)。
GPDMA1 在 System Core 分类下,Channel 9 的 Mode 先选 Standard Request Mode,Request 才会出现下拉列表,选 GPDMA1_REQUEST_HASH_IN:

Source/Destination Data Settings:字宽(Word)、源地址递增、目标固定。生成代码后,HAL_HASH_MspInit() 会自动完成 DMA 通道初始化和句柄挂接:
/* GPDMA1_REQUEST_HASH_IN Init */
handle_GPDMA1_Channel9.Instance = GPDMA1_Channel9;
handle_GPDMA1_Channel9.Init.Request = GPDMA1_REQUEST_HASH_IN;
...
__HAL_LINKDMA(hhash, hdmain, handle_GPDMA1_Channel9);
配置坑点总结——创建工程前先核对两项:
- HASH 在 Security 分类下,System Core 里翻不到;
- GPDMA 通道必须先选 Standard Request Mode,否则 Request 下拉列表不出现;选完 HASH_IN 后生成代码会自动 LINKDMA,无需手写。
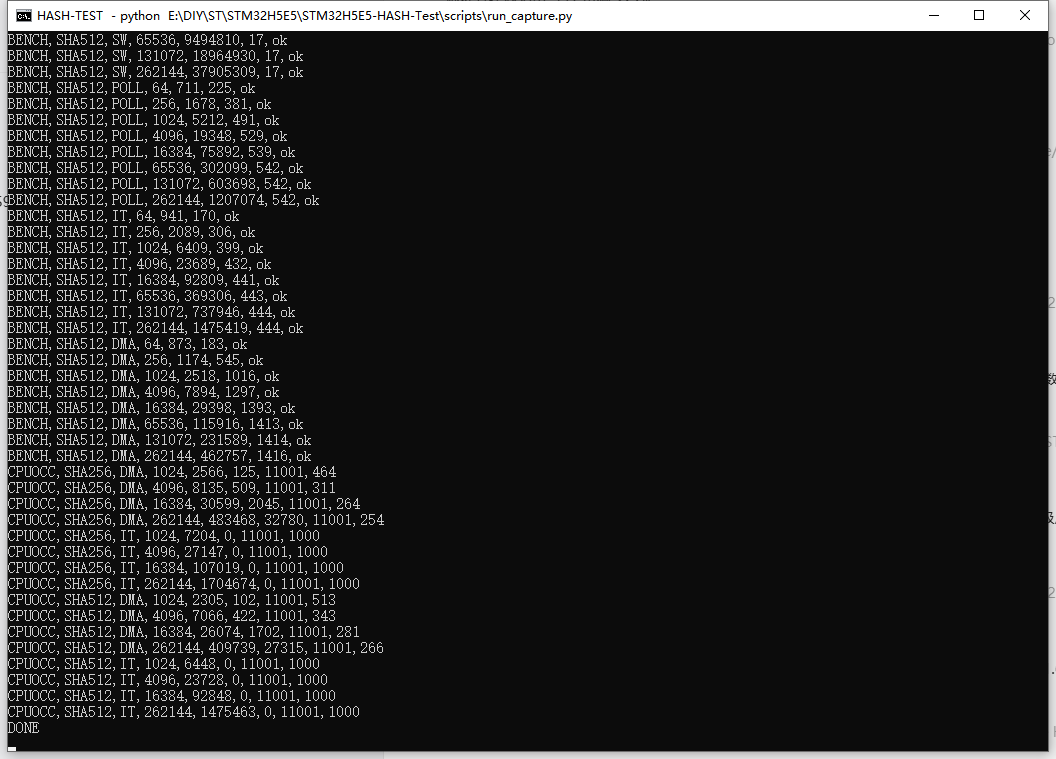
烧录固件后,PC 端用 pyserial 复位开发板并接收全部结果(CSV 格式便于解析):

32 个向量验证、64 行基准数据、16 行 CPU 占用全部通过,尾部 DONE 表示完整跑完。
3.3 软件实现
实现共两对文件(Core/Inc/sha256.h + Core/Src/sha256.c、sha512 同理),接口为 OpenSSL 风格:
/* 流式接口:分段喂数、输出摘要 */
int  SHA256_Init(SHA256_CTX *c);
int  SHA256_Update(SHA256_CTX *c, const void *data, size_t len);
int  SHA256_Final(unsigned char md[32], SHA256_CTX *c);

/* 一次性接口:内部走流式三件套 */
unsigned char *SHA256(const void *data, size_t nbytes, unsigned char md[32]);
核心是 2.2 节拆解的压缩函数,代码与算法步骤一一对应:
/* 单分组压缩:64 轮迭代更新 8 个工作变量 */
static void sha256_block(SHA256_CTX *ctx, const uint8_t *p)
{
    uint32_t w[64];

    /* 消息扩展:前 16 字为分组原文,后 48 字循环生成 */
    for (t = 0; t < 16; t++)
        w[t] = ...;                       /* 大端装配 4 字节 */
    for (t = 16; t < 64; t++)
        w[t] = SSIG1(w[t-2]) + w[t-7] + SSIG0(w[t-15]) + w[t-16];

    a = ctx->state[0]; ... h = ctx->state[7];
    for (t = 0; t < 64; t++) {            /* 64 轮压缩 */
        t1 = h + BSIG1(e) + CH(e,f,g) + K[t] + w[t];
        t2 = BSIG0(a) + MAJ(a,b,c);
        h=g; g=f; f=e; e=d+t1;  d=c; c=b; b=a; a=t1+t2;
    }
    ctx->state[0] += a; ...               /* 反馈进状态 */
}
SHA-512 同构,只是换成 64 位运算、80 轮、128B 分组(2.4 节的参数表)。
实现坑点:80 个 64 位轮常数是从素数立方根推出来的无规律数字,手抄必错(本次就抓到一处十六进制混入字母的笔误)——所以先在 PC 上用 gcc 编译跑 NIST 向量 + 与 Python hashlib 对拍规律缓冲,全绿再上板;流式接口还要补一条"分段喂数与一次性计算等价"的自测。
四、软件基线
先测纯软件,给硬件立个对照。
4.1 SHA256 软件吞吐
| 尺寸 |
周期数 |
吞吐 |
| 64 B |
12,869 |
1.2 MB/s |
| 1 KB |
69,029 |
3.7 MB/s |
| 16 KB |
967,685 |
4.2 MB/s |
| 256 KB |
15,346,664 |
4.2 MB/s |
稳态 4.2 MB/s,折合 58 周期/字节(每分组约 3700 周期,64 轮压缩平均每轮 58 条指令周期,纯 C 实现的正常水平)。小尺寸(64B)吞吐掉到 1.2 MB/s,是每次调用的固定开销(上下文初始化 + 填充尾块)占比过高。
4.2 SHA512 软件吞吐
| 尺寸 |
周期数 |
吞吐 |
| 64 B |
19,464 |
0.8 MB/s |
| 1 KB |
137,901 |
1.8 MB/s |
| 16 KB |
1,831,564 |
2.2 MB/s |
| 256 KB |
28,930,157 |
2.2 MB/s |
稳态 2.2 MB/s(110 周期/字节),只有 SHA-256 的 52%——2.4 节预言的 64 位劣势。256KB 算一次要 116 毫秒,250MHz 的 CPU 有可观的时间耗在纯哈希上,这就是硬件加速要解决的开销。
五、硬件实测
5.1 HASH 工作流程
先建立硬件模型,后面三条路径的差异就好理解了。HASH 外设的三个关键部件:
- 输入 FIFO:16 个字(64 字节)深——恰好一个 SHA-256 分组
- 压缩引擎:DIN 来一个分组消化一个分组(SHA-256 每 66 周期)
- 状态机:DINIS(FIFO 可喂数)、DCIS(摘要完成)两个状态标志
三条硬件路径的差别只在谁来喂数、怎么等完成:
| 路径 |
喂数者 |
等待方式 |
| 轮询 |
CPU 写 DIN |
CPU 自旋读 DINIS |
| 中断 |
CPU 在 ISR 里写 DIN |
DINIS/DCIS 触发中断 |
| DMA |
GPDMA 写 DIN |
硬件握手,完成触发中断 |
轮询和中断的数据搬运者都是 CPU——这个共性是 5.3 节反直觉结果的根源。
5.2 轮询实测
路径函数保持极简(这也是 HAL 的正确打开方式):
/* 硬件轮询:CPU 喂数,原地等结果 */
static int sha_hw_poll(uint32_t algo, const uint8_t *in, uint32_t len, uint8_t *out)
{
    hhash.Init.DataType  = HASH_BYTE_SWAP;
    hhash.Init.Algorithm = algo;
    HAL_HASH_Init(&hhash);              /* 算法配置应用到外设寄存器 */
    if (HAL_HASH_Start(&hhash, in, len, out, 100U) != HAL_OK) return -1;
    while (HAL_HASH_GetState(&hhash) != HAL_HASH_STATE_READY) {}
    return 0;
}
| 尺寸 |
SHA-256 |
SHA-512 |
| 64 B |
23.8 MB/s |
22.5 MB/s |
| 4 KB |
54.4 MB/s |
52.9 MB/s |
| 16 KB |
55.3 MB/s |
53.9 MB/s |
| 256 KB |
55.5 MB/s |
54.2 MB/s |
两个观察:
- 两个算法吞吐几乎一样——硬件压缩引擎不是瓶颈,瓶颈在 CPU 逐字写 DIN 的速度(每 4 字节一次总线写 + FIFO 满了要自旋等)
- 对软件的加速比 13×/25×,已经非常可观,且代码比软件实现还简单
小坑:切换算法(SHA-256 ↔ SHA-512)必须重新调 HAL_HASH_Init()——算法位是在 Init 里写进 CR 寄存器的,只改 hhash.Init.Algorithm 再直接 Start 不生效(实测 SHA-512 算出来还是 SHA-256 的结果)。
5.3 中断实测
中断路径用完成回调置标志,标准的异步写法:
static volatile uint8_t s_dgst_done;

void HAL_HASH_DgstCpltCallback(HASH_HandleTypeDef *hh)  /* 中断上下文 */
{
    (void)hh;
    s_dgst_done = 1U;
}

/* 硬件中断:DINIS 中断逐块喂数,完成回调置标志 */
static int sha_hw_it(uint32_t algo, const uint8_t *in, uint32_t len, uint8_t *out)
{
    hhash.Init.DataType  = HASH_BYTE_SWAP;
    hhash.Init.Algorithm = algo;
    HAL_HASH_Init(&hhash);
    s_dgst_done = 0U;
    if (HAL_HASH_Start_IT(&hhash, in, len, out) != HAL_OK) return -1;
    while (s_dgst_done == 0U) {}        /* 等待期间 CPU 理论上可做别的 */
    return 0;
}
实测结果违反直觉:
| 尺寸 |
轮询 |
中断 |
中断/轮询 |
| 16 KB |
55.3 MB/s |
38.2 MB/s |
69% |
| 256 KB |
55.5 MB/s |
38.4 MB/s |
69% |
| 256 KB (SHA-512) |
54.2 MB/s |
44.4 MB/s |
82% |
中断模式比轮询慢 30%,而且 CPU 占用是 100%(所有尺寸,主循环空转计数为 0)。
原因分析——三层因素叠加:
① 每次中断干的活只有 64 字节,固定开销摊不平。 这不是"测试数据量小"的问题,而是硬件喂数粒度:FIFO 16 字深,DINIS 中断按 SHA-256 每 64B(SHA-512 每 128B)触发一次。每次中断的纯开销(Cortex-M33 硬件压栈 + 取向量 + HAL_HASH_IRQHandler 分发 + 状态机检查)约 130 个周期。按 256KB 数据折算:
|
轮询 |
中断 |
每块"中断税" |
| SHA-256(每 64B 块) |
288 周期 |
416 周期 |
+128 周期(+44%) |
| SHA-512(每 128B 块) |
589 周期 |
720 周期 |
+131 周期(+22%) |
② 吞吐与消息总大小完全无关:16KB/64KB/128KB/256KB 全是 38.4 MB/s——证明瓶颈是每块的固定开销,数据再多也只是反复付这笔税。反证:SHA-512 的块是 128B,每次中断搬运量翻倍,中断/轮询保留率立刻从 69% 升到 82%——每次中断搬得越多,惩罚越小。
③ HAL 实现把轮询搬进了中断里。 读 HAL 源码发现 HASH_WriteData_IT() 在 ISR 内部同样自旋等待 DINIS/DCIS 标志,并不是"喂一块立刻退出";加上 CubeMX 把 HASH_IRQn 配在优先级 0,中断尾链连续触发,主循环被完全饿死——这就是 CPU 占用 100% 的由来。H5 的"中断模式"本质是把轮询循环搬进最高优先级中断里执行,再额外付出每块一次的进出中断成本,吞吐和 CPU 两头都吃亏。
结论:中断模式的"异步"只是编程模型上的异步,没有任何 CPU 卸载。它有意义的场景是:HASH 中断调低优先级、系统跑 RTOS 时在块间隙切换任务。但只要目标是吞吐或释放 CPU,答案只有一个——DMA。
5.4 DMA 实测
DMA 路径代码多一层分块逻辑,原因见后面的坑点:
#define DMA_CHUNK 32768U   /* GPDMA 单块上限 65535 字节,MDMAT 多块须 16B 倍数 */

/* 硬件 DMA:GPDMA1 喂数,超 32KB 自动 MDMAT 分块 */
static int sha_hw_dma(uint32_t algo, const uint8_t *in, uint32_t len, uint8_t *out)
{
    hhash.Init.DataType  = HASH_BYTE_SWAP;
    hhash.Init.Algorithm = algo;
    HAL_HASH_Init(&hhash);

    if (len <= DMA_CHUNK) {              /* 单块:末块硬件自动收尾 */
        if (HAL_HASH_Start_DMA(&hhash, in, len, out) != HAL_OK) return -1;
    } else {                             /* 多块:MDMAT 连续喂数,末块收尾 */
        uint32_t off = 0;
        __HAL_HASH_SET_MDMAT();
        while ((len - off) > DMA_CHUNK) {
            if (HAL_HASH_Start_DMA(&hhash, in + off, DMA_CHUNK, out) != HAL_OK) return -1;
            while (HAL_HASH_GetState(&hhash) != HAL_HASH_STATE_READY) {}
            off += DMA_CHUNK;
        }
        __HAL_HASH_RESET_MDMAT();
        if (HAL_HASH_Start_DMA(&hhash, in + off, len - off, out) != HAL_OK) return -1;
    }
    while (HAL_HASH_GetState(&hhash) != HAL_HASH_STATE_READY) {}
    return 0;
}
| 尺寸 |
SHA-256 |
SHA-512 |
| 64 B |
20.9 MB/s |
18.3 MB/s |
| 1 KB |
94.2 MB/s |
101.6 MB/s |
| 16 KB |
120.7 MB/s |
139.3 MB/s |
| 256 KB |
122.1 MB/s |
141.6 MB/s |
- 256KB 分 8 块搬运,吞吐与单块 32KB 持平——分块开销可忽略
- SHA-512 反超 SHA-256:128B 大分组让 DMA 搬运次数减半,压缩引擎更快(98 周期/1024bit)
- 对软件加速比 29× / 64×
DMA 路径是本次调试投入最大的一章,踩了三个坑,每一个都有代表性:
DMA 三坑(全部实测复现,排查过程花了整个下午):
- 源地址必须字对齐:曾直接把 FLASH 里的字符串常量
"abc"(落在 0x0800858A,%4=2)喂给 DMA,GPDMA 立刻报 USEF(用户设置错误,错误码 4)。RM0517 明**定源地址须为数据宽度的整数倍——FLASH 常量不保证对齐,先拷到对齐的 SRAM 缓冲
- 单块上限 65535 字节:GPDMA 块计数寄存器 BNDT 只有 16 位,传 65536 会截断成 0(空块也是 USEF)。HAL 不检查这个溢出,表现为玄学失败。大缓冲必须像上面那样用 MDMAT 分块
- HAL 错误路径泄漏 DMA 句柄锁:首次 DMA 出错后
hdma->Lock 停留在锁定态,后续所有调用在 __HAL_LOCK 处直接返回 HAL_BUSY,寄存器根本不再重编——表现是"换通道、换配置都失败",极具迷惑性(我们为此冤枉过通道 FIFO 深度、端口分配甚至硅片)。出错后需手动解锁句柄才能恢复
5.5 CPU 占用实测
"硬件加速省 CPU"不能停留在定性,用空转计数器量化:哈希期间主循环全力跑 s_idle++,按校准周期数折算被抢占的比例。
| 场景(16KB / 256KB) |
CPU 占用 |
| 纯软件 |
100%(算法本身) |
| 硬件轮询 |
100%(自旋等待) |
| 硬件中断 |
100%(中断链饿死主循环,见 5.3 ③) |
| 硬件 DMA |
26.4% / 25.4%(SHA-256),28.1% / 26.6%(SHA-512) |
DMA 模式下 75% 的算力是空闲的——1KB 小尺寸时占用升到 46%(启动开销占比高),随尺寸增大递减。这意味着哈希可以和业务逻辑真并行:实测 DMA 哈希 256KB 的 2.1ms 里,主循环能跑完数万次空转迭代。
顺带一提:DMA 期间被占的 25% 也主要是 HAL_HASH_Start_DMA 的软件开销(MDMAT 分块 8 次重配 + 状态轮询),不是 DMA 引擎本身——真正的传输 CPU 完全不参与。
5.6 理论预算对照
拿 1.1 节的理论上限对照实测(256KB 档):
|
SHA-256 |
SHA-512 |
| 理论上限(压缩引擎) |
242 MB/s |
326 MB/s |
| DMA 实测 |
122.1 MB/s |
141.6 MB/s |
| 预算达成率 |
50% |
43% |
一半的差距从哪来?压缩引擎不是瓶颈(5.2 已证明 CPU 都能喂到 55 MB/s),差距在喂数通道:当前 GPDMA 配置是单 beat 握手(BlkHWRequest = Single,每次 HASH 请求搬一个字),每字都有一次总线仲裁与握手周期。改进方向是把 GPDMA 突发长度调到 4(HASH FIFO 恰好支持 4 字固定突发),理论上可显著逼近上限——这留作下一篇的优化实验。轮询/中断路径的 55 MB/s 天花板同理:CPU 写 DIN + FIFO 满等待,总线效率有限。
六、结果讨论
6.1 加速比汇总
全部路径稳态吞吐(256KB,250MHz,-O3):
| 路径 |
SHA-256 |
加速比 |
SHA-512 |
加速比 |
CPU 占用 |
| 软件(标准 C) |
4.2 MB/s |
1× |
2.2 MB/s |
1× |
100% |
| 硬件轮询 |
55.5 MB/s |
13× |
54.2 MB/s |
25× |
100% |
| 硬件中断 |
38.4 MB/s |
9× |
44.4 MB/s |
20× |
100% |
| 硬件 DMA |
122.1 MB/s |
29× |
141.6 MB/s |
64× |
~25% |
三个应用层结论:
- 固件签名/小数据校验:直接轮询。代码最简、稳态 55 MB/s,验一个 2MB 固件只需 37ms(纯软件要 476ms),连软件库都省了
- 日志/流式大流量:必须 DMA。吞吐是轮询的 2.2 倍,且 75% CPU 空闲给业务
- 中断模式慎用:吞吐低于轮询、CPU 一点不省,除非 RTOS 场景刻意要异步编程模型
6.2 坑点总结
工程坑点汇总(按踩坑顺序,全部实测复现):
- CubeMX 默认栈 1KB 不够用:SHA-512 压缩函数的
W[80] 消息扩展数组就要 640 字节栈,叠加调用链与 HAL 必然打爆 1KB 栈底,症状是 SHA-512 必现 HardFault(CFSR 显示 STKERR)而 SHA-256 正常——迷惑性极强。StackSize 改 0x2000 解决
- 模板 Release 默认 -Os:CubeMX 的 CMake 模板按尺寸优化编译,软件基线和 HAL 喂数路径都被拖慢(实测轮询 47.5 → 55.5 MB/s),跑分对比前必须统一 -O3
- DMA 源地址须字对齐、GPDMA 单块 65535 字节上限、HAL 错误路径泄漏 DMA 句柄锁——详见 5.4 的 DMA 三坑
- 算法切换必须重新 HAL_HASH_Init——只改
Init.Algorithm 不生效,算出来还是旧算法的结果
- 中断模式的 100% 占用是机制性的(优先级 0 中断尾链饿死主循环),不是配置失误
6.3 应用与选型建议
回到芯片定位。这颗 HASH 外设在 H5E5 的安全版图里只是三分之一:它的兄弟 PKA(公钥加速器,ECDSA 专用)和 RNG(NIST SP800-90B 熵源)本篇没测。选型视角:
- H5E5 的 HASH 性价比很高:SHA-2 全系 + SHA-3 + HMAC,DMA 路径 122~142 MB/s,覆盖固件校验和大部分通信场景绰绰有余
- 但 H5E5 没有 AES 加速器(SAES/AES1/AES2 均无):TLS 记录层的对称加密只能软件,要做全链路硬件 TLS 得上 H5F5 或 H563
- SHA-3 硬件已具备、HAL 未跟上(FW_H5 V1.7.0 无 API),早期采用者需要寄存器级开发
对本板玩家:HASH 外设的入门成本极低(HAL_HASH_Start 一个函数),收益却是最高 64× 的加速比加 75% 的 CPU 空闲——这笔账怎么算都划算。
七、参考资料




 微信公众号
 手机版