【NUCLEO-H5E5ZJ评测】ThreadX 移植实录:从 CubeMX 到双线程
[TOC]
上一篇《CoreMark 移植实录》在这块 NUCLEO-H5E5ZJ 上跑出了 700.89 分的裸机成绩。本篇更进一步:通过 CubeMX 的 Middleware 启用 ThreadX 实时操作系统,在 Project Manager → Thread safe settings 中启用多线程支持并选择加锁策略,生成 CMake 工程,最后创建两个线程,分别以 500ms、1000ms 周期无限循环打印线程名称与计数,并在串口上验证双线程的调度节奏。
全程命令行构建(STM32CubeCLT 1.22 + CMake + Ninja + GCC 14.3.1),CubeMX 6.18.1 完成配置与代码生成。完整工程代码见文末仓库,git 记录了从 ioc 到成品的全过程。
一、准备工作
1.1 ThreadX 简介
ThreadX 是 Eclipse 基金会旗下的 Eclipse ThreadX(原 Azure RTOS,微软 2019 年开源、2023 年捐赠给 Eclipse),一个体积小、确定性强、免认证费(Safety/Cryptography 认证包免费提供)的嵌入式 RTOS。它的核心特点:
- Picokernel™ 架构:内核服务不嵌套,中断延迟、上下文切换时间均为确定值;
- 无运行时开销的按需加载:未使用的内核 API 不参与链接,最小内核仅 2KB 左右 Flash;
- 优先级抢占式调度 + 可选抢占阈值(preemption-threshold):可以在创建线程时限制被同优先级及更低优先级线程抢占,减少不必要的上下文切换与抖动。
在 STM32 生态里,ThreadX 以固件包内置 Middleware 的形式提供(CubeMX 的 Middleware and Software Packs 分类下直接可见),不需要像 FreeRTOS-H7 那样额外安装 X-CUBE 扩展包。
1.2 实验目标
在上一线程实验开始前,本文的工程基线直接复用上一篇成果:
- 时钟:**HSE 48MHz 晶振 → PLL(M=12, N=125, P=2)→ SYSCLK 250MHz**(板上 X2 48MHz 晶振 @ PH0/PH1,坑点分析见上一篇);
- 串口:板载 ST-LINK VCP(USART3,PD8/PD9,115200-8-N-1),printf 经 BSP 的
__io_putchar 直接可用;
- 调试:SWD(PA13/PA14)。
在此基础上启用 ThreadX,创建两个线程并验证调度。
1.3 工程组织
与上一篇一致,目录分为两半:
- STM32H5E5-ThreadX-Code:只放代码(ioc + CubeMX 生成的 CMake 工程 + 应用代码),git 管理;
- STM32H5E5-ThreadX-Test:放本篇文稿与截图。
二、项目骨架
2.1 CubeMX 启用 THREADX
ThreadX 在 CubeMX 里是固件包内置的 Middleware IP:Pinout & Configuration 左侧 Middleware and Software Packs 分类下,THREADX 项已经出现(带版本勾选标记)。启用方式与外设一致——点击后在面板中确认核心配置:
- Generate initialization code:勾选(生成
MX_ThreadX_Init() 与内核入口);
- Application Thread Creation:勾选(让 CubeMX 自动生成一个示例线程的创建代码);
- Application memory pool size:
3 * 1024(静态字节池,供内核对象/线程栈分配)。

通过参数自动生成的线程命名为 Thread_500ms(入口 Thread500ms_Entry,优先级 2)——本实验的第一个线程完全由 GUI 配置产生。
2.2 Thread-safe 设置
这是本篇最重要的一个配置点。CubeMX 生成的 HAL 库内部有若干非可重入的锁(__HAL_LOCK 宏、newlib 的 malloc/free 堆锁等),裸机下它们形同虚设,上了 RTOS 之后必须给这些锁一个多线程安全的实现,否则两个线程同时触碰 HAL/堆就会踩出诡异问题。
在 Project Manager → Thread-safe Settings 中:
- 勾选 Enable multi-threaded support;
- Thread-safe Locking Strategy 选择 Default – Mapping suitable strategy depending on RTOS selection——按 RTOS 选择自动映射的策略。

Default 策略在 ThreadX 工程里最终落为编译宏 STM32_THREAD_SAFE_STRATEGY=2——对照生成的 stm32_lock.h,即 Generic Strategy #2:基于关中断的临界区实现,允许在中断中使用锁。同时 CubeMX 生成 newlib_lock_glue.c / stm32_lock.h 一对胶水文件,把 newlib 的堆锁挂到这套抽象上——这是很多人上 RTOS 后 malloc 偶发损坏却找不到原因的解药。
2.3 代码生成
Toolchain/IDE 选 CMake 后 GENERATE CODE。生成的工程关键内容:
STM32H5E5-ThreadX/
├── AZURE_RTOS/App/            # app_azure_rtos.c(字节池与对象定义)
├── Core/Src/
│   ├── main.c                 # MX_ThreadX_Init() 调用
│   ├── app_threadx.c          # 线程创建 + 线程入口(USER CODE 区)
│   ├── tx_initialize_low_level.S   # SysTick/中断栈等底层初始化
│   └── stm32h5xx_hal_timebase_tim.c # HAL 时基 = TIM6(!)
├── Middlewares/ST/threadx/    # ThreadX 内核(common + cortex_m33/gnu 移植层)
├── newlib_lock_glue.c         # newlib 堆锁 ↔ STM32 锁抽象胶水
└── stm32_lock.h               # 多线程锁抽象(策略 1~5)
几个值得注意的生成细节:
- HAL 时基被自动挪到 TIM6:ThreadX 的调度 tick 接管了 SysTick,HAL 的
HAL_GetTick()/HAL_Delay() 改由 TIM6 中断驱动(优先级 15,最低),SysTick 优先级被降为 14——避免高优先级中断抢占调度器;
- PendSV/SVCall/SysTick 异常处理函数由 ThreadX 移植层提供,CubeMX 不再生成;
- 内核 tick 频率 100Hz(
tx_initialize_low_level.S 中 SYSTICK_CYCLES = SYSTEM_CLOCK / 100),即 1 tick = 10ms。
2.4 一个必踩的坑:固件包子模块
用 GitHub 克隆方式获取固件包的话(本文环境如此),首次构建会直接报错:
CMake Error at cmake/stm32cubemx/CMakeLists.txt:260 (target_sources):
  Cannot find source file:
    .../Middlewares/ST/threadx/ports/cortex_m33/gnu/src/tx_thread_context_restore.S
工程里 Middlewares/ST/threadx 是空目录——与上一篇 BSP 缺失同根同源:固件包里 ThreadX/FileX/USBX/NetXDuo 等中间件全部是 git 子模块,CubeMX 生成时从固件包拷贝内核源码,子模块没拉齐就只会拷出一个空壳。补齐子模块(国内网络需代理):
cd ~/STM32Cube/Repository/STM32Cube_FW_H5_V1.7.0
git -c http.proxy=http://127.0.0.1:7890 submodule update --init --depth 1 \
  Middlewares/ST/threadx
然后重新生成,内核源码(common/src 185 个文件 + ports/cortex_m33/gnu/src 17 个文件)被正确拷入工程。
2.5 构建验证
cmake --preset Release
cmake --build build\Release
构建 197 个目标全部通过、零告警:FLASH 26780 B / RAM 8376 B。ThreadX 内核 + 双线程应用的全部开销不到 27KB——Picokernel 的体积优势名副其实。
三、双线程实验
3.1 线程代码
两个线程采用两种创建方式,正好覆盖 CubeMX + ThreadX 的两种典型用法:
线程一(Thread_500ms):完全由 CubeMX 参数生成。App_ThreadX_Init() 中由 CubeMX 自动生成创建代码,栈从 3KB 字节池分配(TX_APP_STACK_SIZE=512),优先级 2。我们只需填充它的入口函数:
void Thread500ms_Entry(ULONG thread_input)
{
  /* USER CODE BEGIN Thread500ms_Entry */
  uint32_t count = 0;
  for (;;)
  {
    printf("[Thread_500ms] hello %lu\r\n", count++);
    tx_thread_sleep(50);  /* 100Hz tick:50 tick = 500ms */
  }
  /* USER CODE END Thread500ms_Entry */
}
线程二(Thread_1000ms):在 app_threadx.c 的 USER CODE 区手动创建,静态线程控制块 + 静态栈,不经字节池:
/* USER CODE BEGIN PV */
static TX_THREAD tx_thread_1000ms;
static UCHAR thread_1000ms_stack[1024];
/* USER CODE END PV */

/* USER CODE BEGIN App_ThreadX_Init */
if (tx_thread_create(&tx_thread_1000ms, "Thread_1000ms", Thread1000ms_Entry, 0,
                     thread_1000ms_stack, sizeof(thread_1000ms_stack),
                     3, 3, TX_NO_TIME_SLICE, TX_AUTO_START) != TX_SUCCESS)
{
  ret = TX_THREAD_ERROR;
}
/* USER CODE END App_ThreadX_Init */

/* USER CODE BEGIN 1 */
static void Thread1000ms_Entry(ULONG thread_input)
{
  uint32_t count = 0;
  for (;;)
  {
    printf("[Thread_1000ms] hello %lu\r\n", count++);
    tx_thread_sleep(100);  /* 100Hz tick:100 tick = 1000ms */
  }
}
/* USER CODE END 1 */
两个线程的时延都用 tx_thread_sleep() 实现——线程让出 CPU,由 ThreadX tick 唤醒,与裸机 HAL_Delay() 的忙等有本质区别:等待期间 CPU 可以跑别的线程或进入低功耗。
另外在 main.c 的 USER CODE 区、MX_ThreadX_Init() 之前打印系统时钟横幅(此时 BSP COM 已初始化):
printf("\r\n[STM32H5E5-ThreadX] System Clock: %lu Hz\r\n", SystemCoreClock);
printf("[STM32H5E5-ThreadX] ThreadX RTOS demo (two threads: 500ms / 1000ms)\r\n");
3.2 串口验证
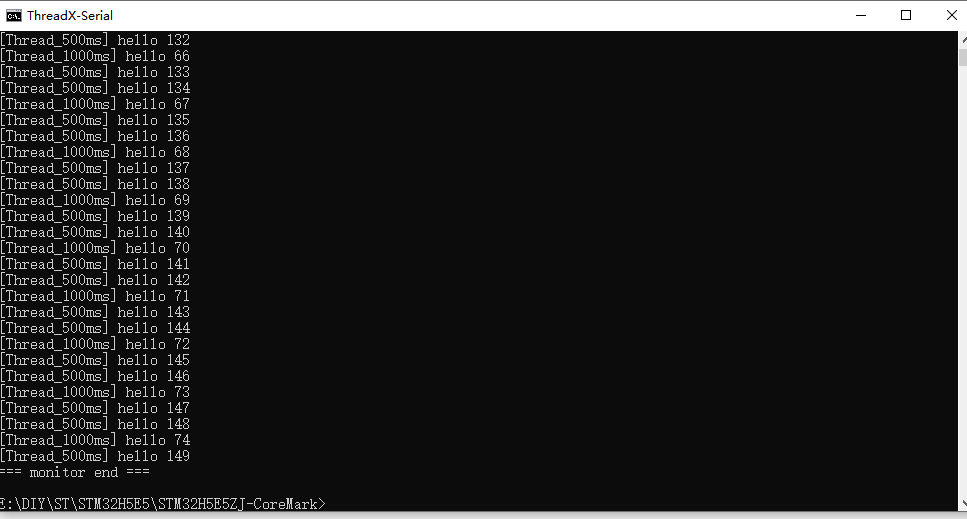
烧录(STM32_Programmer_CLI -c port=SWD -d xxx.elf)后用 pyserial 打开 COM29 复位监听,串口输出:

[Thread_500ms] hello 132
[Thread_1000ms] hello 66
[Thread_500ms] hello 133
[Thread_500ms] hello 134
[Thread_1000ms] hello 67
[Thread_500ms] hello 135
...
四、结果讨论
调度节奏精确 2:1。 每打印 2 行 Thread_500ms 恰好插入 1 行 Thread_1000ms(hello 计数 132↔66、133↔67……严格对半),两个线程的计数器随时间同步增长——ThreadX 的 tick 调度没有漂移,tx_thread_sleep 的周期精确到 tick(10ms)粒度。
为什么输出不会串行化交叠? 两个线程共用 printf → 轮询式 HAL_UART_Transmit。一行约 25 字节 @115200bps ≈ 2.2ms,小于 1 个 tick(10ms);且两个线程的唤醒相位都落在 5 tick 的整数倍上,调度时序天然错开。当然这是"恰好安全"——生产代码里多个线程共享同一个 UART 输出,应该用 TX_MUTEX 保护或者走队列汇总到单一打印线程。
Thread-safe 策略的实际含义。 Default 策略在本工程映射为 STM32_THREAD_SAFE_STRATEGY=2(关中断式临界区、允许中断内加锁)。它不是 ThreadX 原生 API 实现的锁——对 HAL 这种"临界区极短"的场景,关中断的开销反而小于内核 mutex。这印证了 CubeMX 那句 "Mapping suitable strategy depending on RTOS selection":Default 不是敷衍选项,而是按 RTOS 与 HAL 使用模式给出的工程默认值。若应用需要在中断里频繁使用 HAL 且临界区较长,可再评估 Generic #3(deny from interrupts)或自定义策略 #1。
HAL 时基迁移是 RTOS 工程的隐形关键点。 启用 ThreadX 后 SysTick 归调度器所有,HAL 时基自动改挂 TIM6。如果手工建工程时忽略了这一步(保留 SysTick 给 HAL),会出现 tick 冲突、HAL_Delay 卡死或调度抖动等疑难杂症——CubeMX 自动处理了这一切。
两种线程创建方式的选择。 字节池分配(CubeMX 默认)省心但引入分配失败的可能性;静态分配(本文线程二)则把内存预算完全静态化,更适合安全关键场景。ThreadX 两者都支持,且可以在同一工程里混用。
五、参考资料
本文完整工程代码(ioc + CubeMX 生成的 CMake 工程 + 双线程应用):
https://gitcode.com/xusiwei1236/STM32H5E5-ThreadX
仓库以 git 管理,从 ioc 创建、ThreadX 子模块排障到双线程实现的完整变更历史都在仓库提交记录中,可逐一回溯。
参考链接:
- Eclipse ThreadX 官方文档:https://eclipse-threadx.github.io/
- ThreadX 用户手册(内核服务):https://github.com/eclipse-threadx/threadx
- STM32CubeH5 固件包(GitHub):https://github.com/STMicroelectronics/STM32CubeH5
- 上一篇:【NUCLEO-H5E5ZJ评测】CoreMark 移植实录
- NUCLEO-H5E5ZJ 原理图(ST-LINK VCP 与 USART3 连接关系)




 微信公众号
 手机版