




|
前言 本文主要讲解什么是Linux内核,以及通过多张图片展示Linux内核的作用与功能,以便于读者能快速理解什么是Linux内核,能看懂Linux内核。 拥有超过1300万行的代码,Linux内核是世界上最大的开源项目之一,但是内核是什么,它用于什么?) x9 s% K+ a' a$ x6 ~( y$ v z2 s) K8 P5 Z9 M) o* S 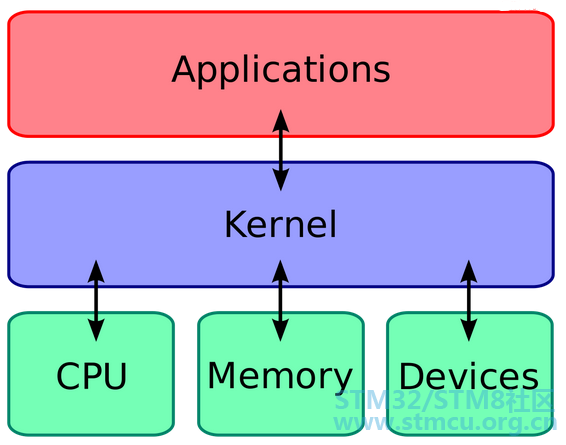
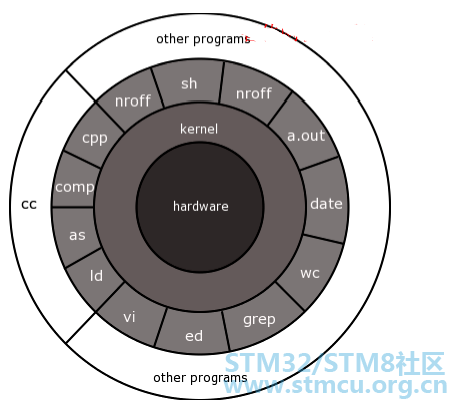
02 什么是内核 内核是与计算机硬件接口的易替换软件的最低级别。它负责将所有以“用户模式”运行的应用程序连接到物理硬件,并允许称为服务器的进程使用进程间通信(IPC)彼此获取信息。 03 内核还要分种类? 是的,没错。3.1 微内核 7 j1 W9 n7 m! @6 O8 _- m) ? 微内核只管理它必须管理的东西:CPU、内存和IPC。计算机中几乎所有的东西都可以被看作是一个附件,并且可以在用户模式下处理。微内核具有可移植性的优势,因为只要操作系统仍然试图以相同的方式访问硬件,就不必担心您是否更改了视频卡,甚至是操作系统。微内核对内存和安装空间的占用也非常小,而且它们往往更安全,因为只有特定的进程在用户模式下运行,而用户模式不具有管理员模式的高权限。8 @9 |. \2 T: O/ i7 |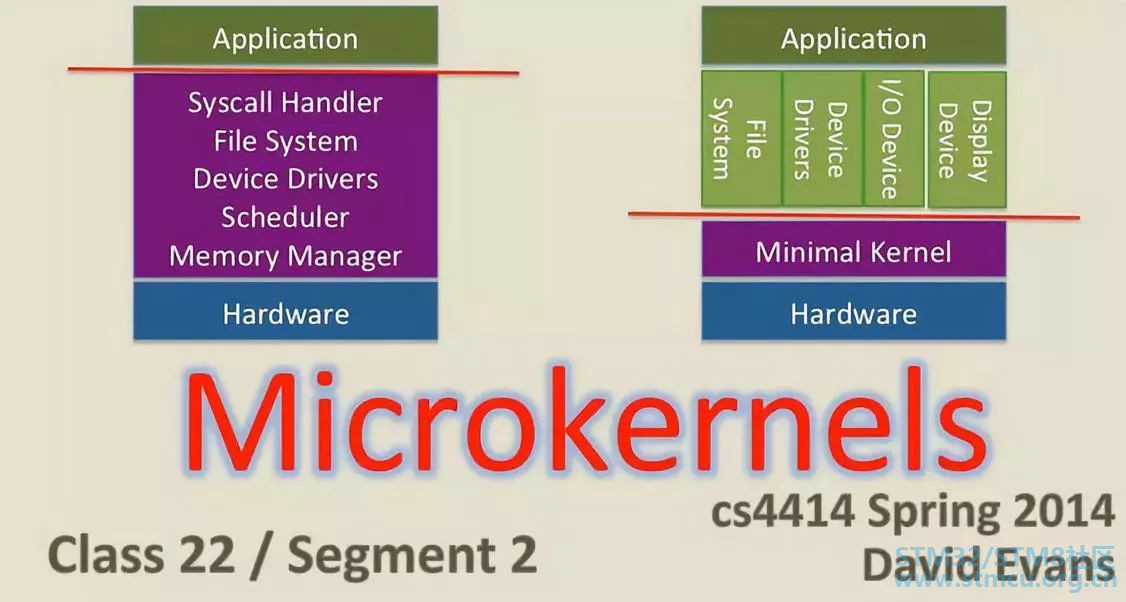
3.1.1 Pros
3.1.2 Cons
3.2 单内核 9 n H$ t+ Q/ ]7 n 单内核与微内核相反,因为它们不仅包含CPU、内存和IPC,而且还包含设备驱动程序、文件系统管理和系统服务器调用等内容。单内核更擅长于访问硬件和多任务处理,因为如果一个程序需要从内存或运行中的其他进程中获取信息,那么它就有一条更直接的线路来访问信息,而不需要在队列中等待来完成任务。但是,这可能会导致问题,因为在管理模式下运行的东西越多,如果行为不正常,就会有越多的东西导致系统崩溃。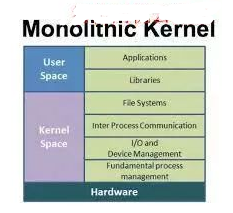
3.2.2 Cons . E7 \2 p, h) @! }# U2 R8 W0 K
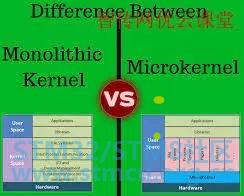
. q8 N. t0 A! p' [1 y( ^ 04 混合的内核 混合内核能够选择在用户模式下运行什么,以及在管理模式下运行什么。通常情况下,设备驱动程序和文件系统I/O将在用户模式下运行,而IPC和服务器调用将保持在管理器模式下。这是两全其美,但通常需要硬件制造商做更多的工作,因为所有驱动程序的责任都由他们来承担。它还可能存在一些与微内核固有的延迟问题。 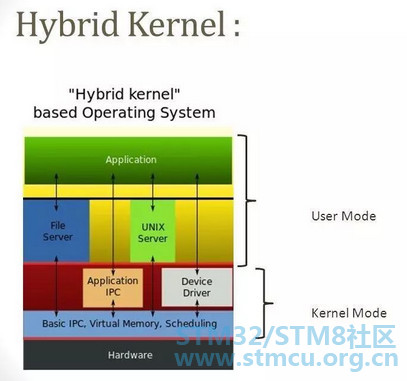
4.1 Pros / r q3 L. S- e2 K4 g" X; d
4.2 Cons
05 Linux内核文件在哪里 Ubuntu中的内核文件存储在/boot文件夹中,称为vmlinux -version。vmlinuz这个名字来自于unix世界,早在60年代,他们就把内核简单地称为“unix”,所以当内核在90年代首次开发时,Linux就开始把内核称为“Linux”。 - m+ J% X* x; \ 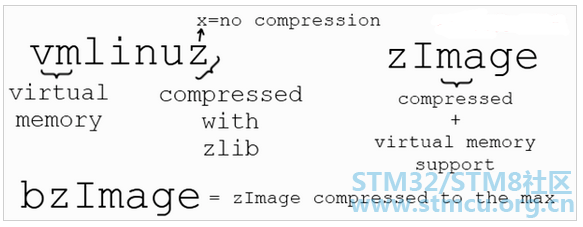
$ D' s' x2 y% ]$ o' j4 ~ 当开发虚拟内存以便更容易地进行多任务处理时,将“vm”放在文件的前面,以显示内核支持虚拟内存。有一段时间,Linux内核被称为vmlinux,但是内核变得太大,无法装入可用的引导内存,因此压缩了内核映像,并将末尾的x更改为z,以显示它是用zlib压缩的。并不总是使用相同的压缩,通常用LZMA或BZIP2替换,一些内核简单地称为zImage。# J' q7 s/ i+ u$ |+ m4 y! L6 K6 N4 z1 f* T 版本号将采用A.B.C.格式D在。B可能是2.6,C是您的版本,D表示您的补丁或补丁。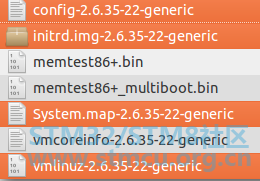
. M+ M. R( P, X 在/boot文件夹中还有其他非常重要的文件,称为initrd.img-version、system.map-version, config-version。initrd文件用作一个小RAM磁盘,用于提取和执行实际的内核文件。这个系统。map文件用于内核完全加载之前的内存管理,配置文件告诉内核在编译内核映像时要加载哪些选项和模块。06 Linux内核体系结构 ) C2 S# I- n# ]# R; i5 s因为Linux内核是单片的,所以它比其他类型的内核占用空间最大,复杂度也最高。这是一个设计特性,在Linux早期引起了相当多的争论,并且仍然带有一些与单内核固有的相同的设计缺陷。 - g; L g; R* g W% J( D C 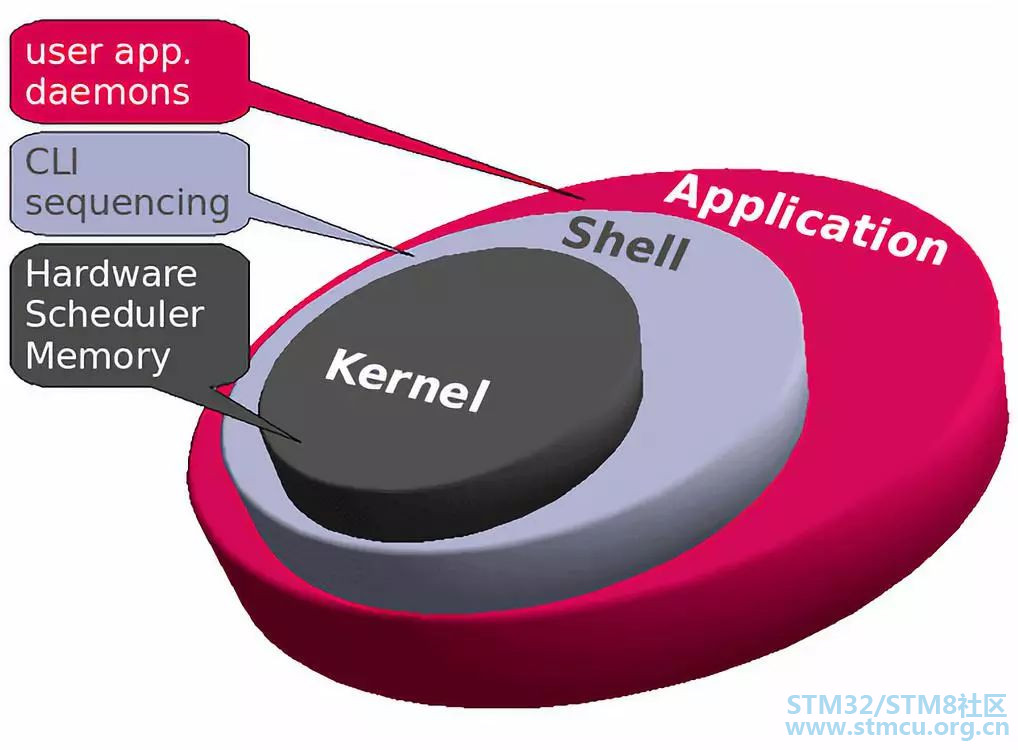
9 P! V! L! ]8 m! d" w 为了解决这些缺陷,Linux内核开发人员所做的一件事就是使内核模块可以在运行时加载和卸载,这意味着您可以动态地添加或删除内核的特性。这不仅可以向内核添加硬件功能,还可以包括运行服务器进程的模块,比如低级别虚拟化,但也可以替换整个内核,而不需要在某些情况下重启计算机。. p( [& M2 H$ Z: b1 L 想象一下,如果您可以升级到Windows服务包,而不需要重新启动……4 L. f! p- f& v$ g- F- h 07 内核模块 如果Windows已经安装了所有可用的驱动程序,而您只需要打开所需的驱动程序怎么办?这本质上就是内核模块为Linux所做的。内核模块,也称为可加载内核模块(LKM),对于保持内核在不消耗所有可用内存的情况下与所有硬件一起工作是必不可少的。* p! X. X! l% J" Y* k. J1 f 9 ]8 p: q* O0 r3 O; `$ _+ S( P0 M . ^& l. D; [3 ~, f3 m# L, U
6 l9 j/ i( Q/ u. O! Q 模块通常向基本内核添加设备、文件系统和系统调用等功能。lkm的文件扩展名是.ko,通常存储在/lib/modules目录中。由于模块的特性,您可以通过在启动时使用menuconfig命令将模块设置为load或not load,或者通过编辑/boot/config文件,或者使用modprobe命令动态地加载和卸载模块,轻松定制内核。, ? H1 B* p( d- C$ G( a 第三方和封闭源码模块在一些发行版中是可用的,比如Ubuntu,默认情况下可能无法安装,因为这些模块的源代码是不可用的。该软件的开发人员(即nVidia、ATI等)不提供源代码,而是构建自己的模块并编译所需的.ko文件以便分发。虽然这些模块像beer一样是免费的,但它们不像speech那样是免费的,因此不包括在一些发行版中,因为维护人员认为它通过提供非免费软件“污染”了内核。08 Linux 内核学习经验总结 4 S5 A$ w. `" b$ e( y8 t |, B 开篇. x8 u. H& Y- p. w( \2 d 学习内核,每个人都有自己的学习方法,仁者见仁智者见智。以下是我在学习过程中总结出来的东西,对自身来说,我认为比较有效率,拿出来跟大家交流一下。9 a% g' _ }' z& e8 @* M4 y 我在大二的时候刚开始接触内核,就犯了这个错误,一头扎到内存管理里头,去看非常底层的实现代码,虽然也是建立在内存管理的设计思想的基础上,但是相对来说,比较孤立,因为此时并没有学习其它子系统,应该说无论是视野还是思想,都比较狭隘,所以代码中牵涉到的其它子系统的实现我都直接跳过了,这一点还算聪明,当然也是迫不得已的。+ h* F( h' u2 [ 我的学习方法" I6 W0 q; o9 s 根据自己的学习经验,刚开始学习内核的时候,我认为要做的是在自己的脑海中建立起内核的大体框架,理解各个子系统的设计理念和构建思想,这些理念和思想会从宏观上呈献给你清晰的脉络,就像一个去除了枝枝叶叶的大树的主干,一目了然;当然,肯定还会涉及到具体的实现方法、函数,但是此时接触到的函数或者方法位于内核实现的较高的层次,是主(要)函数,已经了解到这些函数,针对的是哪些设计思想,实现了什么样的功能,达成了什么样的目的,混个脸熟的说法在这儿也是成立的。至于该主函数所调用的其它的辅助性函数就等同于枝枝叶叶了,不必太早就去深究。此时,也就初步建立起了内核子系统框架和代码实现之间的关联,关联其实很简单,比如一看到某个函数名字,就想起这个函数是针对哪个子系统的,实现了什么功能。 m( p$ | s* b2 t0 K: u6 T 我学习的时候是三本书交叉着看的,先看LKD3,专于一个子系统,主要就是了解设计的原理和思想,当然也会碰到对一些主要函数的介绍,但大多就是该函数基于前面介绍的思想和原理完成了什么样的功能,该书并没有就函数本身的实现进行深入剖析。然后再看ULK3和PLKA上看同样的子系统,但是并不仔细分析底层具体函数的代码,只是粗略地、不求甚解地看,甚至不看。因为,有些时候,在其中一本书的某个点上,卡壳了,不是很理解了,在另外的书上你可能就碰到对同一个问题的不同角度的描述,说不准哪句话就能让你豁然开朗,如醍醐灌顶。我经常碰到这种情况。# [. m8 n) x# J# n" b) q: @# L6 c 并不是说学习过程中对一些函数体的实现完全就忽略掉,只要自己想彻底了解其代码实现,没有谁会阻止你。我是在反复阅读过程中慢慢深入的。比如VFS中文件打开需要对路径进行分析,需要考虑的细节不少(.././之类的),但是其代码实现是很好理解的。再比如,CFS调度中根据shedule latency、队列中进程个数及其nice值(使用的是动态优先级)计算出分配给进程的时间片,没理由不看的,这个太重要了,而且也很有意思。) N3 j9 S; @1 j7 ]1 d PLKA介于LKD3和ULK3之间。我觉得PLKA的作者(看照片,真一德国帅小伙,技术如此了得)肯定看过ULK,无论他的本意还是有意,总之PLKA还是跟ULK有所不同,对函数的仔细讲解都做补充说明,去掉函数体中边边角角的情况,比如一些特殊情况的处理,有效性检查等,而不妨碍对整个函数体功能的理解,这些他都有所交代,做了声明;而且,就像LKD3一样,在某些点上也给出了指导性编程建议。作者们甚至对同一个主要函数的讲解的着重点都不一样。这样的话,对我们学习的人而言,有助于加深理解。另外,我认为很重要的一点就是PLKA针对的2.6.24的内核版本,而ULK是2.6.11,LKD3是2.6.34。在某些方面PLKA比较接近现代的实现。其实作者们之所以分别选择11或者24,都是因为在版本发行树中,这两个版本在某些方面都做了不小的变动,或者说是具有标志性的转折点(这些信息大多是在书中的引言部分介绍的,具体的细节我想不起来了)。" [, I3 S+ i# s8 R9 e2 F 在读书过程中,会产生相当多的疑问,这一点是确信无疑的。大到搞不明白一个设计思想,小到不理解某行代码的用途。各个方面,各种疑问,你完全可以把不理解的地方都记录下来(不过,我并没有这么做,没有把疑问全部记下来,只标记了很少一部分我认为很关键的几个问题),专门写到一张纸上,不对,一个本上,我确信会产生这么多的疑问,不然内核相关的论坛早就可以关闭了。其实,大部分的问题(其中很多问题都是你知道不知道有这么一回事的问题)都可以迎刃而解,只要你肯回头再看,书读百遍,其义自现。多看几遍,前前后后的联系明白个七七八八是没有问题的。我也这么做了,针对某些子系统也看了好几遍,切身体会。' Z. |5 n( |2 ^; t. Z I 当你按顺序学习这些子系统的时候,前面的章节很可能会引用后面的章节,就像PLKA的作者说的那样,完全没有向后引用是不可能的,他能做的只是尽量减少这种引用而又不损害你对当前问题的理解。不理解,没关系,跳过就行了。后面的章节同样会有向前章节的引用,不过这个问题就简单一些了 ,你可以再回头去看相应的介绍,当时你不太理解的东西,很可能这个时候就知道了它的设计的目的以及具体的应用。不求甚解只是暂时的。比如说,内核各个子系统之间的交互和引用在代码中的体现就是实现函数穿插调用,比如你在内存管理章节学习了的内存分配和释放的函数,而你是了解内存在先的,在学习驱动或者模块的时候就会碰到这些函数的调用,这样也就比较容易接受,不至于太过茫然;再比如,你了解了系统时间和定时器的管理,再回头看中断和异常中bottom half的调度实现,你对它的理解就会加深一层。5 e& @! A( |" V9 G6 q' ?% C% t6 O% f, J 等我们完成了建立框架这一步,就可以选择一个比较感兴趣的子系统,比如驱动、网络,或者文件系统之类的。这个时候你再去深入了解底层代码实现,相较于一开始就钻研代码,更容易一些,而且碰到了不解之处,或者忘记了某个方面的实现,此时你完全可以找到相应的子系统,因为你知道在哪去找,查漏补缺,不仅完成了对当前函数的钻研,而且可以回顾、温习以前的内容,融会贯通的时机就在这里了。* b p" R, d' q. M 《深入理解linux虚拟内存》(2.4内核版本),LDD3,《深入理解linux网络技术内幕》,几乎每一个子系统都需要一本书的容量去讲解,所以说,刚开始学习不宜对某个模块太过深入,等对各个子系统都有所了解了,再有针对性的去学习一个特定的子系统。这时候对其它系统的援引都可以让我们不再感到茫然、复杂,不知所云。 b4 P# }* g ~5 n( h/ l 比如,LDD3中的以下所列章节:构造和运行模块,并发和竞态,时间、延迟及延缓操作,分配内存,中断处理等,都属于驱动开发的支撑性子系统,虽说本书对这些子系统都专门开辟一个章节进行讲解,但是详细程度怎么能比得上PLKA,ULK3,LKD3这三本书,看完这三本书,你会发现读LDD3这些章节的时候简直跟喝白开水一样,太随意了,因为LDD3的讲解比之LKD3更粗略。打好了基础,PCI、USB、TTY驱动,块设备驱动,网卡驱动,需要了解和学习的东西就比较有针对性了。这些子系统就属于通用子系统,了解之后,基于这些子系统的子系统的开发—驱动(需进一步针对硬件特性)和网络(需进一步理解各种协议)—相对而言,其学习难度大大降低,学习进度大大加快,学习效率大大提升。说着容易做来难。达到这样一种效果的前提就是:必须得静下心来,认真读书,要看得进去,PLKA,ULK3厚得都跟砖头块儿一样,令人望之生畏,如果没有兴趣,没有热情,没有毅力,无论如何都是不行,因为需要时间,需要很长时间。我并不是说必须打好了基础才可以进行驱动开发,只是说打好了基础的情况下进行开发会更轻松,更有效率,而且自己对内核代码的驾驭能力会更强大。这只是我个人见解,我自己的学习方式,仅供参考。% {8 R% H3 F# W. [; ?6 R% G “比起知道你所用技术的重要性,成为某一个特别领域的专家是不重要的。知道某一个具体API调用一点好处都没有,当你需要他的时候只要查询下就好了。”这句话源于我看到的一篇翻译过来的博客。我想强调的就是,这句话针应用型编程再合适不过,但是内核API就不完全如此。( D) E( h8 q6 x; n' k( R 当你了解了操作系统的实现—这些实现可都是对应用程序的基础性支撑啊—你再去写应用程序的时候,应用程序中用到的多线程,定时器,同步锁机制等等等等,使用共享库API的时候,联系到操作系统,从而把对该API的文档描述同自己所了解到的这些方面在内核中的相应支撑性实现结合起来进行考虑,这会指导你选择使用哪一个API接口,选出效率最高的实现方式。对系统编程颇有了解的话,对应用编程不无益处,甚至可以说是大有好处。 h% Q0 x. B r9 ~. U& A 设计实现的本质,知道还是理解" ], f; T9 r9 C( w9 U- a" s 操作系统是介于底层硬件和应用软件之间的接口,其各个子系统的实现很大程度上依赖于硬件特性。书上介绍这些子系统的设计和实现的时候,我们读过了,也就知道了,如果再深入考虑一下,为什么整体架构要按照这种方式组织,为什么局部函数要遵循这样的步骤处理,知其然,知其所以然,如果你知道了某个功能的实现是因为芯片就是这么设计的,CPU就是这么做的,那么你的疑问也就基本上到此为止了。再深究,就是芯片架构方面的设计与实现,对于程序员来讲,无论是系统还是应用程序员,足迹探究到这里,已经解决了很多疑问,因为我们的工作性质偏软,而这些东西实在是够硬。8 Q" Y8 t( S$ v2 {* ^' b& y9 R' u8 {( M 比如,ULK3中讲解的中断和异常的实现,究其根源,那是因为Intel x86系列就是这么设计的,去看看Intel V3手册中相应章节介绍,都可以为ULK3中描述的代码实现方式找到注解。还有时间和定时器管理,同样可以在Intel V3 对APIC的介绍中获取足够的信息,操作系统就是依据这些硬件特性来实现软件方法定义的。8 l2 U! N3 M0 r$ J 又是那句话,不是理解不理解的问题,而是知道不知道的问题。有时候,知道了,就理解了。在整个学习过程中,知道,理解,知道,理解,知道……,交叉反复。为什么开始和结尾都是知道,而理解只是中间步骤呢?世界上万事万物自有其规律,人类只是发现而已,实践是第一位的,实践就是知道的过程,实践产生经验,经验的总结就是理论,理论源于实践,理论才需要理解。我们学习内核,深入研究,搞来搞去,又回到了芯片上,芯片是物质的,芯片的功用基于自然界中物质本有的物理和电子特性。追本溯源,此之谓也。* {5 h% Y; D/ |( G6 Y" R! q* C 纸上得来终觉浅,绝知此事要躬行。只看书是绝对不行的,一定要结合课本给出的编程建议自己敲代码。刚开始就以模块形式测试好了,或者自己编译一个开发版本的内核。一台机器的话,使用UML方式调试,内核控制路走到哪一步,单步调试看看程序执行过程,比书上的讲解更直观明了。一定要动手实际操作。! A5 [1 x% W% x: T2 r" _9 B 参考书! o" A8 ]0 k5 [8 x3 p LDD3 Linux Device Driver 3rdLKD3 Linux Kernel Development 3rdULK3 Understanding the Linux Kernel 3rdPLKA Professional Linux Kernel ArchitectureUML User Mode LinuxIntel V3 Intel? 64 and IA-32 Architectures Software Developer’s Manual Volume 3 (3A, 3B & 3C): System Programming GuideMany of the key control paths in the kernel are described, step by step; ' ]2 Y; A" Q; b$ J 这几句话对本书的描述非常到位。基于此,作为指导性原则,我们就可以很有效率地使用它了。- e Z5 f/ _, u 结尾8 M, j* x$ W; R A% [ Linux,我的兴趣,我的动力,我的方向,我的未来! |
 微信公众号
 手机版


