




int ni = n*i;0 A3 v* ?0 T U( S/ Z for (j = 0; j < n; j++)0 E. x+ z6 @/ Z+ [- \: d a[ni + j] = b[j];( {( Z- t1 E* f; d }/ I- v4 u! c j+ Q* } 1.2 分析代码 代码如上所示,外循环每执行一次,我们要进行一次乘法计算。i = 0,ni = 0;i = 1,ni = n;i = 2,ni = 2n。因此,我们可以把乘法换成加法,以n为步长,这样就减小了外循环的代码量。 1.3 改进代码int ni = 0;for (i = 0; i < n; i++) {$ n* ?1 x9 @) |6 z# C% n for (j = 0; j < n; j++)9 I2 w9 A+ W, u9 h0 F a[ni + j] = b[j]; ni += n; //乘法改加法 } 2. 提取代码中的公共部分2.1 示例代码 想象一下,我们有一个图像,我们把图像表示为二维数组,数组元素代表像素点。我们想要得到给定像素的东、南、西、北四个邻居的总和。并求他们的平均值或他们的和。代码如下所示。 up = val[(i-1)*n + j ];# Z, t5 l+ C2 b' Ydown = val[(i+1)*n + j ]; left = val[i*n + j-1]; right = val[i*n + j+1]; sum = up + down + left + right; 2.2 分析代码 将以上代码编译后得到汇编代码如下所示,注意下3,4,5行,有三个乘以n的乘法运算。我们把上面的up和down展开后会发现四格表达式中都有i*n + j。因此,可以提取出公共部分,再通过加减运算分别得出up、down等的值。 leaq 1(%rsi), %rax # i+1leaq -1(%rsi), %r8 # i-1 imulq %rcx, %rsi # i*n imulq %rcx, %rax # (i+1)*n imulq %rcx, %r8 # (i-1)*n addq %rdx, %rsi # i*n+j8 Q L: Z _4 S# J0 n0 }3 o addq %rdx, %rax # (i+1)*n+j* A9 y1 V5 {- E8 W$ i+ G addq %rdx, %r8 # (i-1)*n+j 2.3 改进代码long inj = i*n + j; up = val[inj - n]; down = val[inj + n]; left = val[inj - 1]; right = val[inj + 1]; sum = up + down + left + right;% k) P7 M- M5 z: n9 M! b4 l; m9 N9 F6 | 改进后的代码的汇编如下所示。编译后只有一个乘法。减少了6个时钟周期(一个乘法周期大约为3个时钟周期)。 imulq %rcx, %rsi # i*n9 k; D" N3 |8 Q5 W. |addq %rdx, %rsi # i*n+j5 Y1 c/ A" j) I* G! i2 V" K movq %rsi, %rax # i*n+j; D0 X+ u M/ K subq %rcx, %rax # i*n+j-n leaq (%rsi,%rcx), %rcx # i*n+j+n ...2 z3 Y3 G7 e' G3 _# C$ J6 H, O 对于GCC编译器来说,编译器可以根据不同的优化等级,有不同的优化方式,会自动完成以上的优化操作。下面我们介绍下,那些必须是我们要手动优化的。 3. 消除循环中低效代码3.1 示例代码程序看起来没什么问题,一个很平常的大小写转换的代码,但是为什么随着字符串输入长度的变长,代码的执行时间会呈指数式增长呢? void lower1(char *s){ size_t i;5 z: S, D2 T+ d1 } for (i = 0; i < strlen(s); i++) if (s >= 'A' && s <= 'Z'): ~1 N6 c0 R, D: ]; z2 O s -= ('A' - 'a');. Y* _( ^; y! d" p }" X$ k( I T9 S2 n8 V, { 3.2 分析代码 那么我们就测试下代码,输入一系列字符串。 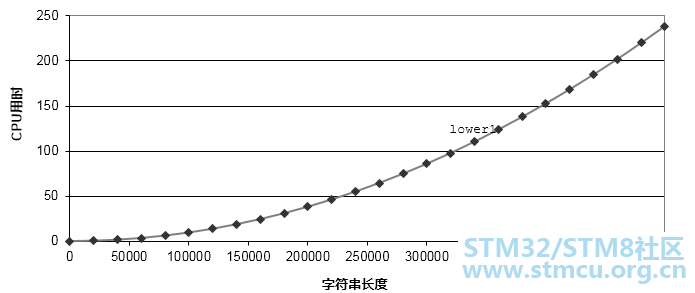
当输入字符串长度低于100000时,程序运行时间差别不大。但是,随着字符串长度的增加,程序的运行时间呈指数时增长。 我们把代码转换成goto形式看下。 void lower1(char *s)& |. U; d+ I5 B; N{ size_t i = 0;* `# m( U4 a2 F+ E if (i >= strlen(s)), l8 n1 T; k# `4 t5 Q3 h* {3 b goto done;! p0 r$ s0 J1 q9 C4 |1 A2 E loop:& Y' `. m" `8 C$ X if (s >= 'A' && s <= 'Z')# m! B' m7 }3 L# u( d& e* R s -= ('A' - 'a'); i++;7 `! N, _7 N& ~1 q if (i < strlen(s)) goto loop; done:$ w, n4 Y- N9 F1 `' y3 x6 b) z. q } 以上代码分为初始化(第3行),测试(第4行),更新(第9,10行)三部分。初始化只会执行一次。但是测试和更新每次都会执行。每进行一次循环,都会对strlen调用一次。 下面我们看下strlen函数的源码是如何计算字符串长度的。 size_t strlen(const char *s)7 o4 \' h4 q$ D* l1 B& m7 [# `0 J{ size_t length = 0;% r V3 Y W F* _ A y9 K! ^8 d while (*s != '\0') {& b0 H0 B+ F7 {5 Y s++; length++; } return length;/ q' f A8 x- ` } strlen函数计算字符串长度的原理为:遍历字符串,直到遇到‘\0’才会停止。因此,strlen函数的时间复杂度为O(N)。lower1中,对于长度为N的字符串来说,strlen 的调用次数为N,N-1,N-2 ... 1。对于一个线性时间的函数调用N次,其时间复杂度接近于O(N2)。 3.3 改进代码对于循环中出现的这种冗余调用,我们可以将其移动到循环外。将计算结果用于循环中。改进后的代码如下所示。 void lower2(char *s){ size_t i;1 o9 R1 Q: \; Y0 I- T size_t len = strlen(s);2 k# e% ~0 \ A) L# J" B3 e9 t for (i = 0; i < len; i++) if (s >= 'A' && s <= 'Z') s -= ('A' - 'a');1 ?8 O0 F1 H4 N0 N8 e }0 w# e# L6 L* e# p 将两个函数对比下,如下图所示。lower2函数的执行时间得到明显提升。 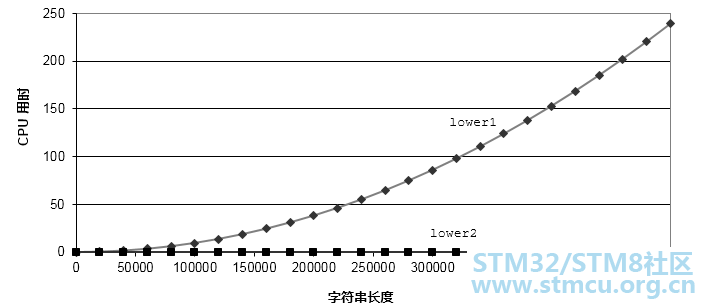
以下代码作用为,计算a数组中每一行所有元素的和存在b中。 void sum_rows1(double *a, double *b, long n) {) \+ ^% k% n. H, glong i, j; for (i = 0; i < n; i++) {7 [5 \, b3 X* c* f7 ` b = 0; for (j = 0; j < n; j++)& n* a a3 p% ?1 ~$ @* _* p b += a[i*n + j]; }: T$ Z# n1 G* R" `, ]. W6 X) \$ T" D }4 C# A; X3 O! q5 a; o( x 4.2 分析代码 汇编代码如下所示。 # sum_rows1 inner loop.L4:0 i8 F1 E& G5 V; q movsd (%rsi,%rax,8), %xmm0 # 从内存中读取某个值放到%xmm0 addsd (%rdi), %xmm0 # %xmm0 加上某个值. a1 Y+ E; ^: n1 a: d. o7 ~4 X8 Q H movsd %xmm0, (%rsi,%rax,8) # %xmm0 的值写回内存,其实就是b, f! c1 A: Q5 F, `" Y ]! S addq $8, %rdi cmpq %rcx, %rdi jne .L4 这意味着每次循环都需要从内存中读取b,然后再把b写回内存 。b += b + a[i*n + j]; 其实每次循环开始的时候,b就是上一次的值。为什么每次都要从内存中读取出来再写回呢? 4.3 改进代码/* Sum rows is of n X n matrix a7 } r5 I- l) U5 J* L5 rand store in vector b */ void sum_rows2(double *a, double *b, long n) { long i, j;& a5 {( L( ~+ {, a for (i = 0; i < n; i++) { double val = 0;: {0 R/ a" \4 ?" h for (j = 0; j < n; j++) val += a[i*n + j];" B r5 S C F/ U; e0 Y8 {1 j b = val;6 d- D& T9 R' J } }- e( _& _1 _+ j6 U& g 汇编如下所示。 # sum_rows2 inner loop9 i. r' n% F! Z6 c, ^% ?& R.L10: S+ Y7 X! _: O/ |2 F5 t+ e addsd (%rdi), %xmm0 # FP load + add addq $8, %rdi cmpq %rax, %rdi jne .L10& Q, v5 p, ?2 d" @ 改进后的代码引入了临时变量来保存中间结果,只有在最后的值计算出来时,才将结果存放到数组或全局变量中。 5. 减小不必要的调用5.1 示例代码为了方便举例,我们定义一个包含数组和数组长度的结构体,主要是为了防止数组访问越界,data_t可以是int,long等类型。具体如下所示。 typedef struct{4 r% Y @) j+ f7 F' Hsize_t len;* x1 R. i( s2 I% n; b8 a data_t *data; } vec; 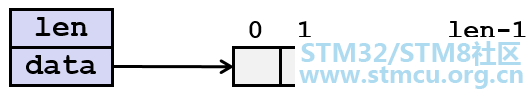
get_vec_element函数的作用是遍历data数组中元素并存储在val中。 int get_vec_element (*vec v, size_t idx, data_t *val){) D! F; Y1 T! K5 P* D7 ^% E if (idx >= v->len) return 0;7 b- x, P' S' }+ e# _5 I *val = v->data[idx];, m; C; ~& b+ u8 S* N+ ? return 1; }0 e @- i' m& \8 c 我们将以以下代码为例开始一步步优化程序。 void combine1(vec_ptr v, data_t *dest)0 z! [) G; ^4 ~7 L0 C' q3 T$ k( X{7 M4 X/ u; B* P+ h1 ^ long int i;8 M2 Z- P' F5 W- y" ^ *dest = NULL; for (i = 0; i < vec_length(v); i++) {7 m! v! L+ P, u, Z% F/ o data_t val;/ t; R1 |9 H0 [) u6 t get_vec_element(v, i, &val); *dest = *dest * val;" d! N, w c5 x. ^) S } } 5.2 分析代码 get_vec_element函数的作用是获取下一个元素,在get_vec_element函数中,每次循环都要与v->len作比较,防止越界。进行边界检查是个好习惯,但是每次都进行就会造成效率降低。 5.3 改进代码我们可以把求向量长度的代码移到循环体外,同时抽象数据类型增加一个函数get_vec_start。这个函数返回数组的起始地址。这样在循环体中就没有了函数调用,而是直接访问数组。 data_t *get_vec_start(vec_ptr v){ return v-data; }! n* K1 ~; J( v9 f/ r) }9 a2 b void combine2 (vec_ptr v, data_t *dest) { long i; long length = vec_length(v); @$ g! |% \1 A2 _5 F data_t *data = get_vec_start(v); *dest = NULL; for (i=0;i < length;i++) {* Y8 I; t- _6 r% ^. f; x; G( F *dest = *dest * data;1 B/ u- A% J( R. E6 K }) J9 m" K' n$ k* k0 J" G( [5 F }5 M, r' E: T5 N7 Q5 u. H 6. 循环展开6.1 示例代码 我们在combine2的代码上进行改进。 6.2 分析代码循环展开是通过增加每次迭代计算的元素的数量,减少循环的迭代次数。 6.3 改进代码void combine3(vec_ptr v, data_t *dest) ^2 e, c' Y* T" p2 K{5 D/ [ P& Y: J long i;, r% E% i2 j4 ~& s$ |5 ^# \4 d7 D% I long length = vec_length(v); long limit = length-1; data_t *data = get_vec_start(v);4 `9 }! |, E& `! n4 F data_t acc = NULL;" c$ P. D* w+ |( [; c /* 一次循环处理两个元素 */5 @5 }' H5 T, R9 @" _/ h# M for (i = 0; i < limit; i+=2) { acc = (acc * data) * data[i+1];/ J, S' K* F% d4 }; [% f0 l }9 A# i2 E( N2 O- X# } /* 完成剩余数组元素的计算 */ for (; i < length; i++) { acc = acc * data; } *dest = acc;7 c- b) G* s: I } 在改进后的代码中,第一个循环每次处理数组的两个元素。也就是每次迭代,循环索引i加2,在一次迭代中,对数组元素i和i+1使用合并运算。一般我们称这种为2×1循环展开,这种变换能减小循环开销的影响。 7. 累计变量,多路并行7.1 示例代码 我们在combine3的代码上进行改进。 7.2 分析代码对于一个可结合和可交换的合并运算来说,比如说整数加法或乘法,我们可以通过将一组合并运算分割成两个或更多的部分,并在最后合并结果来提高性能。 7.3 改进代码void combine4(vec_ptr v, data_t *dest)8 {- N& s% K* |' L* W1 a3 U a P {3 c# s4 D6 y* H7 P long i;' \+ ?" z# a" I6 B2 Z/ T! L! i long length = vec_length(v); long limit = length-1;! N; j! @# \# W3 ^( X J" o data_t *data = get_vec_start(v);$ w( A! x/ |5 Z, j5 ^9 U- S data_t acc0 = 0;! f7 l( ?4 W* W# L a+ a+ F( b data_t acc1 = 0; /* 循环展开,并维护两个累计变量 */ for (i = 0; i < limit; i+=2) { acc0 = acc0 * data;* z* Z4 y: J( K9 H1 j1 L, F acc1 = acc1 * data[i+1]; } /* 完成剩余数组元素的计算 */# M" b/ |" U4 Q" g) d, J/ g2 l for (; i < length; i++) { acc0 = acc0 * data;' ~! Z+ _7 h: y$ _ } *dest = acc0 * acc1; } 上述代码用了两次循环展开,以使每次迭代合并更多的元素,也使用了两路并行,将索引值为偶数的元素累积在变量acc0中,而索引值为奇数的元素累积在变量acc1中。因此,我们将其称为”2×2循环展开”。运用2×2循环展开。通过维护多个累积变量,这种方法利用了多个功能单元以及它们的流水线能力 8. 重新结合变换8.1 示例代码我们在combine3的代码上进行改进。 8.2 分析代码到这里其实代码的性能已经基本接近极限了,就算做再多的循环展开性能提升已经不明显了。我们需要换个思路,注意下combine3代码中第12行的代码,我们可以改变下向量元素合并的顺序(浮点数不适用)。重新结合前combine3代码的关键路径如下图所示。 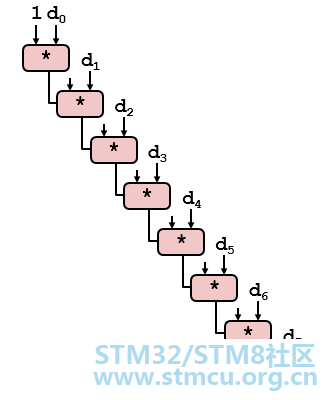
{, ~+ {+ \% A2 K) X9 ]: N! B7 q long i; long length = vec_length(v);3 C' u* o# l, U7 J3 b& } long limit = length-1; data_t *data = get_vec_start(v); data_t acc = IDENT;- U& |& |8 O* R/ c4 S1 N /* Combine 2 elements at a time */& q. x5 p. `! {' K. X/ G for (i = 0; i < limit; i+=2) { acc = acc OP (data OP data[i+1]);) e1 {. D: s! [7 f2 R; m } /* Finish any remaining elements */1 @, Z; Y: p- Q: Y K c for (; i < length; i++) {! x: u1 _6 ^# M( S5 Q$ y9 I% ?* P acc = acc OP data;4 |* s* l4 F7 b0 M- G; v } *dest = acc; } 重新结合变换能够减少计算中关键路径上操作的数量,这种方法增加了可以并行执行的操作数量了,更好地利用功能单元的流水线能力得到更好的性能。重新结合后关键路径如下所示。 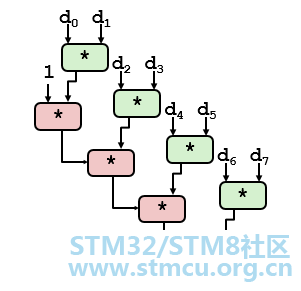
long i; y% L, E' @1 Q5 R% P) l for(i = 0;i,n;i++){ if(a>b){6 b2 e: @- X9 z9 ?+ u6 S8 B. |0 b long t = a;' C- u3 B% p2 K: o8 N a = b;( u U) ^) c( V) I b = t; } } }# a" T7 G+ O1 O 9.2 分析代码 现代处理器的流水线性能使得处理器的工作远远超前于当前正在执行的指令。处理器中的分支预测在遇到比较指令时会进行预测下一步跳转到哪里。如果预测错误,就要重新回到分支跳转的原地。分支预测错误会严重影响程序的执行效率。因此,我们应该编写让处理器预测准确率提高的代码,即使用条件传送指令。我们用条件操作来计算值,然后用这些值来更新程序状态,具体如改进后的代码所示。 9.3 改进代码void minmax2(long a[],long b[],long n){: [* {$ W; N5 ^' Zlong i;; j( X+ X; m% A, f. v for(i = 0;i,n;i++){) i; O& |/ C- c long min = a < b ? a:b; E2 o' z/ R$ h. g& I* |$ j long max = a < b ? b:a;: X: I( @0 f- E( b a = min;: S: O `. o, ?7 E b = max;& B; \7 Z- a- d5 M) L; ` } } ^* [% X {' N) m' y2 `1 ~" S 在原代码的第4行中,需要对a和b进行比较,再进行下一步操作,这样的后果是每次都要进行预测。改进后的代码实现这个函数是计算每个位置i的最大值和最小值,然后将这些值分别赋给a和b,而不是进行分支预测。 10. 总结我们介绍了几种提高代码效率的技巧,有些是编译器可以自动优化的,有些是需要我们自己实现的。现总结如下。
|
 微信公众号
 手机版


