|
【导读】:日常开发最容易被忽视的就是性能优化,除了类似cache的性能刺客,还有分支预测这种不容易被察觉的优化!
/ r( Z0 f E- l8 N
6 m; o' V' s! I/ P0 a
以下是正文
为什么处理有序数组比无序数组快?8 w2 g2 @- P6 {9 \5 l
由于某些怪异的原因,下面这段C++代码表现的异乎寻常—-当这段代码作用于有序数据时其速度可以提高将近6倍,这真是令人惊奇。
4 ~! D/ T! i4 N7 g& V; y- #include <algorithm>* F) y. o" ^5 b6 s
- #include <ctime>+ T' F: k, K0 @( }. j
- #include <iostream>7 `6 K: b' b' v+ R) |5 f
- # h( e1 s% k# E7 g: ?* B# T
- int _tmain (int argc , _TCHAR * argv [])
" N' G9 _1 Y( N6 M. e - {
$ L' p2 ]9 N( b( q. G5 U - //Generate data- u5 ^9 M8 B* x: R' l4 e/ C E
- const unsigned arraySize = 32768;
; o; \/ X- u% F - int data[arraySize];
# ~ ?8 d. P2 ]5 ^( Q1 j5 C - " T# A( g: w6 d: h; Z# y2 r
- for ( unsigned c = 0; c < arraySize; ++c)
6 a$ E+ `; X2 S& _ - data[c] = std::rand() % 256;
7 Y$ J' w% _) Y9 c5 V/ S0 N* S' g
9 S4 F' K; ?- s7 `/ q! \8 W- t- //!!! With this, the next loop runs faster
2 B$ E. Q9 H1 O - std::sort(data, data + arraySize);
5 n2 j; V: r7 _2 s' G/ [# i5 D. \
% H7 K. n6 X- F3 R8 L+ ]- //Test
2 G! D" G- \3 Z b1 C- X) `- }. y - clock_t start = clock();
& C9 | P$ y" X6 ~! x6 j1 T7 j - long long sum = 0;1 j3 d3 X% g. D5 V. m+ @" n% A: }, n
- for ( unsigned i = 0; i < 100000; ++i){- o# ]6 [+ j. F7 v% Q: Q
- //Primary loop
% H3 C: t B/ i - for ( unsigned c = 0; c < arraySize; ++c){$ x. D; |" n# W, e; U5 O; O
- if (data[c] >= 128)
1 @0 J: p7 b( { l - sum += data[c];
2 Q; t0 V% `+ R. ^7 j: B& D - }0 V$ [: |' u v* l
- }" X( d. u' r1 l- q! E3 O, {
- double eclapsedTime = static_cast<double >(clock() - start) / CLOCKS_PER_SEC;: U3 g5 d3 e/ a9 d
& O$ a Q( K; V. p) `- std::cout << eclapsedTime << std::endl;
# h/ \ x6 S# ~0 F2 N - std::cout << "sum = " << sum << std::endl;! R7 I+ G3 `" [9 n2 W
- return 0;
8 M3 ~" h# D* c5 B. h% d. b - }
起初我以为这可能是某一种语言或某一个编译器发生的异常的事件,后来我在java语言写了个例子,如下: - 4 F1 M" M+ y7 n; _
- import java.util.Arrays;
t- l; A! C; U - import java.util.Random;2 o* e' A0 P* q3 `
-
+ F% K& t# S! g4 ` l& M - public class Test_Sorted_UnSorted_Array {" _) t: q3 u5 h' e/ r# l
- public static void main(String[] args) {2 Z) \& M+ E! H l4 L! X7 E7 s
- //Generate data
2 m+ \0 O9 f1 V- i, F8 ?% @ - int arraySize = 32768;2 O) @$ C$ Q& m! K8 v$ J
- int data[] = new int[arraySize];
1 H9 I% [# ?1 B6 P1 R1 o0 Y -
; d# n A8 d9 x0 S" X - Random rnd = new Random(0);
5 d0 B9 k" }! B2 l, H - for( int c = 0; c<arraySize; ++c)
# \% [! ^8 l1 p |( k5 o$ X7 S. t) s" } - data[c] = rnd.nextInt()%256;* Q. ]5 b/ [2 p1 z# v
- * G5 i! O' i K
- //!!! With this, the next loop runs faster
: L7 B% O3 f* _4 z; E) M0 E - Arrays. sort(data);
+ R) n J$ g; |( }. b4 W -
7 k7 q" S y- U& j - //Test
" ]! A. @ K% i7 ~5 A - long start = System. nanoTime();% Z' s" J& n" g. w9 Y3 [
- long sum = 0;
; x/ B4 v; O! m5 Q. W- o* W - * p* M7 o, [% ~1 p
- for( int i=0; i<100000; ++i){
/ I h' T6 ]: V - //Primary loop
8 g9 w. v% H- S, m' i; e+ G2 ~ - for( int c = 0; c<arraySize; ++c){
3 g, F/ }- f N# q7 C" w6 V - if(data[c] >=128)
4 H0 |/ W6 d. G$ w% K - sum += data[c];
2 F+ B9 H4 m% \8 r- r - }2 o& v$ o9 U! O) x" y
- }0 H$ T( s1 y& e
- 5 T s+ X9 k0 |/ O+ L
- System. out.println((System. nanoTime() - start) / 1000000000.0);; C( ~; i, u+ |. ]9 }; W2 t& F2 m
- System. out.println( "sum = " + sum);
8 `6 Y% }# S' T - }+ L' E$ u! H, u0 @
- }
上述例子运行结果和前面C++例子运行的结果差异,虽然没有C++中那么大,但是也有几分相似。 $ \. }' y. R6 C: h: d6 e
对于上面的问题,我首先想的原因是排序可能会导致数据有缓存,但是转念一想之前原因有点不切实际,因为上面的数组都是刚刚生成的,所以我的问题是: : t6 ]% {* s9 s: v4 I+ M) U) [
上述代码运行时到底发生了什么? - H i0 Y) F1 x6 a, F9 U
为什么运行排好序的数组会比乱序数组快?
! Z& A3 Y( v7 E
上述代码求和都是独立的,而顺序不应该会产生影响。 % w* _2 I: U! A5 u8 K2 ^
来自 Mysticial 的最佳回复8 S' d* n4 o% x: T: H. h t
你是分支预测(branch prediction )失败的受害者。
* ~2 u8 j$ t1 ~* A+ {( x, ~
什么是分支预测?
8 K: n- X: L& E( N5 w- a, i
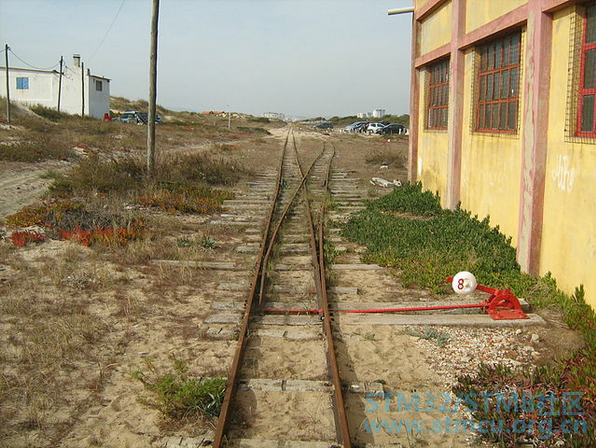
考虑一个铁路枢纽: Imageby Mecanismo, via Wikimedia Commons. Used under theCC-By-SA 3.0license. ! l- n* B! e/ m
为了便于讨论,假设现在是1800年,这时候还没有出现远程或广播通讯工具。 8 c% H4 l( S- h5 J: x' }, m+ l
你是一个铁路枢纽的工人。当你听到火车开来时,你不知道这个火车要走哪一条路,只有让火车停下来询问列车长火车要开往哪,最后你将轨道切换到相应的方向。 # m3 x; V, @$ F1 o) A8 F
火车的质量非常大,固惯性很大,因此火车需要经常性的加速减速。
1 p9 {4 n2 A1 f! }2 I
有没有更好的方法喃?可以猜火车将行驶的方向应该是可行的!
/ {: a( z7 X5 X: A4 x
% k. s; e0 A6 X1 t7 @% V, r9 V: S' G
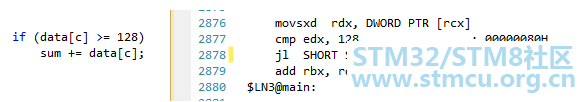
考虑一个if语句:在处理器级别上,他是一个分支指令:
. \7 m+ M* T1 L0 B1 p
你来扮演处理器,当你遇到一个分支,你不知道它要走哪条路,该怎么办?你可以停止执行并等待直到之前的指令执行完。然后继续执行正确路径的指令。 % ^. A; B6 y4 f' Z5 |
有没有更好的方法喃?可以猜测哪个分支将要被执行!
4 v: g5 U0 _7 Z2 b
& {" K" M0 i: l3 S& A! d
如果每次都能猜对,整个执行过程就不会停止。
' d& {9 _' q# U如果经常猜错,就需要在停止、回退、重新执行上花费非常多的时间。
; ]7 x0 C4 a/ b- b; s/ x" J# O
这就是分支预测。不得不承认这不是一个最好的比喻因为火车可以仅仅使用一个标志表示其前进的方向。但是对于计算机,直到最后时刻,处理器是不知道哪条分支被执行。 ( D: a6 S8 E" w
想想可以使用什么预测策略使得火车回退的次数最少?哈哈,可以利用历史数据!如果火车100次有99次都是向左,那么下次预测结果仍向左。如果过去数据是交替的,那么预测结果也是交替的。如果它每3次都换一个方向,那么预测也采用相同的方法。
* j6 Y$ b( K/ ?$ O* h( x9 E
简而言之,你需要尝试寻找出一个规则(模式)然后按照它进行预测就可以了。分支预测基本上就是这样工作的。 5 v2 W4 z9 I0 i# `
大部分应用程序的分支是很规律的。这也是为什么现代的分支预测的准确率基本上都在90%以上。但是当没有规律、不可预测的分支时候,分支预测就显得比较拙鸡了。 / A6 U3 V+ j! A9 t
从上面可以得到启发,这个问题的“罪魁祸首”就是 if 语句 - 3 _/ K# q/ m7 w3 ~
- if (data[c] >= 128)
! a4 c; l3 f3 L/ a - um += data[c];
G( P& w. C' X% M; ~, H注意到数据是在0到255均匀分布的。当排好序后,小于等于128的前半部分是不会执行if语句的,大于128的后半部分都会进入if语句。 ! p3 G5 Q! x' \; E
这是非常有好的分支预测因为分支会连续多次执行相同的分支。即使是一个简单的饱和计数器也会预测正确除去当变换方向后的少数几个。 * y! }5 U: H' d7 t9 s2 c
快速可视化 - \9 k2 l4 Q% O. L
- T = branch taken
z$ M/ C$ ?) h5 u. c$ g - N = branch not taken1 Y' ~; G, h4 c2 j
- ' X* z# ~$ S* Z$ d
- data[] = 0, 1, 2, 3, 4, ... 126, 127, 128, 129, 130, ... 250, 251, 252, ...
; M4 s u2 z4 R1 u - branch = N N N N N ... N N T T T ... T T T .... g6 b2 b" j5 P% ^! z4 i+ W9 f0 W& V, s
-
: y" t$ h d4 M! o% A5 r! { - = NNNNNNNNNNNN ... NNNNNNNTTTTTTTTT ... TTTTTTTTTT (easy to predict)</span></code>
4 f3 O9 q6 @3 o5 l% y3 v然而,如果数据是完全随机的,分支预测则毫无用处因为它不能预测随机数据。这种情况下可能会有50%的错误预测。 - * e6 v$ k) q# e6 a3 x1 d; \
- data[]= 226, 185, 125, 158, 198, 144, 217, 79, 202, 118, 14, 150, 177, 182, 133, ...+ Y9 l+ p1 t& b M- w
- branch= T, T, N, T, T, T, T, N, T, N, N, T, T, T, N ...( t, u% x- V3 \+ R U, W
- = TTNTTTTNTNNTTTN ... (completely random - hard to predict)
U) V& o0 I9 [9 P那这种情况下该怎么做呢? # c" e& Q; G2 I8 E& [
如果编译器不能将分支优化为有条件的移动,这时候可以尝试一些 Hacks ,如果能够可以牺牲可读性的表现。 1 v. z8 L' w7 U! a w
将下面代码 - + n, n2 H# B7 Y9 S- l2 P1 E
- if (data[c] >= 128)
8 N1 f7 |" v- J* r+ x* L - sum += data[c];
/ j3 B: J: f+ J7 U: T: F. [0 i: F替换为: - 9 ~$ |& k) L3 r# C3 q
- int t = (data[c] - 128) >> 31;9 \5 \/ x- ?, H0 a3 n$ W9 Z
- sum += ~t & data[c];
" h% e' y( X0 g5 P% {: j6 e用一些按位操作取代分支判断,这样就去除了分支。(注意:这个 hacks 并不是和if语句严格相等,但是在我们这个例子里,对输入数组data的所有值都是正确的)
- i3 H: X4 k" n" D6 k
Benchmarks: Core i7 920 @ 3.5 GHz
7 E5 g( {1 k% d) \. WC++ – Visual Studio 2010 – x64 Release
- z+ h# U* ^6 P& ^
- // Branch - Random
' W6 V* {7 h X1 l- U; T5 H - seconds = 11.777
; ?+ j% M2 X- B+ h, q5 @+ k -
8 Z4 M7 k8 o6 U% m }* M - // Branch - Sorted
. m4 g/ B1 v) i$ J, q* B - seconds = 2.3522 S" j* u: A/ O8 p
-
! a6 }/ V) \5 p( ? - // Branchless - Random" |0 c0 \/ R! q" g' @
- seconds = 2.5642 k7 e7 B8 v6 ~# O, u
- ( F* a' p/ }2 m2 c. H
- // Branchless - Sorted
9 o0 c' P1 i/ t# m - seconds = 2.587</span></code>
- y7 m, L( |/ m6 h, DJava – Netbeans 7.1.1 JDK 7 – x64
4 s4 u& M `- T- // Branch - Random
# r) ^2 a( U }* K5 } @ - seconds = 10.93293813: O2 r3 C) Q* u. D q
- # _8 ^; F9 M. u$ t
- // Branch - Sorted
$ s% h, i6 F, ]! k } - seconds = 5.643797077$ F a9 \( Z4 y+ w& d8 ^
-
+ t. z4 K8 I3 A* W& o - // Branchless - Random
+ k" i3 J5 b0 a2 J - seconds = 3.113581453
% o( Y/ k# `8 r. ^8 I* s - ?8 E# L: i) S% G# n: g3 {
- // Branchless - Sorted
: o: ^+ t0 B5 q- c+ ~% w5 Q6 _ - seconds = 3.186068823</span></code>
观察可得:
* g& m& ~ g8 ?" i
在分支情况下:排序数组和乱序数组之间的结果有着巨大的差异。 在 Hack 方式下:对于排序和乱序的结果则没有差异。 在C++中,对于排序数组,Hack 会比分支有一点点慢。 & H8 n4 K; R3 @3 X6 `' t/ C
8 M1 | ?+ y* P/ {1 h. e. n w: c
一般的经验法则是避免数据依赖分支在一些特殊的循环中。
* v6 b% X' ^7 h: R, V7 C7 h( v" e
64位机器下,GCC 4.6.1附带选项-O3或者-ftree-vectorize可以产生一个条件移动。因此对于有序和乱序数据都是一样快。
3 X- A6 k$ K; ?* o( P
VC++2010不能够产生条件移动对于这样的分支。 1 | V( W1 J. y2 f& Y3 b$ M Y
英特尔编译器11同样可以做一些神奇的事。它通过互换两个循环,从而提升了不可预测的分支外循环。因此,它不但能够避免误预测,而且速度上可以达到VC++和GCC的两个快。换句话说,ICC利用了测试回路打破了benchmark。 " V# b: }/ q) F2 i) J; c5 {; e; `
如果用英特尔编译器执行没有分支的代码,它仅仅出右向量化(out-right vectorizes it),并且和带分支同样快。 % M0 I1 G7 i" f) }
通过上面说明,即使比较成熟的现代编译器在优化代码的上可以有很大的不同。 Q+ o" h/ B# ?1 I# f E0 R
|





 微信公众号
 手机版


