




|
在STM32的应用开发过程中,我们有时可能涉及到DSP应用,需要使用到相关DSP函数。这里基于STM32H743芯片的Nucleo开发板,做个有关矩阵运算应用的演示,简单的演示下两个矩阵相乘的实现过程。 开发环境选择的是ARM MDK,当然你也可以选其它的,比方IAR, STM32CubeIDE等。8 f5 r8 J0 h7 `9 M 我们要用到ARM提供的DSP函数库,该库在STM32的Cube库或标准库里都可以找到。3 x* g4 M( r0 D 以STM32CubeH7的库为例,相应的DSP函数库一般在下面位置: 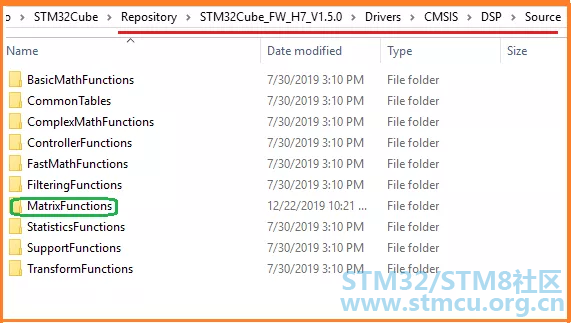
上图中绿色方框内的函数即为跟矩阵相关的函数库文件。% H0 v3 I0 `" N4 L, e% l # @( j0 a G( f0 n$ z* o, R7 v 具体使用时,我们直接添加相应的lib库进来即可,不过,添加该lib库文件时要注意两点:( F g) _4 b% u 你选择的库文件要跟你芯片类型一致,内核类型、大小端模式、是否支持浮点运算。 0 R0 o6 ~2 h4 W" \ 你选择的库文件还要跟你所使用的编译器匹配,即IDE是MDK还是IAR等。 基于上面两点我们添加arm_cortexM7lfdp_math.lib文件【corex M7、小端模式、支持硬件浮点单元】。 0 n' S9 V# G0 ?* k 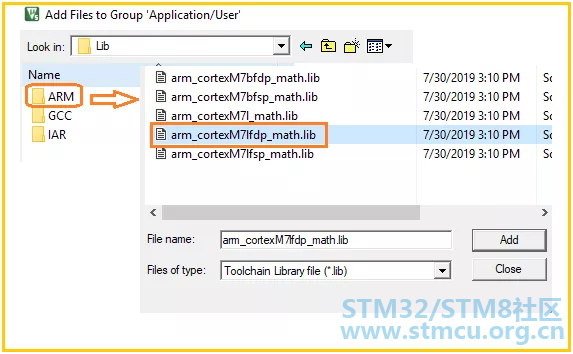
* b& x6 J' Y* L( H. X 在我们的main()文件里添加arm_math.h头文件。记得在IDE环境的配置里添加相应的搜索路径。启用硬件浮点运算单元。开启有关宏定义。【宏开关不用特别去记,缺少的话编译时会报错】 ' u5 C# Z- o1 D! G 
/ ^3 v7 D' U* U# _1 R: `( r8 W0 ~ 下面构造三个矩阵,A矩阵的数据表示某家芯片代理商为他的8个客户分别提供四种不同规格的芯片,数据以包为单位。不同型号的包装规格不一样。A矩阵为8X4矩阵。" Z. Q7 A; ]! N( s + J5 n' J4 R6 e/ t/ Z6 V B矩阵表示A矩阵中各类包装每包的数量、价格、运费、重量,为4X4矩阵。 二者的矩阵乘积表示各个收货方收到芯片的总数、应付货款、运费、以及货物总重量,将构成8X4矩阵。矩阵里的数据使用浮点数,数据随意设计的。 我们知道,两个矩阵可乘有个前提,比方A*B,矩阵A的列数应该等于矩阵B的行数,相乘后所得的乘积矩阵的行数等于矩阵A的行数,其列数等于矩阵B的列数。9 y& r9 K- e. _( Z: p ( T4 x; h& u( c% j# Y: D I4 t* T 具体到这里,矩阵A的行数为8,列数为4,矩阵B的行数、列数均为4。A*B所得矩阵的行数为8,列数为4.+ u6 K& G A$ E/ s 9 j& R( t8 W4 [' _" O5 c 
M1 ~6 g: o; L3 Y5 l, N( p# ` 
- m7 l0 g; ~1 N: X7 t8 ]( b T 下面做相关代码的准备。 定义三个数组,pDataA[32]数组对应矩阵A, pDataB[16]数组对应矩阵B,第3个数组pDataC[32]对应矩阵AB乘积所得的新矩阵。 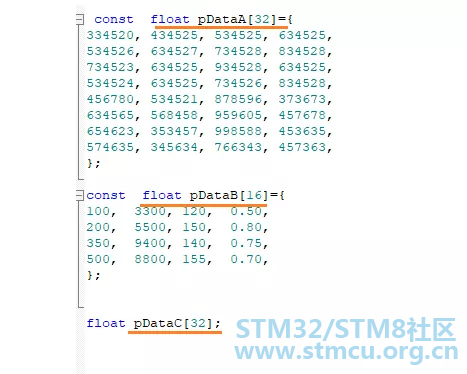
* m, } W, `; L9 ]3 T1 K: ~6 Z 基于上面的3个数组定义3个如下矩阵变量:- a& N4 e: T% q - x: T, h0 ~1 f c3 N c3 E1 F7 Q 
$ i9 G" N4 F r, O2 S 关于结构体arm_matrix_instance_f32的定义和说明,可以在arm_math.h中看到。4 f3 q( w4 t; @" r8 Y- l, @ 
8 I* M- V5 D; C) Y) L7 ~ 9 b/ r2 a+ i: R. I 接下来对3个矩阵进行初始化,注意行、列数别给错了。- I7 b3 M+ B; }( m U! k; c : W; _" _6 C: A) B, d- l1 R s 8 p0 _+ H: }" z7 w. Y: a 
. r# v* m8 x* i4 A3 b; R' g7 ^ ) S$ |$ e" Q. k1 J8 x 一切都准备好了,就可以进行矩阵乘法计算了,调用库函数中arm_mat_mult_f32()函数。8 y$ T8 p1 g0 Z4 W4 O4 m5 I 2 F6 @' ?; C+ P0 L5 W 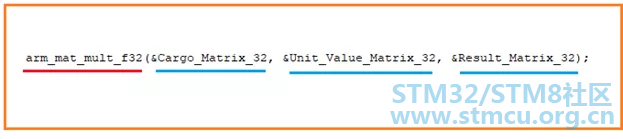
Y) L$ O$ l1 ] 9 E4 h; K1 _2 [3 {: @ 矩阵相乘后的运算结果存放在数组pDataC[32]里面,按8*4的矩阵摆放。- a% _; y3 Q, s. a9 F * f2 R) x: M+ C( p6 c8 z: i, p 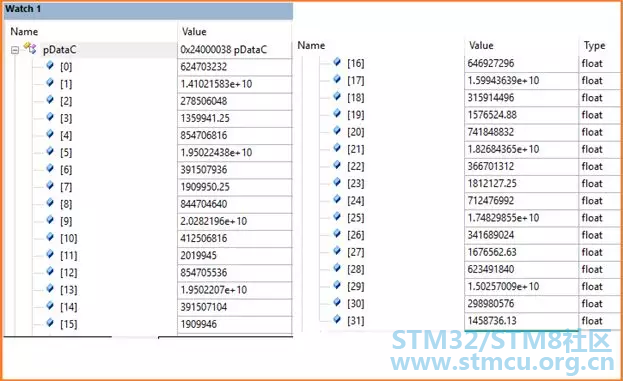
上述运算结果跟使用MATLAB数学工具通过矩阵乘法得到的结果整体上非常一致。数据会稍有些小出入,毕竟是基于浮点运算所得结果。 A: S1 K' H' k% @ 我们知道,STM32H7是带Cache和FPU的。不妨基于该矩阵乘法应用比较不同情况下的运行时间。以定时器的计数时钟为单位。根据Cache和FPU的开启与关闭的不同组合进行测试,可以做些相对比较,让我们有些直观的感受。测试时ARM MDK的优化等级为-o3。顺便提醒下,如果不开启硬件FPU,调用的DSP库函数应选择另外一个不支持硬件浮点单元的函数库。 3 T2 M" H6 \1 Z8 f2 s) V# D5 T, y6 o 
下面数据是基于上面测试代码所得到的,其中红色数据为十进制数据。! ?5 l5 e: D- C1 B 7 @$ O/ s9 J( f) v) D# A( o 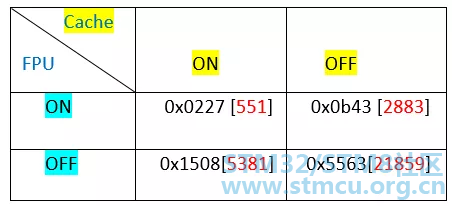
从这里我们可以看出,同时开启硬件FPU和Cache与同时关闭二者,运行时间相差将近40倍;开启Cache与关闭Cache运行时间上相差4倍左右;使用FPU和不用FPU,运行时间相差8倍左右。当然,或许基于不同的应用,上述数据可能存在些差异,但可以肯定,开与不开Cache、启不启用硬件FPU,运行速度上的差别还是很明显的。 ' |! B& Z0 k& F: e 好,关于利用STM32及相关DSP函数库进行矩阵运算的演示就介绍到这里,请留意上文中谈到的那些提醒。其它更多细节,有兴趣的话可以进一步阅读和研究相关资料。: {2 s+ S8 I9 Z; J |
【新品】STM32H7P微控制器:DSP与边缘AI加速赋能工业实时控制
【STM32H735G-DK测评】ADC3+TIMER1+DMA 采样模拟信号
【 逢7发帖赢大礼】1、利用CubeMX生成正点原子H7R7开发板的STM32CubeIDE工程
【STM32H735DK测评】Ethernet+lwip DHCP获取IP地址
STM32H743基于CubeMx5.0配置手册
【STM32H735G-DK测评】lvgl移植
【STM32H735G-DK 测评】STM32H735G-DK External Loder 编译和测试
【福利三:逢7发帖赢大礼】使用MPU6050模块、img_dsc、img_btn机制实现一些简单有趣的动画效果
【福利三:逢7发帖赢大礼】使用arc弧形拉条控件控制PWM舵机及使用SPI3接口操作NRF24L01模块进行无线通信
【福利三:逢7发帖赢大礼】调试nucleo-WBA65RI工程测试样板的一些心得
 微信公众号
 手机版


