DSP简介& N: \ L1 K, S4 y! H5 N
STM32F4 采用 Cortex-M4 内核,相比 Cortex-M3 系列除了内置硬件 FPU 单元,在数字信5 Z; x/ _; F" A- j1 ^7 D/ f, }. G
号处理方面还增加了 DSP 指令集,支持诸如单周期乘加指令(MAC),优化的单指令多数据指& B9 H% S. R/ |* i; X+ P+ n
令(SIMD),饱和算数等多种数字信号处理指令集。相比 Cortex-M3,Cortex-M4 在数字信号处2 G; i, l, G0 P( H
理能力方面得到了大大的提升。Cortex-M4 执行所有的 DSP 指令集都可以在单周期内完成,而, D# O' x* { A6 \* ]
Cortex-M3 需要多个指令和多个周期才能完成同样的功能: o* m G. }! ~4 v' B J
( N# u! d+ F7 y( D0 H) `9 v0 K
以上都不重要。重要的是,它运算快就完了!!!具体多快,我们后面会有相应测试
$ n7 W j* g, a+ K' o3 T8 c
. }) ]4 D' x& t0 |5 }一、可供移植的DSP文件
0 M3 g! ]' e$ P& m, F* v/ {0 s& sSTM32F4 的 DSP 库源码和测试实例在 ST 提供的标准库,详细路径为:光盘→8,STM32
! t. a1 b' p' @& Z7 O7 ^2 j l. `, n参考资料→STM32F4xx 固件库→STM32F4xx_DSP_StdPeriph_Lib_V1.4.0→Libraries→CMSIS→' i, O4 e6 {+ |5 t* I5 q
DSP_Lib。
' Q' v) i8 j* m/ Z- JDSP_Lib 源码包的 Source 文件夹是所有 DSP 库的源码,Examples 文件夹是相对应的一些% Z. y' ~( z0 z# i
测试实例。这些测试实例都是带 main 函数的,也就是拿到工程中可以直接使用。接下来我们一. l- p! L& k: s1 q; o5 W: q
一讲解一下 Source 源码文件夹下面的子文件夹包含的 DSP 库的功能。
1 l2 `3 H& O6 C. y" n$ r
2 |$ _! s; y. G7 R0 x7 P- kBasicMathFunctions
" U6 b2 e4 F( [, B% K+ w; @, Z& c2 K基本数学函数:提供浮点数的各种基本运算函数,如向量加减乘除等运算。
: [, J/ _9 o3 j! m; W6 F$ J& g2 }- z& z) b% _( W! H( i$ a; s
CommonTables
4 h' s8 C7 }1 |3 m, `9 ^9 U: p+ narm_common_tables.c 文件提供位翻转或相关参数表。. ~0 j- I0 A/ T( _& x8 o+ \
% k7 }% t! U. {! c& N qComplexMathFunctions" Q* X/ l: x1 u4 M9 j- O/ f
复杂数学功能,如向量处理,求模运算的。9 s! X3 U3 c& k! x- r( P# O5 R
9 u( q, a) L# g2 u+ d/ I( n
ControllerFunctions
9 }3 f, C' W |7 d6 a0 T% a控制功能函数。包括正弦余弦,PID 电机控制,矢量 Clarke 变换,矢量 Clarke 逆变换等。- D" f) h: m4 Y; X8 \5 Z
9 Q& H8 Q( D8 d( q q; a
FastMathFunctions- o2 ?" |8 r6 a( H
快速数学功能函数。提供了一种快速的近似正弦,余弦和平方根等相比 CMSIS 计算库要快. e/ y3 l R2 q$ K8 E5 s( l
的数学函数。
( w- m6 ^# N$ {# `, Z' L5 _& k% w2 J
0 }8 b4 k7 d" s! NFilteringFunctions d9 v$ m' {. p+ h
滤波函数功能,主要为 FIR 和 LMS(最小均方根)等滤波函数。
0 c% X3 s( O9 z9 R8 d1 K- R4 ~* Q+ B: c
MatrixFunctions
+ V7 T: t4 N4 K矩阵处理函数。包括矩阵加法、矩阵初始化、矩阵反、矩阵乘法、矩阵规模、矩阵减法、! f% O' U: k2 a
矩阵转置等函数。
5 x( l9 k5 j8 g/ x8 A" \4 v
7 x7 T' v$ E# C* C+ w- V8 ]6 }& qStatisticsFunctions
8 e% x. j T2 b% l3 F; e. Y. S统计功能函数。如求平均值、最大值、最小值、计算均方根 RMS、计算方差/标准差等。6 Z0 l( `1 Y' W! t9 b$ @
; q9 Z0 p& S) I' X" O
SupportFunctions
+ b3 ^; _4 t j* _0 v- X2 d支持功能函数,如数据拷贝,Q 格式和浮点格式相互转换,Q 任意格式相互转换。( F% d( I. y! p4 p
3 J: N3 b5 V5 o4 W6 O0 M
TransformFunctions" z& q& o1 e5 W$ m
变换功能。包括复数 FFT(CFFT)/复数 FFT 逆运算(CIFFT)、实数 FFT(RFFT)/实数
9 c% J# F% s$ {% kFFT 逆运算(RIFFT)、和 DCT(离散余弦变换)和配套的初始化函数
8 Y( Y% B& l! W+ Q- ? h
1 q7 O4 ?' W5 L0 }!!! 所有这些 DSP 库代码合在一起是比较多的,因此,ST 为我们提了.lib 格式的文件' C: p- u M# O; z
.lib 格式文件路径:光盘→8,STM32 参考资料→STM32F4xx固件库→STM32F4xx_DSP_StdPeriph_Lib_V1.4.0→Libraries→CMSIS→Lib→ARM。根据自己的需求选择不同的.lib文件。
' s/ a$ m+ w" O* E我们所用的STM32F4 属于 CortexM4F 内核,小端模式,应选择:arm_cortexM4lf_math.lib(浮点 Cortex-M4
7 q3 S* y+ x* r3 _$ {( \小端模式)。
2 j) ?4 T3 g! J% a3 f" e0 |示例:pandas 是基于NumPy 的一种工具,该工具是为了解决数据分析任务而创建的。, O2 n" g' r: s6 ]( A: r7 w
# U' P! N9 j. z% ^% W2 ]二、arm_cortexM4lf_math.lib7 D! @# @6 M- l, c3 d# r7 V
1.可使用的DSP函数6 G8 ^ C# D! k. w- Q4 M' d1 V
我们打开.lib文件可看到,里面存有编译后的.o文件,也就是提供可使用的DSP函数。
# p& | g2 E9 t8 A根据函数名可以粗略了解其含义,也可以度娘搜索DSP函数XXX,即可查到其含义。' M+ v5 g7 g' r% E. t6 T
后续将在实验中一一讲解。# i/ d6 l9 b- l9 Z
) l- P3 a/ m9 U( I: k代码如下(示例):! `& n+ \$ W# ?
0 A+ H: {# u# D+ f/ e, A+ k, Y3 U
- arm_dot_prod_f32.o/
! D" U4 ]# |& y. j4 y1 r8 M - arm_dot_prod_q7.o/
% O; V _# Y- N. n0 L - arm_dot_prod_q15.o/, Q$ r6 {% f$ c5 H
- arm_dot_prod_q31.o/5 I/ T; X3 \* b& J
- arm_negate_f32.o/3 Z$ {! l2 T* _: E- u' a6 N
- arm_negate_q15.o/
# z }3 j% |6 ^3 c - arm_negate_q31.o/: A, O: a6 D' M
- arm_offset_f32.o/
" v9 I% r% Y9 u& O - arm_offset_q15.o/
& f8 b$ b5 ~+ H- ?, |! n, z - arm_offset_q31.o/
. W% [# u9 u' @& g1 _9 e - arm_cmplx_conj_f32.o/
+ M& a) ~& G9 n% s: j0 e; m* @ - arm_cmplx_conj_q15.o/0 y# g. S$ d3 M
- arm_cmplx_conj_q31.o/
# p6 a7 T9 j5 T. Z" C - arm_cmplx_dot_prod_f32.o/
+ u' _: a4 L6 C' n2 W W - arm_cmplx_dot_prod_q15.o/# N- G2 r! y( \ U* n
- arm_cmplx_dot_prod_q31.o/
/ E# R, s/ Y4 p - arm_cmplx_mag_f32.o/5 Q, n& ^9 I4 I# `- K
- arm_cmplx_mag_q15.o/
$ W! \" O" L. ]3 L! ?9 k8 H - arm_cmplx_mag_q31.o/
# A# d( ?7 L! n% X! Z" b6 t. R - arm_cmplx_mag_squared_f32.o/4 e+ I- g) U# X8 w. G7 ` c
- arm_cmplx_mag_squared_q15.o/
. t( V5 ~ y2 D% b$ u* i' G3 W - arm_cmplx_mag_squared_q31.o/
, o" ]8 Z2 I" T* ~ - arm_cmplx_mult_cmplx_f32.o/
' M* e( a1 T, i+ w - arm_cmplx_mult_cmplx_q15.o/5 x* w4 w6 |$ t. u* Q% m4 {
- arm_cmplx_mult_cmplx_q31.o/6 e( u) ]& _" H& _$ `7 h+ y
- arm_cmplx_mult_real_f32.o/
a) P% A7 A3 G0 q - arm_cmplx_mult_real_q15.o/
V' b4 \. ^6 X - arm_cmplx_mult_real_q31.o/7 b8 |) V# w4 s- M
- arm_biquad_cascade_df1_32x64_init_q31.o/& h/ c8 \& W( Z7 j
- arm_biquad_cascade_df1_32x64_q31.o/1 H; F& @! O2 f. I: C. m" y, t* W
- arm_biquad_cascade_df1_f32.o/
. t/ s1 Q! D/ `! Y$ ` - arm_biquad_cascade_df1_fast_q15.o/
" \5 Y8 r( k# x - arm_biquad_cascade_df1_fast_q31.o/5 F1 k! _/ S+ F' h. T8 y
- arm_biquad_cascade_df1_init_f32.o/
, |3 u$ n7 F. J- V" I - arm_biquad_cascade_df1_init_q15.o/
7 H' q" f6 s0 M, n& u- e* C - arm_biquad_cascade_df1_init_q31.o/ n; p" ?: J1 j/ }2 P2 t% F
- arm_biquad_cascade_df1_q15.o/
# n' `, `3 f( s+ O' u8 k$ f - arm_biquad_cascade_df1_q31.o// `; e0 \8 t/ {5 O( ?
- arm_biquad_cascade_df2t_f32.o/
. t7 q0 X% o9 L' d4 a - arm_biquad_cascade_df2t_init_f32.o/
6 X$ W2 ^; `6 e" b7 `& a - arm_conv_fast_opt_q15.o/
0 I% [4 z3 k2 O/ N0 @/ J$ C - arm_conv_fast_q15.o/
: M$ z5 U& j0 f3 B! V* O - arm_conv_fast_q31.o/
4 F$ K* u6 Z" g* ^7 J L$ E - arm_conv_opt_q7.o/
# G8 L. w$ c1 p8 H+ W - arm_conv_opt_q15.o// y! Z: R4 }( \6 x( q8 L5 T5 F1 D
- arm_conv_partial_f32.o/
! V1 o0 Y& H7 s2 F( W0 f - arm_conv_partial_fast_opt_q15.o/; w* Y5 S5 x5 v0 q/ T. \. K
- arm_conv_partial_fast_q15.o/$ t4 V; {( D' h0 }) A
- arm_conv_partial_fast_q31.o/
+ I9 Q! L1 @8 g$ u- R7 n0 D2 Q - arm_conv_partial_opt_q7.o/( d+ ^" |7 M ?( `# a
- arm_conv_partial_opt_q15.o/$ @7 |3 ^1 b; R1 d2 d8 P; W- h' o8 W
- arm_conv_partial_q7.o/
; D+ y8 V% i' |# O8 e - arm_conv_partial_q15.o/0 \, s7 B* C4 k7 ^1 Q
- arm_conv_partial_q31.o/
; I* P; s, X+ t0 @$ D4 q- X& u0 [ - arm_correlate_f32.o/
; `) m: k3 n |( Q. l, p- h - arm_correlate_fast_opt_q15.o/
) B# v- l* X3 A' b3 t1 n - arm_correlate_fast_q15.o/
F7 h, _' a3 [# a, c8 P6 M4 n& X: [ - arm_correlate_fast_q31.o/
( j! Z& z4 l6 L) Y - arm_correlate_opt_q7.o/" A. G- @/ I' L4 c9 M
- arm_correlate_opt_q15.o/
: M9 K6 J: R0 X% }8 M f - arm_correlate_q7.o/, D4 J2 G4 `5 b+ }1 {3 f9 y, P
- arm_correlate_q15.o/
& N7 z: p6 a9 s - arm_correlate_q31.o// N; H- r* G, C% I5 M* h
- arm_fir_decimate_f32.o/
3 L7 E( j c7 \, |; P. r- C* ~5 E - arm_fir_decimate_fast_q15.o/7 s2 z, w- v8 K% @
- arm_fir_decimate_fast_q31.o/9 ]# @! \, B% ]3 Q4 t5 Y1 L
- arm_fir_decimate_init_f32.o/
& _: z' d( J9 Q0 w" g( r" n - arm_fir_decimate_init_q15.o/
" Z1 B8 {3 |* W/ i% a - arm_fir_decimate_init_q31.o/
$ |+ q& d" P+ D- n; d1 b% A - arm_fir_decimate_q15.o/! y. v( z; O5 M# ]7 x
- arm_fir_decimate_q31.o/
7 ?8 p! [7 Z' d. ^ - arm_fir_fast_q15.o/3 L; S7 p4 U2 u* I2 c' |9 k
- arm_fir_fast_q31.o/
! ` U2 W4 B9 ?! a% B5 A - arm_fir_init_f32.o/
* h: t& {% J8 z! [7 o5 h - arm_fir_init_q7.o/
, ~: [1 o9 W$ T" L - arm_fir_init_q15.o/
) x. x0 J: J' ]0 E- @1 F( e - arm_fir_init_q31.o/
$ u: P8 o, x5 s |. n' B! @8 L - arm_fir_interpolate_f32.o/# [0 [. }9 F5 Y% q! V8 |
- arm_fir_interpolate_init_f32.o/
" u9 \' ^: Q X8 J - arm_fir_interpolate_init_q15.o/( C' B# \3 _1 `( m. l* O- b
- arm_fir_interpolate_init_q31.o/
/ u& E. |( L1 u$ j' a2 N; l" g$ b. z - arm_fir_interpolate_q15.o/; L# ?' L1 I5 h! ?( }( o
- arm_fir_interpolate_q31.o/
: x$ l$ V# u$ n8 f% V - arm_fir_lattice_f32.o/
) H8 @0 J) r* w5 _% M; x3 j - arm_fir_lattice_init_f32.o/
# H- u0 Z* W% w; y, A+ L8 M - arm_fir_lattice_init_q15.o/, W6 q! t8 a: s/ \& c6 x; w/ s
- arm_fir_lattice_init_q31.o/( e r. S! J% m6 \
- arm_fir_lattice_q15.o/
' [* S t- Q( z6 |- p$ E' h - arm_fir_lattice_q31.o/
, q/ S; _) q7 M- B, a( ? - arm_fir_sparse_f32.o/
, ^8 \% R+ h; N" L - arm_fir_sparse_init_f32.o/
# M( {) [1 h9 @5 i$ D5 G; U - arm_fir_sparse_init_q7.o/
# O/ }+ l9 l) i0 H8 |6 b - arm_fir_sparse_init_q15.o/
" y# S6 v+ }9 _3 O3 \ - arm_fir_sparse_init_q31.o/! d4 [- o7 S3 |& a G
- arm_fir_sparse_q7.o/
4 R* O9 Z& e3 M* q - arm_fir_sparse_q15.o/9 }$ ~) _0 @0 r/ d* H' y% T& C4 i
- arm_fir_sparse_q31.o/1 s. n, }2 k) r; A+ a4 H" f
- arm_iir_lattice_f32.o/$ Y+ W6 E. Y& M2 f! Q
- arm_iir_lattice_init_f32.o/
# s9 g" g% P: ]& [- T9 }; `( h) e - arm_iir_lattice_init_q15.o/
) |# Q) e+ |6 h# S5 b5 [" k - arm_iir_lattice_init_q31.o/
8 }9 M* U$ H( I* }# X: t% R* O - arm_iir_lattice_q15.o/
" b5 A0 F V9 {+ ~# _9 F - arm_iir_lattice_q31.o/
9 d# v" `$ i8 c7 h1 @ - arm_lms_init_f32.o/
8 k, D, M* @5 s - arm_lms_init_q15.o// Y7 Y2 o- W: v1 A6 {7 z
- arm_lms_init_q31.o/4 e ^5 K. X; A1 E; j$ l$ B
- arm_lms_norm_f32.o/
* _+ \ \, G E$ U2 y - arm_lms_norm_init_f32.o/
2 w4 j8 G% G1 G: e. O1 y1 b9 s - arm_lms_norm_init_q15.o/
4 P" ~1 g3 U0 ~8 Q2 A - arm_lms_norm_init_q31.o/! s( H% `0 _0 f# ~( D% I
- arm_lms_norm_q15.o/
$ z' N2 S% V/ K5 K7 G - arm_lms_norm_q31.o/ g$ y( ]2 n& L
- arm_mat_add_f32.o/3 z" w; p5 |1 @) ^$ ?( {
- arm_mat_add_q15.o/
1 N/ ^* `4 q N1 v$ M - arm_mat_add_q31.o/# _1 D/ K t4 A! H
- arm_mat_init_f32.o/
: Q8 h2 [0 g- P9 w/ A p - arm_mat_init_q15.o/# T, D3 x! i1 l% W* C a1 X
- arm_mat_init_q31.o/2 O) L; [4 S3 e8 Q
- arm_mat_inverse_f32.o/
; O+ F. p3 y! ^4 ` - arm_mat_mult_f32.o/
! x4 [6 Y( n$ C8 P- ? - arm_mat_mult_fast_q15.o/
( \4 z' c. P1 a, s - arm_mat_mult_fast_q31.o/
5 r) i& y; E5 u6 I' ] - arm_mat_mult_q15.o/
6 ]+ _% q" w# Y4 |9 n: g- E, W - arm_mat_mult_q31.o/
, K! d, M( A* \# w5 D' @5 ~9 V - arm_mat_scale_f32.o/
$ ]6 [6 {" n- W7 A T8 X, x1 ] - arm_mat_scale_q15.o/
8 r- ]' O* w, z# h8 P - arm_mat_scale_q31.o/
6 F2 u6 Z0 u& V! F" ~* ]2 @% z; J p - arm_mat_sub_f32.o/
7 [6 I% u6 h4 c - arm_mat_sub_q15.o/( g# A) T x8 N$ O- V
- arm_mat_sub_q31.o/9 ?. O) }& a0 S; G: _, M/ o* k, K4 p
- arm_mat_trans_f32.o/% r$ K: a6 Q- m6 t) V
- arm_mat_trans_q15.o/
; w6 \' E! s2 Y+ e5 p - arm_mat_trans_q31.o/: P) R2 a' x) V% ?+ v
- arm_bitreversal.o/
" u# j. v8 A' `* C+ N - arm_bitreversal2.o/
8 S0 k( [. k0 b4 [: j; G! t7 L( v - arm_cfft_radix2_f32.o/
! I. J0 O4 ^% s* I - arm_cfft_radix2_init_f32.o/
# ~1 r8 _" [4 r - arm_cfft_radix2_init_q15.o/2 z6 r" q! V% C; p( Q. U. V
- arm_cfft_radix2_init_q31.o/
* f& d% ?% t; x0 g' j8 B6 ~7 e9 t5 Z - arm_cfft_radix2_q15.o/
# d R. p( E, X8 f; b1 _' | - arm_cfft_radix2_q31.o/
8 a. q8 _3 Y. G7 o5 l1 U - arm_cfft_radix4_f32.o/
% K( i/ P1 M7 U/ L7 M; I; w. r _ - arm_cfft_radix4_init_f32.o/% o& U C3 ~. ~8 s! K
- arm_cfft_radix4_init_q15.o/& i. o' C) t* q, ^& G
- arm_cfft_radix4_init_q31.o/
r- g3 {+ X" c) i k- S - arm_cfft_radix4_q15.o/
+ B3 ? b! d: ?# V: ^, ` - arm_cfft_radix4_q31.o// P2 F6 R% I0 V3 w
- arm_cfft_radix8_f32.o/+ r. h7 h) G$ J7 `. G$ a) E+ S: U2 p
- arm_dct4_init_f32.o/5 |; m2 h* f2 D* v+ R& [2 |
- arm_dct4_init_q15.o/$ \8 `) E0 \: n9 E$ a+ s1 J& J
- arm_dct4_init_q31.o/3 N; o, M9 p5 T$ l; n0 e9 O* ~
- arm_rfft_fast_f32.o/
7 c! I( i7 X9 R7 I, T - arm_rfft_fast_init_f32.o/8 J: J( Q; G5 F8 z& P, W E
- arm_rfft_init_f32.o/
' [ X! K% w& J( s - arm_rfft_init_q15.o// w7 A$ l: S; y
- arm_rfft_init_q31.o/
* w; h/ o8 ^% J& R6 X' e* u - arm_pid_init_f32.o/, x( b& ^4 j k( x4 i' j, t
- arm_pid_init_q15.o/) Y0 T' \6 R+ D; C
- arm_pid_init_q31.o/
. N) y9 Z# r; p: Q6 \ - arm_pid_reset_f32.o/5 V" { N1 k* w# W: ~
- arm_pid_reset_q15.o/' S" p, F1 Y% s. |# o2 a
- arm_pid_reset_q31.o/
5 f" ~& i0 D$ s/ w9 O& [9 M - arm_sin_cos_f32.o/. Z: ?# f8 d3 [
- arm_sin_cos_q31.o/0 Y5 f0 U. z' D2 k
- arm_float_to_q7.o/8 e4 m% ~. Q$ ]' C6 t( k# t
- arm_float_to_q15.o/7 Q" b: e$ v6 f. Z' X9 L
- arm_float_to_q31.o/4 L0 I) o; A' m' c+ u! ?: A5 f- }
- arm_q7_to_float.o/7 s6 }0 {6 T" `5 C6 _" |/ I
- arm_q15_to_float.o/: t- L* f% A' \6 ]8 O6 Q- u0 m
- arm_q15_to_q31.o/
5 Z# q3 p" ~ a1 E' ^ - arm_q31_to_float.o/
& @0 d; n4 C4 B. K* B1 e - arm_q31_to_q15.o/
, ^% T# A% h* R - arm_common_tables.o/
2.工程移植7 V0 F$ I" ?! Z" q
1、添加文件。
# x l0 R7 Y9 J- z# y7 I6 ^: x2 {首先,我们在例程工程目录下新建:DSP_LIB 文件夹,存放我们将要添加的文件:arm_cortexM4lf_math.lib 和相关头文件,然后,打开工程,新建 DSP_LIB 分组,并将 arm_cortexM4lf_math.lib 添加到工程里面。
0 c+ }5 \ W* u
; W# L [: x$ b2、 添加头文件包含路径
( t0 T# V/ ]+ L A' n添加好.lib 文件后,我们要添加头文件包含路径,将第一步拷贝的 Include 文件夹和 DSP_LIB
4 Q6 F! Q3 B6 F, e文件夹,加入头文件包含路径。
; Z( u6 j$ R' |& I& x Q
/ m, C+ X- e/ D3、 添加全局宏定义: K4 ~' _$ V( Q& C
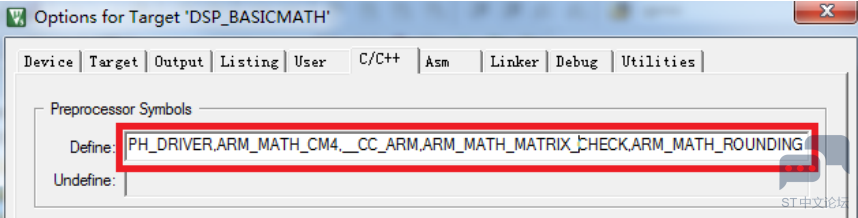
最后,为了使用 DSP 库的所有功能,我们还需要添加几个全局宏定义:* L" B* b7 A) c
1,__FPU_USED
$ [- a4 B5 Z. {4 X+ Q2,__FPU_PRESENT! o' I$ m7 f5 P. o+ ~
3,ARM_MATH_CM4, { c9 p! j. v+ z$ M
4,__CC_ARM( ^1 ~( {1 F: F2 S6 z# D+ n* r( U
5,ARM_MATH_MATRIX_CHECK# d1 e8 Y5 g+ {8 y% c
6,ARM_MATH_ROUNDING+ e9 w3 }/ O; P6 n D3 c9 |
( @, v& p& \* _
. {, Y5 r H0 i$ h, W5 U# \5 f: y; s) R! {: _4 e
这里,两个宏之间用“,”隔开。并且,上面的全局宏里面,我们没有添加__FPU_USED,
9 M! \. D9 h2 X/ d4 u" @7 }因为这个宏定义在 Target 选项卡设置 Code Generation 的时候(上一章有介绍),选择了:Use FPU5 G: g6 y `4 z) R2 Q1 }4 B
(如果没有设置 Use FPU,则必须设置!!),故 MDK 会自动添加这个全局宏,因此不需要我们
0 Q( r& r! D+ D! r1 }7 A: [) I手动添加了。同时__FPU_PRESENT 全局宏我们 FPU 实验已经讲解,这个宏定义在 stm32f4xx.h$ R" [% C& R3 i2 }6 e5 I6 Y8 y
头文件里面已经定义。 这样,在 Define 处 要 输 入 的 所 有 宏 为 :0 w& H* }+ J) g0 d5 c, q+ m
STM32F40_41xxx,USE_STDPERIPH_DRIVER,ARM_MATH_CM4,__CC_ARM,ARM_MATH_M
. _5 X; a V1 w9 E# ^% yATRIX_CHECK,ARM_MATH_ROUNDING 共 6 个。
0 \% Q% B& G* d" Y; z" a0 o至此,STM32F4 的 DSP 库运行环境就搭建完成了。特别注意,为了方便调试,本章例程我们将 MDK 的优化设置为-O0 优化,以得到最好的调试效果。
5 j! T, ~0 m* I1 N' A0 b! B( W# C" _' b4 F* m7 S) f" ~- Q; T2 s
4 B8 r, S* f' L& d
|





 STMCU小助手
发布时间:2022-7-6 15:05
 微信公众号
 手机版