家介绍经典C语言平方根倒数速算法(或称Fast Inverse Square Root)。详细推导魔法数字0x5f3759df究竟从何而来,并最终在MCU上对比该算法和<math.h>中double sqrt(double)方法的性能表现并给出使用建议。本文不涉及高深的数学变换或复杂的计算机原理,但希望读者具备一些C语言基础;此外任何相关领域的积累都可能有助于内容理解。
6 ?) \) D b9 z' X6 L r3 k6 w/ A7 O
希望本文能帮助到有需要的朋友。5 I* |) G( v5 J# c7 B0 `
( J y9 P% A+ z, _9 C* U# y
平方根倒数简介
1 o o/ h4 o: i4 G5 V求平方根倒数在向量单位化操作中很常见,先举个例子,假设在二维平面内有一向量:2 w4 ?" v" _; ~4 A- F* u! a
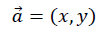
( X2 y5 n9 Q" w6 r
将该向量单位化,即将向量模长缩放为1,用向量除以它的模,可以表达成下式:
1 d8 q9 @0 u/ J( N2 ^3 K+ q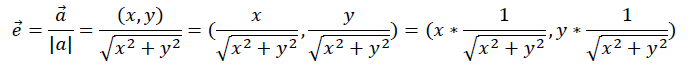
% ?! Z( a+ z" m" h
此处,单位向量的坐标,即是原向量坐标和模长倒数的乘积。% m+ O& b( F* v: B+ S
一般而言,对任一数x, 
即被称作平方根倒数。! q7 Q* @; A/ k$ T
' X/ P9 k$ l7 lC语言内求平方根倒数
+ R1 B1 ^. g+ w1 {( P& X/ ]5 lC语言内求平方根属于常规操作,因为<math.h>中已经提供了double sqrt(double)函数给大家调用,该函数接收一个double型变量,并返回其平方根。部分场合使用float类型,如果是我,我会这么写: - #include <math.h>
# x* r. Z) e# L8 x# ] -
% s6 L9 r& {2 ^$ p - float x =0;2 i8 }5 Y; {; P0 B `0 D7 S5 {+ M
- & D4 J5 j2 F2 o; v) P5 z
- float inverse_square_root =0;3 r7 P% _" O. \; J$ E
- / ]6 ~, ]9 ~" l. [3 T8 B' l
- inverse_square_root =1/sqrt(x);
% @9 n1 n! w: q6 h- @7 A0 D" ?+ _! r
事实上,大多数计算机处理加法和乘法时更快,对于除法和开方运算,速度相对较慢。定义在<math.h>中的sqrt()方法其系统开销是比较大的,尤其在部分MCU上,有时不能很好地满足系统实时性要求。
) G2 j$ g- f, m# v
速算法介绍
8 F& a% n0 I+ u& i9 E该情景与上世纪末PC算力较低的情况颇有几分相似,而在那段PC内存按MB计算的岁月里,优秀的C语言程序员们找到了该问题的解决方法:平方根倒数速算法(Fast Inverse Square Root),据说该算法最早由GaryTarolli在SGI Indigo开发中使用,对起源感兴趣的朋友可自行探究。
+ d- ?! k8 K+ b2 B5 M' a* w, @0 b$ ~' X平方根倒数速算法是一个单独的函数实现,代码如下:- float FInvSqrtRoot(float x)0 d+ F$ f# b9 D6 `3 D9 u
-
2 V2 q. ]) U/ E4 [7 G - {7 R1 `: B4 Q1 E# i6 c* z* f- C
-
4 Q- J( i% k; F3 Z - long i = 0;
7 o" a: B, p) o* Y -
, X. @ G' P9 r, s - float y, halfx;
9 t9 [8 ?0 }4 n7 E -
( N$ ], o8 U @5 U - halfx = 0.5 * x;
# n5 i9 B- m, W: q/ |9 V( j) Y -
0 c5 \0 P% n' S - i = *(long*) &x; // 按照整型方法操作浮点数7 `7 ~( V9 O) {! Q, ^9 _
- $ R0 L8 Y+ E8 @
- i = 0x5f3759df - (i >> 1); // 魔法?
7 {+ Q# R: y# L5 A0 w - - v6 \! l- n( U1 k! [9 c
- y = *(float*) &i; // 获得平方根倒数近似值+ b, E0 T7 b( w/ ]8 N9 i' s
-
% N0 y3 J4 r6 x# X: G% R* a$ u - y = y * (1.5 - halfx * y * y); // 一次牛顿迭代, j. \) Q2 A. n6 @# ~% g
-
" S4 l& V3 u% h* j - return y;
, X1 {2 |/ L/ K0 | -
$ C, z6 S( q, J - }
 2 S0 w$ q. Z% C% m0 o8 Q+ o
+ W, \& ^' |9 J4 i0 W0 r' |2 o* V
该函数接收一个float型变量,并返回其平方根倒数。 4 z' G/ n0 Y. a7 G; J2 z+ D# b
Step1.奇怪的地址类型转换 - i = *(long *) &x; // 按照整型方法操作浮点数
代码第四行将浮点数x按照整型数据操作,这里的操作方法与类型转换有很大不同;类型转换将内存中按照浮点数标准表示的值近似为最接近的整数,并按照整数标准储存在内存中,像这样:i=(long)x;要理解*(long *) &x与(long)x的不同,需要了解浮点数在计算机中的表示方法。
' R( z# S/ w* |# d$ ~, t& w浮点数在计算机中使用类似科学计数法的形式储存,float类型的浮点数使用32bit表示,结构如下:
" b6 ^3 x* Y. d

" ?2 y5 P d3 D
最高位,第31位,为符号位,若S=0,该浮点数为正数;若S=1,该浮点数为负数。9 I5 @& Q5 t# W, b- q* f- f
接下来的8位数字,为指数部分,指数E范围为[0,255],为可以表示负指数,规定在E的范围基础上-127,即[-127,128];例如E=3表示2^(3-127)=2^(-124)。9 X# [1 J4 R p' k7 H9 t' u& C! B. {7 I
接下来的23位数字,为尾数部分,即有效数字部分。由于二进制下有效数字必为1.xxx的形式,整数部分必为1,因此无需使用第22位表示整数1,而是直接表示小数点后一位,整数部分不在尾数M中体现,只在计算时加上;即M=0101…表示二进制的1.0101。以上,float型浮点数在内存中的存放形式已经明确。
% e& U! B) w0 ]: p现假设有一float型浮点正数x,其在内存中按照上述方式存放,即: 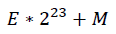
则x表示的浮点数值为: 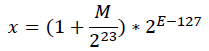
注意平方根倒数速算法只接收正数,所以全文只讨论x为正浮点数的情况。 此时再回来看i=*(long *) &x这行代码; 第一步;取x的地址,注意此时x的地址指向一个浮点数,内存中对应的数据为:E*2^23+M 第二步;将该地址转换为指向long整型的地址,注意转换的是地址类型而不是数据,现在内存中的数据仍然是:E*2^23+M 第三步,取该地址指向的数据,赋给i;此时程序将按照整型标准去读取这个数据。因此,可以将i理解为x对应内存数据的整型解释。现在可以对i进行整型支持的操作,比如接下来要用到的位移操作。 准备工作已经完成,现在进入算法的核心,即施放魔法: - i = 0x5f3759df - (i >> 1); // 魔法?
3 W8 W7 n/ j3 M) c, b2 D要理解这行代码,需要一点点数学铺垫;我们先给x表示的浮点数取个对数: 
其中,M表示尾数,M/2^23范围在[0,1)之间;在极限理论中,若x属于[0,1],有以下关系: 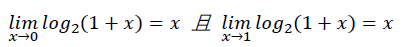
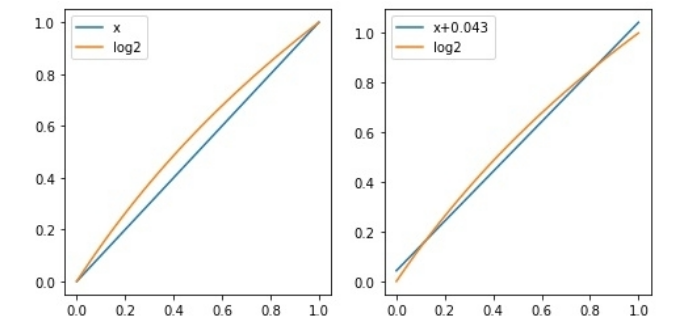
即在x接近0或1的条件下,log2(1+x)接近x;很明显当x不靠近0或1时,误差会变大,如下图左侧所示: 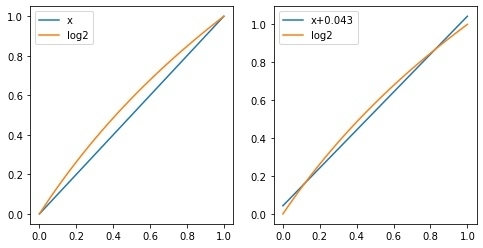
如果在等式右侧加入一个微小量u,可以使得x+u在[0,1]范围内近似log2(1+x),如上图右侧所示: 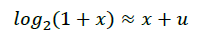
所以有: 
因此, 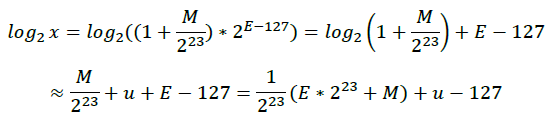
4 s6 F2 k, N2 C# [
& q& H/ J. I. F0 X. a7 n' V! E此时再倒回去看浮点数x在内存中的存放形式,即:E*2^23+M; 因此可以认为浮点数的对数形式与其内存存放形式相似,只是添加了缩放和平移。我们知道: 
令: 
所以有: 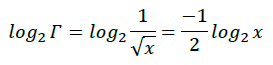
将上式展开: . A2 e( M7 m9 b8 d8 E; X
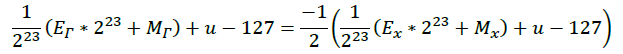
稍作整理: 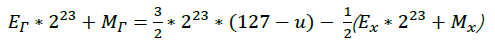
这太棒了,因为浮点数在内存中的存放形式,即:E*2^23+M 而上式中 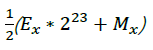
则相当于对其内存形式右移1位,即 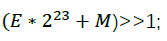
由此可知,魔法数字0x5f3759df就是包含u在内的修正项: 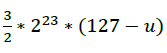
至此我们已经完成了魔法代码的解析: 这太棒了,因为浮点数在内存中的存放形式,即:E*2^23+M 而上式中 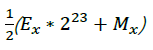
则相当于对其内存形式右移1位,即 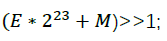
由此可知,魔法数字0x5f3759df就是包含u在内的修正项: 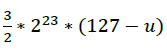
至此我们已经完成了魔法代码的解析: - i = 0x5f3759df - (i >> 1); // 魔法
1 N- W* E- ~8 y& Qi就是x对应内存数据的整型解释,将i右移1位相当于乘以二分之一,也就是1/2*(Ex*2^23+Mx); 等式右侧的运算结果,就是 
,也就是 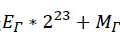
即 
注意此时程序认为i是整型变量,所以需要下一行代码再将其转换为浮点型; y = *(float *) &i; // 获得平方根倒数估计值此时y即是x的平方根倒数。
. ]& j* C# B' T( Y% y
Step3.优化结果
3 r }/ }* h9 d7 @. A2 L由于上述推导中,引入了修正系数u,所以y只是近似解。0 l+ c1 M% z% A1 O3 \
! x% w% U8 H# z* V1 Z# _- V4 H接下来使用牛顿法(Newton Method)进行一次迭代,使y更接近准确值。简单来说,使用牛顿法,可以从一个近似解获得一个更接近准确答案的解;牛顿法的核心思想是迭代,对于我们正在讨论的问题,属于已知x求y的类型,即& U% B3 w( }" `; |
6 u, r7 F) U% k8 E

# H( s( @; P9 O9 @+ A! j
+ ?! \0 T4 I. ~; p# u& E假设已经获取一个近似解y1,则可以通过一次迭代求取更优解y2:
9 i6 m& _: w( m' ~/ D. J0 [( s4 S+ W2 h3 N" q4 _
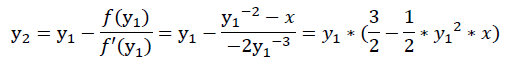
3 {' r3 g: E+ O" Q" n$ B9 g v
1 O; H$ p3 H% l2 L神奇的是计算y2仅需要乘法和减法运算,于是有如下代码:
9 D$ G& X6 X; i4 h5 g. C+ b
2 }; `& N: p- M1 B+ Z- ?! n' vy = y * (1.5 - halfx * y * y); // 一次牛顿迭代' [3 M% m7 {; ], W1 W
1 w5 J! X2 b4 y: W! N该行代码返回优化后的平方根倒数,也就是最终运算结果。
% z& \% n' z5 _% `# ]$ `9 M, y- |; V+ ?, n8 e" {
性能测试
. W# J1 U4 z( k接下来我会在STM32G071上测试Fast Inverse Square Root算法与<math.h>中提供的double sqrt(double)算法的性能,并尝试以此证明它为何被尊为经典。STM32G071运行在64MHz下,编译器和调试器优化分别为-O0和-g3。
; S8 g7 u' f- z; B使用uint32_t替代long型:% C, {8 n" d6 O: z& W. _1 ~
2 n L8 y" R# ~1 y
- float FInvSqrtRoot(float x)% u0 J; n0 [" h1 ?* B
- # g6 X! O3 D! @8 P: n
- {
W/ w7 ^2 B, }6 O6 a- d; Z" F - 4 J; ^2 `6 O+ G. k. N
- uint32_t i = 0;
. w& A* Q' D8 V) P$ F& `! u -
( ]! u* [8 v* |7 ]( l. Z9 ` - float y, halfx;
, C4 P1 D2 t- h0 l9 Z, g3 R -
. ~5 _( s1 R- P! q/ ~5 f4 |9 J2 M# x - halfx = 0.5 * x;1 J: |) X, N r# o5 }" i
- ' s9 |) s/ z, M6 V
- i = *(uint32_t*) &x; // 按照整型方法操作浮点数* M @" T2 O0 G9 Z' x7 u5 S' s
- ; u/ ?( D0 t& {: S/ n% M( d) K1 }
- i = 0x5f3759df - (i >> 1); // 施放魔法. Y) [5 `" W7 x, S+ Q" C
- ) T1 k) s" Q9 j8 q# n+ v
- y = *(float*) &i; // 获得平方根倒数近似值
7 g7 y8 [6 _9 E# r3 a g7 Q - 3 O7 D) E+ _. \
- y = y * (1.5 - halfx * y * y); // 一次牛顿迭代. W9 e$ k, z7 a, o6 Q
-
( U1 y/ Y: Y& ?& d - return y; h: b0 p' x- S) V) k
- : p4 p3 A& n' S3 W; b' s$ w) d
- }
) ]) H- C; j' h( z A+ U
( b6 L. t5 c/ P8 f: B6 q因为STM32G071的RAM大小为36KB,先构造了8000个float数据的数组,大小为32KB;构造方法如下:2 F3 G% O$ F4 \$ ^' J6 v0 Q3 R0 l
* h2 H8 Q$ } y' U& d
J4 \% m, c, n( s* R
- float test_data[8000] ={ 0 };
+ O, G% g0 U7 |5 N. E$ g5 ^ - ' B. ]) T8 k3 s6 w) a- e
- for (uint16_t i = 0; i < 8000; i++)
! r) d5 \1 E+ E" K - / R; {. ~9 P: x# d; ]$ V- N
- test_data[i] = i * 1000 + (float)i / 1000;
: B' X3 M# p* a; V4 q使用两种不同算法处理上述8000个数据,测试代码如下(注意此处仅作演示,测试方法不一定严谨):' @& t6 u# c1 a0 _" f$ g
4 r6 D, M, F1 l
- //平方根倒数速算法
p j) F; Q7 ]. N3 h# B; e -
* o0 p: f, [$ M6 x2 K; f - printf("FISR Test Start!\r\n");
# ^: w# }( c! M, |" n( g# n; Z# u - # [ y q3 I8 E8 m6 m
- ticks = 0;//定时器计数,1ms/tick O3 a7 r' b+ z! K/ n* _
-
7 D2 w* W+ _0 u) u3 a; E/ x - HAL_TIM_Base_Start_IT(&htim1);
* Y9 b0 G, l; e3 ^ - & T# @+ [' z; u
- for (uint16_t i = 0; i < 8000; i++)4 e/ |% {9 A1 N4 t, t- Y
- : I* Q7 \$ y& m+ h, w$ u! a
- sroot=FInvSqrtRoot(test_data[i]);9 {+ H& Y2 e1 @/ y) J; T0 ~
- " H9 I% u- P3 X
- HAL_TIM_Base_Stop_IT(&htim1);
6 f( o, I3 u$ C' D+ ~% ^: b+ A2 } - % i# H% h. I, w/ T3 C- G' ?& N
- printf("FISR Test Stop!\r\n");4 D& t& i4 ~# A0 B
- : o* G/ C+ V8 d) j' b
- printf("FISR Time Elapsed:%f\r\n", ((float) ticks) / 1000);
3 z" w* v' M; O! F a. T - # Y. L7 r. y; @+ X+ z) w, n
- . C% w' B& Q5 m/ @: u1 K- f7 t
-
# y- }% D k0 ^8 ]; t( C - //传统1/sqrt()6 R8 F3 S) w' B+ w D( o
-
' ?- t* L( {! d8 W0 x. g - printf("SQRT Test Start!\r\n");
, p" f0 f. G/ b- W j$ f' I - 8 l% I" @% w6 m5 W( C8 F( u
- ticks = 0;& L% M/ C# Q* D5 r5 Z
-
! m b5 X: N% k( m - HAL_TIM_Base_Start_IT(&htim1);
/ ^; n* }* q0 j0 V -
2 V0 y$ o7 ~# } - for (uint16_t i = 0; i < 8000; i++); P, W" z! O6 N1 I% J6 r2 x: J% S9 }
- ) ], [$ l2 @2 @- Y
- sroot=1 / sqrt(test_data[i]);
. {# Z3 w; @4 T0 A6 s - 2 k) g1 p% h/ k9 ?! J
- HAL_TIM_Base_Stop_IT(&htim1);) {* _8 u6 k% R
- $ o( [) v) r+ B' t' w. d) F; E
- printf("SQRT Test Stop!\r\n");. Z8 y- f2 f# }( I
-
3 B) l* x3 u* Z% O, f - printf("SQRT Time Elapsed:%f\r\n", ((float) ticks) / 1000);
在上述测试环境下,FInvSqrtRoot耗时181ms,1 / sqrt()耗时325ms,FInvSqrtRoot比1 / sqrt()快大约79%。由于sroot是float型,sqrt()返回double型,所以1 / sqrt()测试时有额外的类型转换损耗;将sroot更改为double型,则类型转换损耗由FInvSqrtRoot承担;该状态下,FInvSqrtRoot耗时187ms,1 / sqrt()耗时315ms,FInvSqrtRoot比1 / sqrt()快大约68%。注意FInvSqrtRoot求取的仅是平方根倒数的近似值,和1 / sqrt()比对,误差约在1%以内。, J5 p. B/ }9 z! H
9 ~" B% l& I: `
魔改:平方根速算法
6 }0 |( k" U$ Y1 m1 l. A根据上述原理,可将平方根倒数速算法修改为平方根速算法,代码如下:2 S) j9 X# k9 `& l+ ^) ?
z" x3 V' s/ t6 F- float FSqrtRoot(float x) {
; R4 i6 q# n9 X; s4 A+ I -
. @6 W) o" N5 V; r @! W: y% P2 a - uint32_t i = 0;
2 o; u, w. G. O3 K0 T - / `7 R3 q& l( B
- float y;
) t9 n# [0 v c* U/ _ -
, B$ `8 G/ s+ w) B- C$ M& @ - i = *(uint32_t *) &x; // 按照整型方法操作浮点数
; m0 x1 z: d+ M" C - \! T4 f5 l/ p/ `
- i = 0x1fbd1df5 + (i >> 1); // 施放魔法
y b' s+ C+ _' r5 L9 ~* h1 x -
; u% {$ ~: P7 R3 p% \ - y = *(float *) &i; // 获得平方根近似值: e. F" P" k6 Z$ @# w% k7 [
-
* l# ]1 S9 P1 i: J& s - y = 0.5 * (y + x / y); // 一次牛顿迭代
6 r, M3 {2 N, {5 W* w -
, r Y) F- D6 Y' l - return y;
3 J3 E5 Y$ ?2 e: R" Z8 b: ?5 E: z -
* V6 D) v# l1 t/ ^9 Q - }
在上述测试环境下,FSqrtRoot耗时109ms,sqrt()耗时221ms,FInvSqrtRoot比sqrt()快大约100%。由于sroot是float型,sqrt()返回double型,所以sqrt()测试时有额外的类型转换损耗;将sroot更改为double型,则类型转换损耗由FSqrtRoot承担;该状态下,FSqrtRoot耗时115ms,sqrt()耗时208ms,FInvSqrtRoot比sqrt()快大约80%。
5 i0 _4 W- ^/ I感兴趣的朋友可自行推导实验,算法性能也请根据实际需求比对。+ G2 m* A" d2 ^7 U/ H
---------------------
3 b& F! _" l5 m; h5 c作者:Litthins
& B- X# j E7 q8 \% Y; Q7 X
4 ?2 w" s- [, c3 u6 ^+ G& n0 C0 ~4 _# N1 O. o c$ N; l5 I! g9 ^" z
|





 STMCU小助手
发布时间:2022-12-10 19:00
 微信公众号
 手机版