STMCU小助手
发布时间:2022-9-26 21:12
|
Linux并发与竞争 Linux是一个多任务操作系统,肯定会存在多个任务共同操作同一段内存或者设备的情况,多个任务甚至中断都能访问的资源叫做共享资源,就和共享单车一样。在驱动开发中要注意对共享资源的保护,也就是要处理对共享资源的并发访问。比如共享单车,大家按照谁扫谁骑走的原则来共用这个单车,如果没有这个并发访问共享单车的原则存在,只怕到时候为了一辆单车要打起来了。在Linux驱动编写过程中对于并发控制的管理非常重要,本章我们就来学习一下如何在Linux驱动中处理并发。 27.1 并发与竞争& s5 m* \. E# [( N; ?) `8 H3 W 1、并发与竞争简介- Q' f! T/ g* s* e) F# G0 P: C 并发就是多个“用户”同时访问同一个共享资源,比如你们公司有一台打印机,你们公司的所有人都可以使用。现在小李和小王要同时使用这一台打印机,都要打印一份文件。小李要打印的文件内容如下: 示例代码27.1.1 小李要打印的内容 我叫小李: |0 |& A7 P7 a+ j 电话:1234566 g" k( G4 ~2 C 工号:16: M5 u# [, d. H 小王要打印的内容如下:$ S2 a+ u9 C/ G5 ~+ H- j5 I) M 示例代码27.1.2 小王要打印的内容 我叫小王1 D+ A4 E/ R. a' d+ I/ v) I! d 电话:678910 工号:20 这两份文档肯定是各自打印出来的,不能相互影响。当两个人同时打印的时候,如果打印机不做处理,可能会出现小李的文档打印了一行,然后开始打印小王的文档,这样打印出来的文档就错乱了,可能会出现如下的错误文档内容: 示例代码27.1.3 小王打印出来的错误文档 我叫小王5 L" Y8 k, E! E1 Q8 w7 h& T+ @& h 电话:123456 工号:20 可以看出,小王打印出来的文档中电话号码错误了,变成小李的了,这是绝对不允许的。如果有多人同时向打印机发送了多份文档,打印机必须保证一次只能打印一份文档,只有打印完成以后才能打印其他的文档。 Linux系统是个多任务操作系统,会存在多个任务同时访问同一片内存区域,这些任务可能会相互覆盖这段内存中的数据,造成内存数据混乱。针对这个问题必须要做处理,严重的话可能会导致系统崩溃。现在的Linux系统并发产生的原因很复杂,总结一下有下面几个主要原因: ①、多线程并发访问,Linux是多任务(线程)的系统,所以多线程访问是最基本的原因。, W0 \1 _+ P- T9 D; T6 l# l/ o& `5 i ②、抢占式并发访问,从2.6版本内核开始,Linux内核支持抢占,也就是说调度程序可以在任意时刻抢占正在运行的线程,从而运行其他的线程。+ w# W$ Y7 d3 m. T ③、中断程序并发访问,这个无需多说,学过STM32的同学应该知道,硬件中断的权利可是很大的。6 g+ k5 r4 w: L# I7 D- ?) w. ] ④、SMP(多核)核间并发访问,现在ARM架构的多核SOC很常见,多核CPU存在核间并发访问。 并发访问带来的问题就是竞争,学过FreeRTOS或UCOS这类RTOS的同学应该知道临界区这个概念,所谓的临界区就是共享数据段,对于临界区必须保证一次只有一个线程访问,也就是要保证临界区是原子访问的,注意这里的“原子”不是正点原子的“原子”。我们都知道,原子是化学反应不可再分的基本微粒,这里的原子访问就表示这一个访问是一个步骤,不能再进行拆分。如果多个线程同时操作临界区就表示存在竞争,我们在编写驱动的时候一定要注意避免并发和防止竞争访问。很多Linux驱动初学者往往不注意这一点,在驱动程序中埋下了隐患,这类问题往往又很不容易查找,导致驱动调试难度加大、费时费力。所以我们一般在编写驱动的时候就要考虑到并发与竞争,而不是驱动都编写完了然后再处理并发与竞争。 2、保护内容是什么 前面一直说要防止并发访问共享资源,换句话说就是要保护共享资源,防止进行并发访问。那么问题来了,什么是共享资源?现实生活中的公共电话、共享单车这些是共享资源,我们都很容易理解,那么在程序中什么是共享资源?也就是保护的内容是什么?我们保护的不是代码,而是数据!某个线程的局部变量不需要保护,我们要保护的是多个线程都会访问的共享数据。一个整形的全局变量a是数据,一份要打印的文档也是数据,虽然我们知道了要对共享数据进行保护,那么怎么判断哪些共享数据要保护呢?找到要保护的数据才是重点,而这个也是难点,因为驱动程序各不相同,那么数据也千变万化,一般像全局变量,设备结构体这些肯定是要保护的,至于其他的数据就要根据实际的驱动程序而定了。 当我们发现驱动程序中存在并发和竞争的时候一定要处理掉,接下来我们依次来学习一下Linux内核提供的几种并发和竞争的处理方法。 27.2 原子操作 27.2.1 原子操作简介( E f1 P8 S6 M; g7 u 首先看一下原子操作,原子操作就是指不能再进一步分割的操作,一般原子操作用于变量或者位操作。假如现在要对无符号整形变量a赋值,值为3,对于C语言来讲很简单,直接就是: a = 39 M. S2 g3 K4 n% J& I1 ~* J2 a5 F1 S 但是C语言要先编译为成汇编指令,ARM架构不支持直接对寄存器(内存)进行读写操作,要借助寄存器R0、R1等来完成赋值操作。假设变量a的地址为0X3000000,“a=3”这一行C语言可能会被编译为如下所示的汇编代码:' c9 |. E# K9 X, C8 q
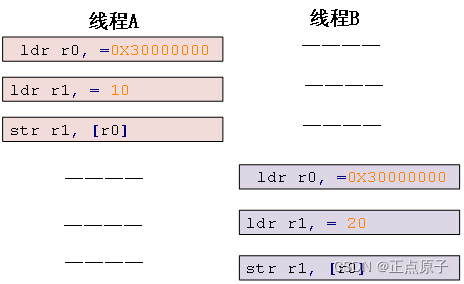
示例代码27.2.1.1只是一个简单的举例说明,实际的结果要比示例代码复杂的多。从上述代码可以看出,C语言里面简简单单的一句“a=3”,编译成汇编文件以后变成了3句,那么程序在执行的时候肯定是按照示例代码27.2.1.1中的汇编语句一条一条的执行。假设现在线程A要向a变量写入10这个值,而线程B也要向a变量写入20这个值,我们理想中的执行顺序如图27.2.1.1所示: 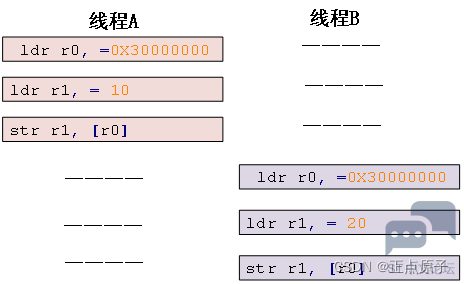
图27.2.1.1 理想的执行流程 按照图27.2.1.1所示的流程,确实可以实现线程A将a变量设置为10,线程B将a变量设置为20。但是实际上的执行流程可能如图27.2.1.2所示: $ [4 q* S! S" q5 Z* [ 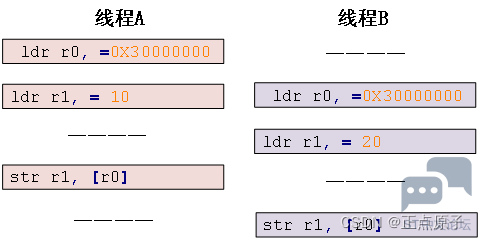
图27.2.1.2 可能的执行流程2 I$ B9 A2 A, M6 O 按照图27.2.1.2所示的流程,线程A最终将变量a设置为了20,而并不是要求的10!线程B没有问题。这就是一个最简单的设置变量值的并发与竞争的例子,要解决这个问题就要保证示例代码27.2.1.1中的三行汇编指令作为一个整体运行,也就是作为一个原子存在。Linux内核提供了一组原子操作API函数来完成此功能,Linux内核提供了两组原子操作API函数,一组是对整形变量进行操作的,一组是对位进行操作的,我们接下来看一下这些API函数。! Q6 j N# M# O0 S6 T* F 27.2.2 原子整形操作API函数 Linux内核定义了叫做atomic_t的结构体来完成整形数据的原子操作,在使用中用原子变量来代替整形变量,此结构体定义在include/linux/types.h文件中,定义如下:0 Q: x; }* g6 f# ]6 Y + q- Z" d) {. D" V# @
如果要使用原子操作API函数,首先要先定义一个atomic_t的变量,如下所示:6 d: W, f! T ?0 ]7 ^! E2 Z8 B / t U+ }; l: O atomic_t a; //定义a 也可以在定义原子变量的时候给原子变量赋初值,如下所示: atomic_t b = ATOMIC_INIT(0); //定义原子变量b并赋初值为09 I4 {% X* k, [" J2 @ 可以通过宏ATOMIC_INIT向原子变量赋初值。 原子变量有了,接下来就是对原子变量进行操作,比如读、写、增加、减少等等,Linux内核提供了大量的原子操作API函数,如表27.2.2.1所示:8 w) N8 o5 A9 ] 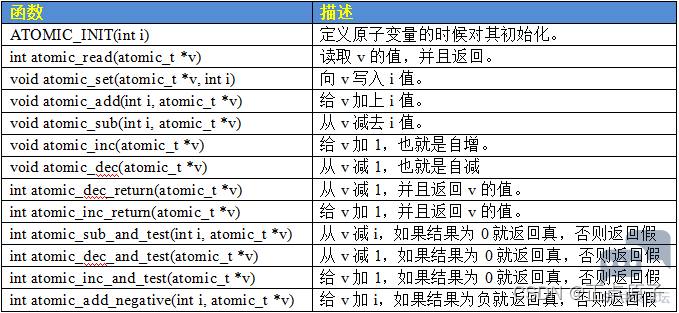
/ ]9 j/ h/ Z5 c 表27.2.2.1 原子整形操作API函数表% {& O* W) u; L; g# o$ h* z0 e2 Q( b 如果使用64位的SOC的话,就要用到64位的原子变量,Linux内核也定义了64位原子结构体,如下所示:: p9 Y) | r; u
可以看出,counter变为了s64类型,s64本质是long long类型,相应的也提供了64位原子变量的操作API函数,这里我们就不详细讲解了,和表27.2.1.1中的API函数有用法一样,只是将“atomic_”前缀换为“atomic64_”,将int换为long long。如果使用的是64位的SOC,那么就要使用64位的原子操作函数。Cortex-A7是32位的架构,所以本书中只使用表27.2.2.1中的32位原子操作函数。原子变量和相应的API函数使用起来很简单,参考如下示例:' p4 k- R# \" A$ r; K4 j
27.2.3 原子位操作API函数/ ^* z9 N0 |" y 位操作也是很常用的操作,Linux内核也提供了一系列的原子位操作API函数,只不过原子位操作不像原子整形变量那样有个atomic_t的数据结构,原子位操作是直接对内存进行操作,API函数如表27.2.3.1所示:. I( S9 f. p: J: G; y1 O' _ 函数 描述8 v7 H6 L% C7 U. Y1 P6 l) e9 s 2 v5 R0 l/ o6 A$ l+ q) b- J0 M 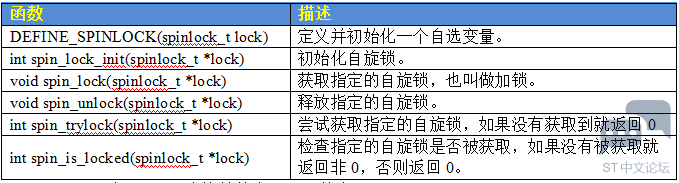
表27.2.3.1 原子位操作函数表' v/ I/ p4 w$ _* y 27.3 自旋锁 27.3.1 自旋锁简介 原子操作只能对整形变量或者位进行保护,但是,在实际的使用环境中怎么可能只有整形变量或位这么简单的临界区。举个最简单的例子,设备结构体变量就不是整型变量,我们对于结构体中成员变量的操作也要保证原子性,在线程A对结构体变量使用期间,应该禁止其他的线程来访问此结构体变量,这些工作原子操作都不能胜任,需要本节要讲的锁机制,在Linux内核中就是自旋锁。' O- T' w. E" F% q$ m 当一个线程要访问某个共享资源的时候首先要先获取相应的锁,锁只能被一个线程持有,只要此线程不释放持有的锁,那么其他的线程就不能获取此锁。对于自旋锁而言,如果自旋锁正在被线程A持有,线程B想要获取自旋锁,那么线程B就会处于忙循环-旋转-等待状态,线程B不会进入休眠状态或者说去做其他的处理,而是会一直傻傻的在那里“转圈圈”的等待锁可用。比如现在有个公用电话亭,一次肯定只能进去一个人打电话,现在电话亭里面有人正在打电话,相当于获得了自旋锁。此时你到了电话亭门口,因为里面有人,所以你不能进去打电话,相当于没有获取自旋锁,这个时候你肯定是站在原地等待,你可能因为无聊的等待而转圈圈消遣时光,反正就是哪里也不能去,要一直等到里面的人打完电话出来。终于,里面的人打完电话出来了,相当于释放了自旋锁,这个时候你就可以使用电话亭打电话了,相当于获取到了自旋锁。 自旋锁的“自旋”也就是“原地打转”的意思,“原地打转”的目的是为了等待自旋锁可以用,可以访问共享资源。把自旋锁比作一个变量a,变量a=1的时候表示共享资源可用,当a=0的时候表示共享资源不可用。现在线程A要访问共享资源,发现a=0(自旋锁被其他线程持有),那么线程A就会不断的查询a的值,直到a=1。从这里我们可以看到自旋锁的一个缺点:那就等待自旋锁的线程会一直处于自旋状态,这样会浪费处理器时间,降低系统性能,所以自旋锁的持有时间不能太长。自旋锁适用于短时期的轻量级加锁,如果遇到需要长时间持有锁的场景那就需要换其他的方法了,这个我们后面会讲解。 Linux内核使用结构体spinlock_t表示自旋锁,结构体定义如下所示:/ l k' R, ` w: f - M, f6 P! h- I
在使用自旋锁之前,肯定要先定义一个自旋锁变量,定义方法如下所示: spinlock_t lock; //定义自旋锁 定义好自旋锁变量以后就可以使用相应的API函数来操作自旋锁。 27.3.2 自旋锁API函数# U! a% U: X6 O& ` 最基本的自旋锁API函数如表27.3.2.1所示:/ K# y% B# O( ?" D L6 A0 d 函数 描述 DEFINE_SPINLOCK(spinlock_t lock) 定义并初始化一个自选变量。 int spin_lock_init(spinlock_t *lock) 初始化自旋锁。% W7 E( Q( E. _, P1 Q3 g void spin_lock(spinlock_t *lock) 获取指定的自旋锁,也叫做加锁。 void spin_unlock(spinlock_t *lock) 释放指定的自旋锁。4 l* K1 b* F4 e _9 A int spin_trylock(spinlock_t *lock) 尝试获取指定的自旋锁,如果没有获取到就返回0* T! `; J7 E% N% \ int spin_is_locked(spinlock_t *lock) 检查指定的自旋锁是否被获取,如果没有被获取就返回非0,否则返回0。- y% @, g9 C+ X/ p" O3 x# @ 表27.3.2.1自旋锁基本API函数表3 R( i/ K0 ]0 A- A 表27.3.2.1中的自旋锁API函数适用于SMP或支持抢占的单CPU下线程之间的并发访问,也就是用于线程与线程之间,被自旋锁保护的临界区一定不能调用任何能够引起睡眠和阻塞的API函数,否则的话会可能会导致死锁现象的发生。自旋锁会自动禁止抢占,也就说当线程A得到锁以后会暂时禁止内核抢占。如果线程A在持有锁期间进入了休眠状态,那么线程A会自动放弃CPU使用权。线程B开始运行,线程B也想要获取锁,但是此时锁被A线程持有,而且内核抢占还被禁止了!线程B无法被调度出去,那么线程A就无法运行,锁也就无法释放,好了,死锁发生了!. L# f+ f$ s" @: t2 j$ T7 Z 表27.3.2.1中的API函数用于线程之间的并发访问,如果此时中断也要插一脚,中断也想访问共享资源,那该怎么办呢?首先可以肯定的是,中断里面可以使用自旋锁,但是在中断里面使用自旋锁的时候,在获取锁之前一定要先禁止本地中断(也就是本CPU中断,对于多核SOC来说会有多个CPU核),否则可能导致锁死现象的发生,如图27.3.2.1所示: _, p9 K& V9 D5 T( x 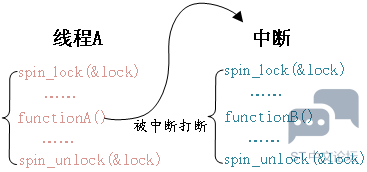
图27.3.2.1 中断打断线程 在图27.3.2.1中,线程A先运行,并且获取到了lock这个锁,当线程A运行functionA函数的时候中断发生了,中断抢走了CPU使用权。右边的中断服务函数也要获取lock这个锁,但是这个锁被线程A占有着,中断就会一直自旋,等待锁有效。但是在中断服务函数执行完之前,线程A是不可能执行的,线程A说“你先放手”,中断说“你先放手”,场面就这么僵持着,死锁发生! 最好的解决方法就是获取锁之前关闭本地中断,Linux内核提供了相应的API函数,如表27.3.2.2所示: 函数 描述 void spin_lock_irq(spinlock_t *lock) 禁止本地中断,并获取自旋锁。6 Y) k; ~1 q. w: i void spin_unlock_irq(spinlock_t *lock) 激活本地中断,并释放自旋锁。5 I3 a" w. _9 @+ F( Y& L void spin_lock_irqsave(spinlock_t *lock, unsigned long flags) 保存中断状态,禁止本地中断,并获取自旋锁。" |4 |4 ~4 o8 ~3 [ void spin_unlock_irqrestore(spinlock_t *lock, unsigned long flags) 将中断状态恢复到以前的状态,并且激活本地中断,释放自旋锁。 表27.3.2.2 线程与中断并发访问处理API函数! v3 M @: T H# {& K: l9 [$ N 使用spin_lock_irq/spin_unlock_irq的时候需要用户能够确定加锁之前的中断状态,但实际上内核很庞大,运行也是“千变万化”,我们是很难确定某个时刻的中断状态,因此不推荐使用spin_lock_irq/spin_unlock_irq。建议使用spin_lock_irqsave/ spin_unlock_irqrestore,因为这一组函数会保存中断状态,在释放锁的时候会恢复中断状态。一般在线程中使用spin_lock_irqsave/ spin_unlock_irqrestore,在中断中使用spin_lock/spin_unlock,示例代码如下所示:. ~; n8 E' ?6 Q4 x8 q3 o6 o
下半部(BH)也会竞争共享资源,有些资料也会将下半部叫做底半部。关于下半部后面的章节会讲解,如果要在下半部里面使用自旋锁,可以使用表27.3.2.3中的API函数: 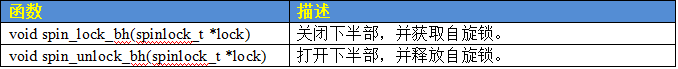
表27.3.2.3 下半部竞争处理函数 27.3.3 其他类型的锁 在自旋锁的基础上还衍生出了其他特定场合使用的锁,这些锁在驱动中其实用的不多,更多的是在Linux内核中使用,本节我们简单来了解一下这些衍生出来的锁。 1、读写自旋锁# Y- U+ s% `# I 现在有个学生信息表,此表存放着学生的年龄、家庭住址、班级等信息,此表可以随时被修改和读取。此表肯定是数据,那么必须要对其进行保护,如果我们现在使用自旋锁对其进行保护。每次只能一个读操作或者写操作,但是,实际上此表是可以并发读取的。只需要保证在修改此表的时候没人读取,或者在其他人读取此表的时候没有人修改此表就行了。也就是此表的读和写不能同时进行,但是可以多人并发的读取此表。像这样,当某个数据结构符合读/写或生产者/消费者模型的时候就可以使用读写自旋锁。 读写自旋锁为读和写操作提供了不同的锁,一次只能允许一个写操作,也就是只能一个线程持有写锁,而且不能进行读操作。但是当没有写操作的时候允许一个或多个线程持有读锁,可以进行并发的读操作。Linux内核使用rwlock_t结构体表示读写锁,结构体定义如下(删除了条件编译): 7 E2 @+ t& y- \. v1 ?1 ^) W0 }; Z3 O
读写锁操作API函数分为两部分,一个是给读使用的,一个是给写使用的,这些API函数如表27.3.3.1所示: 6 @+ }' E+ O$ z 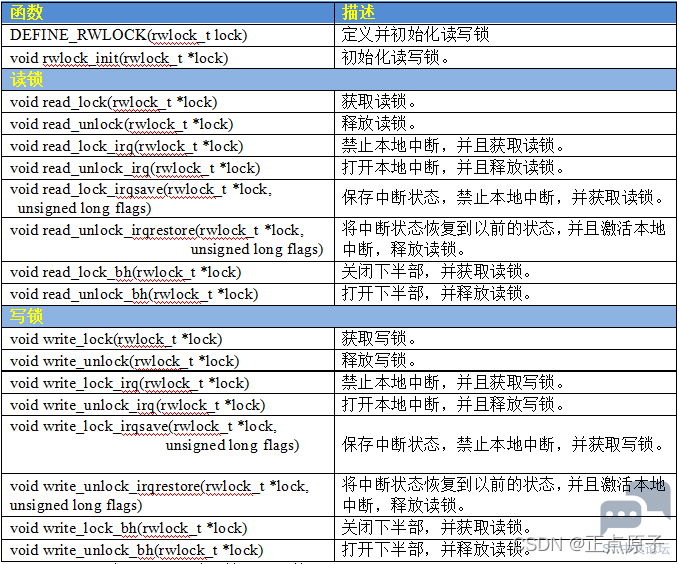
表27.3.3.1 读写锁API函数 2、顺序锁 顺序锁在读写锁的基础上衍生而来的,使用读写锁的时候读操作和写操作不能同时进行。使用顺序锁的话可以允许在写的时候进行读操作,也就是实现同时读写,但是不允许同时进行并发的写操作。虽然顺序锁的读和写操作可以同时进行,但是如果在读的过程中发生了写操作,最好重新进行读取,保证数据完整性。顺序锁保护的资源不能是指针,因为如果在写操作的时候可能会导致指针无效,而这个时候恰巧有读操作访问指针的话就可能导致意外发生,比如读取野指针导致系统崩溃。Linux内核使用seqlock_t结构体表示顺序锁,结构体定义如下: ' g: ~& ]5 [' J: d7 _
关于顺序锁的API函数如表27.3.3.2所示: ! e2 \; G4 J* w2 m5 v 函数 描述 DEFINE_SEQLOCK(seqlock_t sl) 定义并初始化顺序锁 void seqlock_ini seqlock_t *sl) 初始化顺序锁。0 [0 e9 F2 X2 W( { 顺序锁写操作 F9 @$ I' A5 f; d void write_seqlock(seqlock_t *sl) 获取写顺序锁。 void write_sequnlock(seqlock_t *sl) 释放写顺序锁。# ? G0 `0 `9 f. F# T- L* \ void write_seqlock_irq(seqlock_t *sl) 禁止本地中断,并且获取写顺序锁 void write_sequnlock_irq(seqlock_t *sl) 打开本地中断,并且释放写顺序锁。 void write_seqlock_irqsave(seqlock_t *sl, unsigned long flags) 保存中断状态,禁止本地中断,并获取写顺序锁。 void write_sequnlock_irqrestore(seqlock_t *sl," K1 W; u0 M1 {; E9 f! u5 Z7 v unsigned long flags) 将中断状态恢复到以前的状态,并且激活本地中断,释放写顺序锁。 void write_seqlock_bh(seqlock_t *sl) 关闭下半部,并获取写读锁。. |8 s) t( s5 ~, R2 a0 t: a void write_sequnlock_bh(seqlock_t *sl) 打开下半部,并释放写读锁。% S7 N2 F& F+ X4 Y* T$ f 顺序锁读操作% V" K# y' B0 N) A8 G, {5 }3 q, H unsigned read_seqbegin(const seqlock_t *sl) 读单元访问共享资源的时候调用此函数,此函数会返回顺序锁的顺序号。 unsigned read_seqretry(const seqlock_t *sl, unsigned start) 读结束以后调用此函数检查在读的过程中有没有对资源进行写操作,如果有的话就要重读& e/ }7 c* s m9 a. J* J1 G 表27.3.3.2 顺序锁API函数表# E8 _2 N* v5 W& x& F 27.3.4 自旋锁使用注意事项 综合前面关于自旋锁的信息,我们需要在使用自旋锁的时候要注意一下几点:( I) L |) D1 _ E ①、因为在等待自旋锁的时候处于“自旋”状态,因此锁的持有时间不能太长,一定要短,否则的话会降低系统性能。如果临界区比较大,运行时间比较长的话要选择其他的并发处理方式,比如稍后要讲的信号量和互斥体。 ②、自旋锁保护的临界区内不能调用任何可能导致线程休眠的API函数,否则的话可能导致死锁。 ③、不能递归申请自旋锁,因为一旦通过递归的方式申请一个你正在持有的锁,那么你就必须“自旋”,等待锁被释放,然而你正处于“自旋”状态,根本没法释放锁。结果就是自己把自己锁死了!# i: X! J" T( ]# O% K4 ~ ④、在编写驱动程序的时候我们必须考虑到驱动的可移植性,因此不管你用的是单核的还是多核的SOC,都将其当做多核SOC来编写驱动程序。0 O: w9 {5 X( d3 D* _ ! `( p- S( o$ R$ o/ u 27.4 信号量9 i6 j% x+ p; H% b! F4 H( i 27.4.1 信号量简介: n, b5 G7 x& _ 大家如果有学习过FreeRTOS或者UCOS的话就应该对信号量很熟悉,因为信号量是同步的一种方式。Linux内核也提供了信号量机制,信号量常常用于控制对共享资源的访问。举一个很常见的例子,某个停车场有100个停车位,这100个停车位大家都可以用,对于大家来说这100个停车位就是共享资源。假设现在这个停车场正常运行,你要把车停到这个这个停车场肯定要先看一下现在停了多少车了?还有没有停车位?当前停车数量就是一个信号量,具体的停车数量就是这个信号量值,当这个值到100的时候说明停车场满了。停车场满的时你可以等一会看看有没有其他的车开出停车场,当有车开出停车场的时候停车数量就会减一,也就是说信号量减一,此时你就可以把车停进去了,你把车停进去以后停车数量就会加一,也就是信号量加一。这就是一个典型的使用信号量进行共享资源管理的案例,在这个案例中使用的就是计数型信号量。 相比于自旋锁,信号量可以使线程进入休眠状态,比如A与B、C合租了一套房子,这个房子只有一个厕所,一次只能一个人使用。某一天早上A去上厕所了,过了一会B也想用厕所,因为A在厕所里面,所以B只能等到A用来了才能进去。B要么就一直在厕所门口等着,等A出来,这个时候就相当于自旋锁。B也可以告诉A,让A出来以后通知他一下,然后B继续回房间睡觉,这个时候相当于信号量。可以看出,使用信号量会提高处理器的使用效率,毕竟不用一直傻乎乎的在那里“自旋”等待。但是,信号量的开销要比自旋锁大,因为信号量使线程进入休眠状态以后会切换线程,切换线程就会有开销。总结一下信号量的特点:) N3 d S- N% V/ Q+ I* M7 x ①、因为信号量可以使等待资源线程进入休眠状态,因此适用于那些占用资源比较久的场合。 ②、因此信号量不能用于中断中,因为信号量会引起休眠,中断不能休眠。 ③、如果共享资源的持有时间比较短,那就不适合使用信号量了,因为频繁的休眠、切换线程引起的开销要远大于信号量带来的那点优势。6 i* h! D5 Y) M' t 信号量有一个信号量值,相当于一个房子有10把钥匙,这10把钥匙就相当于信号量值为10。因此,可以通过信号量来控制访问共享资源的访问数量,如果要想进房间,那就要先获取一把钥匙,信号量值减1,直到10把钥匙都被拿走,信号量值为0,这个时候就不允许任何人进入房间了,因为没钥匙了。如果有人从房间出来,那他要归还他所持有的那把钥匙,信号量值加1,此时有1把钥匙了,那么可以允许进去一个人。相当于通过信号量控制访问资源的线程数,在初始化的时候将信号量值设置的大于1,那么这个信号量就是计数型信号量,计数型信号量不能用于互斥访问,因为它允许多个线程同时访问共享资源。如果要互斥的访问共享资源那么信号量的值就不能大于1,此时的信号量就是一个二值信号量。4 y: h7 I ]# `/ D% l! V2 H: p2 ]* \0 y 27.4.2 信号量API函数) ]" M4 m2 R% j Linux内核使用semaphore结构体表示信号量,结构体内容如下所示:
要想使用信号量就得先定义,然后初始化信号量。有关信号量的API函数如表27.4.2.1所示: 函数 描述 DEFINE_SEAMPHORE(name) 定义一个信号量,并且设置信号量的值为1。. Y2 B# m8 B, x1 d) x& t void sema_init(struct semaphore *sem, int val) 初始化信号量sem,设置信号量值为val。) W4 j5 ?1 a# U6 L; Z \ void down(struct semaphore *sem) 获取信号量,因为会导致休眠,因此不能在中断中使用。" v' X* u) {+ y int down_trylock(struct semaphore *sem); 尝试获取信号量,如果能获取到信号量就获取,并且返回0。如果不能就返回非0,并且不会进入休眠。8 K1 t$ w) H2 ?( j int down_interruptible(struct semaphore *sem) 获取信号量,和down类似,只是使用down进入休眠状态的线程不能被信号打断。而使用此函数进入休眠以后是可以被信号打断的。 void up(struct semaphore *sem) 释放信号量" o- [4 K( F# @) B; _ 表27.4.2.1 信号量API函数 信号量的使用如下所示:
27.5 互斥体! {: l; r6 m6 I: P- s 27.5.1 互斥体简介9 J8 m6 v' N9 M* Z 在FreeRTOS和UCOS中也有互斥体,将信号量的值设置为1就可以使用信号量进行互斥访问了,虽然可以通过信号量实现互斥,但是Linux提供了一个比信号量更专业的机制来进行互斥,它就是互斥体—mutex。互斥访问表示一次只有一个线程可以访问共享资源,不能递归申请互斥体。在我们编写Linux驱动的时候遇到需要互斥访问的地方建议使用mutex。Linux内核使用mutex结构体表示互斥体,定义如下(省略条件编译部分): 5 D* i5 }% o2 T7 {+ l
在使用mutex之前要先定义一个mutex变量。在使用mutex的时候要注意如下几点:. I5 V4 s1 G% {) |+ V* }) x ①、mutex可以导致休眠,因此不能在中断中使用mutex,中断中只能使用自旋锁。 ②、和信号量一样,mutex保护的临界区可以调用引起阻塞的API函数。 ③、因为一次只有一个线程可以持有mutex,因此,必须由mutex的持有者释放mutex。并且mutex不能递归上锁和解锁。 27.5.2 互斥体API函数1 v- z) y. F9 D' U. k# l 有关互斥体的API函数如表27.5.2.1所示:4 U* x2 Z. i& v( ?. U& o) U 函数 描述; i# y/ v; ~' G& Q2 u DEFINE_MUTEX(name) 定义并初始化一个mutex变量。 void mutex_init(mutex *lock) 初始化mutex。 void mutex_lock(struct mutex *lock) 获取mutex,也就是给mutex上锁。如果获取不到就进休眠。 void mutex_unlock(struct mutex *lock) 释放mutex,也就给mutex解锁。 int mutex_trylock(struct mutex *lock) 尝试获取mutex,如果成功就返回1,如果失败就返回0。 int mutex_is_locked(struct mutex *lock) 判断mutex是否被获取,如果是的话就返回1,否则返回0。- G0 [ z3 G1 f: l int mutex_lock_interruptible(struct mutex *lock) 使用此函数获取信号量失败进入休眠以后可以被信号打断。4 Q( m( ^( W$ X+ S4 [% y 表27.5.2.1 互斥体API函数* Z3 l0 H1 {5 U: h: M5 V 互斥体的使用如下所示:# L8 f3 X/ s. S, ~4 k
关于Linux中的并发和竞争就讲解到这里,Linux内核还有很多其他的处理并发和竞争的机制,本章我们主要5 G7 \8 X2 k. ]- |) c: H/ b ———————————————— 版权声明:正点原子 3 q9 C1 s V, f1 C) @5 E |
扩展STM32微处理器,实现高性价比、低功耗和灵活性能
STM32MP1 自举程序编程:USB DFU/USART 协议全解析
兔哥心中的ST中文论坛
我心中的ST中文论坛
STM32 开发者指南:ST.com 全新 MCU 产品阵容视觉布局深度解析
深度拆解 STM32MP1 Boot 链路
STM32串口自动识别波特率的原理
STM32MP135 MP157 MP257 CoreMark移植&&跑分对比&&多核心负载不均衡问题排查与解决
STM32--STM32 微控制器详解
为什么学了几天STM32一脸茫然?
 微信公众号
 手机版