




|
Cortex-M3缩略语 AMBA:先进单片机总线架构 ADK:AMBA设计套件AHB:先进高性能总线 AHB-AP:AHB访问端口3 f- n9 c1 M k. D8 @ APB:先进外设总线 ARM ARM:ARM架构参考手册 ASIC:行业领域专用集成电路 ATB :先进跟踪总线 BE8:字节不变式大端模式 CPI:每条指令的周期数 DAP:调试访问端口 DSP:数字信号处理(器)# _* s9 K F1 j' ` DWT:数据观察点及跟踪 ETM:嵌入式跟踪宏单元2 y* J& @3 \+ d4 n3 M% S FPB:闪存地址重载及断点 FSR:fault状态寄存器1 S0 M i8 @, v; e6 _% Q HTM:Core Sight AHB跟踪宏单元' Q* Z% m% C$ [* I% T8 c ICE:在线仿真器 IDE:集成开发环境 IRQ:中断请求(通常是外中断请求)& Z: [; s. q" ]! f ISA:指令系统架构 ISR:中断服务例程% q R1 X8 U3 F( l2 b! l: w ITM:仪器化跟踪宏单元 JTAG:连接点测试行动组(一个关于测试和调试接口的标准)$ @% \' i9 K& |, b1 b" p LR:连接寄存器 LSB:最低有效位5 ]4 r$ Q% O" ` n+ A- p+ c MSB:最高有效位/ z" P$ f0 F) l8 \" A5 h LSU:加载存储单元 MCU:微控制器单元; y4 \) B/ i/ _2 F" w8 d5 r MPU:存储器保护单元 MMU:存储器管理单元2 ?* Q8 h5 A8 O) N3 H" \ MSP:主堆栈指针 NMI:不可屏蔽中断- g; D. r# {( ~& F NVIC:嵌套向量中断控制器2 ? P I, f9 N5 U) d9 S- d8 g PC:程序计数器 PPB:私有外设总线 数值( z! G0 r7 Y+ u8 M% ]3 K 1. 4''hC , 0x123 都表示16进制数 9 X) k- s2 m5 ?. |7 u 2. #3表示数字3 (e.g., IRQ #3 就是指3号中断) 1 g; `+ @" n( k; H; u- V$ p9 N 3. #immed_12表示一个12位的立即数 4 q% W' B) Y7 c7 ?% d 4. 寄存器位。通常是表示一个位段的数值,例如 ! |5 B; ]5 ^1 f. G8 ]' V bit[15:12] 表示位序号从15往下数到12,这一段的数值。 寄存器访问类型: s0 |7 D# q" z- T) z- q R :表示只读 3 v6 Q& A! m9 z! ^0 J3 E W:表示只写 9 x% i* M$ h9 j @! Z' {5 V/ f# L: ]) Q RW :表示可读可写(前3条好像地球人都知道) ( `+ ?5 b p0 F" Y/ D7 R R/Wc :表示可读,但是写访问将使之清 03 f6 ]- m7 v9 x' H3 g; _ 3 t) \& ]2 g. w0 l9 [7 T- G- @ Cortex-M3芯片简介 芯片的基本结构如下图:. T1 w+ v8 Q" P 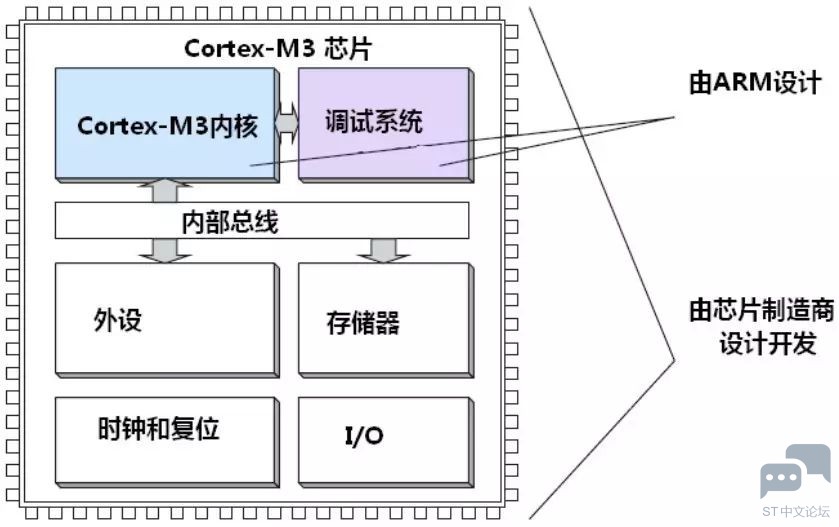
在这个版本中,内核架构首次从单一款式变成3种款式:
高性能+高代码密度+小硅片面积,使得CM3大面积地成为理想的处理平台,主要应用在以下领域:7 P; ?" ]2 B/ |
(1)简介 3 C# ^, h5 N) d# L3 L% S9 X Cortex-M3是一个 32位处理器内核。内部的数据路径是 32位的,寄存器是 32位的,存储器接口也是 32 位的。CM3 采用了哈佛结构,拥有独立的指令总线和数据总线,可以让取指与数据访问并行不悖。这样一来数据访问不再占用指令总线,从而提升了性能。为实现这个特性, CM3内部含有好几条总线接口,每条都为自己的应用场合优化过,并且它们可以并行工作。但是另一方面,指令总线和数据总线共享同一个存储器空间(一个统一的存储器系统)。 7 u3 L4 u; r- P0 w1 | 比较复杂的应用可能需要更多的存储系统功能,为此CM3提供一个可选的MPU,而且在需要的情况下也可以使用外部的 cache。另外在CM3中,Both小端模式和大端模式都是支持的。 H/ x. e2 \9 j$ d. d7 f9 { & q" P8 O" w" X; l6 I3 y q (2)Cortex-M3的简化图' @, F2 r0 `( ~2 X 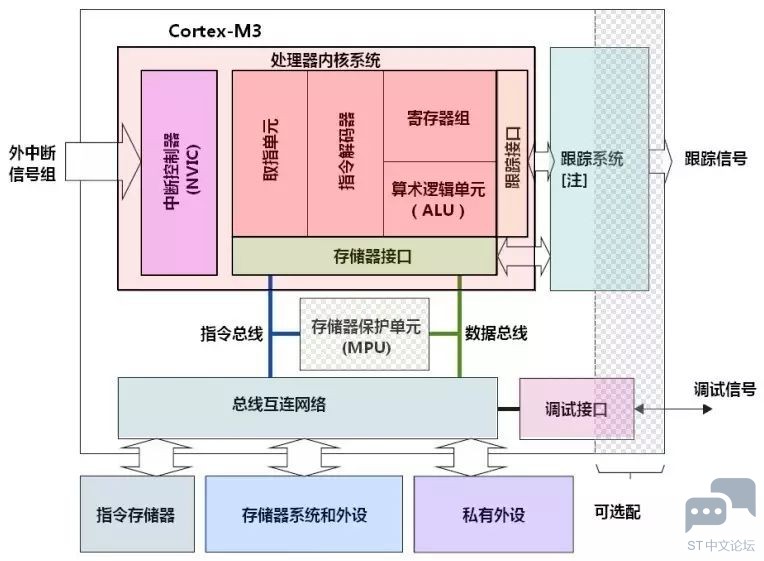
(3)寄存器组 处理器拥有R0-R15的寄存器组,其中R13最为堆栈指针SP,SP有两个,但是同一时刻只能有一个可以看到,这就是所谓的“banked”寄存器。2 q* `$ {2 s0 E7 s5 `: U 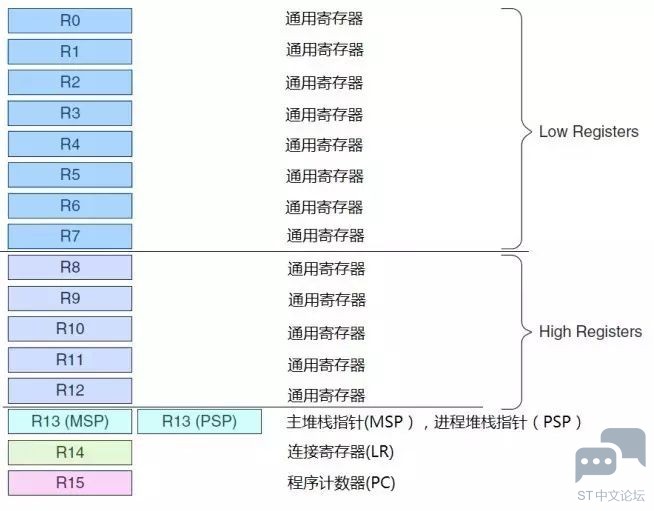
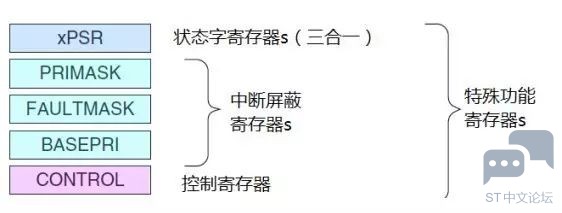
Cortex-M3处理器支持两种处理器的操作模式,还支持两级特权操作。 两种操作模式分别为:处理者模式和线程模式(thread mode)。引入两个模式的本意,是用于区别普通应用程序的代码和异常服务例程的代码——包括中断服务例程的代码。 $ j5 k1 L/ Y) n U+ w9 e Cortex-M3 的另一个侧面则是特权的分级——特权级和用户级。这可以提供一种存储器访问的保护机制,使得普通的用户程序代码不能意外地,甚至是恶意地执行涉及到要害的操作。处理器支持两种特权级,这也是一个基本的安全模型。9 y2 {4 E# F3 {, A" ^ 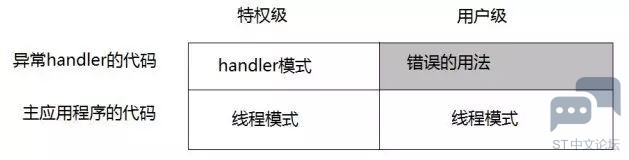
在 CM3 运行主应用程序时(线程模式),既可以使用特权级,也可以使用用户级;但是异常服务例程必须在特权级下执行。复位后,处理器默认进入线程模式,特权极访问。在特权级下,程序可以访问所有范围的存储器(如果有 MPU,还要 在MPU规定的禁地之外),并且可以执行所有指令。 * _8 p, \" _! a7 V 在特权级下的程序可以为所欲为,但也可能会把自己给玩进去——切换到用户级。一旦进入用户级,再想回来就得走“法律程序”了——用户级的程序不能简简单单地试图改写 CONTROL寄存器就回到特权级,它必须先“申诉”:执行一条系统调用指令(SVC)。这会触发SVC异常,然后由异常服务例程(通常是操作系统的一部分)接管,如果批准了进入,则异常服务例程修改 CONTROL寄存器,才能在用户级的线程模式下重新进入特权级。 $ F) G3 q8 y {; c 事实上,从用户级到特权级的唯一途径就是异常:如果在程序执行过程中触发了一个异常,处理器总是先切换入特权级,并且在异常服务例程执行完毕退出时,返回先前的状态。 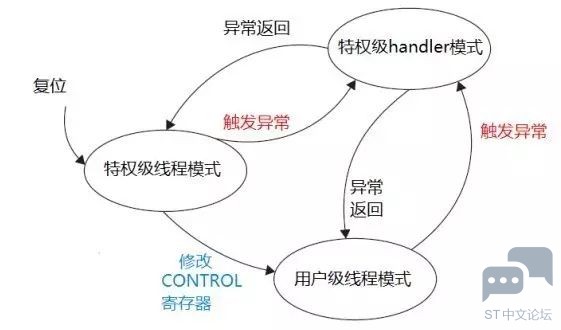
通过引入特权级和用户级,就能够在硬件水平上限制某些不受信任的或者还没有调试好的程序,不让它们随便地配置涉及要害的寄存器,因而系统的可靠性得到了提高。进一步地,如果配了 MPU,它还可以作为特权机制的补充——保护关键的存储区域不被破坏,这些区域通常是操作系统的区域。 / |* ?% }. ^, e- ? / Q9 Z M1 v+ x1 H; q- T. ?/ k (4)内建的嵌套向量中断控制器 Cortex-M3 在内核水平上搭载了一颗中断控制器——嵌套向量中断控制器 NVIC(Nested Vectored Interrupt Controller)。它与内核有很深的“亲密接触”——与内核是紧耦合的。NVIC提供如下的功能:
" G' T! W n0 w 向量中断支持: 当开始响应一个中断后,CM3会自动定位一张向量表,并且根据中断号从表中找出 ISR的入口地址,然后跳转过去执行。不需要像以前的 ARM那样,由软件来分辨到底是哪个中断发生了,也无需半导体厂商提供私有的中断控制器来完成这种工作。这么一来,中断延迟时间大为缩短。 (5)存储器映射 Cortex-M3支持4G存储空间,具体分配如下图: 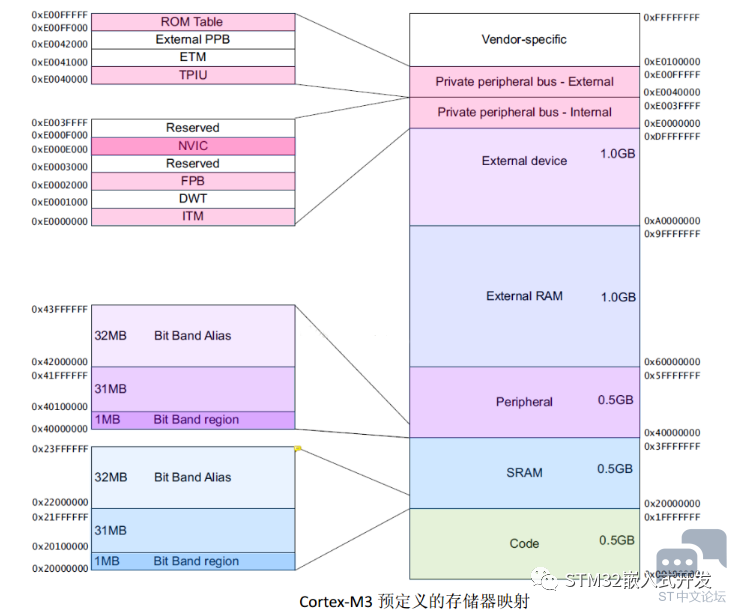
系统总线用于访问内存和外设,覆盖的区域包括 SRAM,片上外设,片外 RAM,片外扩展设备,以及系统级存储区的部分空间。 私有外设总线负责一部分私有外设的访问,主要就是访问调试组件。它们也在系统级存储区。 : G7 O/ f m( K% r5 \, B $ p4 K" @9 C5 e$ u x (7)存储器保护单元(MPU) Cortex-M3有一个可选的存储器保护单元。配上它之后,就可以对特权级访问和用户级访问分别施加不同的访问限制。当检测到犯规(violated)时,MPU 就会产生一个 fault 异常,可以由fault异常的服务例程来分析该错误,并且在可能时改正它。 MPU 有很多玩法。最常见的就是由操作系统使用 MPU,以使特权级代码的数据,包括操作系统本身的数据不被其它用户程序弄坏。MPU在保护内存时是按区管理的。它可以把某些内存 region设置成只读,从而避免了那里的内容意外被更改;还可以在多任务系统中把不同任务之间的数据区隔离。一句话,它会使嵌入式系统变得更加健壮,更加可靠。 4 U7 V7 T$ t& Y( j! `; [ 很多行业标准,尤其是航空的,就规定了必须使用 MPU来行使保护职能。 (8)Cortex-M3的简评
Thumb-2的到来告别了状态切换的旧世代,再也不需要花时间来切换于 32位 ARM状态和16位Thumb状态之间了。这简化了软件开发和代码维护,使产品面市更快。 Thumb-2指令集为编程带来了更多的灵活性。许多数据操作现在能用更短的代码搞定,这意味着 Cortex-M3的代码密度更高,也就对存储器的需求更少。 - S5 l7 w% Q& M) K b0 w& {4 }8 p 取指都按 32位处理。同一周期最多可以取出两条指令,留下了更多的带宽给数据传输。 Cortex-M3的设计允许单片机高频运行(现代半导体制造技术能保证 100MHz以上的速度)即使在相同的速度下运行,CM3的每指令周期数(CPI)也更低,于是同样的 MHz下可以做更多的工作;另一方面,也使同一个应用在 CM3上需要更低的主频。
Cortex-M3在进入异常服务例程时,自动压栈了 R0-R3, R12, LR, PSR 和PC,并且在返回时自动弹出它们,这多清爽!既加速了中断的响应,也再不需要汇编语言代码了。 NVIC支持对每一路中断设置不同的优先级,使得中断管理极富弹性:STM32外部中断实例。最粗线条的实现也至少要支持 8级优先级,而且还能动态地被修改。+ A, N* ~2 \/ H4 _6 N$ U 优化中断响应还有两招,它们分别是“咬尾中断机制”和“晚到中断机制”。 - p8 D0 h# ?1 t4 l) J/ _9 {) j 有些需要较多周期才能执行完的指令,是可以被中断-继续的——就好比它们是一串指令一样。这些指令包括加载多个寄存器(LDM),存储多个寄存器(STM),多个寄存器参与的PUSH,以及多个寄存器参与的 POP。 4 y" s; Q' B% s 除非系统被彻底地锁定,NMI(不可屏蔽中断)会在收到请求的第一时间予以响应。对很多安全-关键(safety-critical)的应用,NMI都是必不可少的(如化学反应即将失控时的紧急停机)。 " L, a Q1 c3 m$ R1 ?( b- R$ O 总结 0 M6 _. t: W- |* U; n 以上内容总结了STM32的一些基本知识,希望能为STM32的学习打好基础。 |
经验分享 | 基于STM32G4芯片TIM+SPI+DMA应用示例
实战经验 | 基于STM32G0B1的全桥移相+同步整流PWM解决方案
STM32G47x 双 Bank 模式下在线升级
DMA 原理从 0 到 1:为什么它能解放 CPU?一文讲透 DMA 的工作流程
【福利三:逢7发帖赢大礼】8、基于STM32G070板子的Ymodem串口协议IAP Bootloader开发
【福利三:逢7发帖赢大礼】7、基于STM32G070板子TF卡的FATFS移植
【福利三:逢7发帖赢大礼】6、基于STM32G070板子spiflash的FATFS移植
基于STM32F303双电机FOC驱动: 无感原理图/BOM表/代码等开源...
【福利三:雨露均沾·逢7狂欢】之五:STM32系统时钟PLL故障排除1例
【福利三:逢7发帖赢大礼】5、基于STM32G070板子IRDA红外遥控接收解码
 微信公众号
 手机版


