




 STMCU小助手
发布时间:2025-8-18 10:53
|
帮助机器更好地“思考”,让更多的AI走向边缘,是AI发展的重要趋势之一。在MCU中加入NPU单元是落实这一趋势的芯片技术路线之一,STM32N6便是MCU+NPU架构的开山之作,它拥有MPU级的AI性能,同时具备MCU级的功耗和成本。这一独特的价值定位,让边缘AI部署更轻松。 n* N& d! h0 ] & o+ Q% G. A1 i* t W 1. STM32N6特性概览 
专用嵌入式神经处理单元(NPU)STM32N6集成ST自研硬件NPU,处理能力达600GOPS;同时具有3TOPS/W的极低功耗,在运行AI模型时,不需要任何散热装置。( ~; o6 h: d+ { Arm Cortex-M55内核 STM32N6内核为Cortex-M55,主频达800MHz,新增150个DSP矢量扩展指令集(MVE),可实现在数据被送到NPU之前的预处理,或从NPU得到结果的后处理。 大容量嵌入式RAM STM32N6内置4.2 Mbytes嵌入式RAM,支持实时数据处理和多任务处理,如存储NPU运算中的推理数据,或作为帧缓存,或H264压缩时的中间数据。! j: j8 g" x7 ?0 L9 E 强大的计算机视觉能力 STM32N6集成并行和MIPI CSI-2摄像头接口及专用图像处理单元(ISP),提供600GOPS的AI处理算力,可胜任很多机器视觉应用。 扩展的多媒体功能 STM32N6集成2.5D图形加速器、H264编码器,以及JPEG编解码的硬件加速,能轻松实现在运行AI处理时,把从摄像头获取的视频通过以太网口或USB(UVC协议)传输到外部。 增强的安全功能 STM32N6包括为Cortex-M55核和NPU配备的Arm TrustZone,目标认证SESIP3、PSA L3。1 ?! q p" L# P$ `( l$ T- b* o2 N * Q U& r0 `) P8 w. b 2. NPU引入MCU,将触发边缘AI应用新场景的“aha moment”! C% p) g N9 N6 j/ [, p STM32N6之所以能够实现MPU级别的AI性能,是因为它搭载了神经网络硬件加速单元—Neural-ART加速器,这是ST自研的神经处理单元(NPU),运算吞吐量高达600 GOPS(每秒6000亿次操作),比不具备NPU的STM32H7高出600倍。9 {1 ~. E5 U8 g . L8 z3 W0 f6 ?# N& N: ^1 K1 k NPU是专为加速神经网络计算和人工智能相关任务而设计的,针对矩阵乘法、卷积和其他线性代数运算进行了优化。因此,NPU在运行和处理AI算法非常高效,非常擅长处理图像分类、语音处理以及自然语言等多模态模型。NPU在处理AI相关任务时,功耗非常低,尤其适合电池供电的设备。不仅如此,它还可以减少微控制器上处理AI任务的延迟,这对于实时应用来说非常重要。' ^& s# {) M2 I4 _ w 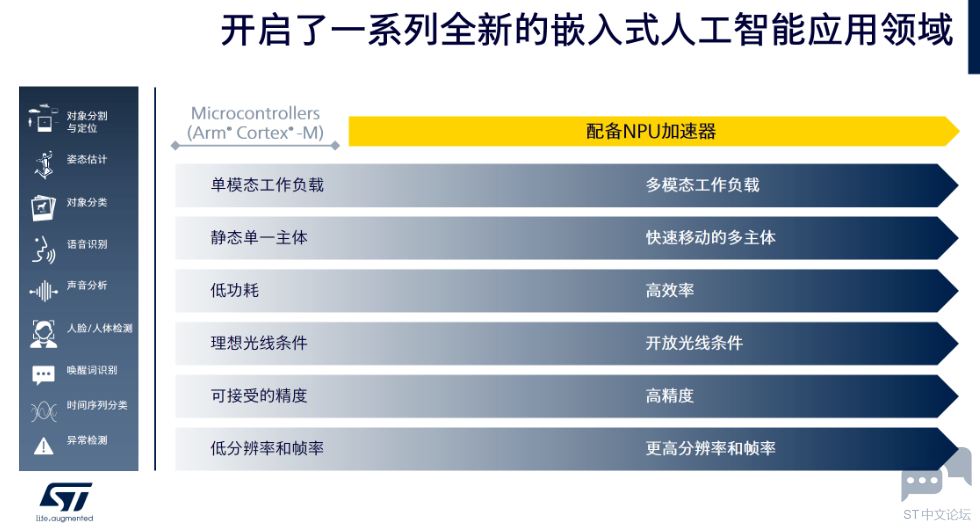
) z/ { W2 t1 ~3 g* Z NPU带来的性能提升也是非常显著的。如上图,选取一些如图像分类、对象检测、语音识别等非常经典的神经网络模型,让这些模型分别运行在STM32N6的NPU上,也运行在STM32N6的Cortex-M55内核上,通过比较,可以发现运行这些神经网络模型时,推理性能提升了26倍到134倍。; J7 y( z# d$ x% Q 4 `# {) U |8 M8 J) x- f$ \ h 3. STM32N6完备开发工具链邂逅成熟产品生态 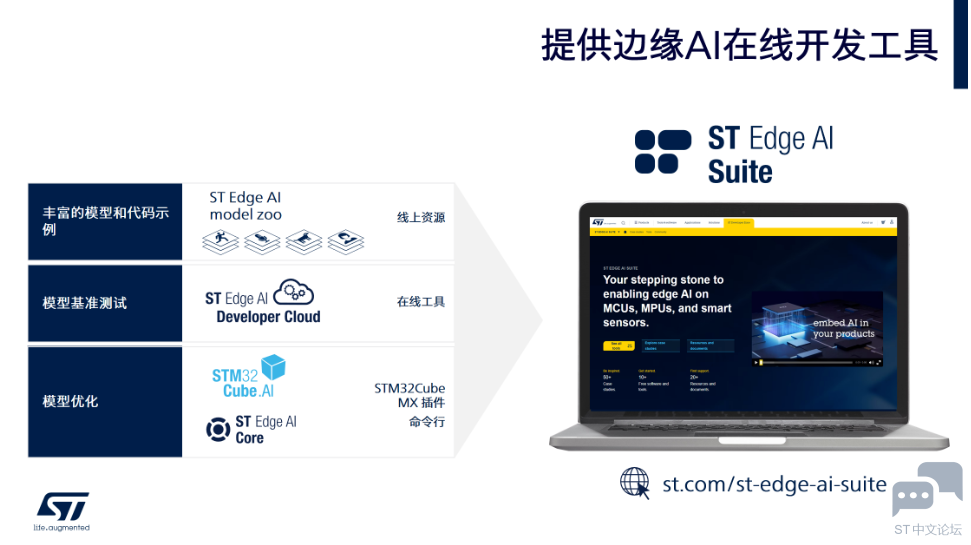
" r6 f9 b8 m8 a, l ST还提供一个完整的软件生态系统,极大地促进并优化基于STM32N6的新型人工智能应用的开发过程。这一生态系统的核心是ST Edge AI Suite,它由三部分组成:首先是Edge AI Model Zoo,这是一个免费软件工具的资源库,汇聚了免费的软件工具、实用的边缘AI模型和代码示例,以及详尽的文档资料。无论开发者经验丰富与否,都能在其中找到创建边缘人工智能应用所需的支持。其次是Edge AI Developer Cloud在线平台,开发者可以通过托管在这个云平台上的板卡对自己的AI模型进行远程性能基准测试。最后是STM32Cube.AI和ST Edge AI Core,这两款工具是模型优化器,可以将您的神经网络转换为可以在设备上执行的C代码。9 C2 m, ]) B5 y$ ^% `! R; C / r. O# R5 B6 |* z% O* X1 a9 T4 c # P7 V" S5 n# `! {8 V 4. 结语 在AI蓬勃发展的当下,STM32N6以MCU+NPU架构破局,性能飞升,为边缘AI解锁更多场景,成为边缘AI落地的插上“隐形的翅膀”。! w. m* O% {( t; [$ s# P) I% X ———————————————— 版权声明:本文为博主原创文章,遵循 CC 4.0 BY-SA 版权协议,转载请附上原文出处链接和本声明。- H) V( p& {3 X& d, M 原文链接:https://blog.csdn.net/2501_92678806/article/details/1503816030 r$ U( |" n$ c! W- i9 D $ r+ O, J7 ^4 Q. j: [! Z# V8 N |
合作伙伴方案 | 基于STM32N6 NE302紧凑型AI视觉节点
如何测量STM32N6的功耗
请教下STM32N6570 怎么把分辨率改成320x240并可以全屏显示
STM32N6课程学习心得
【STM32N6570-DK评测】3.CubeMX关于DCMIPP和CSI的BUG整理及摄像头使用
线下培训(深圳) | 基于STM32N6的边缘人工智能应用开发实训
《STM32N6视频课程》学习笔记+STM32N6 系统资源隔离: RIF对外设的配置和管理
《STM32N6视频课程》学习笔记+STM32N6系统资源隔离— RIF访问规则与非法访问控制
《STM32N6视频课程》学习笔记+STM32N6 系统资源隔离 Cortex M55 TrustZone
《STM32N6视频课程》学习笔记+STM32N6 资源隔离RIF简介(一)
 微信公众号
 手机版


