




 STMCU小助手
发布时间:2021-12-7 12:00
# b% f. A8 y" i# P$ B7 Q ^
$ y) Z4 j6 s* [% N; { 最近有人问起程序在STM32G4片内不同存储空间运行的速度差异。说实在的,这个很难说死或说出个绝对的数据,毕竟结果除了跟执行代码的存放空间有关外,还跟代码本身的内容、程序逻辑、编译工具及优化等级等都息息相关。我这里设计了一个小测试程序做了下简单比较,以供参考。& s8 G; ~2 [& V6 U / i, o# Y3 G8 w5 `. S 我们不妨先看看STM32G4系列内部系统框架图。下图是STM32G4芯片的系统框架图,我将测试程序放在图中三个黄色高亮位置来运行。& ]% n5 h5 y( Q( l, ^* D 9 Z! x0 ]+ x, P3 w" v R3 S7 J7 F/ P 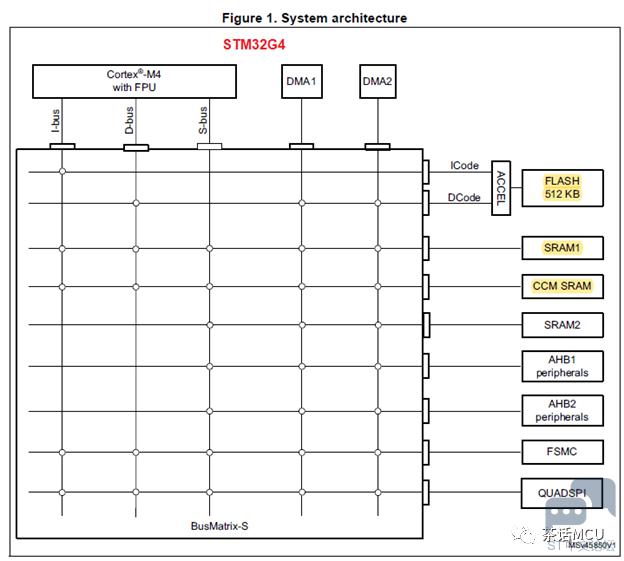
我将程序分别放在CCM、通用SRAM1、Flash区来运行,基于不同的配置,即是否开启指令预取、指令/数据Cache等,得到下面一个表格。代码所在区域栏里的数据代表各种情形下的执行时间。 
2 s' M6 s2 e+ l9 D 从上面表格可以看出,相同配置下在CCM里执行速率总是最高。% M7 p2 O) y2 u" B2 ?8 p6 K 2 {* D1 Q3 k5 J, k( y1 f: D# t7 c 至于代码放在SRAM和Flash里的执行速率,不同配置下结果并不太一样。比如在开启prefetch和使能指令/数据Cache时,即第(1)种配置条件下,在SRAM里运行的速率是最慢的,只有在上图中的第(3)种情形下,代码在SRAM里运行速率相比在FLASH里运行才凸显出明显优势。7 F% Y3 q3 z5 L" ~ 对于STM32G4系列芯片,芯片复位后其Prefetch功能是关闭的,而指令/数据Cache是开启的,即复位后默认为上面的第(2)种情形。结合上图,我们不难看出情形(1)与情形(2)的差别不大,至少不显著。# K, M, q3 @; x# l6 B- k % s: i3 ]3 m7 B c 上面数据虽只是基于特定代码测试而得,但作为基本的方向性判断还是可以的。/ ], n; c+ j2 P / N- n0 X. a: z- O) T9 r# z6 v |
经验分享 | 基于STM32G4芯片TIM+SPI+DMA应用示例
STM32G47x 双 Bank 模式下在线升级
DMA 原理从 0 到 1:为什么它能解放 CPU?一文讲透 DMA 的工作流程
【经验分享】STM32G4之基本定时器
NUCLEO-G474RE 扩展 LSM6DSO 传感器数据融合实操演示全解析
经验分享 | STM32G474 高精度定时器同步功能全解析 从内部互联到多芯片协同的实现方案
经验分享 | STM32G4双BANK启动应用演示
STM32G4 LPTIM+DMAMUX 实现并行输出应用示例
实战经验 | LAT1578 SAU对NSC分区的影响
经验分享 | STM32G474 HRTIM Triggered-half模式实现两相交错电源180°相位同步方案
 微信公众号
 手机版


