




|
曾经有人发现同样代码在STM32F1系列芯片上运行好好的,而且代码跟STM32外设关联性也不大。而当代码运行在stm32L071VB单片机时,在做数据的内存拷贝时会进入硬件错误【Hard Fault】,觉得不可理解。0 r2 A1 I9 ^9 |% f 4 F' [( U, G/ s# q : f' x8 M$ ~* r: i 它定义了类似下面的数据结构,并用到预编译命令安排结构体数据成员的存放对齐原则: ' N, w6 _2 _) e- B. e5 O4 D #pragma pack (1) 8 _5 X2 G: }& w# z. Y Struct Comm_Frame {4 _1 L" f- y- k0 d v k. ^" }) Q) x8 P uint8_t Head;9 \7 V+ f" ?7 n$ e # x9 M5 i+ n+ a9 Q* B & ^- [7 Z6 g7 d2 Y' x% K4 _& Q' n uint16_t Data[3]; ) W' Z% s7 n2 x0 U7 m uint8_t Class;- d# u! i4 s7 ^4 h2 s 2 E9 |2 _5 b' T- K. t+ M & W8 j* Z1 z; S! |- ~ uint16_t Tail [2];$ T H$ _) D6 f. k3 i! N2 z } Stream; + a% r( D; \4 u" p$ Q# `- I 8 Q2 k4 h- D& { #pragma pack ()9 z, |: M6 Q9 I8 F % B: J: A' r4 \: z: W + X: B" v) o3 o; i' f 他使用到基于上面结构体定义的数据变量进行数据通信,为了让数据成员在内存中紧凑连续存放,将数据结构体的地址对齐规则指定为字节对齐,即使用#pragma pack (1)。数据在内存中像下面样子摆放: / Q) j( Q# Z( o1 r+ U" ? 2 w; Q! b& s: P5 E 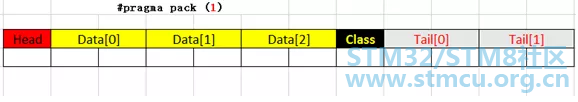
0 W; Z7 K' ~7 k z$ B( w% B& D1 V 9 q" z" t3 s0 ?7 ~6 L1 ] 他这样设计的话,数据结构体中的Data[]和Tail[]双字节数据会出现在奇数地址的地方。那么,当将上述Stream.Data[]数据拷贝出去的时候,在基于双字节数据类型的指针寻址访问时,会出现被访问数据的地址不遵循2倍数的原则,即出现访问地址不对齐的问题,可能导致运行出错。一般来讲,对于ARM内核的芯片,基于双字节数据宽度的寻址访问时,被访问数据的地址要求是2的倍数;基于4字节数据宽度的寻址访问时,地址要求是4的倍数。 ) d8 T, y: w9 D' g 
0 J+ I$ u- Y1 j. f! u" ]; g0 @ % b$ N( x$ s8 Q: M 比如:这里定义了一个数组uint16_t forcomp[3]和下面两个指针:# d9 I# e9 i: ~& h1 _ uint16_t *pointer1 = &forcomp[0]; uint16_t *pointer2 = &Stream.Data[0];, {& i6 k2 l) m8 o / m7 ]. {) p, o2 m0 | 现将上面结构体成员Stream.Data[]的内容通过指针寻址按如下方式拷贝进forcomp[]。 - t( [7 O* M' A1 r V4 J( X# j e 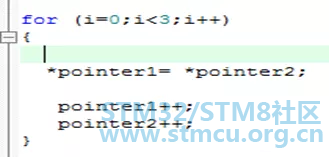
2 ?4 [$ Q* G/ y8 o 9 _* S W% a/ \9 S& F$ N 上面的代码如果运行在基于M0或M0+内核的STM32芯片的话,就会出现Hard Fault错误. 客户使用的芯片stm32L071VBT6正是基于M0+内核的STM32芯片。5 B2 o1 a& v6 U; b! L 1 }6 D8 w+ n7 y2 @6 z W0 l, R1 E, N 
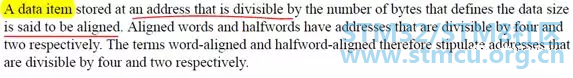
( E7 X# n. _* q+ ~$ e' m# Y9 k5 W8 g 为什么会这样呢?这可以从Cortex M0/M0+的内核技术手册上看到相关描述: 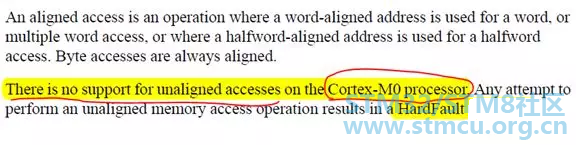
显然,基于M0、M0+内核的芯片,它是不支持非对齐寻址访问的。; z7 ^' W! n8 Q9 t3 ?& S* U- A2 N 1 L3 E3 _: G" ^: n2 R3 x7 e 客户又说过,相同代码在STM32F1芯片上运行又没有问题,那怎么解释呢?3 g( s) }* A( J9 u 6 v2 g8 z9 R& Z* U STM32F1系列MCU是基于ARMCortex M3内核的芯片,关于地址对齐方面跟M0/M0+有所不同。M3内核支持部分指令的非对齐地址访问,相关描述如下: 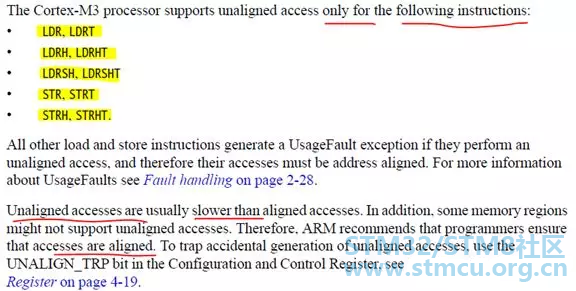
9 F2 T- Q6 x' v 也就是说,基于CortexM3内核的芯片,它支持部分指令的非对齐访问,但非对齐访问要慢于对齐访问。即非对齐访问是需要代价的,访问效率会受到影响。所以,我们在应用中要尽量遵循地址对齐的寻址访问方式。关于地址对齐话题,在各个ARM内核技术参考手册里略有介绍。 结合本案的实际情况,碰巧用户代码先是可以正常运行于基于M3内核的STM32F1芯片,而在基于M0+内核的芯片上出现了异常。导致他觉得不好理解。 这里,指针所指数据类型为双字节类型,为了避免在M0/M0+内核芯片里寻址访问时发生非对齐而导致的异常,可以将结构体变量的内存地址对齐方式改为双字节对齐,即使用#pragma pack (2)。数据在内存中像下面这样摆放。 3 o R- s5 ~! N 3 u5 O8 X9 [ G2 [ 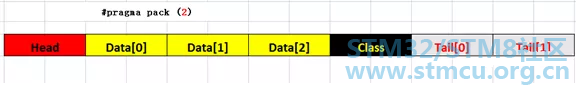
$ P: h7 b; Q1 d0 Y! a6 J7 k! k + b" `! `* X9 Y/ \& `% V* `& L1 O 这样修改后,经过测试的确没有问题。结合到客户的具体情况,客户希望数据连续、紧凑存放,不希望数据间有空隙,即结构体数据成员的内存地址对齐规则不变,仍然采用pack(1)。那么,数据拷贝操作时可以将双字节数据类型的指针强转为单字节数据类型的指针,将双字节数据按字节对齐寻址方式分作两次连续读取完成。此时,用户只需将应用程序稍作调整即可。+ T- L+ [8 g4 ^- h2 ~- T# ~. r2 W 所以,在STM32开发过程中,有些代码或许跟MCU外设没什么关系,但可能跟内核有关。STM32系列众多,涉及多个ARM内核,不同的内核在诸多方面存在些差异,这点需要注意。其实,从MCU软件开发层面来看,地址对齐问题、中断优先级安排问题、堆栈安排问题,都是些比较隐蔽的问题,出错了后果往往也很严重,我们平时可以多留意下。; T; g/ M2 I; \$ | f% {6 U & w3 y! ]6 w* S3 h8 f8 ] |
 ,学到了 |
无刷直流电机控制应用+基于STM8S系列单片机---电子书
MCSDK FOC应用详解
STM32F10xxx 正交编码器接口应用笔记 及源代码
基于STM32定时器ETR信号的应用示例
《无刷直流电机控制应用 基于STM8S系列单片机》
STM32定时器触发SPI逐字收发之应用示例
【银杏科技ARM+FPGA双核心应用】STM32H7系列10——ADC
【银杏科技ARM+FPGA双核心应用】STM32H7系列57——MDK_FLM
【STM32图书分享之九】—《STM32F 32位ARM微控制器应用设计与实践》
STM32 USB的程序,包含固件、驱动和测试用的应用程序
 微信公众号
 手机版


