5.1 如何看原理图
$ x) }* o0 Z, x; c3 U# \以100ASK_STM32F103_MINI的原理图为例,介绍如何看原理图,读者只需要掌握几个要点,就能基本理解原理图的标识含义。100ASK_STM32F103_MINI原理图在“4_硬件资料”文件夹里,读者打开《100ASK_STM32F103_MINI原理图.pdf》(后简称,《原理图》)配合本手册阅读。
6 _3 y* E& `0 ^: F
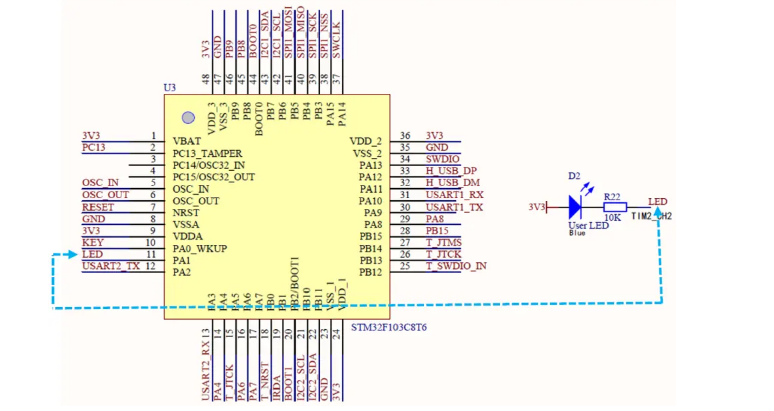
" G8 v+ ^0 T+ \《原理图》由开发板最小系统,加上外设模块和一些接口组成。在原理图上,除了用连线表示两个器件有连接外,更多的时候使用网络标号来表示连接。如图 5.1.1 所示,红色文字是网络标号,只要两者网络标号相同,则表示它们是连接的。网络标号LED一个连接主控芯片,一个连接D2发光二极管,它们之间没有任何连接,但因为网络标号都是LED,因此它们表示电气上是连通的,即主控芯片的PA1脚控制发光二极管。
" D. m1 I3 S8 z
$ o; [2 O- V3 \+ \5 e) m! F. `- ~ ]+ l8 M
图 5.1.1 原理图网络标号连接
9 W3 \1 j; T, K& @3 ?: S& A5 B, V8 I _# r% \3 ~ ^7 ~ W
/ e. U/ ]/ Z+ Q7 s& j; G. d5 H% _) c原理图上的器件类型繁多,但依旧遵循“二八原则”,80%都是常见的器件,因此我们只需熟悉常见器件即可。每一类器件,通常使用英文名称简写标记,比如电阻通常标记为Rn(n为数字),常见元件如下表 5.1.1 所示。
% l: [& y" J" p+ y
1 J8 ]! m7 U! ~2 q" e$ v' _7 ]% O+ X8 i6 `. Y( ^ d3 {- |
6 h, n5 s1 T ~表 5.1.1 原理图常见元件 ' o9 g1 d/ ~9 e1 q6 \
4 o- t1 ~1 s+ ~& j
5 d3 c# _0 E; f" O' C( O
对于一个单片机系统,首先要保证最小系统功能正常,其次再实现与各个外设模块的控制或数据传输。因此看原理图也是,首先重点是最小系统,其次是各个外设模块。对于外设模块的外围电路,需要什么电源、怎么接线,电阻/电容如何取值,读者也不用太担心,通常都能找到参考电路,然后根据芯片手册说明,仔细核对,最后调试验证即可。
+ M6 Y1 X! J' R Q9 \
8 J, X4 e' c5 o
+ U7 j* {& {7 R6 _) P【总结】
2 N, ?$ i. I/ h% N/ E. P* L3 m5 _7 \; O
后面分析STM32最小系统的时候,再感受如何具体的分析原理图细节,对于原理图基础部分,读者暂时理解以下内容即可:. Q, Z, g4 c; m( k- V& K4 \4 ?% g
- F5 u: y. G* D; [
1. 理清原理图板块;
5 \8 ~; P& b8 V% Q% k# M. x0 b+ a z8 a$ e T% g8 }4 v
2. 理解网络标号;
h: @* W- G- L1 M% C0 B# y3 H* o% i0 {7 u1 o, B
3. 熟悉常见元件;9 F, A% d2 R) V; b# B
B, P# ~6 U0 @# S$ a3 T8 H
. m! W/ k# f, I9 b: {$ J
, p9 V- ]9 o- t5 L: w' N5 J* m# A5.2 STM32最小系统
' D5 ?, K( `' x# E5 y单片机最小系统是指用最少的电路组成单片机可以工作的系统,通常最小系统包含:电源电路、时钟电路、复位电路、调试/下载电路,对于STM32还需要启动选择电路。& ]% }5 u7 q4 f+ [
( v J2 J0 X& s" z4 }6 h# e- K
, }: D. n: n$ I& F6 V9 S2 Q6 g5.2.1 电源电路1 ?+ U7 f/ w3 i& T9 @: T
不同的MCU的工作电压可能是不一样的,比如51单片机通常为5V,而STM32单片机通常为3.3V。因此,通常需要查阅该MCU的数据手册才能确定工作电压和规范。
' Q9 r' d2 f) I! G% Z( a' w- G1 f; j8 }
打开“2_原厂资料”的《1_STM32F103x8数据手册【重要】.pdf》(后简称,《数据手册》),找到“5.1.6 Power supply scheme”电源方案小结,可以看到如图 5.2.1 框图。
4 E9 H, S* `9 b0 [
" h: {, O$ r$ y: p9 r5 N3 r, m% {& S) y
7 l% {' z4 B! [) l1 [+ C8 o7 {# {
图 5.2.1 STM32F103x8电源方案 , f* |. g4 _1 I! g+ K; o% s$ m
结合《数据手册》“5.3.1 General operating conditions”的表 5.2.1 ,可得知上图中的各电压值大小。# x$ W' r! p B5 G0 i. R
- f! p# @( x8 @( `: T3 n; c+ c# }% s \1 ?- L) P
9 M2 ^4 B' ~- B2 W. I6 y表 5.2.1 工作电压参考
0 N. l# u( B% N4 S2 r- a4 e①VDD-VSS:标准工作电压;电压范围:2V~3.6V;从VDD1 ~ VDD3,VSS1 ~ VSS3共有3组;经过MCU内部Regulator电源管理,为CPU、存储器等供电;
% z5 d4 D- Q! y
/ L4 G& x u* k( O$ _②VDDA-VSSA:模拟工作电压;电压范围:2V~3.6V(未使用ADC) 2.4V~3.6V(使用ADC);由VDDA输入,为ADC、DAC等供电;0 p0 E: y$ T/ U( k& c0 a
5 J/ g- b( { i1 t* O3 `9 l③VREF+-VREF-:基准参考电压;电压范围:2.4V~ VDDA;可以使用独立参考电压VREF(需10nF+1uF高频滤波电容),也可使用VDDA输入,为ADC、DAC等作基准参考电压;, X& \' P7 N4 e6 ]. r# }
0 R, o( G% F( ?) K) L
④VBAT:RTC备用电源;电压范围:1.8V~ 3.6V;通常使用纽扣电池外部供电,当主电源VDD掉电后,VBAT为实时时钟(Real-Time Clock,RTC)和备份寄存器供电(此时功耗超低);
' O& G& f' x# R7 ~, S: j0 }. u2 @# g, F) A0 [
: T# E( u8 o. P/ m$ ?从数据手册了解到以上知识后,再来看看原理图的MCU电源部分。开发板采用USB供电,通常USB都为5V,因此需要将5V转换成3.3V,使用AMS1117-3.3电源芯片即可实现,如图 5.2.2 所示。6 y( ?: i _- E( F7 z. G
+ E; a" y4 {2 F* v3 i) A
# y0 f% m; f6 u) l, P
* ~! P \* n% H2 T+ y3 m" F图 5.2.2 电压转换 3 z% y9 O W" _. p1 a4 C3 X
通常USB口由其它电子设备提供,还需要考虑其保护。这里使用自恢复保险丝F1,避免USB口短路大电流烧毁;使用TVS二极管E1和E2,避免静电损坏USB信号引脚。: ? f7 W& T' z; X4 H
( e2 t4 D$ f5 |! k3 S
使用转换后的3.3V提供给VDD1 ~ VDD3和VDDA;VREF+和VREF-在引脚数大于100脚的芯片才会有,因此STM32F103C8T6不涉及;VBAT这里直接连接3.3V,简化不使用对应功能。
( T9 o( s* Y- F4 j$ r. o9 u
4 Z& E2 t+ V0 R- }$ S; j# |4 v; Q- {- C) l0 z x
5.2.2 时钟电路
- m8 v) J6 ?7 S$ {MCU是一个集成芯片,由非常复杂的数字电路和其它电路组成,需要稳定的时钟脉冲信号才能保证正常工作。时钟如同人体内部的心脏一样,心脏跳动一下,推动血液流动一下。时钟产生一次,就推动处理器执行一下指令。除了CPU需要时钟,芯片上所有的外设(GPIO、I2C、SPI等)也都需要时钟,由此可见时钟的重要性。( D6 o$ r' X' R7 Q4 I) u5 Y
1 F- ?9 D! O. U, V8 z# L1 n芯片运行的时钟频率越高,芯片处理的速度越快,但同时功耗也越高。为了功耗和性能兼顾,微处理器一般有多个时钟源,同时还将时钟分频为多个大小,适配不同需求的外设。7 {6 w" u l6 B' s( ^- P% y. P7 M
1 c# \9 k( T. l I由《数据手册》可得到如图 5.2.7 所示的时钟树,这里只关心时钟源,时钟的分配使用放在后面讲解。
; c8 c- A6 K/ b8 @! h& W: |1 ^5 I; [* I3 b3 a3 ]1 M3 \: z
. v3 V% v) f ^) r4 F" _* c u8 _ ~1 f2 d% }
图 5.2.3 STM32F103x8时钟树
9 e' `6 ], t/ c+ p, P
V" }, j# v7 p7 f) |3 y) H. v: C3 R9 Y7 _2 C* J6 D
可以看到一共有四个时钟源:% e0 j! S P* k! [" P6 v" P5 x
. `+ Y) b2 j3 a* U; ?①HSI(High Speed Internal clock signal):6 |) X: z3 j& N; I6 ~1 Q2 H2 ~
* O* @* g- W5 G& q! W7 hHSI是内部的高速时钟信号,频率8MHz。因为是内部提供,可以降低成本,缺点是精度较差。& Y. P4 ~! [/ T" `# X9 _8 c
|) L6 B4 H, C$ M7 Z②HSE(High Speed External clock signal):
e; N$ W$ Z* E, W! Z7 m! P2 ~, Q) j b, ~
HSE是外部的高速时钟信号,需要外部电路晶振,输入频率范围要求为4-16MHz。因为需要外部电路提供,成本会增加,但精度较好。
- C0 {/ e6 d& M. l1 Q9 {: F6 E
③LSE(Low Speed External clock signal):7 A. a+ p( F) Q, _4 U3 J4 |
; \; P x6 j" S" _. o" W1 p D9 X2 F: iLSE是外部的低速时钟信号,需要外部电路晶振,输入频率范围要求为32.768KHz。一般用于RTC实时时钟。# k: z9 X" J$ J- v
" Z. p, I. O7 f3 t4 }2 F& d④LSI(Low Speed Internal clock signal):' H5 Q* @/ O+ V$ v, s+ B0 x
/ [, o4 O' Y- b( VLSI是内部的低速RC振荡器,频率40KHz。一般用于看门狗、RTC实时时钟等。% T/ P( c5 `5 n. Y2 z! T
7 x) Q6 N7 M6 e- j0 c8 U' X" A" P
# h$ X) F& w/ s4 P. b. ]7 d* b4 A! |1 Z. A4 O* r3 s
对于STM32F103系列的MCU,都需要一个高速时钟和一个低速时钟,而这两个时钟可以选择使用内部时钟源节约成本,也可以选择外部时钟源输入提高精度。如果使用内部时钟源,则无需设计外部电路,反之,则需要时钟电路。- ?3 ]* G g* R8 [/ i( c9 v4 \
7 N' m- }8 W V ?/ j9 b( N$ s继续查看《数据手册》,可以看到如图 5.2.8 和图 5.2.9 所示的外部时钟输入参考电路。手册上提到对于HSE,当晶振为8MHz时,CL1和CL2的容值范围为5pF~25pF。REXT用于产生负反馈,保证放大器工作在高增益的线性区,同时也起到限流作用,通常在兆欧级,具体由晶振决定。
, t/ w6 n% D, V' p) F( n! y' s6 o' a+ o( @
; Z; n X! m8 r6 R3 E. N" K+ z8 Y
图 5.2.4 HSE典型应用(8MHz) + { F9 h2 o5 w6 k4 p- O
# t" ]1 u. l4 C9 J3 k3 V# j
9 h- U3 Z/ p% T$ x6 y# c% H
对于LSE,当晶振为32.768KHz时,CL1和CL2的容值范围为5pF~15pF。之所以选择32.768KHz,是因为32768=215,分频设置寄存器通常为2n的形式,这样经过15次分频就很容易得到1Hz的频率。
" M# W; r0 s! q7 E& y# v0 m6 b
/ \! n9 V; x7 M, V8 w/ K$ k( n" h) l. a; z+ o
: X7 u2 z: O4 o2 S2 ?' H2 O) u; w图 5.2.5 LSE典型应用(32.768KHz) + }& E' k% z: t4 U: N U: G
从数据手册了解到以上知识后,再来看看原理图的时钟电路部分,如图 5.2.10 所示。高速时钟由外部提供,低速时钟由内部提供。' A" @& N5 o6 ?, Z2 o, R. }' R8 m
% j0 B2 ~" J) p8 Q. Q) R, M$ W
晶振旁的负载电容,应选择高质量陶瓷电容(NPO),以满足高频率场合。在Layout(PCB布局走线)时,晶振和负载电容,应尽可能的靠近MCU,以减少输出失真和启动时的稳定时间,保证振荡器可靠工作。
# @3 m* G' i. c! b% |+ x
! |! ~, y1 a/ P4 T* j, v
8 O* q- x8 Y) R c. p: k) N
X6 |0 c5 U) p" t/ k$ A4 k( J图 5.2.6 时钟电路 - \7 e0 D5 H) E# [. u
. I" x6 T$ g/ ?2 r" P; }
1 j+ _( h; {5 g% l! i. Y& M5 Q5.2.3 复位电路
! U1 f3 V. k6 H3 V* @1 Q0 A嵌入式系统中,由于外界环境干扰,难免出现程序跑飞或死机,这时就需要复位让MCU重新运行。查看《参考手册》,可见如图 5.2.11 所示复位电路。该电路将一个按键接在了NRST引脚,一旦按键按下,NRST就会接地,拉低NRST,实现复位。
! W0 l5 w3 x$ ^& e6 U" y! V8 l* |
4 M% w& d% Y& [1 ~
5 ^. L7 {& A4 n' K2 G0 y
% b1 K c: J- l N图 5.2.7 复位参考电路 # |. T% C. \! g( L; R3 x: O% H. T. w) r
再来看看原理图上的复位电路,如图 5.2.12 所示。当开发板正常工作时,3V3上拉NRST,当K1被按下, NRST会导通接地,拉低NRST,使MCU复位。/ Z" i4 B* d( c& y* ]
" Z3 C; W, W, a" U; e& C! h
: M7 Q0 |8 ~* f6 F: {8 Y
5 O# W+ T0 l o* v* |3 y! C Y. X/ r图 5.2.8 复位电路
5 @' L% G1 h, [* L$ @* L) {3 L) |# E
! L1 H, b& d9 b( N: @1 v
5.2.4 调试/下载电路) B( N1 ^ G( h
不同的MCU,调试/下载的方式可能不一样。比如51系列单片机,使用串口下载程序,部分也使用串口仿真调试。对于STM32,可以使用串口下载程序,也可以使用串口打印的方式进行简单调试,如果想仿真单步调试,就需要JTAG(Joint Test Action Group)调试接口或SWD(Serial Wire Debug)调试接口。
# M1 w) h' E) q2 M5 P' V0 O6 S7 n8 x8 E) X
本开发板支持串口和SWD下载,如表 5.2.2 所示,日常直接使用串口下载,无需额外设备,方便快捷。需要单步仿真调试时,使用SWD接口,功能强大。
: j2 o' U8 x2 V1 A
. q" }- J f* j' n% b, r6 y) t* f' V8 t. E2 P1 f2 ~6 E2 n
) O/ D& _7 o7 W9 H6 x* p' E
表 5.2.2 调试/下载接口
% B. S8 w* Q9 D, e0 N串口自动下载电路涉及BOOT启动选择,当BOOT0和BOOT1引脚都为低电平时,MCU正常启动;当BOOT1引脚为低电平,BOOT0引脚为高电平时,进入串口下载模式(In System Programing,ISP)。串口打印调试/下载电路如图 5.2.9 所示,上电后,CH340G的RTS和DTR都输出高电平,电脑上位机软件控制DTR引脚输出低,PMOS管导通,电容C2充能,BOOT0逐渐变为高,此时三极管Q2导通,复位拉低,MCU复位。随后控制DTR输出高,PMOS管关闭,C2放电,BOOT1会保持一段时间高电平,此时三极管Q2截止,RESET上拉,开发板启动,进入串口下载模式。下载完后,跳到下载程序位置,运行下载程序。
6 k: n9 C' W& B" Y0 h
/ n! `: E5 d2 f* T y* |" z: [5 n1 x/ I& Y Q; f0 ~1 }; F4 s
5 P- \) B2 w* L5 n: {# M
图 5.2.9 串口打印调试/下载电路
4 Z- U' K) P. }2 o; M: {" a7 w: z 开发板除了用于单步仿真调试/下载SWD接口,也可以作为ST-Link去调试下载其它SWD接口。这里把两个接口做在了一起,实现了两个板子直连,一个作为ST-Link去调试/下载,一个作为开发板被调试/下载。所涉及的引脚参考表 3.4.1,原理图如图 5.2.13 所示。
. g# c. T M# B1 d0 l& B. p o6 ~/ C6 `- F9 H% Z( S: e% |
$ q E& q+ |2 a5 w# ~' w- \0 a3 d5 p5 ^2 t" j' D& ^3 V+ j7 U
图 5.2.10 SWD接口调试/下载电路 : t0 i# l, F- j
【总结】
2 I% s/ E$ y9 F; @' `% S3 p$ S# H+ T* E. U
本小结带领读者学习了如何读原理图,也对STM32的最小系统有了一些了解。后面的电路众多,在分析某个电路时,结合相关手册的参考电路和说明,加上不断积累,相信读者也能灵活分析原理图。; M$ o" J9 H; k& L6 _
5 V6 }% Y( j1 {+ R! v% K4 i9 `0 q/ P# V; E/ e4 m" [
$ }3 `2 W& C' c8 C6 n' \+ c& O
5.3 嵌入式C语言4 |( D9 {+ I4 X6 s1 H- ]$ k
5.3.1 基础知识: u' I k* S, M, F& h) w. E8 v8 C
嵌入式C语言和普通C语言在语法上几乎没有差别,其主要差别在于普通C语言的运行环境是OS之上,有很多的标准库函数支撑调用,分配的内存是电脑的内存,其处理器就是电脑的CPU;而在嵌入式环境中,会涉及到底层的硬件,而硬件本身是没有标准库可以调用的,因而就需要开发者使用C语言编程调试硬件,使其可以工作,对于开发某一款芯片,有针对的编译器(或者交叉编译环境),可以分配的内存则是芯片的RAM、Flash,处理器则是芯片自身带的MCU,例如ARM、DSP等。1 W) Z! o1 ^0 [: M6 R
9 K8 d4 G& t! B, v/ k例如C语言编程的入门课:打印“Hello World!”,在普通C语言编程中,直接调用printf()函数即可在PC上打印出;而在嵌入式中,则需要开发者使用C语言去将芯片的串口调试成功,然后将printf()函数重新实现,方可调用打印。9 X5 u0 M+ q. O5 |% `
2 }3 q$ k. D# J4 V; k
嵌入式C语言的基本结构及其特点:4 K9 k9 w: Q% a/ b/ t* j5 I
* s1 O* I' n( w4 I5 u! r f1 h
1) 所有的C语言程序都需要包含main()函数,代码从main()函数开始执行;这一条在嵌入式中不一定完全正确,在执行main()函数之前也有开发者可以操纵的空间,因而开始函数可以不是main(),例如也可以是myMain()这样的函数,而这所涉及到的知识已经超过基础知识的范围,会在后续详细说明;
! `8 [3 I/ a' N$ t N
- M- H M0 `. Y+ b2) C语言的语句以用分号“;”结束;: ]3 v. b4 ~* A- D9 R# k
& v# {2 B& k2 c q/ g. L/ n1 }: B6 b3) C语言的注释有行注释(“//”)和段注释(“/*…*/”);
* b( D0 |7 j( ]4 ~* P' g7 ]$ j, B' Z j+ V( v
4) 函数是C语言的基本结构,每个C程序都是由至少一个函数组成;
" k$ E3 w- s$ i" S* Y
3 @! k- E' h* ~/ _' j5) C语言的文件有两种格式:源文件.c文件和头文件.h文件,通常.c文件用于功能函数的实现,而.h文件用于预处理、宏定义和声明等;在嵌入式中,通常将某个硬件模块的功能实现函数及其声明和包含的全局变量声明分别处理到一个.c和.h文件中,例如led.c、hello.c和led.h、hello.h就分别对应于LED灯的功能函数及其声明和hello的功能函数及其声明;' `& y& H) u/ Z. S% C' v2 ?
0 |& r; \9 [6 w0 U; I+ n; @
6) 我们将这种基于某个模块的独立设计称之为模块化设计,在一个系统中通常是由许许多多的模块共同组成的,因而模块化设计是一个非常科学且非常值得学习的程序设计方法;3 O* ^& Z! g) i4 ^9 B
/ T: z8 b: S! E* j% M
7) 除了模块化设计,通常嵌入式的编程设计还有层次化设计。在一个工程系统中,硬件驱动仅仅只是第一步,对硬件的应用则是一个功能丰富的系统的更进一步的设计,通常在这一块会设计到例如图像处理、数据处理等算法;我们可以笼统的将一个嵌入式工程系统分为驱动层和应用层。 d: {) [7 z2 X& y- L+ V
: s) {& {4 T3 D, q7 a/ o
5 L! v% b& r/ q% v6 l( ~% y: z, ~7 f% l$ {4 F! L9 Z
5.3.2 数据类型& m$ e4 |$ h9 {4 ^& c# n
在C语言中,数据类型指的是用于声明不同类型的变量或函数的一个广泛的系统,变量的类型决定了变量存储占用的空间以及如何解释存储的位模式。
; E: o4 e$ y3 c5 ]5 w, w1 w8 z) c: n+ C, C
在嵌入式系统中,芯片的容量是有限的,且对比于PC机容量通常都是比较小的,因而了解变量所占用的存储空间是嵌入式开发者应当掌握的一项技能,所以对于不同数据类型在不同位数的芯片中(例如STM32xxx就表示此款芯片是32bit的芯片,STM8xxx表示此款芯片是8bit的芯片)的长度开发者也应该掌握。
2 z$ i) x# E; J. K9 ~% w# a* U/ e8 `
C语言中的数据类型有以下几种:9 r* V, d5 O( v
! z8 a: B1 }- W" G
7 d8 ?% W4 {8 n5 w& j. ]( Y, u
' U; X1 ~- f) H+ l0 {3 [
图 5.3.1 C语言数据类型 0 _! {2 A* W3 h/ |+ { S+ G, b1 Y
就以STM32F103C8这一款芯片为例,这是一块32bit的MCU,基本数据类型在此款芯片中的数据长度,以及在HAL库函数中的定义(stdint.h文件中的定义,采用C99标准)如图 5.3.2 所示。这里建议开发者在开发过程中使用库定义的数据类型,来定义变量或函数,比如unsigned char a,使用uint8_t a。( [/ m& i- C/ X0 p
' W/ E1 L5 Q3 I( w. G: H# k) Y
1 g# a$ a! J$ C# d
3 y+ m1 R. v) U图 5.3.2 本手册芯片涉及数据类型 7 g5 W% t0 Y& `2 l% }! I
& D+ S8 [# X5 D. A V- {7 x. f0 Z( F: Q! w9 x
5.3.3 const用法; H3 Z5 q- c2 e
C语言中const关键字是constant的缩写,译为常量、常数等,但const关键字不仅仅是用于定义常量,还可以用于修饰数组、指针、函数参数等。
% R8 N6 C; o6 e& @* |# z. r% T/ Q8 {% z7 m0 K7 G/ n5 ~
1) 修饰变量5 Z/ E% B+ F1 {- a$ T
! M7 h e* Y' ^$ G. _
C语言中使用const修饰变量,功能是对变量声明为只读特性,并保护变量值以防被修改。例如:
% S# L* ^' l* r% s, C/ a这个例子表明整形变量i具有只读性,不能够被修改;若想对其重新赋值,例如i=10则是错误的用法。需要注意的是,const定义变量的同时还必须对其初始化,const可以放在数据类型的前面或者后面,比如上述例子也可以写成:4 Z" z. m9 O9 |9 m7 ^
+ t( V3 q- }. J" ]( C6 n2 ?/ a3 {7 u/ S7 w( `) Q- B) I. c
此外,const修饰变量还起到了节约空间的目的,通常编译器并不给普通const只读变量分配空间,而是将它们保存在符号列表中,无需读写内存操作,程序执行效率也会提高。
( ^* Q: a L6 w8 j8 Y- T1 l, f
2 O Y, y# t& W" Q% e4 N. A8 u7 u
8 w( E2 V$ v& J3 I2 f
! e1 G" R( Y8 D+ v$ o/ H2) 修饰数组( Y) V, j: i. I2 w& n$ X$ x
' x" L. t9 s& i; u
C语言中const还可以修饰数组,例如:
1 t5 Y" J' O. j8 s* v
" M! T+ l2 e5 H# M- const int array[5] = {0, 1, 2, 3, 4};: ^6 E# ^4 X& w) x& V0 Q; b6 v
- : X4 d& l1 m" ?! S K
- // 或
# }1 {2 s0 I7 q
# c* ?2 b$ Q6 O5 U* c, f8 U- int const array[5] = {0, 1, 2, 3, 4};
0 n2 \" J5 v8 ?const关键字修饰数组与修饰变量类似,表明此数组具有只读性,不可修改,一旦被更改程序会出错,例如上述例子如果:0 {$ y2 K1 }/ {! m' w7 t* G
( ?$ p |% ~& g" @
/ ]5 g& Z2 p4 H/ A则程序将会提示错误。
0 w" e' Q2 k1 h+ I2 {9 M4 D
0 H( C4 h0 N' s5 h: g8 `) ^+ e
3 o: B) R+ o1 a! F a& M1 A. W% R
* g3 ^2 p2 Y' s# r* H- \3) 修饰指针
% j i; Y1 b( w" v0 K
3 Q/ }$ i8 a8 hC语言中const修饰指针需要特别注意,共有两种形式,一种是用来限定指向空间的值不可修改;另一种是限定指针不可修改,例如:* ]$ o2 M, r: V8 g
( \" S; N4 z3 \( ?' T! a- int i = 5;. o7 o; F6 g S5 F
$ S$ _$ H- b' F% j) k+ t2 O- int k = 10;
% b( n- c+ m8 ^$ P - ) h* E( o: g, l* k2 f5 W
- int const *p1 = &i;* ]' z6 U! D2 u! ^! J3 @- |7 b2 O
- * ?! G- F' ?, m+ C1 C9 K; x
- int * const p2 = &k;
对于指针p1,const修饰的是*p1,即p1指向的空间的值不可改变,例如*p1 = 20;就是错误的用法;但是p1的值是可以改变的,例如p1 = &k;则没有任何问题。 o! D8 `7 `- N. l' V$ \8 T' }
5 p# f# v9 i0 t3 `: z' A9 c对于指针p2,const修饰的是p2,即指针本身p2不可更改,而指针指向空间的值是可以改变的,例如*p2 = 15;是没有问题的,而p2 = &i;则是错误的用法。# r0 S. A0 g( G; ^% k
! z6 H9 a. v( E. W1 J$ x2 w4 Z
5 w/ n5 ]* K3 h+ h4 X$ y6 N6 x
6 _! e1 c" ], e4) 修饰函数参数, ?1 L/ L- I: N3 F
9 ?0 ], p6 T8 }& T" P% _& J0 B
在C语言中const修饰函数参数对参数起限定作用,防止其在函数内部被意外修改,所限定的参数可以是普通变量也可以是指针变量,如:6 f7 H* z" G8 n1 @; X
8 u8 d( o. @4 t/ s7 K5 E$ ?
- void fun(const int x)1 @( n. r, N, S/ f: G8 ]
- 3 f9 X. I5 q3 s5 {/ I; b
- {
* N: {" L5 }% H' f
1 X8 h; b7 v3 ?1 p% t- ...
" S% `8 u3 {+ K' F; x, p9 k
. }% c h7 Y7 f# r: ]- x = 10; // 对x的值进行了修改,错误( v4 H/ f) L& D) S6 Q
# V( e! r$ ?5 ]; {. m, v0 L- } M0 g- t+ Y% [/ t. `
9 q& S2 A+ V( ~: E' N$ R+ R
6 t: p6 ~9 m. l) ` B
" \% p! ^* t G' n- void fun1(const int *p)
, G# B& t" {; y
( g' ?6 g- Z! [7 ^% b- {
+ r1 Y& H" l0 G, o: K/ o - 0 Y- _' q4 }1 S- d
- ...- ^' z+ u+ e* b& a
- 9 Y/ S" E* I" {" L; B/ s
- (*p)++; // 对p指向空间的值进行了修改,错误
6 C/ F# {; h) q0 |
o4 R }9 q6 V3 V( U g+ i- }/ ?6 A0 S) p0 \3 V+ p
8 L: X: T2 X" [3 q: Q) W$ g' q) Q* \4 w* g. D2 `
5.3.4 作用域与static用法( k9 M1 ^' q" {7 F" `/ V
在了解static关键字的用法之前,我们需要先了解C语言中的作用域、局部变量和全局变量的概念。. J2 d! M9 C3 X1 F+ O+ L
2 p% H& d* i6 Q一个C变量的作用域可以是块作用域、函数作用域、函数原型作用域或文件作用域。
$ \" H8 M+ M! a
1 W, J# l5 v" z7 f! |块是用一对花括号“{}”括起来的代码区域,定义在块中的变量具有块作用域。块作用域的可见范围是从定义处到包含该定义的块的末尾。以前,具有块作用域的变量都必须声明在块的开头,C99标准放宽了这一限制,允许在块中的任意位置声明变量。例如不支持C99标准的的for循环需要这样写:
3 y \9 @0 P0 m/ a S. Z2 d$ U2 Q' |4 g+ e
- void fun1(void)7 M4 u% s* ]% D
: W' ~6 }( P! O) |2 N' r$ J- {
c6 [ P: x# g
3 s7 H% M! B5 Z1 U/ T- l6 L. L- int i = 0;1 ~2 \. y' b ^
- , `6 U) z; l7 a" B
- for(i=0; i<10; i++)
) p+ Z* l2 s4 C8 |3 Z' n8 D0 P - 0 B, @6 q' a# o5 H6 d8 M
- {
5 X; \0 b4 d. k/ L' V8 x - 5 }8 V% B. x: Z0 v. Z# e# Z- v
- ...
6 N6 p1 G/ P0 `5 z) p - % [. W: W) \- A) Q7 b8 m
- } h$ B# [- x* F) m( M8 b4 }
- ! k0 v3 }2 o* n) v$ O
- }
1 t! P) e: N4 ]# [* R4 a在函数fun的开头定义了局部变量i,然后在for循环中调用此变量,变量i的作用域是函数fun内,当函数fun执行完毕之后变量i会被释放。而C99标准下可以这样写:0 @/ y6 O( M. P
# X! G. B2 k$ O* n- void fun2(void), B$ b, P1 l2 v% c, s% c6 P8 ?
- ) G( v+ X- V5 t9 R( Y; `! `. I
- {
) s+ T& v3 T# c t; H4 x - # q5 J6 @4 a9 f1 Q" w( k o6 v
- for(int i = 0; i<10; i++)) N( F! A2 E& D* M
- $ n& x; ^* n) f" ]+ `# C9 Q. ^- H
- {
# @0 @# q9 `# \ - 8 }: G, _# [# ~: |0 s2 G
- ...
1 O9 U: w! L( X! w; X - 2 x' M" t: Y. |$ T/ D- p/ S
- }
: ^, X' ~ B. x1 E - $ |" s w+ @. g2 C5 |- z
- }
! |, t5 Z. _. l' `) @3 A7 R这样写的话,变量i的作用域则在for循环体内,当循环结束后,变量就会被释放,可见其作用域缩小了,这样的好处是增加了安全性和灵活性。. l' F% t' ^6 ^4 n0 _" k& H$ t5 H
1 P V# o1 u8 x在函数fun1中,变量i被声明在函数体内,我们称这样的变量为局部变量,其有效范围是在被定义的函数内,函数执行完毕后变量即被释放;如果把这个变量定义在函数体外,如:
9 T6 F, h2 F) v- p
( Y% K4 `# l9 x0 k- int k = 0;7 }' o) Y0 o4 O7 }
- : k# X& \9 D1 P! I
- void fun3(void)
- l1 a) R$ ]- w8 p8 c- a9 ]& @, n - ; I. d% |' N0 y
- {1 h# E% ]7 f$ s
- * ]! I9 I5 U9 z% Y+ t7 X
- for(k=0; k<10; k++)
) r: X% R4 p0 W8 q
6 x3 r2 M7 w4 j" B7 y- {
- x) x4 C6 A6 ]9 C6 a O0 u
1 K0 l+ Y' t- B; h- ...
3 e5 z6 C# \9 e+ q) s o3 n2 ? - 9 }. m: X4 [8 x
- }$ ~1 X( }0 o" j _) A# E0 p2 H
- 2 J. A( b9 C; A3 X
- }
1 v% {: Z0 e3 |5 Q7 a' \: h我们则将定义在函数体外的变量称之为全局变量,其作用范围为当前源文件和工程,若其它源文件想要调用用此变量需要在文件内使用关键字extern声明,如extern int k。
" Y; D5 a9 [2 B) k1 n% i" J8 u' i, K4 g$ P
简单的总结下局部变量和全局变量的特点:
r1 R* J( U+ B- I- j9 {. q5 r Z% k0 Y% J
1) 局部变量会在每次声明的时候被重新初始化(如果在声明的时候有初始化赋值),不具有记忆能力,其作用范围仅在某个块作用域可见;
4 i( x1 Q" F: z3 L4 b5 k
: n8 n0 S, r3 W1 a2) 全局变量只会被初始化一次,之后会在程序的某个地方被修改,其作用范围可以是当前的整个源文件或者工程;, {- f+ D( W) Z
- X6 [5 ^, n- q+ v
2 _! b2 e8 S$ {% a
. L) @) Q& M5 n& G! J- O3 @ z" y4 R鉴于两种变量的局限性,就引入了静态变量(静态局部变量和静态全局变量),使用关键字static来修饰。其中静态局部变量满足局部变量的作用范围,但是其拥有记忆能力,不会在每次生命的时候都初始化一次,这个作用在用来实现计数功能的时候非常方便,例如:
9 i' d9 T- T9 [4 r7 H" P
5 }0 U$ g9 W! R/ |, ^' L- void cnt(void)$ x9 y2 m8 U$ s2 D
! v; T( m& l) E# p, W0 S" ~- Q- {
0 u7 M9 v0 T; y - 5 N' S0 a0 _" Y5 \
- static int num = 0;
( B* Q5 q, G3 c6 t - W/ C1 x8 _% S( A! X* z _+ `
- 1 b. v" y" e0 {) C. t: `- T' ]
! r! N/ ~1 X; H9 M9 S! `7 ]- num++;
9 n0 K, B9 L1 Q! F, Q% c, ?
7 Q( h4 I' x6 K3 Y& |, D; T! j- }
在这个函数中,变量num就是静态局部变量,在第一次进入cnt函数的时候被声明,然后执行自加操作,num的值就等于1;当第二次进入cnt函数的时候,num不会被重新初始化变成0,而是保持1,再自增则变成了2,以此类推,其作用域仍然是cnt这个函数体内。
: L3 S2 b( d) M3 [3 p3 S n$ R$ p, i8 `1 p9 O) W
静态全局变量则将全局变量的作用域缩减到了只当前源文件可见,其它文件不可见,简单例子如下:
( k8 o4 l4 \4 Z6 K$ |$ r8 l l8 o1 b7 ^/ N8 O
- static int k = 0;
% A1 G* ?) u% {' }, U: V p - 9 L/ @3 X! R2 I: e" F4 e8 g3 v
- void set_k(void)
6 E7 @; @- l8 i) @7 U5 l; U0 N+ s - / i0 U7 \3 C0 c T# o8 @1 ^
- {& y+ Q% X1 C; {4 n! [% n
$ J, T% z+ J1 [7 Y* _8 Z+ a8 h4 e- k = 1;5 d! y9 b0 q9 ?
- * ~8 Q& h# k3 A
- }% ] Y* z' O% ~, z* P
- , i( h5 d2 ?$ L0 L$ l4 R" t( M, B
- + `" M& y6 ^% D/ ?, G0 J
- $ t+ [& y9 R o# {9 E% D! w
- void reset_k(void); h2 M9 Q$ W" S* B& W+ O" C2 P
- ) ?' k [8 v) p2 U( r) l8 D F, W, u, r
- {
7 [1 l/ o8 D" A' S - ! g( A6 b# i# Y; P2 e- a
- k = 0;
( @7 K, I; l( o: K! G - ) b+ w, O }5 o) v4 H: o
- }
) H9 J: n" j5 `/ o - ; h: j- `* o L9 w
- int get_k(void). X5 Z2 u* @ A
) P& q4 o, H7 j- {
, n2 q/ W! a! B7 Z; Q- c- Q
9 C: Y8 [& K M: P, K6 A- return k;3 v% R2 d* _+ ?$ A
- ( ]% ?! j3 x0 D/ Q
- }
静态全局变量的优势是增强了程序的安全性和健壮性,因为对于变量k而言,我们假设我们不期望其它的文件有修改变量k的能力,但是其它的文件又需要变量k的值来进行逻辑运算,那我们就可以向上述例子那样做,在源文件中定义一个静态全局变量,同时使用函数对其的值进行修改和获取,对外只提供函数接口即可,其它文件通过函数接口间接的使用这个变量。这样做同时也可以提高可移植性。
4 [% t; s7 S3 o+ h; E3 `/ ]9 ^- h/ l) |
静态全局变量只在本文件可见,因而其它文件也可以定义相同名字的静态局部变量,例如我们可以在source1.c里面定义static int k = 0;的同时也可以在source2.c里面也定义一个static int k = 0;这样做是不会有问题的,但是我们一点都不建议如此做,因为这不利于程序的可读性和可维护性,也容易让开发变得混乱。
$ _( b/ X1 G! C# I |4 c' S2 e3 I( P
在C语言中static关键字除了用来修饰变量之外,还可以用来修饰函数,让函数仅在本文件可见,其它文件无法对其进行调用,例如在example1.c文件里面进行了如下定义:6 L; @- r7 e/ f* r
; j/ S4 } i# o2 u
- static void gt_fun(void)2 \) l1 r+ O" A4 z0 B' |
7 T5 v! n# }' X: ?- ]- v- {
* B6 M. V2 ^2 I' H: c5 _( b
, \. G) J! p D: D1 [, _- ...$ b7 w; c) R" r0 R4 O, V( E1 P
- ' Z0 P; w1 i9 m% U
- }
& b# F) a0 y# K5 Z1 G那么gt_fun这个函数就只能在example1.c中被调用,在example2.c中就无法调用这个函数。而如果不使用static来修饰这个函数,那么只需要在example2.c中使用extern关键字写下语句extern void gt_fun(void);即可调用gt_fun这个函数。) I4 E ]& Y* s, E; r3 H# h
4 i% M1 A* O, p* z+ @
在嵌入式C语言编程中,static是一个非常灵活非常好用的关键字,它可以让程序更简洁、更安全、更具有可移植性,在嵌入式系统中这三点都是非常重要的编程思想,需要认真掌握。
9 E' z, I( i8 g8 A n
: b3 x- R! s! v, m3 y
4 a! H; {+ a5 f/ Q8 i# ], W" j8 j) j2 b, i5 i
5.3.5 extern用法3 P7 _: A+ Q% P t3 d3 k3 v4 L
在上一小节有提到过extern这个关键字,那么这节就来详细说一说这个关键字。在C语言中,extern关键字用于指明函数或变量定义在其它文件中,提示编译器遇到此函数或者变量的时候到其它模块去寻找其定义,这样被extern声明的函数或变量就可以被本模块或其它模块使用。因而,extern关键字修饰的函数或者变量是一个声明而不是定义,例如:! S! C4 s. s- O) X; q1 {0 R! M
4 _% r- n3 b+ N+ M6 L' w& y6 @ q
- /* example.c */
J3 d! [# O R5 c$ p& p9 m$ T" @ - ( N1 w3 W1 b/ Q+ H5 T2 d
- uint16_t a = 0;
/ V& q- [9 J. S3 W8 n W& ~) L - 3 Z2 l3 L5 G G/ r, b- G( x7 i
- - F+ L& v+ @2 F1 ]& ^ M
( `+ H: t. H8 c: \- uint16_t max(uint16_t i, uint16_t j)1 \* d6 V2 E, D
- 3 L+ }# A' C" K- n9 c C3 I' j
- {6 X( f% v, h5 ]4 g! M+ Q) g
2 L3 A- N) `4 I6 X8 y3 u- return ((i>j)?i:j);
8 K) N: R6 d# S$ c - d, J& t' Y- `; a B3 [
- }
- /* main.c */
0 F5 j6 i; {; [1 U" d$ u
3 `1 p+ f0 v `" q" G' P V- #include <stdio.h>5 n" \. g! t0 X5 ?& [# _' R( F
- . x7 d% b) f( ^* J6 u' S2 [
- k* C0 T# a' a" _
: r }& H: \3 R& c1 K g- extern uint16_t a;. w7 L/ a- i8 ^6 } ~8 L: v% X# r
- ' O' W( n- K# Y- q
- extern uint16_t max(uint16_t i, uint16_t j);$ Y' j4 {! B2 N3 t9 @$ v
! _( Y: L1 ~; T8 V% a v5 P
. q0 {3 u r5 K% N- 8 ~7 f- o3 c' `7 K7 l
- void main(void)
3 ?' b8 H ]% ^# N/ Q. B - / o: g: A; c& f# s5 D
- {& m* u* H9 {6 _
9 I, [, I* S+ m- printf("a=%d\r\n", a);8 a# V; X( X- B- n& z) D1 @
( V8 L J4 i( ], a2 Z- printf("Max number between 5 and 9: %d\r\n", max(5, 9));
- W& t# {6 o r3 v& N
j+ N+ V# E6 v8 _9 F- }
extern关键字还有一个重要的作用,就是如果在C++程序中要引用C语言的文件,则需要用以下格式:
( e0 \) r! T$ w
7 H, V! d; R& \" l) l8 O- #ifdef __cplusplus5 j; [8 g/ ?! P+ Z3 ^3 [/ X" I1 @% y
1 R4 P# D7 D3 v. t3 z( z, _- extern "C"{0 u! g' L1 v- T5 m, e" V
- . C( G8 U+ U- P5 c5 Y
- #endif /* #ifdef __cplusplus */
: ]+ \& r( j2 ?4 Z - # q" O. }1 f+ I; y+ B! K
- ......
2 L" Z; q& _: u$ u+ `/ |1 Q
+ D3 F) K0 ~/ V( r" I0 s- #ifdef __cplusplus2 s- N2 {( a5 h" U* A! L
- 2 m5 R3 U* K& H3 w6 S# D* D: o' P8 n
- }
/ Z7 x5 u7 y- a9 ?2 D/ R. O U. E
+ e% R% h( F7 `1 s- #endif /* #ifdef __cplusplus */
# V. M D# k" `这段代码的含义是,如果当前是C++环境(_cplusplus是C++编译器中定义的宏),要编译花括号{}里面的内容需要使用C语言的文件格式进行编译,而extern “C”就是向编译器指明这个功能的语句。5 g6 C% Q- ]6 Z7 r% D9 f0 ?
q% ^. U- H& l# u8 M& w
- h& q% M( z) q% Y3 G5.3.6 volatile用法
) P: b$ T% N, ~2 `; u6 ?volatile原意是“易变的”,在嵌入式环境中用volatile关键字声明的变量,在每次对其值进行引用的时候都会从原始地址取值。由于该值“易变”的特性所以,针对其的任何赋值或者获取值操作都会被执行(而不会被优化)。由于这个特性,所以该关键字在嵌入式编译环境中经常用来消除编译器的优化,可以分为以下三种情景:# i& ^* l! O: h! K- d- r0 S
7 l- A8 ]; |# v9 x! L6 V1) 修饰硬件寄存器;
" f# @- H0 u0 K, C, ~* p8 T" r
/ x4 ]2 b h7 v$ P7 |3 T5 m0 r, u2) 修饰中断服务函数中的非自动变量;
7 u n+ o B! r3 s" A
j, t' H9 E5 c3) 在有操作系统的工程中修饰会被多个应用修改的变量;/ ]* t$ e+ P- l0 \
) |: A; t4 _; f# Q& O {! @: b6 u8 d H" `1 j
修饰硬件寄存器! G% F3 |% C: X* v" s
; D4 ]1 L* M) [( c" }+ S
以STM32F103的HAL库函数中GPIO的定义举例,如下为HAL库中GPIO寄存器定义:; C. _$ m8 g; t% i
4 ?7 ^( y* g, {& x+ ] c' v% c1 d
- /**; R+ w' I6 y z8 ], D8 H# q6 J, t
7 G/ }. V) x0 P# `' p0 \- * @brief General Purpose I/O- `4 L$ {# } n( |. f
( r( ?8 F+ p6 v# b2 Z6 T7 f- J) t; M- */$ h$ c" G" o$ }) A; k- u
6 l; K- g! u3 p$ m
. A+ o! \7 I' n- g- & `; F( F+ F8 N; I9 [6 ?2 {
- typedef struct
9 |3 Q* m$ X" n - : s9 q. t: J# u: ?
- {
+ A0 w8 |, @% a
& A6 Z* |/ a: r a9 P, U. u: [1 a- __IO uint32_t CRL;
$ i8 q1 A! \! D" s4 o+ _ - . e) M/ W- V2 c# c) y6 ^7 y
- __IO uint32_t CRH;
, A9 A2 h6 H7 v+ t" L - 9 u+ e9 M, W7 h ~) O2 D
- __IO uint32_t IDR;
; S: q. T! {. v; \; c - 3 h) V2 S' M5 Y" e$ ?1 A" e
- __IO uint32_t ODR;8 O3 F/ }9 B3 B# `( m+ g5 I; K2 P- R
. @ p$ K/ p* a& y0 f3 K: L6 x- __IO uint32_t BSRR;! q1 P& B9 _- \$ v( P
- / y* v z: B" r7 f# T- V
- __IO uint32_t BRR;
) b% G9 ^* h1 K+ l3 c
' X* J/ K. z! E0 Q) _& s; o6 M- __IO uint32_t LCKR;' [, h: ?$ M/ |1 O( ]5 n
+ \! q: ~; _0 X" t7 k( s( f- } GPIO_TypeDef;
其中__IO的定义是:; e/ V# t" j" A c9 [* A( @* L
3 r6 w" K5 Y( ]8 t
- #define __IO volatile /*!< Defines 'read / write' permissions */
然后定义GPIO是:& V2 J& B$ j# X% m2 p' B) Z
' d% S# k" b% b% {- #define GPIOA ((GPIO_TypeDef *)GPIOA_BASE)
+ S! ~3 H0 u( s0 u' J, {0 }
+ P) {1 B3 V I K$ P- #define GPIOB ((GPIO_TypeDef *)GPIOB_BASE)
1 y3 Y5 b4 O' O. F; F) Z% d, | - ; N! i2 N. O' v# l4 v
- #define GPIOC ((GPIO_TypeDef *)GPIOC_BASE)3 p$ k h; ^+ J3 I# X( d
0 e4 M, G; I$ G- #define GPIOD ((GPIO_TypeDef *)GPIOD_BASE)
/ m" \( X6 `' H2 M3 y7 z1 v - * \4 m4 |! \* _8 R2 W
- #define GPIOE ((GPIO_TypeDef *)GPIOE_BASE)4 Q" W% u t5 R. u0 Y: ^, p7 w: Y5 k- p
* m B9 _4 L8 ^- #define GPIOF ((GPIO_TypeDef *)GPIOF_BASE)
4 \2 D0 I+ n% \! @8 `1 v* r. e' U - 1 _/ ?4 B" D' y- c
- #define GPIOG ((GPIO_TypeDef *)GPIOG_BASE)
' {/ `, O5 j: T9 B5 q而GPIOx_BASE的定义是这样的:- V- e; c# D# K
2 M( x8 ?! ~; S" w
- #define GPIOA_BASE (APB2PERIPH_BASE + 0x00000800UL)
* [( l& D4 ^1 T
8 l- i6 U j+ N! D$ p- #define GPIOB_BASE (APB2PERIPH_BASE + 0x00000C00UL)2 \. ?! U) Y% C
) h; ^; a% I% {. r5 O- #define GPIOC_BASE (APB2PERIPH_BASE + 0x00001000UL)
; t# Y7 w5 e( W3 D2 _/ Z& a - " ?- H$ C$ T2 G: Z. e, L
- #define GPIOD_BASE (APB2PERIPH_BASE + 0x00001400UL)
- t4 H W U2 F- B+ N - 9 t; e3 m& ^% W
- #define GPIOE_BASE (APB2PERIPH_BASE + 0x00001800UL)! y0 s6 z& P% z0 B. ]4 s: ~
- * r" E3 N7 G% X$ U, h/ m
- #define GPIOF_BASE (APB2PERIPH_BASE + 0x00001C00UL)2 P4 b. Q" b4 K( n. G! s: j( Q1 L
& C: ^. M3 d3 K5 ~# F- v% V) A- #define GPIOG_BASE (APB2PERIPH_BASE + 0x00002000UL)
其中APB2外设基地址的定义:
3 G* [. F8 n7 b5 M- c4 S" R, v1 u% E2 p% l }& T0 h
- #define APB2PERIPH_BASE (PERIPH_BASE + 0x00010000UL)
z, m% B' f4 V最后再来看外设基地址的定义:- #define PERIPH_BASE 0x40000000UL /*!< Peripheral base address in the alias region */
0 r2 {' j( K0 O6 ^& Z综合起来,将宏定义一一展开,仅用GPIOA来看,其它的以此类推:
% O* O) m, O0 V" `$ d' i9 ~, N% Q( G* B) d; k0 |" [+ }; t" B( O# a
- #define GPIOA ((GPIO_TypeDef *)(0x40000000UL + 0x00010000UL + 0x00000800UL))
9 @+ N, t+ f0 K4 z如此定义之后,那么GPIOA的CRL的地址就是:- (volatile uint32_t *)(0x40000000UL + 0x00010000UL + 0x00000800UL)
9 V& U! {. F4 y+ rCRH的地址就是:
7 d5 Q, w$ L* Q& v% d5 F- n2 l; t5 r& Q+ r* t% Q1 K& t: Y
- (volatile uint32_t *)(0x40000000UL + 0x00010000UL + 0x00000800UL + 2)
]% ]9 M5 o! ^, _9 j0 O后面的寄存器以此类推,因而在程序中使用:
5 @5 @+ b+ T' i4 `! p& G3 G那么实现的功能就是对GPIOA的CRH的寄存器的最低位拉高。如果在定义GPIO的寄存器结构体里面没有使用__IO uint16_t,而是仅使用uint16_t,那么在程序中再用语句:
! N. X& j( X1 ]. o' h就有可能会被编译器优化,不执行这一语句,从而导致拉高CRH的最低位这个功能无法实现;但是库函数中使用了volatile来修饰,那么编译器就不会对此语句优化,在每次执行这一语句的时候都会从CRH对应的内存地址里面去取值或者存值,保证了每次执行都是有效的。8 C- y2 t- q) H3 b; ]! }
/ b, G# L" I8 W# U! D+ |在有操作系统的工程中修饰会被多个任务修改的变量; T! ?+ R. O8 X8 ]: s2 q) L+ j
0 G/ j4 v5 ~, p$ A- p9 E, J D& N
在嵌入式开发中,不仅仅有单片机裸机开发,也有带有操作系统的开发,通常两者使用C语言开发的较多。在有操作系统(比如RTOS、UCOS-II、Linux等)的设计中,如果有多个任务在对同一个变量进行赋值或取值,那么这一类变量也应使用volatile来修饰保证其可见性。所谓可见即:当前任务修改了这一变量的值,同一时刻,其它任务此变量的值也发生了变化。2 J( {; V; g1 e' [7 @6 p% [) E
; q6 `4 e6 l8 x8 B" s0 V6 ^; V
/ E) Y; r2 T& m
$ g4 d: i' P* K3 U, G5.3.7 struct用法
0 u- T2 [& z! n( n3 N# Y设计程序最重要的一个步骤就是选择一个表示数据的好方法。在多数情况下,使用简单的变量甚至数组都是不够的。C使用结构变量进一步增强了表示数据的能力。C的结构的基本形式就足以灵活的表示多种数据,并且能够创建新的形式。- p. p% j0 F+ o
# y1 G' c2 D+ W7 R8 \" T2 r$ _2 e& ^
C的结构的声明格式如下:" r. U: A. o* X* u- i3 N ?+ ?8 N2 S
2 A4 T. |6 l/ _3 a: y7 O9 A5 ~( v; n
- struct [结构体名]
) f$ b( h1 K; b8 [9 d
6 H6 d3 Y V J9 S$ b; |- {
, j5 L$ N9 Z0 s9 c
+ \6 `8 w3 O) k4 l7 o- 类型标识符 成员名1;7 c: I, u( \' k3 `. u. o
- 7 h. c8 E) J" N+ W
- 类型标识符 成员名2;
# a8 T2 z* r$ J. Z - 2 ^' Y" `, P1 x! p0 F
- . O2 i- e/ m5 n d& G( u; @
( O5 n. G$ w- h$ g: t: B& H! `4 F- .5 z4 t- g8 D6 `" c* \
0 r8 \+ ^" K ]; V( l$ t H- .
) w! K% c8 R% H6 @
2 g2 ]1 ^" J8 z8 j- 类型标识符 成员名n;
# y& M! h7 V* B5 t4 ^4 z+ j- g; a - 7 S6 b( C; ~8 e `* G. C7 v1 g
- };
此声明描述了一个由n个数据类型的成员组成的结构,它并未创建实际的数据对象,只描述了该对象由什么组成。分析一下结构体声明的细节,首先是struct关键字,它表明跟在其后的是一个结构,后面是一个可选的标记,后面的程序中可以使用该标记引用该结构,因而我们可以在后面的程序中可以这样声明:
. N( q6 \* J! e. A' }( ?! l
- W# G, h, f" L1 }* e4 D# U4 O# C, b/ {
在结构体声明中用一对花括号括起来的是结构体成员列表。每个成员都用自己的声明来描述。成员可以是任意一种C的数据类型,甚至可以是其它结构。右花括号后面的分号是声明所必需的,表示该结构布局定义结束,例如:$ E4 a( }1 D- l$ T
9 D6 w! P6 w* W! u- struct students
: E; V0 o5 L3 ~6 j# I% E- M2 D
; {/ a. h) {. X- S- {0 t, |5 Z% G# t- g
- 8 @ m! v9 c+ a" }
- char name[50];, \- Y! Z8 q! i% H3 J
1 J. a' L0 y5 r3 ?: }- char sex[50];$ b2 y8 ^+ s! b6 z! R. O: p: V* m
9 S0 r) ^* `) q" i! f2 J( r' b- int age;. I9 v; v& u7 D4 t) b0 Y0 s
3 c' A. J5 R. I7 m* y- float score;
/ v% X1 T5 m! { - 9 |$ R, j( |) u2 t- F3 t. l
- };4 w: Q' ^; G; a( R8 B% X
- ! V! ~) n- a! H; V6 x( U3 I, ~
* j9 Q3 o! L" L# X% f# ], h! K; K- 0 p$ H, ~7 T# ^2 I q
- int main(void)
9 c2 o5 ]) x8 a" \1 K, |4 O5 B
- c6 v. D; i; W% V# {# M- {- y( n& T7 B4 d( Z, q
- 6 N* J7 v9 r/ Y) e7 P0 @
- struct students student;
7 G5 }! {0 h" T6 R& b, x5 r - : I8 T2 _' {$ Z2 E% c% B# B
- printf("Name: %s\t",student.name[0]);
, C7 ]4 E4 }4 j! d( R5 B5 F
- s; C' ^) b7 R% C! h5 Z7 U; g- printf("Sex: %s\t", student.sex);
4 A! g' L5 E& Y( W7 N& n: u
2 I+ S$ J* _# H+ P" i3 M- printf("Age: %d\t", student.age);. v1 E* d2 i, Q
' R! n% j5 \8 N* }# D- printf("Score: %f\r\n", student.score);
5 C, S+ s. {/ T3 ~
/ [& Q* ? N3 W4 w- Z5 a6 s
# I- m: ^! w3 G; f. p- ; U" i) l$ A- `+ T" s$ |. f$ r
- return 0;
4 s: |& @: \* Z3 A& d a( s - 3 ` S1 `& ^4 R9 {( c# n' x2 y
- }
8 P% C2 }5 `3 g+ C可以把结构的声明放在所有函数的外部,也可以放在一个函数的内部。如果把一个结构声明在一个函数的内部,那么它的标记就只限于函数内部使用;如果把结构声明在所有函数的外部,那么该声明之后的所有函数都能使用它的标记。, _1 d. v4 }7 ^, E
4 L" H, H+ ~+ {* x5 m结构有两层含义,一层含义是“结构布局”,如上述例子的struct student{…};告诉编译器如何表示数据,但是它并未让编译器为数据分配空间;另一层含义是创建一个结构体变量,如上述例子的struct students student;编译器执行这行代码便创建了一个结构体变量student,编译器使用students模板为该变量分配空间:内含50个元素的char型数组1、50个元素的char型数组2,一个int型的变量和一个float的变量,这些存储空间都与一个名称为student结合在一起,如图 5.3.3 所示。% `% _9 P+ I! W5 m" w' B
3 U8 D# E' L6 q D' o* q: X
8 M) Z- l, v1 ]# B
: {8 L9 n q, H- ^5 l2 V |1 S
图 5.3.3 结构体存储示意
$ G \' J1 h: Y! r5 b* F8 ?8 t% K3 W+ @
+ L4 b+ ~# v2 L' f7 X
在内存中这个结构中的成员也是连续存储的。在通常程序设计中,struct还会与typedef一起使用,具体的会在后面的《typedef用法》一节介绍。9 N+ D! Y4 \- V: L$ n
0 k& v L) o, v+ L
! A7 N' p# k+ I) B# a5.3.8 enum用法 j; b u4 _6 c0 ]. v
enum是C语言中用来修饰枚举类型变量的关键字。在C语言中可以使用枚举类型声明符号名称来表示整型常量,使用enum关键字可以创建一个新的“类型”并指定它可具有的值(实际上,enum常量是int类型,因此只要能使用int类型的地方就可以使用枚举类型)。枚举类型的目的是提高程序的可读性,其语法与结构的语法相同,如下:! T& I) w) S' I
% @) L: g5 Z) s% i: Z+ Q7 \
- enum [枚举类型名]
2 W; ? b' v" D( U7 L' f7 T - ; u4 X" x, ~1 y* R6 u3 s- N+ A8 P
- {9 E4 c0 T& ?8 I: t2 r! T& y
& x9 p) f5 X4 V! f' F8 f' d6 E- 枚举符1,: H$ o. E2 G+ N8 M
- 3 \- G* K8 x& J1 j
- 枚举符2
2 c6 q+ R% r6 U6 G I( p/ F9 V7 {
* t7 J* V3 \2 k, t/ {2 H- .
. n, T( K+ J3 k [2 @ - / {) |7 e0 [$ c1 X" m4 Y* W; S, O
- .3 l5 ~: ~2 I+ Y p) A0 c( e4 r8 n
- $ |/ B) W9 T7 m2 t( z7 I1 f
- .
" m: J2 {/ X: J8 `2 G/ r - * L6 g2 D: g( g4 Y3 ?' N0 r
- 枚举符n,. ]% N4 z$ f( l6 x3 O
- . A0 v$ ]7 t) e5 V
- };
2 N6 }- y, j- A% @" g# O0 l4 @5 n例如:' y7 Q1 y9 W* t+ ]+ s# _# a
) Q; `2 ^( y' }2 h% x2 U' o- enum color
# @2 w1 k3 J% D5 R. Y0 X1 s$ n( t
2 ?% |/ W4 B7 N9 X. J5 Z" a- {
! F2 I6 ]) J: a4 m$ b - , o, }& d9 d* l* ?/ `! O j
- red,4 B0 g: W! c4 Y# a2 g6 @1 G! K
- : G* e2 z! l+ Y, y5 D( U( t/ G
- green,
: h+ [) @5 ~4 A. D% ? l3 o" b8 W - ! Q: @( [# t; r, m9 G1 T
- blue,6 o4 X( t7 f% s/ g! C1 v. \2 |
( |4 D6 ~- T" v3 [! z. M- yellow, U: U5 g3 f2 l) o6 L
5 ^+ g+ Z, n9 t- };/ O- G* V: Q1 c5 h
7 p/ V: N! J0 M: l
enum常量& D! H% L9 O& d) m" ^9 P( _8 S
& D3 U; [6 ^( y6 B8 S
在上面的例子中,red, greeb, blue, yellow到底是什么?从技术层面来讲,它们是int类型的整型常量,例如可以这样使用:/ ~9 @$ Q) A3 i5 m4 v
8 `6 f- c) D5 t1 ]- printf("red=%d, green=%d", red, green);
& e$ Z8 y+ N7 v& k" b可以观察到最后打印的信息是:red=0,green=1。
$ J/ ]- j5 E% L- U) w+ ?! H; a9 c- Q: r, V8 F& B1 ]' x
red成为一个有名称的常量,代表整数0。类似的,其它的枚举符都是有名称的常量,分别代表1~3。只要是能使用整型常量的地方就可以使用枚举常量,例如,在声明数组的时候可以使用枚举常量表示数组的大小,在switch语句中可以把枚举常量作为标签。' ]9 }# p! k! o/ |* D* ? ^
% E4 |8 e! K0 v8 q. @8 O! q
$ n; p2 H2 c1 q
1 Y9 ^6 Q5 I" b' y, t, h
enum默认值7 x7 V, e- v$ e6 a0 A: E, R
. y: N# f* M. F0 m2 ^; Y% h" f
默认情况下,枚举列表中的常量都被赋予0,1,2等,因此下面的声明中,apple的值是2:
) x/ c* G/ _& X4 L* N9 N7 y# g' v
- enum fruit{banana, grape, apple};
* R; S% Z0 Q$ p/ l3 z2 n% |enum赋值; y* E T8 O. R5 b+ A/ \9 q
2 p. H& |* H* L$ C在枚举类型中,可以为枚举常量指定整数值:
' d$ p# ~+ U2 G1 j9 j) W2 p( B: f2 O+ v8 A/ m; r% H' [
- enum levels{low=90, medium=80, high=100};
如果只给一个枚举常量赋值,没有对后面的枚举常量赋值,那么后面的常量会被赋予后续的值,例如:3 D; E* c$ {% ~- @
6 N: X. g' q/ q9 C& D- enum feline{cat, lynx=10, puma, tiger};
那么cat=0,lynx、puma、tiger的值分别是10、11、12。; q- m' b% K& a( F* R7 U9 J( I
9 _: K1 K% _4 D3 B" o O- ~& v
/ B7 v( J: w, s7 w: O" d9 {, l
& d4 u+ G; U1 D( ]/ R# y5.3.9 typedef用法
# c0 |- q- v. [7 d& s7 j1 vtypedef工具是一个高级数据特性,利用typedef可以为某一类型自定义名称。这方面与#define类似,但是两者有三处不同:1 p# O8 X5 g2 |: x7 m& ^) X
$ N& x7 f0 M& J/ {$ m8 O. u1) 与#define不同,typedef创建的符号只受限于类型,不能用于值;
9 S* h8 h( g: I, H) q% G
" H# [7 m# @7 A" z- }# B- C2) tyedef由编译器解释,不是预处理器;
2 B8 t, b% g: X5 r" a1 b
. b7 l5 L: s! B- @3) 在其受限范围内,typedef比#define更灵活;3 F% C, c' t( v: A+ D! h$ t
1 T0 w6 w& @; i' q+ N. e' S# j4 D
假设要用BYTE表示1字节的数组,只需要像定义个char类型变量一样定义BYTE,然后再定义前面加上关键字typedef即可:3 r+ j& R2 [! \$ m5 Z. F! R) v
# ?5 u. F8 g# r$ @1 {7 Y
- typedef unsigned char BYTE;
随后便可使用BYTE来定义变量:/ A |, @4 h e
该定义的作用域取决于typedef定义所在的位置。如果定义在函数中,就具有局部作用域,受限于定义所在的函数。如果定义在函数外面,就具有文件作用域。
+ [% P6 D" z8 W8 w+ l, H# a+ y! o+ ?: \- Y
为现有类型创建一个名称,看起来是多此一举,但是它有时的确很有用。在前面的示例中,用BYTE代替unsigned char表明你打算用BYTE类型的变量表示数字而不是字符。使用typedef还能提高程序的可移植性。
5 ?! r/ F+ J( l8 u
( v8 n/ m. j+ Z- |6 `4 G! @4 n用typedef来命名一个结构体类型的时候,可以省略该结构的标签(struct):$ N1 k) l3 K0 X- q8 i
& D; e9 X. }# H8 ^$ e' V7 u$ @ x
- typedef struct
4 \# L, K5 @2 z - & c2 j- g( Y( r, m
- {
1 z* U; S) T# f8 F0 G - 4 x5 N3 _) _! n: O7 Z
- char name[50];/ p) b, B- Q [7 v% j, O- r
- ( J" W5 N/ r# N) ]
- unsigned int age;$ n d7 K) r- B3 U: ^3 M/ S
- q7 d# n A5 @) Z( V- float score;% _5 Y6 s, `7 K- u
- * \- e7 V6 D3 |; h3 C; p* K
- }student_info;: f/ h& P6 j \- d
- 0 }8 p; `2 c2 V' ~3 K4 I
- 7 u; t# d: n8 a) k# I. O) {
- : _4 \4 T, ]1 h0 k" ]% c
- student_info student={“Bob”, 15, 90.5};
8 B, D8 j2 @1 {这样使用typedef定义的类型名会被翻译成:1 m4 k7 @7 m; @4 C$ t5 V8 ^
/ @& ~$ D0 n/ `: z+ S4 _
- struct {char name[50]; unsigned int age; float score;}; V; f3 a4 |; c
- ; [8 V) n+ R, M
- student = {“Bob”, 15, 90.5};
$ Z2 _2 G! N4 Q7 F6 ]5 |使用typedef的第二个原因是:tyedef常用于给复杂的类型命名,例如:
8 y4 A( u% U& X- A6 a5 ~
0 I4 D @# z. J6 }" ~. r- typedef void (*pFunction)(void);
把pFunction声明为一个函数,该函数返回一个指针,该指针指向一个void型。
( b( L; K4 ~" a9 x0 o0 }7 o/ L/ C" e! W6 h+ B
使用typdef时要记住,typedef并没有创建任何新类型,它只是为某个已有的类型增加了一个方便使用的标签。6 U. L# g/ l6 }5 k
5 b. d7 ^9 h6 E( Z( |+ t3 I; D; t+ S4 }6 }
5.3.10 预处理器与预处理指令$ c7 J) Q4 m, T
本节将简单介绍C语言的预处理器及其预处理指令。首先是预处理指令,它们是:- #define、#include、#ifdef、#else、#endif、#ifndef、#if、#elif、#line、#error、#pragma
在这些指令中,#line、#error、#pragma在基础开发中比较少见,其它的都是在编程过程中经常遇到和经常使用的,所以我们在后面的章节将主要介绍这些常用的指令。
( [/ D* e" K% r, |3 a/ b, l9 d3 L2 Z
C语言建立在适当的的关键字、表达式、语句以及使用他们的规则上。然而C标准不仅描述C语言,还描述如何执行C预处理器。2 b9 d3 A* @& M
( j. j3 G- _; l+ z
C预处理器在执行程序之前查看程序,因而被称之为预处理器。根据程序中的预处理指令,预处理器把符号缩写替换成其表示的内容(#define)。预处理器可以包含程序所需的其它文件(#include),可以选择让编译器查看哪些代码(条件编译)。预处理器并不知道C,基本上它的工作是把一些文本转换成另外一些文本。) F6 s4 M% i7 a( _1 w
# U* \6 o# B! T6 @' U由于预处理表达式的长度必须是一个逻辑行(可以把逻辑行使用换行符‘\’变成多个物理行),因而为了让预处理器得到正确的逻辑行,在预处理之前还会有个编译的过程,编译器定位每个反斜杠后面跟着换行符的示例,并删除它们,比如:
& {9 P- \' _& R2 P* M$ |0 l
/ J! n. H, X: O2 ]/ s3 a# g- printf(“Hello, Chi\/ y9 p0 ^- z9 y; T% R& A8 T! V, ]
2 w" m3 ?$ V$ R* R/ N1 j) c4 C- na”);
转换成一个逻辑行:
& @; E5 s K ]4 z, z/ m+ X& D( i |( f2 {3 u
5 [' n+ F6 D8 k" E另外,编译器把文本划分成预处理记号序列、空白序列和注释序列(记号是由空格、制表符或换行符分割的项),需要注意的是,编译器将用一个空格字符替换每一条注释,例如:( w" j" Y2 M/ V; z! r. a$ B7 S
7 s. f J8 h+ M% C& G6 F1 z7 S3 H8 U
* q% `; x& x6 L' R' c
将变成:
3 H6 y; F5 ~ E; W' }这样编译处理后,程序就准备好进入预处理阶段,预处理器查找一行中以#号开始的预处理指令。然后我们就从#define指令开始讲解这些预处理指令。5 Z/ [0 t& L8 r
! K' S: {2 d1 n2 m# P8 y
% M1 t7 h/ v' k( W7 n7 M4 `3 I6 U( U) h+ k8 b/ n! e# m
5.3.11 #define与#undef用法6 a# l' i$ O$ L
#define预处理器指令以#号作为一行的开始,到后面的第一个换行符为止。也就是说,指令的长度仅限于一行。然而在预处理开始前,编译器会把多行物理行处理为一行逻辑行,例如:0 Y4 B. f' q/ c# l
0 m: ~; r n6 J6 v# U
- #define STRING “I am Chinese, \
7 _3 @$ M: D0 w% N i - " n5 G& _( e8 D/ ?4 S+ `( k
- I love China.” /* 反斜杠把该定义延续到下一行 */
9 v! d* d, t5 w( \/ f每行#define(逻辑行)都由3部分组成。第1部分是#define指令本身;第2部分是选定是缩写,也称为宏,有些宏代表值,例如:% e7 E" ^0 d6 Z8 Q4 z! o, Y
5 `$ ~" Y1 |" g S3 N6 I; k( {- #define PX printf(“x=%d”, x)
这些宏被称为类对象宏。C语言还有类函数宏,在后面介绍。宏的名称中不允许有空格,而且必须严格遵循C变量的命名规则:只能使用字符、数字和下划线字符,且首字符不能是数字。第3部分称为替换列表或替换体。一旦预处理器在程序中找到宏的示例后,就会用替换体代替该宏。从宏变成最终替换文本的过程称为宏展开。例如上例我们如果使用:0 D- v8 L6 X% Q! V7 K- O
( j- {% e6 o/ d' f+ g9 X- int x=2;% x8 R; f! \7 Y3 M
- , z6 C1 A$ B- `- x) G
- PX;
就会被预处理器展开成:. _8 C' s$ {+ f2 h2 w) T
+ O" w: L; o; E. @" m
- int x=2;: U- K& L; J3 H5 i
# O5 {& V6 W5 r0 I9 i! l- printf(“x=%d”, x);
最后输出的结果是x=2。
% ?7 b$ `) h! O
/ b9 x7 O5 c; V1 j可以看到宏可以表示任意字符串常量,甚至可以表示整个C表达式,例如下面整个取绝对值的宏定义:- #define ABS(x) ((x>0)?(x):(-x))
2 `3 W D" r, f& L1 y4 |宏展开有个值得注意的点是:预处理器会严格按照替换体直接替换,不做计算不做优先级处理,例如下面求取平方值的宏定义:
" {8 ?' y4 I8 l B4 r' q& B
9 Y7 f/ G* f5 J4 ~7 ]
9 P1 A9 t2 ?2 r% t( n我们假设这样使用:. \6 }/ C9 X/ D' R
, e" A! g5 d1 O
- printf(“2的平反:%d”, sqr(2));
* b. P2 O; P1 A6 _8 Z3 K# P0 [输出的结果为4。
c/ Y8 m8 I: E( G! C) l* J, w( {. E/ m7 o
但是如果我们这样使用:
7 p: e5 o% S- p3 [4 _2 x" R+ }" ]4 ?7 F+ w
- printf(“2+2的平方:%d”, sqr(2+2));
那么与编译器就会这样展开:- B% l- E: g# n7 t8 p6 _
5 }/ b" w1 D6 g% n8 w7 @/ @
- printf(“2+2的平方:%d”, 2+2 * 2+2);
! X# E/ N9 g$ I( r输出的结果为8。2 k( x9 z; V; ~9 b! b2 ~
9 D+ c! j5 I. |! e3 g# a m& Q但是实际按照逻辑2+2的平方是16,得到8的结果是因为前面所说的预处理器不会做计算只会严格按照替换体的文本进行直接替换,因而为了避免类似的问题出现,我们应该这样改写平凡宏定义: s- }" G0 {" f. w1 v3 c* z* n9 ^
) \8 p5 |2 I- `' i: a. Y$ e
8 ]" Q+ ~+ r7 N* r) x这样上述的2+2的平方的例子就会被展开成这样:
9 {4 r$ [7 C) l& x+ |! g$ k2 Q; I2 b$ C# {, G1 @+ N0 f" z
- printf(“2+2的平反:%d”, ((2+2)*(2+2)));
2 d3 b0 c4 D* q就会得到正确的输出16。8 Y% @* X7 w: K* t) `7 E3 p8 B
$ d% h4 T6 o6 {% j) A i上述的求取绝对值的宏定义或者求取平方值的宏定义中我们可以看到其形式与函数类似,此类宏定义就是前面所说的类函数宏。类函数宏定义的圆括号可以有一个或多个参数,随后这些参数出现在替换体当中。
) `8 J8 f) \+ e+ B' l
' g6 G+ W5 }7 [- z/ E: n#undef指令用于取消已定义的#define指令。
) ^ P7 u* ~/ d% `1 T, I. E' [0 J2 q
0 I$ I7 R, R& z& K: V: Q9 {5.3.12 文件包含#include
: S0 n. t3 l: [: C7 p% s当预处理器发现#include预处理指令时,会查看后面的文件名并把文件的内容包含到当前文件中,即替换文件中的#include指令。这相当于把被包含文件的全部内容输入到源文件#include指令所在的位置。
- b9 j9 ]2 ?) I! V/ G2 v8 `( }. i% v4 e
- #include指令有两种形式:; j! z# H5 p" a: C4 w' i& d1 Z
6 Z* d8 ?: x2 H/ r5 Z- #include <stdio.h> // 文件名在尖括号内+ T) z5 @- P% p/ h, d
! G/ `" w% B6 ^& @- #include “myfile.h” // 文件名在双引号内
在UNIX中,尖括号<>告诉预处理器在标准系统目录中寻找该文件,双引号“”告诉预处理器首先在当前目录(或指定路径的目录)中寻找该文件,如果未找到再查找标准系统目录:: n0 P3 h4 M$ a" |$ J% H
' [8 T" W% t/ W. l' r
- #include <stdio.h> // 在标准系统目录中查找stdio.h文件
( O- p; ~1 @5 b! `8 @! X6 e4 b7 @
3 J6 t) g7 s% w8 D/ s8 \' E- #include “myfile.h” // 在当前目录中查找myfile.h文件
5 ~ a4 i# g( i- q: y, L, V
0 h' K2 C1 s1 K" k- #include “/project/header.h” // 在project目录查找
) L# ?1 d5 W6 y - ) O& V# Y2 {, P3 ]/ q! b
- #include “../myheader.h” // 在当前文件的上一级目录查找
; D2 u- x/ \6 ^1 W' Z集成开发环境(IDE,比如开发板的开发环境keil)也有标准就或系统头文件的路径。许多集成环境提供菜单选项,指定用尖括号时的查找路径。( d) ]% O) I# v( l
# M; R. d; }$ s o) K7 R7 Q7 v
为什么我们要包含文件?因为编译器需要这些文件中的信息,例如stdio.h中通常包含EOF、NULL、getchar()和putchar()的定义。此外,该文件还包含C的其它的I/O函数。而对于我们自定义的文件,对于嵌入式开发来说,可能这些文件就有需要使用到的某些引脚宏定义、简单的功能函数宏定义等,以及某个源文件的全局变量和函数的声明等。2 e2 M* T0 _, v
- F' `' F, f9 x9 C, C; C9 kC语言习惯用.h后缀表示头文件,这些文件包含需要放在程序顶部的信息。头文件经常包含一些预处理指令,有些头文件由系统提供,也可以自定义。: h" J6 K6 e4 ^3 ^+ `
- I7 a% s* ^& S/ l+ }: U
下面是一个子自定义一个头文件的示例:gpio.h, main.c
; l8 U0 m- R1 N. N! ^3 e, o( F# q/ i. g0 d
- /*gpio.h*/! ]" d0 B U( \ z$ O" G* l
- 4 G. P# A" {3 f7 H
- #ifndef __GPIO_H
& T0 }, H4 a' e3 A) F% u/ H2 z% V
. O& G) r6 R2 s0 D# t! V! N- #define __GPIO_H9 |2 T, K5 v, j4 F' f+ ~
- ( Z( n( o5 f* w3 _
- #include <stdio.h>
. p& _' A3 ]( e6 |) W - , Y/ O* k5 _0 x5 k/ C
9 x: H! f! e: l% o D6 S& A, y& D- 3 q% s y. X8 c
- typedef struct
* m: \' A8 \5 Q' { - % ]" m6 [% ]2 P& H* b: V1 }$ N+ y2 Q# f
- {
3 E N* E( s4 ^9 O: }( { - - R. B7 @0 n0 L" a! ^; L2 T
- uint8_t cnt;
. Y( w3 I& @4 G! R1 B2 @* Y
, C+ T" b$ Y- z) _ H- uint16_t sum;
( ~% H- E: z" G! B& h& ]0 T
2 Y7 O1 t2 @9 i, D$ x' D2 b2 B4 `, Q- float result;% A/ x. l' t: a+ e7 [+ \
1 a4 S! }4 w2 k/ g# Q+ [- }MyStruct;
( j9 f0 t+ C5 x4 B) r7 T1 d M9 t - ! C' C5 P: P: t+ q6 H9 o: f
$ H2 b6 z" v. y) @- % w! O1 L2 G' n- ]7 f% f
- typedef enum
2 T: }3 K2 V4 [# m2 H
8 f$ W& R5 w2 U- {7 |; S9 L" G( F
- ; O/ s/ W" \1 z" r& R8 `$ y9 ~( c; E$ I
- GPIO_RESET = 0,' i+ F+ }, I p% `" m
- ; |" r u# k+ _# ]
- GPIO_SET = 1,$ Y& e# G* g1 m4 R5 r
- $ B+ Q8 _, ^/ ~9 Q0 s% g: H* _
- }GPIO_STATE;
7 M& m8 P0 V* j
! j0 C9 n8 M3 G0 G3 L
3 q# C# y3 X# a8 K. `% S- ( l) Y6 d6 I1 E( Q& s
- #define ABS(x) ((x>0) ? (x) : (-x))
$ ^$ ~% c7 F* q/ c' f1 a
0 F0 E* v/ ?9 p! k- #endif
- /* main.c */2 J# o g9 }/ v! z
- : f2 n+ F% w5 K2 }: M* ]4 P, {
- #include “gpio.h”
' Y H( U+ K) ]6 N - 7 [: c# v8 H2 w4 }5 ~2 ?
- int main(void)& w5 W# m9 n" L8 B& E; v
- * ^$ O z; w9 w. n
- {
3 I7 v' V" q X# l% [, o
$ ?3 z1 G. s& d1 \- V" c- n0 e) N- MyStruct my_struct = {0, 25, 3.14};
6 k, W4 t, [3 t# H% y
; B6 {* E( D6 Z% R# b5 [- GPIO_WritePin(GPIOA, GPIO_PIN_0, GPIO_SET);& E# u+ h$ @ P7 E, M
- " o0 x5 d% U! r
- printf(“cnt=%d, sum=%d, result=%f\n\r”, my_struct.cnt, my_struct.sum, my_struct.result);1 y' n% I0 v0 e( h, M
- - P; c# J6 l. S
- }
#include指令也不是只包含.h文件,它同样也可以包含.c文件。5 F+ b. T- o8 e5 @- N
( J& U7 b: J2 [8 s; D! k
, f, c) \$ S/ y4 b9 d
5.3.13 条件编译
# C; {3 f: x( }% I, Y- i" r* l& ^可以使用预处理指令创建条件编译,即可以使用这些指令告诉编译器根据编译时的条件执行或忽略代码块。/ f) u- S5 b- V6 J9 ~/ u4 ?' Q
+ k. v; R+ ~* h3 a5 {+ W
1) #ifdef、#else和#endif指令# o4 C* X: J3 ?" n% S) Z5 B2 R6 S
6 P" p8 U t% i$ _( z m: }: W我们用一个示例来看这几个指令: Q6 ~# w* r( x) W
. z: Q1 s0 C6 B: i2 N- #ifdef HI /* 如果用#define定义了符号HI,则执行下面的语句 */# a% }. F: X" H t
' Q' X3 l) q& w# ~2 a- #include <stdio.h>; z* v: P' V( M
- ( P1 j8 o% [9 Z, V/ x& Y; D
- #define STR "Hello world"
/ E. B0 e# z# D' i& H
% A/ d; [: E4 r$ ~5 O3 X! n. \9 ~" W0 d- #else /* 如果没有用#define定义符号HI,则执行下面的语句 */- D- ]) [# P% T
- ; p2 d# i( a z* `: k
- #include "mychar.h"
$ G7 u) K, j8 {# m9 r4 ^ - . Y5 f3 y) K& |& u' ^" t
- #define STR "Hello China"9 ?& S! M- K u% T' {& K0 p
2 Z7 X; W/ N+ `( X- #endif
#ifdef指令说明,如果预处理器已定义了后面的标识符,则执行#else或#endif指令之前的所有指令并编译所有C代码,如果未定义且有#elif指令,则执行#else和#endif指令之间的代码。7 a' e2 z1 t* X) d
9 c; J( j6 Y) A4 z5 U7 x#ifdef、#else和C和if else很像,两者的主要区别在于预处理器不识别用于标记块的花括号{},因此它使用#else(如果需要的话)和#endif(必须存在)来标记指令块。( \+ B- f3 P5 V5 {
% r& T: V" {; j( }" ?
& L/ H* @) j5 f. `2) #ifndef指令
7 x; o# O) x6 v& k$ p
8 `# f; n+ m6 P#ifndef指令与#ifdef指令的用法类似,也可以和#else、#endif一起使用,但是它的逻辑和#ifdef指令相反。
8 U) s/ T) i* X$ J: E& P
) ]6 ]. @8 n* v% w( {) h& V
7 W: M5 Y* O( r: w+ U8 t' x3) #if和#elif
) Y2 p$ N6 H9 [3 g. l9 z3 X& ^; J) H% U
#if指令很像C语言中的if。#if后面紧跟整型常量表达式,如果表达式为非零,则表达式为真,可以在指令中使用C的关系运算符和逻辑运算符:* q( |5 v; n4 A0 T7 r( h
' [* ]( o+ b9 ]
- #if MAX==19 \" H& |* l5 Y/ r! J( }5 T+ N! s
- # l, ~1 E- Z4 B! g2 }' k {
- printf("1");5 A, |1 E: v9 R, u" _
- 7 g0 K: B" R1 n: \7 @- D7 u
- #endif
. ~8 t' }- N" h7 K5 B; v
. R9 T1 B9 [$ O$ [- 可以按照 if else的形式使用#if #elif:
6 U+ O. h$ e0 y9 x# r, e& ^$ ?" W - ! n/ ], l4 a) \. ?6 u9 g' w7 A
- #if MAX==1: L! a' m5 s E ~* x9 q
- 2 L a9 |( h1 |+ A
- printf("1");5 p1 [8 Z6 ~- r6 Z
# F/ q( Y p( [: _5 [- #elif MAX==2' d7 k+ L# G8 ]/ O) t; ?
- ) I! B1 N# S& ]1 E" n8 ?
- printf("2");
, W& _4 R {- h& {3 S0 U
+ `) n& q2 G) E" a7 g% j- #endif, v: l9 I3 p* ]
H; u* i, R/ t- Y" h8 J6 r% X条件编译还有一个用途是让程序更容易移植。改变文件开头部分的几个关键的定义即可根据不同的系统设置不同的值和包含不同的文件。7 Z" D# H3 R( M9 u; x, s# ^
Q/ M9 O4 X1 L. P3 @( b Z: Q
5.3.14 指针用法
, { f7 l& {9 d6 B什么是指针?从根本上看,指针是一个值为内存地址的变量。正如char类型变量的值是字符,int类型变量的值是整数,指针变量的值是地址。6 o# x, O' d2 @" k+ j- o
/ e8 w" s! ]3 k, B# M- V
因为计算机或者嵌入式设备的硬件指令非常依赖地址,指针在某种程度上把程序员想要表达的指令以更接近机器的方式表达,因此,使用指针的程序更有效率。尤其是指针能够有效地处理数组,而数组表示法其实是在变相的使用指针,比如:数组名是数组首元素的地址。
. r4 @) ]! M; ~% S) Q" v% s, b3 N+ j$ {7 j
要创建指针变量,首先要声明指针变量的类型。假如想把ptr声明为储存int类型变量地址的指针,就要使用间接运算符*来声明。
& Y6 w. w$ n4 \3 }! \! z) U4 C9 a1 Z
N% d7 y6 z5 P, h8 m/ G假设已知ptr指向bah,如下表示:
2 d V0 S! j0 }. [* G& y3 O$ w# `3 c. s4 ]- M, C- N
$ R4 O. \) K+ F# G0 K# ^+ |5 m7 V然后使用间接运算符*找出储存在bah中的值:value = *ptr;此运算符有时也被称为解引用运算符。语句ptr=&bah;value=*ptr;放在一起的效果等效于:value=bah;: k0 o/ ]. y ^/ ]& n2 C
; }/ C9 S7 \; m) `; l2 Q那么该如何声明一个指针变量呢?是这样吗:
) H) z5 E, J# X: E) f _3 i, O/ K3 R+ t0 n) A
- pointer ptr; // 不能这样声明一个指针变量
5 M4 |) D8 X4 R# u2 M% [2 {* G为什么不能这样声明一个指针变量呢?因为声明指针变量时必须指定指针所指向变量的类型,不同的变量类型所占据的储存空间是不同的,一些指针操作需要知道操作对象的大小。另外程序必须知道储存在指定地址的数据类型。例如:- int *pi; // pi是指向int类型变量的指针* j1 g0 D1 d* L0 Q; M
- 0 w. `( _& V# ?, s1 N, ~. I: v
- char *str; // str是指向char类型变量的指针
2 x( N( q% U0 F$ ^/ r6 M* ^
6 R% A I' I8 ^2 p! G" ]- float *pf, *pg; // pf, pg都是只想float类型变量的指针
8 f. Z$ C, X) n) S$ ?类型说明符表明了指针所指向对象的类型,解引用符号*表明声明的变量是一个指针。int *pi声明的意思是pi是一个指针,*pi是int类型,如图 5.3.4 所示。: P; N: e" b4 `$ c4 h3 D9 q
/ F2 r4 \! l2 f9 G8 s% }" u
4 X# t$ N6 ]: u9 K- b \
7 K0 S: Q- k9 O! h图 5.3.4 声明并使用指针
4 Z7 S& a1 f* ?" j4 m: |* X
8 `' T( K$ N" L6 I$ s; e) ^
$ ]5 k% V* I3 z% A- R这仅仅是指针的简单使用,实际指针的世界千变万化,丰富多彩,纵使多年C语言开发的老手,有时在面对指针的使用也会出错,后继者更应谨慎求索,后面将会对指针常见的应用和注意事项进行介绍。) m2 M: s3 E; l! t
$ N# I- K. r: q' Y. ]2 ~8 W# X
1) 指针与数组
( K; x, t3 R4 [9 N7 T) W
4 S+ Y+ @3 p3 J# f, q/ E0 ^前面提到可以使用地址运算符&获取变量所在的地址,而在数组中同样可以使用取地址运算符获取数组成员中任意成员的地址,例如:- p I" V6 J( Z( G2 _# n3 i; e; g' o
' Q/ B* F0 W {! z; {
- int week[7] = {1, 2, 3, 4, 5, 6, 7};
7 D( T; r- z& L( e& } D - - h# w" p$ `2 T: O8 ?; g
- int *pw;
% P1 G/ m- T9 P* x
5 s% a- r* q: D* K+ w- pw = &week[2];
0 _, E6 m4 f8 S3 k/ b" }) \ - 1 O* [. b: c3 O) n- K4 t. p
- printf("week is: %d", *pw);
输出的结果是:week is 3。对这段代码的释义参照上图 5.3.3。) M4 J% V4 ^& c) B
& L6 z4 D; [2 j# t7 T. f! g- A# ~+ T9 V; y1 _- k# [
2) 指针与函数
; x- R! g4 T5 I. p9 X! p. P: Y6 [9 l5 m! T
指针在函数中的使用最简单的是作为函数的形参,比如:
+ S0 X# e' r- y0 p
$ L2 y& c' \/ k" q( h; s- int sum(int *pdata)
- C" d( ~ ?6 v0 J
b9 \6 J8 G1 h5 c! L; E; ]- {' V, u# ~) E' W0 [$ V
- " l( v% x% K+ m) _
- int i = 0;7 ]( x7 @; Y$ ]! X! g. e
- , y- b1 d, k) ~, z
- int temp = 0;+ ?9 |' G1 i. V5 [+ ?* U
- 7 g4 F# }, ^+ O k
- for(i=0;i<10;i++): Z9 S8 V' m+ H: P' J0 \- Y% p
- 1 h9 G: _' L1 k7 g1 k
- {
9 H) \, K$ B6 U4 X4 U; I2 C
9 a2 q* @6 m" L- temp = temp + (*pdata);% Q5 w9 E3 z; P
_ y' i1 k1 @- pdata++;
3 U% Q, l/ X& q- `+ W - 7 D! f0 J% {# u
- }* L' e+ g0 F" c4 _) k
- # M6 }6 P, v9 `* V
- D: q4 ~# n. r. s( b+ Q' g1 h
% D( U$ W/ R! {& M- return temp;6 ]+ W' [1 K. \, V* u4 ~/ L6 c
- $ N* ] D+ M2 [- b- P$ Y5 n
- }
" @: \+ ]1 K: O6 B' v1 C这个例子有几点值得讲解的地方,第1点指针pdata是作为函数的形参存在,指向一个储存int类型变量的地址;第2点指针pdata++;语句执行后,pdata只想的地址自增的不是1,而是int类型所占的大小,加入pdata最初的值是0,int类型占2个字节,那么pdata++;语句执行后,pdata的值就变成了2,而不是1,而*pdata的值是地址2所在的值不是地址1所在的值;第3点这个函数有个危险,即函数实现的是从pdata最初指向的地址开始往后的10个int类型变量的和,假如我们这样使用:
& |/ X$ J) W$ u' ]$ F8 T
H- h5 M9 _! x& u7 a% b- int data[5] = {1, 2, 3, -1, -2};
! w* }# K/ d2 V4 U/ p+ ~
4 n7 X; i& o: e- int x = sum(data);
7 e" ?" U9 d* c5 [7 N/ v: J可以看到数组data的数组名即数组的首地址作为参数输入到函数sum里,而数组的大小只有5个int,函数sum计算的却是10个数的和,因而就会出现地址溢出,得不到正确的结果甚至于程序跑飞。为了避免这个问题,通常的解决方法是加一个数量形参:
2 q ]% v y6 k5 t# W% W9 B5 o1 ~" T( B
- int sum(int *pdata, int length)5 ~2 Q& b. _. N2 w$ @; y# n1 Y, X2 Q
/ Z" P6 F: _8 K# B6 n0 w2 ~) B- {+ E" f5 T+ h$ d: D% P, l
6 p3 O& u; I4 I/ W/ r- int i = 0;5 c) U* _" U6 f
& E. Y* g) O- A% r2 e1 s$ O! z- int temp = 0;
4 N1 X2 ^. N! T# }. e7 w - 2 H6 j3 [6 U( k, y. K! |) j- M
- for(i=0;i<length;i++)
2 A; o7 E* w2 O- a0 }! V8 d: f
3 ~- ~3 }$ G5 o4 g- {2 |. d1 X" ]: e) K* @* s! t
6 r) L) @' l2 u! f2 G5 o. T) X- temp = temp + (*pdata);
! B" a- g* g3 ?- h2 q# b - ! H3 s. l% |4 U' ~' g+ d
- pdata++;
# w1 l# V4 U7 S1 z/ E! k: K8 @ G4 K - : ^! c9 e6 `/ P: T7 q1 p7 z0 J
- }
5 x6 z1 v+ o- e0 N8 b; J( C
+ t4 U+ y* [- g( h- 1 @: ]. Z: |& S
- ; z% _! |! J6 b# m" F# Q; W( {: X# z# I
- return temp;
) r, X& Q' \8 u# j4 |* k( s
& U- A. Z+ J/ i% ?! V. ]- }: L" Y' v0 k% V+ ^. |( J. ~
1 \7 R/ i9 t3 f$ q ^8 I. x' H4 C- x = sum(data, 5);
或者给出指针范围:, J! d) O- s4 o! ?& S: g
. s; d& _. @2 N2 S4 o% O. z# n
- int sum(int *pStart, int *pEnd)
0 K( f' K# P+ `& {3 q8 x* w l - + a |( j8 }5 f6 {0 z3 A/ q5 J# s
- {
4 [0 _2 k5 d) t B7 R
- R; I" K* _+ c3 w, e% N- int i = 0;
% a8 }* F! {2 K; x - " G' U) Y* x1 f5 T
- int temp = 0;$ h4 Q% R" I2 M, b3 `9 n
- / F7 P2 W1 t+ \( K4 j! E" m) S2 R
- int length = (pEnd - pStart)/2; // 假设一个int占2个字节
1 K3 Z" G W# \$ \) N - 2 W' u- Y: A. V4 X
- for(i=0;i<length;i++)
' L0 K6 ]+ N% K& v \/ ` - 2 O3 ?2 y1 J$ N: H2 c; J
- {
4 r6 r; T* |8 R, h - 9 R5 [) [# u/ Q7 S+ ~
- temp = temp + (*pdata);
/ C9 Q& I. u/ o: B) D0 F' _ - 8 j* v$ z' I, P/ M
- pdata++;
* ]- g( O9 }: ^% U* O& _$ b$ |; Z - 5 s' r" m2 V4 i4 y: H8 N% E. x0 L
- }1 i, G8 E3 ^3 s- Z; l8 @8 ]* w
- & P3 `5 T& W) m. g. Y$ k
- 2 a+ ?$ l" a2 n% r4 Y% N4 V
- / R* V! p' Q- C- a/ R( }
- return temp;
* c7 J& S" e0 l( W! ^6 M - ! \* X- G: p8 O" E
- }
0 f" B. g; z! E$ L
# j e7 y; [6 `* k9 r% ?: s- x = sum(data, &data[4]);
3 P# P+ b6 H* }. u% k0 s& s+ |指针与函数的关系除了指针作为函数形参外还有另一个重要的应用,那边是函数指针,比如在typedef用法章节的那个例子:
0 M+ Z! }$ Z( A' k8 y: E. p2 L n* e. K& P$ w
- typedef void (*pFunction)(void);
在这个例子中,首先*表明pFunction是一个指针变量,其次前面的void表示这个指针变量返回一个void类型的值,最后括号里面的void表明这个函数指针的形参是void类型的。如何使用函数指针调用函数呢?看下面这个例子:
+ d5 x' F/ [( T$ i& e) V8 c5 h4 m2 p# _
- Y4 n9 S( L. g/ S; ?! e- int max(int a, int b)
+ R# R4 R9 c- |! Z* R7 s - $ x! n1 A0 w. r6 B2 d9 ~% H7 x* ^
- {
) B4 N- O: }( ? N+ r0 X- b - 5 K6 K9 a# }. q7 n8 _
- return ((a>b)?a:b);
. s' M' ]3 M3 \1 p - 3 w7 Y" D2 `& W7 y% G
- }
: U5 D7 F3 @, j - 4 O' `% ?3 \) m# w+ u% o0 \' X( k
- ; R/ p z, v0 ]' {' r4 i
0 x+ G$ `( a/ h: J: P8 N- int main(void)# T# K0 d/ G7 Q$ I. y- _2 n8 b" |( C
9 Z/ D& m$ {! [" j2 L1 S, E5 Y- {
' I2 w8 Z- v3 J3 M0 X3 w+ _9 s2 D
4 ]3 O" b2 U, }1 l, @0 j( P5 a# C4 R- int (*pfun)(int, int);2 y' _8 N/ _9 e2 ~/ X% i3 O; l
- ; t# Z+ l. W6 q0 ~6 J3 w! H
- int a=-1, b=2, c=0;
- _' T3 I/ K* R2 x2 `' P* O; l
4 \# F5 W! j( d/ J8 ?$ s: k0 Z( ]- pfun = max;
, U. w" e- k) |) d- r! c
. [0 t9 ]7 T. p& ]) b+ b$ z6 b- c=pfun(a, b);( a# O' W" q, z7 B+ H
- 3 v/ C% S/ Q5 k3 Y y7 }( n) j, W
- printf("max: %d", c);
8 u/ e' _$ O$ }; h6 {6 g
- b5 @* w- L7 U- + e5 n! E$ |1 u2 h Q
- , n( |6 F* t+ p" p
- return 0;/ g2 x5 p. Y+ {8 [* [
- ) H7 S9 n$ h% c7 x! C" J
- }
输出的结果是:2。
5 {3 q% Z3 e; p4 X$ `4 Y1 K9 N/ M$ e: {# \% U; X0 V% z" j1 j
$ ?, T; S ~$ w' r) _3 n
1 T O4 ~0 d8 D& W
3) 指针与硬件地址
6 ^; N7 ~7 c9 ?3 d! o4 h
2 ~" P1 y1 e" @& f: v指针与硬件地址的联系在volatile用法章节的例子中惊鸿一现,没有详细介绍,下面做详细说明。比如在STM32F103C8T6中内部SRAM的基地址是0x20000000,我们想对这片空间的前256个字节写入数据,就可以使用指针指向这个基地址,然后开始写:
/ Y! B. `; ^- ^% @- m: D
5 @: i" C: J# [& I1 ]- volatile unsigned char *pData = (volatile unsigned char *)(0x20000000);
# `* ^0 O& p3 ?1 {! J
* m8 X2 h B" e# G, |0 @- int main(void)
/ r5 l4 I! Y5 R# j - # g" t6 ~" z8 ~
- {4 O' r* T: C2 i3 M
- * U: a3 m. H+ Z
- int i = 0;
; Y( g! [+ l0 `' w8 [9 g; u* n1 R/ V
" W- A% c6 m: ]+ `) Z2 ]$ j7 e/ q9 Z, `- for(i=0; i<256; i++)
+ r& b* S6 S0 |( b* ?4 @2 G2 L) ~3 b; I* z - , ~% i' m% [0 F- ?$ A
- {3 n5 ]# I# B/ A' o; J
4 f f* y3 q% ?9 ^- pData<i> = i+10;
3 n+ K1 k& t* T% ~5 N
$ r. L4 [1 m P: f: Z- }
' `; H1 v4 l/ N- f0 Q- Q - ; T) \% V) `4 l$ O; q! o- A* B/ Y
' [# F0 w% B; \$ y- " X7 h) \* N( e4 \0 F! R$ h4 a: C( J( N
- return 0;( G/ J9 ^& N; L& ]+ P- }
- * r' B# b0 o. [9 e4 X1 n0 P
- }</i>
9 e t% V6 V5 g& x除了内存地址,还可以指向硬件外设的寄存器地址,操作方式与上述例子类似。
" q" F9 _6 q7 T6 g指针应用的基本原则:3 b& X& {3 c1 ^" g
首先必须要指定指针的类型;
" Y( }6 }8 z, C; k1 F如果是普通指针变量,非函数形参或者函数指针,必须要给指针变量指定地址,避免成为一个“野指针”;+ R! Z( j; \9 S0 U: Z7 u
: G% T+ u! R! [( l5.3.15 回调函数+ D6 _9 H9 ^# ^* a7 U$ a5 x
在C语言中回调函数是函数指针的高级应用。所谓回调函数,一个笼统简单的介绍就是一个被作为参数传递的函数。从字面上看,回调函数的意思是:一个回去调用的函数,如何理解这句话呢?从逻辑上分析,要“回去”,必然存在着一个已知的目的地,然后在某一个时刻去访问;那么回调函数就是存在一个已知的函数体A,将这个函数体A的地址即函数名“A”(函数名即是这个函数体的函数指针,指向这个函数的地址)告知给另外某个函数B,当那个函数B执行到某一步的时候就会去执行函数A。! z" K6 y* [8 M, [
+ W z8 U% c! z! z回调函数的应用有很多,因之后的程序都是在STM32的HAL库下编写的,因而此处我们仅从HAL库出发来看其中的回调函数。7 ?, [! m% X# ~8 F$ V
" H' E; l4 A9 k; M4 G
我们仅以GPIO的HAL库函数来看,文件名“stm32f1xx_hal_gpio.c”。我们用逆分析的方法来看这个回调函数。. A8 v: u! h! t6 n
! s2 Q9 G2 |1 \$ V- S, Q& d; q; |
首先是GPIO的回调函数声明:5 \/ P$ m+ f4 V% l
8 G+ E, v2 P- C# v9 n) u- __weak void HAL_GPIO_EXTI_Callback(uint16_t GPIO_Pin)
4 ~( Y s0 @4 _% |可以看到其函数名是:HAL_GPIO_EXTI_Callback,形参是GPIO_Pin表示引脚号(Px0~Px15,x=A,B,C,D,E,F,G),从这个函数的名称出发,可以大致明确这是一个引脚的外部中断(EXTI)的回调函数。然后大家看到前面还有个“__weak”,这是“弱函数”的修饰符,告诉编译器如果用户在其它地方用void HAL_GPIO_EXTI_Callback(uint16_t GPIO_Pin)重新定义了此回调函数那么优先调用用户定义的,否则调用这个弱函数修饰的回调函数。
# X/ {& J5 O3 V' ?; p6 b8 F3 ]) I
: l9 c; A( l. d' R1 @* w紧接着我们来看此回调函数是在哪里被调用的:5 @. J6 J0 Z% u+ a$ @4 X( ` V$ M
& u0 E$ A, O8 S; { ^& t
- void HAL_GPIO_EXTI_IRQHandler(uint16_t GPIO_Pin) v5 U! @ `3 }$ L
0 s$ L, P+ t' z; m( b- {
- [) C! o9 {" X; J( r - 4 Z- h0 G X' |( j8 R6 ^
- /* EXTI line interrupt detected */+ V9 C+ j6 F. O# C9 }
% L4 |* h6 x5 _8 h5 `3 e9 c) \- if (__HAL_GPIO_EXTI_GET_IT(GPIO_Pin) != 0x00u)0 O1 i3 \2 U9 C; C5 Y
9 G, s/ C: B6 ?6 _$ U- {
$ |, [! v, Q& t; i: a" z - 3 u [$ K o9 `6 x
- __HAL_GPIO_EXTI_CLEAR_IT(GPIO_Pin);! _9 k9 ^! q6 \* d, E- @
1 h8 R: l: n; |- r7 l. e- HAL_GPIO_EXTI_Callback(GPIO_Pin);: Q$ c& y6 v9 x- W: w9 O. R
- 6 n! H* L# u! o! ~) a
- }
2 c; F" c: m' D6 x3 b7 }
/ [8 C7 ^* ?( C. k1 n- }
# ^, I& ?( p, I9 {可以看到是在GPIO的外部中断服务函数中被调用的,与前面所说的这是一个外部引脚中断回调函数印证一致了。! l. X) g) W( J
9 @- I: J. }2 f& c3 H* Z- H0 ZGPIO的回调函数到此就说完了。其实STM32的HAL库中其它大多数的外设的回调函数基本都是如此,用户如果设计需求,就自己重定义需求的回调函数,然后在中断中被调用。
' |% I! ?! o; w2 G! \, I' F0 B& J7 R. o+ X, O# f1 `
+ Y7 h' D+ c' E
5.3.16 位运算
: K5 ]! p! o& z4 D3 Q2 Y7 s位运算是指二进制位之间的运算。在嵌入式系统设计中,常常要处理二进制的问题,例如将某个寄存器中的某一个位置1或者置0,将数据左移5位等,常用的位运算符如表 5.3.1 所示。+ k( [& K$ J) ]
8 w1 e% k" O3 K' [4 q! w; G8 m7 d
9 c; h5 C/ t( y5 E/ f9 c
表 5.3.1 位运算符 4 i- |; ~0 P7 F( p5 b" u, o/ {
" |! J5 o. N3 }3 [) A9 M: I* V
" m* c! g# H; o! X: p! C) t
1) 按位与运算符(&)+ w% T- t# ]$ `! ^; s' {
( y* f7 j. Q- D& ?$ R' |
参与运算的两个操作数,每个二进制位进行“与”运算,若两个都为1,结果为1,否者为0。$ p" l* E8 Z& ?0 ?$ c8 Y2 `4 t3 K
4 D7 |! m% B- A+ L$ m8 {- }例如,1011&1001,第一位都为1,结果为1;第二位都为0,结果为0;第三位一个为1,一个为0,结果为0;第四位都为1,结果为1。最后结果为1001。, E2 |7 Q" L; i7 b2 J
% V: j( d W" N* r" Q$ a9 s- T/ ^1 W* o) o; g x
2 l0 s$ u" H- @4 O0 E% i2) 按位或运算符(|)
: i% [; e. b. c8 t/ N0 k- k% H3 C: E2 R/ H# Y
参与运算的两个操作数,每个二进制位进行“或”运算,若两个都为0,结果为1,否者为1。! W; f( A; o( \- ?( j2 t
# r+ i2 ^$ w! m9 V+ e
例如,1011 | 1001,第一位都为1,结果为1;第二位都为0,结果为0;第三位一个为1,一个为0,结果为1;第四位都为1,结果为1。最后结果为1011。/ Q! t: X# n ~/ i- y$ e( r) [
1 k1 i/ U. v a1 Q; }# N
2 C4 K2 q/ J9 O4 Y
+ _% c/ W# a8 e0 r+ o) A4 ~. f3) 按位取反运算符(~)9 ]* j$ t& S5 d3 ]- K
5 G. Y! X$ R" P' b按位取反运算符用于对一个二进制数按位取反。& D2 r+ ?) t* u1 D
2 }3 m/ {' {1 X. `3 k例如,~1011,第一位为1,取反为0;第二位为0,取反为1;第三位为1,取反为0,结果为1;第四位为1,取反为0。最后结果为0100。
/ U( P$ _$ i/ L% n9 e
$ }! }0 c! s6 U4 O7 X q' h7 \2 x" D( e
2 k& N( H' ], B
4) 左移(<<)和右移(>>)运算符# m& u% X7 t9 p- ~
7 d2 I* P% T3 ^6 e3 A1 U' @8 @左移(<<)运算符用于将一个数左移若干位,右移(>>)运算符用于将一个数右移若干位。! t: y5 n& ]4 n5 X) T) T
+ p* v+ F. {% s$ @0 m* I* D+ V* Z/ c2 `例如,假设val为unsigned char型数据,对应的二进制数为10111001。若val=va<<3,表示val左移3位,然后赋值给val,左移过程中,高位移出去后被丢弃,低位补0,最后val结果为11001000;若val=val>>3,表示val右移3位,然后赋值给val,右移过程中,低位移出去后被丢弃,高位补0,最后val结果为00010111。
8 Q" S" h) U4 g6 f0 \7 T% |/ N
_3 g+ d4 o+ ^! T+ k* g& i2 P6 ^4 C5 @- w. s7 C; P
6 I& e9 E V. _% Q5) 清0或置14 ^ C; r1 ]3 [; `% B1 k
. Y, A* o2 l$ G0 I( X# D! K
在嵌入式中,经常使用位预算符实现清0或置1。% v4 B2 f1 J5 E- x/ _% \
( r0 X5 D- u2 ~4 a5 D( O! y例如,MCU的ODR寄存器控制引脚的输出电平高低,寄存器为32位,每位控制一个引脚的电平。假设需要控制GPIOB的1号引脚输出电平的高低,设置该寄存器第0位为1,输出高电平,设置该寄存器第0位为0,输出低电平。- #define GPIOB_ODR (*(volatile unsigned int *)(0x40010C0C))
% n' v6 c Q; z7 t8 b- K8 [ - 0 L+ A: i* k6 v7 F
- / o7 L U+ Q# {) i
& |; t# T/ C+ Q; \/ z. J- GPIOB_ODR &= ~(1<<0);
: t) \( S" y( Y; p8 L5 p - ) _/ X& g+ ?+ g F/ E; B7 c6 S
- GPIOB_ODR |= (1<<0);
2 T, f$ I5 J3 K. k1 G第一行:使用#define定义了GPIOB_ODR 对应的内存地址为0x40010C0C。该地址为MCU的ODR寄存器地址。7 _9 {4 b$ c" B) c% s: A" b' e2 f
. T7 t% [0 y2 m: `7 n3 |2 k# R5 A/ V9 H第三行:GPIOB_ODR &= ~(1<<0)实际是GPIOB_ODR = GPIOB_ODR & ~(1<<0),先将GPIOB_ODR和~(1<<0)的进行与运算,运算结果赋值给GPIOB_ODR。1<<0的值为00000000 00000000 00000000 00000001,再取反为11111111 11111111 11111111 11111110,则GPIO_ODR的第0位和0与运算,结果必为0,其它位和1运算,由GPIO_ODR原来的值决定结果。这就实现了,只将GPIO_ODR的第0位清0,其它位保持不变的效果,实现了单独控制对应引脚电平输出低。
! r2 H/ E' p9 j6 ?& @, w2 v# C8 X
0 P! k8 b+ y7 O6 e第四行:GPIOB_ODR |= (1<<0)实际是GPIOB_ODR = GPIOB_ODR | (1<<0),先将GPIOB_ODR和(1<<0)的进行或运算,运算结果赋值给GPIOB_ODR。1<<0的值为00000000 00000000 00000000 00000001,则GPIO_ODR的第0位和0或运算,结果必为1,其它位和0运算,由GPIO_ODR原来的值决定结果。这就实现了,只将GPIO_ODR的第0位置1,其它位保持不变的效果,实现了单独控制对应引脚电平输出高。 " _# E5 I7 U d8 O6 f
4 M/ G0 O5 ?& u- M6 t+ O作者:攻城狮子黄; [0 j6 \" p/ [& r+ P8 w- Q5 T
% P8 {5 F3 r# I: U0 D8 t' U2 |9 _7 R) _ n9 J1 c
! Y5 M1 M8 P- c0 j9 }- R6 c- k* i |





 STMCU小助手
发布时间:2022-8-30 13:17


![PUDD~R%8TG]R2IY$S~)N~QJ.png](data/attachment/forum/202208/30/131808uoro9t22atrgtgxc.png "PUDD~R%8TG]R2IY$S~)N~QJ.png")

![]G]@DJX7I303}8)LKO3F1.png](data/attachment/forum/202208/30/131809vepwozpikwl6gmzk.png "]G]@DJX7I303}8)LKO3F1.png")


![YPAOX~KZ1RW8TL1WYS6]A.png](data/attachment/forum/202208/30/131810xie6964v64a555x4.png "YPAOX~KZ1RW8TL1WYS6]A.png")
![HNA]9WEQU_T0J{CB]JFBZF0.png](data/attachment/forum/202208/30/131810dr2uqp0ucp5ppu0u.png "HNA]9WEQU_T0J{CB]JFBZF0.png")
![6A5820F8(BIK[446GHF[T.png](data/attachment/forum/202208/30/131810a2ozv8va8vao1wpd.png "6A5820F8(BIK[446GHF[T.png")


![92PJZU[[B7_R%J]__NSX{YH.png](data/attachment/forum/202208/30/131811b6mgn3h6642z63nb.png "92PJZU[[B7_R%J]__NSX{YH.png")


 微信公众号
 手机版