5.1 如何看原理图
9 A, s, |& l0 R: \' B以100ASK_STM32F103_MINI的原理图为例,介绍如何看原理图,读者只需要掌握几个要点,就能基本理解原理图的标识含义。100ASK_STM32F103_MINI原理图在“4_硬件资料”文件夹里,读者打开《100ASK_STM32F103_MINI原理图.pdf》(后简称,《原理图》)配合本手册阅读。- {3 N0 K% a; _# d4 o
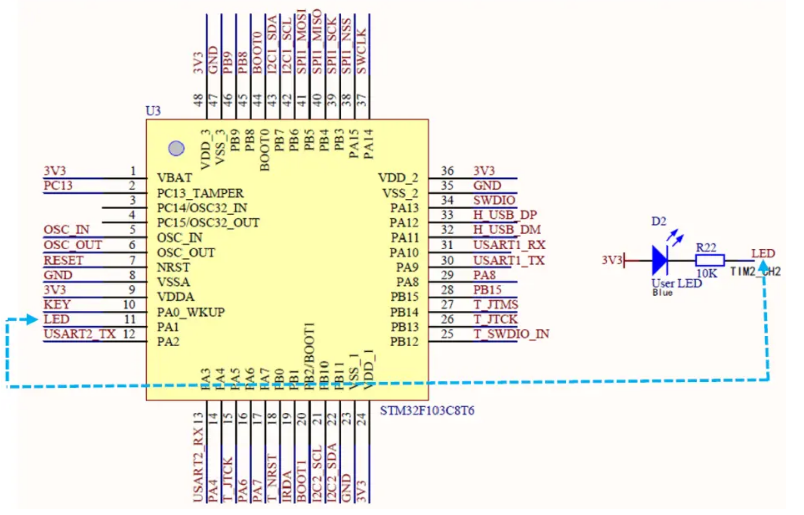
8 W: ~1 f: P4 s《原理图》由开发板最小系统,加上外设模块和一些接口组成。在原理图上,除了用连线表示两个器件有连接外,更多的时候使用网络标号来表示连接。如图 5.1.1 所示,红色文字是网络标号,只要两者网络标号相同,则表示它们是连接的。网络标号LED一个连接主控芯片,一个连接D2发光二极管,它们之间没有任何连接,但因为网络标号都是LED,因此它们表示电气上是连通的,即主控芯片的PA1脚控制发光二极管。0 ^. W4 O l+ h N/ v* ]
8 c# K/ H) T5 o0 ?
 , v2 ~' {1 u! i1 k/ A% t
' {) i* M0 v" A
图 5.1.1 原理图网络标号连接/ f) p, m' H: k! E* }
1 B2 k7 c& s' E( d, \, U5 e9 P$ c |# n2 |0 _8 X5 i
原理图上的器件类型繁多,但依旧遵循“二八原则”,80%都是常见的器件,因此我们只需熟悉常见器件即可。每一类器件,通常使用英文名称简写标记,比如电阻通常标记为Rn(n为数字),常见元件如下表 5.1.1 所示。
/ m: E$ b- F" Z o' t
5 K+ W3 Q2 l; P8 M7 k% N5 ~% Q- l
![X0OM]90GM@YLKKH4@IH6X5N.png](data/attachment/forum/202204/27/112404iwgk7dk5a5glg098.png "X0OM]90GM@YLKKH4@IH6X5N.png")
% |4 t+ C3 A$ r# |5 t
" r7 U0 i3 b( M! ^& }表 5.1.1 原理图常见元件
. e2 v5 k; H5 a9 Q
) j) @8 b* S. i对于一个单片机系统,首先要保证最小系统功能正常,其次再实现与各个外设模块的控制或数据传输。因此看原理图也是,首先重点是最小系统,其次是各个外设模块。对于外设模块的外围电路,需要什么电源、怎么接线,电阻/电容如何取值,读者也不用太担心,通常都能找到参考电路,然后根据芯片手册说明,仔细核对,最后调试验证即可。
; Y& c6 f1 M7 K9 D4 f, Q. K! B3 u# Y% j
- K0 _5 v; Y$ {& [: o- @
【总结】
! [, s- e' X$ y( W
( p+ z0 D$ S/ P) f后面分析STM32最小系统的时候,再感受如何具体的分析原理图细节,对于原理图基础部分,读者暂时理解以下内容即可:9 ~5 [ b0 U0 v# z" h7 o. s
. L& |7 I7 \# i6 X8 z! I p
1. 理清原理图板块;% m( _2 L8 f( B, }+ c( ^
5 N x+ Y: m# ?4 Y' d" F0 u
2. 理解网络标号;, j& R) g6 h3 k0 g( E; D0 x: I
$ u4 j' | ^1 ]
3. 熟悉常见元件;
$ `% M! r2 M9 r* P b$ }
% r5 A C8 {6 D; P) Z: m# |* j; y9 Z6 @1 n
5.2 STM32最小系统/ ^& s A: p v( [$ p7 V
单片机最小系统是指用最少的电路组成单片机可以工作的系统,通常最小系统包含:电源电路、时钟电路、复位电路、调试/下载电路,对于STM32还需要启动选择电路。
8 l' N l1 j5 Z/ m1 h% r' y; w" @2 T5 _
5.2.1 电源电路
$ c. \% J7 Z% b: B8 B1 D不同的MCU的工作电压可能是不一样的,比如51单片机通常为5V,而STM32单片机通常为3.3V。因此,通常需要查阅该MCU的数据手册才能确定工作电压和规范。
. D# n2 y. v& a( L1 i+ R# w( q0 p' r! B& d Z4 U# J
打开“2_原厂资料”的《1_STM32F103x8数据手册【重要】.pdf》(后简称,《数据手册》),找到“5.1.6 Power supply scheme”电源方案小结,可以看到如图 5.2.1 框图。- Q) a& O- F6 p. p' d
; m) Y0 I+ E7 S- `4 x
 + a5 Z) n5 @3 s B: ^& S
4 M" z- D U+ Y$ q/ b, c# H% K2 }
图 5.2.1 STM32F103x8电源方案
* U6 q9 |, e' K! V7 M# v结合《数据手册》“5.3.1 General operating conditions”的表 5.2.1 ,可得知上图中的各电压值大小。
5 t. o+ I( q7 S9 r2 f7 i2 N: S2 d) B5 G5 y& @% E9 A
 & X4 j/ P" }0 W: E; q- W
' q9 q4 {5 v" L. [/ X6 ]1 Y表 5.2.1 工作电压参考
& m5 a! N- J+ D# w: D; u2 a; R* [; ]) s
& O4 ~/ K! F* l3 h①VDD-VSS:标准工作电压;电压范围:2V~3.6V;从VDD1 ~ VDD3,VSS1 ~ VSS3共有3组;经过MCU内部Regulator电源管理,为CPU、存储器等供电;$ J4 z3 l/ R9 _* h
/ V0 _2 r5 }& a0 |/ [0 r
②VDDA-VSSA:模拟工作电压;电压范围:2V~3.6V(未使用ADC) 2.4V~3.6V(使用ADC);由VDDA输入,为ADC、DAC等供电;" Q! r# o/ K" K1 }) [( {& e
/ x: q5 L( H/ [. ]
③VREF+-VREF-:基准参考电压;电压范围:2.4V~ VDDA;可以使用独立参考电压VREF(需10nF+1uF高频滤波电容),也可使用VDDA输入,为ADC、DAC等作基准参考电压;
7 r& a( `& D( E$ g& G" @! X& L& l6 _4 J0 x3 Q2 x1 U! G& a u5 j
④VBAT:RTC备用电源;电压范围:1.8V~ 3.6V;通常使用纽扣电池外部供电,当主电源VDD掉电后,VBAT为实时时钟(Real-Time Clock,RTC)和备份寄存器供电(此时功耗超低);$ G W- Z4 D$ T
% v3 w s6 `8 n. |- h0 C2 T+ {
' ?: z3 H U$ y5 ~2 W( c1 S
从数据手册了解到以上知识后,再来看看原理图的MCU电源部分。开发板采用USB供电,通常USB都为5V,因此需要将5V转换成3.3V,使用AMS1117-3.3电源芯片即可实现,如图 5.2.2 所示。3 h% c0 m6 }3 j e3 P# ]5 y
0 y+ G, M5 X$ l/ S. C# n% C M! D
 3 S8 Z4 }6 ]8 d: @, N% N1 V! Q
9 ~1 Z( i* W5 T1 M图 5.2.2 电压转换
& v J- ^ n- n: s( t" g" f/ _
8 |9 E W0 v! E( W" ~, ?通常USB口由其它电子设备提供,还需要考虑其保护。这里使用自恢复保险丝F1,避免USB口短路大电流烧毁;使用TVS二极管E1和E2,避免静电损坏USB信号引脚。
/ V0 i* N! S! H/ h6 \! C1 ?6 {6 Z4 v: ?/ J3 q; i
使用转换后的3.3V提供给VDD1 ~ VDD3和VDDA;VREF+和VREF-在引脚数大于100脚的芯片才会有,因此STM32F103C8T6不涉及;VBAT这里直接连接3.3V,简化不使用对应功能。6 V/ [. n- l# @' j3 m- D# b: s* }
7 Y( s- g- I( W: k' I# w: M
. c! V7 [8 U! t. X/ Z: h8 U' d5.2.2 时钟电路
5 I5 f8 S# d; ]- I( N# b- ^MCU是一个集成芯片,由非常复杂的数字电路和其它电路组成,需要稳定的时钟脉冲信号才能保证正常工作。时钟如同人体内部的心脏一样,心脏跳动一下,推动血液流动一下。时钟产生一次,就推动处理器执行一下指令。除了CPU需要时钟,芯片上所有的外设(GPIO、I2C、SPI等)也都需要时钟,由此可见时钟的重要性。+ k1 |" T5 I& @ P! n) ~
2 r& L3 @- J+ C1 D8 n- |芯片运行的时钟频率越高,芯片处理的速度越快,但同时功耗也越高。为了功耗和性能兼顾,微处理器一般有多个时钟源,同时还将时钟分频为多个大小,适配不同需求的外设。0 r1 ?9 C' q2 {) O/ n& r, v t0 k
) B, f; H, j7 W* A" \. m! {
由《数据手册》可得到如图 5.2.7 所示的时钟树,这里只关心时钟源,时钟的分配使用放在后面讲解。
( H! d" M4 X2 q* s# c$ J: ]5 F
1 L Y- g: \; F! R! Y2 H

, J8 }- R- M- `* C# e; D( B, W# ]1 M j1 H: ^' x- P8 g3 W
图 5.2.3 STM32F103x8时钟树; m p0 G) M( T8 P; y
8 I' @/ U# b7 T- F; r/ z5 ^可以看到一共有四个时钟源:
2 |1 f# K5 p: A5 ?( R ?( e
; k' `8 J/ Y) ?+ k* w4 I; J" q①HSI(High Speed Internal clock signal):1 }$ u2 C3 L# ?' V: F( T$ H6 f% U
8 ~5 C6 } l. ~7 f6 YHSI是内部的高速时钟信号,频率8MHz。因为是内部提供,可以降低成本,缺点是精度较差。4 K3 M8 F8 L* M* V
' W6 K& \. t& v' |; [# G
②HSE(High Speed External clock signal):" i' J( V( ~+ _; ?
. u5 f6 U/ P1 z. v* N$ e% v8 `
HSE是外部的高速时钟信号,需要外部电路晶振,输入频率范围要求为4-16MHz。因为需要外部电路提供,成本会增加,但精度较好。
$ q# \. L4 k; t
/ i4 R1 \2 n |' A H; i; @. ^9 U③LSE(Low Speed External clock signal):
- ~! h4 J' d8 l7 l; o" |2 {& [6 D$ U: s5 U8 f
LSE是外部的低速时钟信号,需要外部电路晶振,输入频率范围要求为32.768KHz。一般用于RTC实时时钟。9 V# f- \& \$ e/ a/ L
. T: {% a) Q5 [& Z" T4 G0 N9 H- Z
④LSI(Low Speed Internal clock signal):
3 v" z) R/ i& O$ Y4 `6 ?2 W. Z- Y. o7 m- ~. [% i7 U/ y
LSI是内部的低速RC振荡器,频率40KHz。一般用于看门狗、RTC实时时钟等。
& a4 b* P3 J! k; ~# }" G& E' m5 B9 z( B1 i+ ?: U. H
U* _9 k$ f4 p% Z, ?9 n对于STM32F103系列的MCU,都需要一个高速时钟和一个低速时钟,而这两个时钟可以选择使用内部时钟源节约成本,也可以选择外部时钟源输入提高精度。如果使用内部时钟源,则无需设计外部电路,反之,则需要时钟电路。
- x6 d5 o. F# C1 @) B8 V ]4 H% o
继续查看《数据手册》,可以看到如图 5.2.8 和图 5.2.9 所示的外部时钟输入参考电路。手册上提到对于HSE,当晶振为8MHz时,CL1和CL2的容值范围为5pF~25pF。REXT用于产生负反馈,保证放大器工作在高增益的线性区,同时也起到限流作用,通常在兆欧级,具体由晶振决定。1 d- p3 }% ~+ X9 S% p
" Q0 o. ~/ }$ l. e" o' c8 [" W
![P4C4(U]1)HEAHL~AHOWSC6W.png](data/attachment/forum/202204/27/112406ec77vm1ym1z172q9.png "P4C4(U]1)HEAHL~AHOWSC6W.png") 7 }6 X, U8 g) a. G6 }! c
# T5 d/ k+ Y- ~* X$ B: N$ U! ~图 5.2.4 HSE典型应用(8MHz)6 ]# _2 L7 P$ R; a; x) H
对于LSE,当晶振为32.768KHz时,CL1和CL2的容值范围为5pF~15pF。之所以选择32.768KHz,是因为32768=215,分频设置寄存器通常为2n的形式,这样经过15次分频就很容易得到1Hz的频率。5 b9 ?1 g, F. K9 `+ O2 H
4 V- C: u7 F: G0 r+ P% S2 J
 , z" _& z; K9 {( }9 X0 b
: D! V4 w9 ?/ ]- M. Y" L8 a图 5.2.5 LSE典型应用(32.768KHz)
$ B, F" P# y, M从数据手册了解到以上知识后,再来看看原理图的时钟电路部分,如图 5.2.10 所示。高速时钟由外部提供,低速时钟由内部提供。4 G: Y, c- I% W+ k* g2 j4 J# _$ }
1 @: z1 U8 B' ?+ t8 m晶振旁的负载电容,应选择高质量陶瓷电容(NPO),以满足高频率场合。在Layout(PCB布局走线)时,晶振和负载电容,应尽可能的靠近MCU,以减少输出失真和启动时的稳定时间,保证振荡器可靠工作。
i( G3 o0 Q# K' x0 d' z
+ H- z' f* b4 m# e
![MMIT}M_}TQ0@]K~8C39F52S.png](data/attachment/forum/202204/27/112407apc5jht9w9sy5mw3.png "MMIT}M_}TQ0@]K~8C39F52S.png")
' Z% q" r: T& W* t- C# s& K% \5 F, g0 s. [2 K
图 5.2.6 时钟电路9 R6 C' }" I0 X5 z8 E( M
: x3 f, g9 h0 s* ]+ {- Y) h5 D* v) J0 i7 v2 v6 @, n, u- f
5.2.3 复位电路5 D; `/ a0 |2 O. y! |1 _" C
嵌入式系统中,由于外界环境干扰,难免出现程序跑飞或死机,这时就需要复位让MCU重新运行。查看《参考手册》,可见如图 5.2.11 所示复位电路。该电路将一个按键接在了NRST引脚,一旦按键按下,NRST就会接地,拉低NRST,实现复位。+ [1 `! P& m' }6 u- s$ a% ]" `
0 G0 k3 `- w. B+ o4 R
 ' O7 m8 U4 T8 ~0 l+ Y
8 G9 q1 W- _3 F* `5 f# _& h图 5.2.7 复位参考电路( { Q$ F+ N/ B
: [% G8 [! L! C. R! Q
再来看看原理图上的复位电路,如图 5.2.12 所示。当开发板正常工作时,3V3上拉NRST,当K1被按下, NRST会导通接地,拉低NRST,使MCU复位。
, E! f. p6 {9 p! Q/ V, D8 C, Z% s0 U3 z5 H+ w+ v
![}BSD`S]8Y08~HT$TSH[2HX8.png](data/attachment/forum/202204/27/112407nndwowttxw99ptdp.png "}BSD`S]8Y08~HT$TSH[2HX8.png")
6 ^# [2 S2 F* J- J
! h3 @- q/ Z u; e& {图 5.2.8 复位电路
* V7 z; N! d& o7 X
3 _; A1 x4 K7 j! H* o: L7 @! H. t' f7 S1 Q3 H
5.2.4 调试/下载电路
* ~: P P! B' b% R' E1 d不同的MCU,调试/下载的方式可能不一样。比如51系列单片机,使用串口下载程序,部分也使用串口仿真调试。对于STM32,可以使用串口下载程序,也可以使用串口打印的方式进行简单调试,如果想仿真单步调试,就需要JTAG(Joint Test Action Group)调试接口或SWD(Serial Wire Debug)调试接口。6 t8 e9 [/ o% \. y
( N6 a9 g" b/ J& N2 z, y本开发板支持串口和SWD下载,如表 5.2.2 所示,日常直接使用串口下载,无需额外设备,方便快捷。需要单步仿真调试时,使用SWD接口,功能强大。
6 O. B+ d k3 u2 e2 N6 g" E9 _" M8 ~; Q# n% w( \2 o

0 ~$ ^ @5 y7 S+ \, u9 z/ ~ Y+ Y# Q: L2 w" c
表 5.2.2 调试/下载接口/ r1 M/ S1 z; d) ~4 {& [
8 ?5 D3 R' e/ @" V0 c/ g串口自动下载电路涉及BOOT启动选择,当BOOT0和BOOT1引脚都为低电平时,MCU正常启动;当BOOT1引脚为低电平,BOOT0引脚为高电平时,进入串口下载模式(In System Programing,ISP)。串口打印调试/下载电路如图 5.2.9 所示,上电后,CH340G的RTS和DTR都输出高电平,电脑上位机软件控制DTR引脚输出低,PMOS管导通,电容C2充能,BOOT0逐渐变为高,此时三极管Q2导通,复位拉低,MCU复位。随后控制DTR输出高,PMOS管关闭,C2放电,BOOT1会保持一段时间高电平,此时三极管Q2截止,RESET上拉,开发板启动,进入串口下载模式。下载完后,跳到下载程序位置,运行下载程序。
" H- W/ s1 X$ H# g' r4 b
3 h1 z" J- e3 I
![EW]1CD8)7F)~EM)2~W{XDMY.png](data/attachment/forum/202204/27/112407u0bgx0xs67mbpgb2.png "EW]1CD8)7F)~EM)2~W{XDMY.png") 5 ^. y9 z8 p3 E' P( N% y$ Y s
0 I, A: [: D) ~
图 5.2.9 串口打印调试/下载电路
. P& R- c- ~8 I" v3 q [3 T d; ~! G. x- z0 B, P
开发板除了用于单步仿真调试/下载SWD接口,也可以作为ST-Link去调试下载其它SWD接口。这里把两个接口做在了一起,实现了两个板子直连,一个作为ST-Link去调试/下载,一个作为开发板被调试/下载。所涉及的引脚参考表 3.4.1,原理图如图 5.2.13 所示。
% b8 E8 I" K# o& ]+ H" `$ W
9 i. @- s$ r) \$ H% P
 ' |5 ]) v1 y. w
0 F" O1 E4 F, Z; E$ A( p
图 5.2.10 SWD接口调试/下载电路
1 A" r3 H; k7 {3 B5 ^; H& q9 {/ ?% }! ~3 T2 ]" ]
【总结】8 r& s6 U3 y( p
+ `; E, j$ }2 H4 V; A本小结带领读者学习了如何读原理图,也对STM32的最小系统有了一些了解。后面的电路众多,在分析某个电路时,结合相关手册的参考电路和说明,加上不断积累,相信读者也能灵活分析原理图。7 Q6 {7 k, s5 G# ^$ i- A
6 t, H7 D- y) f* R5.3 嵌入式C语言6 i3 f& a6 o! e% D5 x, c4 {* o( `" G
5.3.1 基础知识
) {1 j3 b4 R7 T/ Y( {( P" z( c嵌入式C语言和普通C语言在语法上几乎没有差别,其主要差别在于普通C语言的运行环境是OS之上,有很多的标准库函数支撑调用,分配的内存是电脑的内存,其处理器就是电脑的CPU;而在嵌入式环境中,会涉及到底层的硬件,而硬件本身是没有标准库可以调用的,因而就需要开发者使用C语言编程调试硬件,使其可以工作,对于开发某一款芯片,有针对的编译器(或者交叉编译环境),可以分配的内存则是芯片的RAM、Flash,处理器则是芯片自身带的MCU,例如ARM、DSP等。
1 c* l1 v' @1 P5 k/ N6 `5 E* X" R" d# Q" `/ N- ^
例如C语言编程的入门课:打印“Hello World!”,在普通C语言编程中,直接调用printf()函数即可在PC上打印出;而在嵌入式中,则需要开发者使用C语言去将芯片的串口调试成功,然后将printf()函数重新实现,方可调用打印。# H5 S; ]/ \5 k% m; l: d- e
# t" J. s. t# M, B% e' p5 O. a
嵌入式C语言的基本结构及其特点:3 M8 z" A$ f+ S" g9 Y
3 L. C7 n- C+ k3 R# I' K
1) 所有的C语言程序都需要包含main()函数,代码从main()函数开始执行;这一条在嵌入式中不一定完全正确,在执行main()函数之前也有开发者可以操纵的空间,因而开始函数可以不是main(),例如也可以是myMain()这样的函数,而这所涉及到的知识已经超过基础知识的范围,会在后续详细说明;% v$ D& T& l4 T% A( ^6 H" R* Z
0 u4 U( U2 z0 G9 f
2) C语言的语句以用分号“;”结束;
0 H S, J0 z% d p4 t5 S' _( k! \5 i' `3 z" q' W
3) C语言的注释有行注释(“//”)和段注释(“/*…*/”);, c. e( T8 W5 T
* Q) X0 p8 G% b3 ?
4) 函数是C语言的基本结构,每个C程序都是由至少一个函数组成;7 w& T9 N" p6 k! Q' n. S
4 P6 u! i; Z+ b7 q9 |' r
5) C语言的文件有两种格式:源文件.c文件和头文件.h文件,通常.c文件用于功能函数的实现,而.h文件用于预处理、宏定义和声明等;在嵌入式中,通常将某个硬件模块的功能实现函数及其声明和包含的全局变量声明分别处理到一个.c和.h文件中,例如led.c、hello.c和led.h、hello.h就分别对应于LED灯的功能函数及其声明和hello的功能函数及其声明;
9 b3 Y1 X8 H- @5 ^0 |. c5 h7 H# K# |4 t2 V
6) 我们将这种基于某个模块的独立设计称之为模块化设计,在一个系统中通常是由许许多多的模块共同组成的,因而模块化设计是一个非常科学且非常值得学习的程序设计方法;
* }2 X6 k6 q, J& y" J k7 W$ h& _1 I; [
7) 除了模块化设计,通常嵌入式的编程设计还有层次化设计。在一个工程系统中,硬件驱动仅仅只是第一步,对硬件的应用则是一个功能丰富的系统的更进一步的设计,通常在这一块会设计到例如图像处理、数据处理等算法;我们可以笼统的将一个嵌入式工程系统分为驱动层和应用层。
S; u2 \+ D5 g9 ]$ w6 t- R
& C b2 i z" `, ~& J/ P% r" _4 F7 [
5.3.2 数据类型
" g; O' [' \2 o* H5 p& n在C语言中,数据类型指的是用于声明不同类型的变量或函数的一个广泛的系统,变量的类型决定了变量存储占用的空间以及如何解释存储的位模式。* _6 _- o3 s4 ~$ z/ c( L% h/ G5 o
7 J7 n8 D4 }0 X( @2 d6 A在嵌入式系统中,芯片的容量是有限的,且对比于PC机容量通常都是比较小的,因而了解变量所占用的存储空间是嵌入式开发者应当掌握的一项技能,所以对于不同数据类型在不同位数的芯片中(例如STM32xxx就表示此款芯片是32bit的芯片,STM8xxx表示此款芯片是8bit的芯片)的长度开发者也应该掌握。
- ~! R( D' f4 B, f: G
* _8 g5 ?- y( Z9 r* \C语言中的数据类型有以下几种:
& b( H/ B6 V0 m' N- ~: x! g* q5 h* p- L* s# i. \6 c; b6 K0 H# E
![@{CQ_VE}QFAF]_[XZ1E.png](data/attachment/forum/202204/27/112408doc7yh7h4ohoj6e7.png "@{CQ_VE}QFAF]_[XZ1E.png")
' V$ p; @, U* l6 v# X6 T2 @5 S' K! Z, K
图 5.3.1 C语言数据类型
9 n2 b, r$ z! O8 X G2 D* @' W* B" X! J3 x: S
就以STM32F103C8这一款芯片为例,这是一块32bit的MCU,基本数据类型在此款芯片中的数据长度,以及在HAL库函数中的定义(stdint.h文件中的定义,采用C99标准)如图 5.3.2 所示。这里建议开发者在开发过程中使用库定义的数据类型,来定义变量或函数,比如unsigned char a,使用uint8_t a。' v1 {; i$ k& r7 z. c
# [0 W( z b& |, W( u

# w9 K: q& j! D$ P5 S9 L+ H+ V1 R i' `5 R0 x
图 5.3.2 本手册芯片涉及数据类型3 a1 B+ `2 x- w% s/ b5 G
! T& b p& @- R) t+ B5.3.3 const用法
0 D5 r+ a* S! ~C语言中const关键字是constant的缩写,译为常量、常数等,但const关键字不仅仅是用于定义常量,还可以用于修饰数组、指针、函数参数等。
9 A) ~. p2 E, I l$ K8 @
, t8 J% S& ?: u) P1) 修饰变量! Z6 J+ q2 c1 Z( X
. N- ]1 e. L* P# Y/ J" g& h' [0 y
C语言中使用const修饰变量,功能是对变量声明为只读特性,并保护变量值以防被修改。例如:$ D: E% s8 o$ Y( R
* K- k# x& f) Y( Y3 N l8 P! b" f$ X8 `; M* h+ @
这个例子表明整形变量i具有只读性,不能够被修改;若想对其重新赋值,例如i=10则是错误的用法。需要注意的是,const定义变量的同时还必须对其初始化,const可以放在数据类型的前面或者后面,比如上述例子也可以写成:# P1 w4 v) H" U1 G' p, D/ M" z
9 A& q! e" ? z
0 U2 Z5 C* h8 d1 `1 t' t& l此外,const修饰变量还起到了节约空间的目的,通常编译器并不给普通const只读变量分配空间,而是将它们保存在符号列表中,无需读写内存操作,程序执行效率也会提高。
/ r! q1 L2 } c( H1 x
0 q( F$ _- d! A- N% d ?9 u# k5 a: x1 U( m: v. K
2) 修饰数组
# |2 l; F# @2 M3 ~. Z# m! s$ D4 q6 w7 I1 a% H4 F) n1 P
C语言中const还可以修饰数组,例如:
8 q8 Z! f% a3 q, R4 h( m
8 ]4 u5 P% v6 c- const int array[5] = {0, 1, 2, 3, 4};
2 B3 ~! L5 _6 y0 c
/ u6 P& q* q$ y5 o* |- // 或4 }! x3 T) j- `) t/ F3 v k
- . h/ R% A) V: k& S
- int const array[5] = {0, 1, 2, 3, 4};
+ c7 r& {) J/ S$ i+ Fconst关键字修饰数组与修饰变量类似,表明此数组具有只读性,不可修改,一旦被更改程序会出错,例如上述例子如果:
6 n6 Z. W( v7 h* ?: X1 J( b( l9 s7 _9 m4 l
7 |! `4 p* I3 L4 U则程序将会提示错误。
0 J* T# G4 X5 c" B# B, X0 K" C8 ?" r
9 r; v( G6 y2 w1 f1 s: ?' B- o: B8 K8 x
3) 修饰指针
8 D* [" k# p1 d9 k# V' K U3 `0 J5 }0 ?& u/ m
C语言中const修饰指针需要特别注意,共有两种形式,一种是用来限定指向空间的值不可修改;另一种是限定指针不可修改,例如:$ A3 I# ~ ^0 c: C: x
6 e# [( L* z, l# W8 i+ T
- int i = 5;
) u, Z% [, J. x/ T3 v# O - 6 r! f' n0 W2 `1 @! q8 ^
- int k = 10;, n9 g4 n! |! G5 y7 G
- * Y8 _1 J2 I2 C5 {+ f2 L' \
- int const *p1 = &i;/ w, W, V0 c; t" q8 S( v3 ^% c7 Z
- 9 g4 H7 a7 x1 Z, W
- int * const p2 = &k;
5 F/ ^# O X4 U% j+ a+ p对于指针p1,const修饰的是*p1,即p1指向的空间的值不可改变,例如*p1 = 20;就是错误的用法;但是p1的值是可以改变的,例如p1 = &k;则没有任何问题。
4 `3 N' q/ ]+ ]6 Y5 L0 f4 ~, Q& f" w7 I$ _0 K' {3 f+ J& b
对于指针p2,const修饰的是p2,即指针本身p2不可更改,而指针指向空间的值是可以改变的,例如*p2 = 15;是没有问题的,而p2 = &i;则是错误的用法。
& [& y6 n9 U: z! [( s- r7 D% e+ ]% C2 i6 ]$ U) e- j; A) m1 v
1 v" B1 E! D. ^' Z7 ~" E4) 修饰函数参数
1 [5 x$ n# }0 k; a/ F
2 o- D6 T" K" ?) A6 G: j6 M8 G在C语言中const修饰函数参数对参数起限定作用,防止其在函数内部被意外修改,所限定的参数可以是普通变量也可以是指针变量,如:4 c2 ]2 l& W2 d* N; G' O' L
! T7 J8 ]9 @ x$ K1 s. _- void fun(const int x)* }6 {9 q: V9 i/ x
- ( C& ~) I; J5 I6 K& _/ J2 n4 F. z
- {+ ^$ ^3 i1 r3 ~, `
3 Y- \" t" M* h0 v# l6 f- .... q: H0 n) m q3 P
4 h/ G' Q2 O" M( [- x = 10; // 对x的值进行了修改,错误
7 {( t3 c; D% C7 ^+ z2 d4 E - ) G1 s0 m' u5 E+ {) L
- }
1 s- v) y) O/ b/ b0 C' U# L - 6 y2 N* E/ m% Y( k0 U% j) n+ P% P
$ H2 ^) U; B5 G0 n+ r+ y
c2 [4 ^4 w3 G4 ?( \0 H- void fun1(const int *p)
V1 a3 M/ Q* D" n$ y
. e4 m$ F% M0 `9 y3 ~& x# B& N- {
: }+ A/ }" j: N+ C6 o
4 n+ p s# Y- R; ^% y2 ?# R- ...2 }9 E& z4 ~6 p! G3 c
- ' y+ A; j+ Q2 W; E9 d
- (*p)++; // 对p指向空间的值进行了修改,错误
# N4 l! B6 v9 y0 ^
; a& k1 \4 O* G$ d1 L) h4 }- }
3 `! g# i. C) ~% K" d \7 s
( r- x: y- _# |; B' X! p) V
3 h! M; L8 D& L; J7 N$ ]! J6 T5.3.4 作用域与static用法; y/ c0 U$ M! I- S+ s: V
在了解static关键字的用法之前,我们需要先了解C语言中的作用域、局部变量和全局变量的概念。
1 @4 D) ~% V8 p# q* e; X
( {8 ]6 c' B; O' r一个C变量的作用域可以是块作用域、函数作用域、函数原型作用域或文件作用域。3 C3 x# J- [+ @( i4 E+ K! R% U
5 W l3 x! R2 h: y块是用一对花括号“{}”括起来的代码区域,定义在块中的变量具有块作用域。块作用域的可见范围是从定义处到包含该定义的块的末尾。以前,具有块作用域的变量都必须声明在块的开头,C99标准放宽了这一限制,允许在块中的任意位置声明变量。例如不支持C99标准的的for循环需要这样写:
9 a$ T! u# `3 G6 h
) h& t2 F9 i5 \! M- void fun1(void)
% l0 y: d7 Q3 Q9 ~1 j - & y: A+ t6 R+ p8 p1 D
- {' g: ?0 v' P+ z7 y$ V& t
7 t- l$ ` g2 A; ~# ]- int i = 0;
. s' Y3 Z) @) m7 ^; ?% @( E
7 u9 n& \5 [+ o) [4 c+ o- for(i=0; i<10; i++)& h; k% E/ g" q6 K" w
- 1 Z. o, \8 Q9 M G
- {" t5 j* k3 E# W1 {2 R+ z0 z j) W
- & C6 ^: p! T( ~4 H! P/ _$ N6 k; ?
- ...+ K% D- }3 f& }0 J
3 e3 I! o. f( O& K4 |' ? u% Z- }/ r. H! a, c- B, n
- / X- p0 ]7 J: p) Z
- }
在函数fun的开头定义了局部变量i,然后在for循环中调用此变量,变量i的作用域是函数fun内,当函数fun执行完毕之后变量i会被释放。而C99标准下可以这样写:; T) s7 O2 w+ `3 F9 x8 C& b1 O" h! o
) _2 v S( ~+ o5 {
- void fun2(void)1 s |9 ], T) n# r3 ? i, s
; S% ~% M0 q1 M+ `! w- {
- h, X) p |; }6 L4 V) ~( m
9 O% e' I' l0 `+ n% u- for(int i = 0; i<10; i++)7 j6 F4 K& \( U# ^
/ x/ ^/ k2 d$ F- {& G0 o# W, K3 S8 i7 x
- : N! O' b* i% T+ {
- ...
6 L' I# Q7 ~( d8 ^
6 P% D" d/ {, T- {0 m- }
' i/ _* u$ I+ w; |: Y3 I7 A) h - 5 m5 Y2 d& t" N5 v+ d8 l
- }
这样写的话,变量i的作用域则在for循环体内,当循环结束后,变量就会被释放,可见其作用域缩小了,这样的好处是增加了安全性和灵活性。
) M2 X, p t& J/ S4 [
& D, |9 K( P# C. |- h在函数fun1中,变量i被声明在函数体内,我们称这样的变量为局部变量,其有效范围是在被定义的函数内,函数执行完毕后变量即被释放;如果把这个变量定义在函数体外,如:1 Q; T& Y# a; Q9 M. E0 z
8 S% ^ z/ @! N- F7 O
- int k = 0;
# l; ?; _5 v4 Q" z1 _. ^ - / L: L, S+ b t" t2 C2 [7 b
- void fun3(void)7 p2 }* v" B; l+ a; f
- , W1 S' q% b6 e3 F+ E9 n
- {- L3 Q, \4 G$ c0 L
- + ]5 S. U3 ]( F
- for(k=0; k<10; k++)
4 t' a: f1 w+ H& X0 x - & u* U3 R: x# S# S+ e7 r/ X7 z
- {. z: l2 w# Z7 `1 z' V) r! P4 P
- * q% j7 I; _. p3 \; V
- ...
! l, @+ U7 Y3 ~ - + R2 k- n4 x3 [2 Q2 j7 N. h
- }* y- ~$ U; }+ o' f4 S. c
- ! P8 s1 e; T2 B
- }
我们则将定义在函数体外的变量称之为全局变量,其作用范围为当前源文件和工程,若其它源文件想要调用用此变量需要在文件内使用关键字extern声明,如extern int k。
, b; K& s; U- A
8 H: p( l( k* W5 o1 |5 }简单的总结下局部变量和全局变量的特点:
3 ~! R& {. a3 `2 L. |) L3 K; {. |$ [$ z
1) 局部变量会在每次声明的时候被重新初始化(如果在声明的时候有初始化赋值),不具有记忆能力,其作用范围仅在某个块作用域可见;
3 a2 ~4 t6 B* f. O
- z% E9 L; A Q) B7 [# o! X2) 全局变量只会被初始化一次,之后会在程序的某个地方被修改,其作用范围可以是当前的整个源文件或者工程;
& |" s$ l% a; ]) M/ A; r' b' y, v$ c1 I% o
9 j, \4 s' B t7 y( B鉴于两种变量的局限性,就引入了静态变量(静态局部变量和静态全局变量),使用关键字static来修饰。其中静态局部变量满足局部变量的作用范围,但是其拥有记忆能力,不会在每次生命的时候都初始化一次,这个作用在用来实现计数功能的时候非常方便,例如:
2 G. I9 b# {" K8 I% \: M
_( U" q$ {! o9 o: A- void cnt(void)9 b6 b, }* F9 k h4 _
- ( {8 Z% u8 b! a; `' x
- {0 f# P# |! I. {( |7 H' E
/ o8 n! w, B! Z# G$ i$ n* S6 k! w- static int num = 0;7 n2 f* p4 u+ x* l* E: [3 D$ y
- W& _2 N9 K8 ^. h9 m+ t
4 n# D9 d& m2 |7 Q- 2 X& N; i- J- `# ^ i* K
- num++;
3 K6 Q+ ]% o6 L
$ p a& _* }& V& J6 g: q- _- }
# J% M) E( R( A6 d* V( E在这个函数中,变量num就是静态局部变量,在第一次进入cnt函数的时候被声明,然后执行自加操作,num的值就等于1;当第二次进入cnt函数的时候,num不会被重新初始化变成0,而是保持1,再自增则变成了2,以此类推,其作用域仍然是cnt这个函数体内。5 {2 Q; N6 V# e2 a
8 Q' M- T }2 `8 u静态全局变量则将全局变量的作用域缩减到了只当前源文件可见,其它文件不可见,简单例子如下:# l/ p6 n. Y, v& X4 `
+ O- K7 E' k. q- C0 X* S4 j
- static int k = 0;
& {% s# \ X8 F1 @: q+ L - 7 t! `* p( s" V. M' b
- void set_k(void)' E0 w* F1 u' V4 a/ l
, w* [9 T9 [) u) y9 A- {
/ T% M4 x; \9 h0 |! F - . Z( B8 B x/ e# U% d
- k = 1;
8 a6 B4 o/ w6 X4 g# Z, H& Q
) z3 K) @5 C2 J1 z3 k* x- }1 c% J& J2 ?* S, ?; k7 c
! }* X4 W2 q5 U
+ e5 M6 U6 ?4 N4 K- ! x' J1 O' o K& j
- void reset_k(void)# h. u% |5 n" e3 y9 b6 l# F& W
7 `4 C3 e1 O( j, g, `* J- {
7 A/ b4 M; s, J! N% K! k; k; h
2 Y* c' G# y$ e% D1 A- k = 0;
; z. T& T0 _1 r/ k% q' m, M* [
. I J3 o5 F. G0 w2 Z& _% g' r- }- }
6 P' v3 F' K# e" b8 Z8 V# C0 P3 P - v2 m e; b! a! u( e; m- ~
- int get_k(void); c- v( R8 M/ X, w/ B( g K. V
- # [2 Z2 {+ J: _
- {
" f1 L3 ?6 t3 b3 E V1 \) P - " J' t4 `$ b& P7 K. V
- return k;) A1 `: P+ g+ z) q: b4 _
& c7 H: o& v1 g# u ^+ u7 b- }
D& }- f+ C- S( C+ L4 P1 U静态全局变量的优势是增强了程序的安全性和健壮性,因为对于变量k而言,我们假设我们不期望其它的文件有修改变量k的能力,但是其它的文件又需要变量k的值来进行逻辑运算,那我们就可以向上述例子那样做,在源文件中定义一个静态全局变量,同时使用函数对其的值进行修改和获取,对外只提供函数接口即可,其它文件通过函数接口间接的使用这个变量。这样做同时也可以提高可移植性。
- u; H$ k& L/ p, B" r" o4 | f
$ P: |4 T% s/ j静态全局变量只在本文件可见,因而其它文件也可以定义相同名字的静态局部变量,例如我们可以在source1.c里面定义static int k = 0;的同时也可以在source2.c里面也定义一个static int k = 0;这样做是不会有问题的,但是我们一点都不建议如此做,因为这不利于程序的可读性和可维护性,也容易让开发变得混乱。. T% [$ r. [; H* z. A
, s& f( q8 ^- p3 R9 U在C语言中static关键字除了用来修饰变量之外,还可以用来修饰函数,让函数仅在本文件可见,其它文件无法对其进行调用,例如在example1.c文件里面进行了如下定义:
+ G5 Q& A& R5 u; u5 }$ e2 {) a g2 \) k* }3 f+ q& D- ` d+ C
- static void gt_fun(void)
l. L+ n" l8 F g8 x - * D% Q+ l7 `5 Z) S: k0 F
- {
% y% z3 j7 F3 D9 p% k7 h2 v
7 M* `. }# G: T: x- ...
3 L; M! Y8 v) E) |0 f - / G/ C& i; c; ?5 A5 |
- }
0 o+ O% c; H* g8 w a那么gt_fun这个函数就只能在example1.c中被调用,在example2.c中就无法调用这个函数。而如果不使用static来修饰这个函数,那么只需要在example2.c中使用extern关键字写下语句extern void gt_fun(void);即可调用gt_fun这个函数。
( c& p5 \' _/ r ^5 S6 D$ l5 D3 q2 X7 l' D9 N, a
在嵌入式C语言编程中,static是一个非常灵活非常好用的关键字,它可以让程序更简洁、更安全、更具有可移植性,在嵌入式系统中这三点都是非常重要的编程思想,需要认真掌握。, B" o) d4 _; E: Y4 d! v0 ]
4 V7 Y% Y$ \$ K5.3.5 extern用法# k. [: x) u4 s' \, o+ Q
在上一小节有提到过extern这个关键字,那么这节就来详细说一说这个关键字。在C语言中,extern关键字用于指明函数或变量定义在其它文件中,提示编译器遇到此函数或者变量的时候到其它模块去寻找其定义,这样被extern声明的函数或变量就可以被本模块或其它模块使用。因而,extern关键字修饰的函数或者变量是一个声明而不是定义,例如:
% e) F- d" C4 q0 Z% H0 ]5 B9 `5 `6 [: j& e, u9 }7 E4 j* L
- /* example.c */
0 F/ Q, \6 R' v( w
# V2 k0 {" @/ D3 H0 \1 V- uint16_t a = 0;
7 @1 X. L( X8 T/ v: U" I
( V( p0 G3 e4 W# T9 Q% y5 g- 8 ]" x- w4 z8 |; B
9 l" ]. F2 _0 f' G0 x; N; O- uint16_t max(uint16_t i, uint16_t j)
. d0 U5 a5 ^: w9 d - * B! W5 O0 u: h5 Q) C8 l+ d; u
- {
% C: |6 S) o1 |. z, E9 |" q - , J- g k# `5 j* c ?& r5 z, z
- return ((i>j)?i:j);7 z8 V- Y( W" D; y
- 7 t1 X9 }' u- p' k; M5 f. H
- }
- /* main.c */
# U# a. j x# h6 H2 Q V/ n
5 E1 K4 ~5 R3 {/ q0 g- #include <stdio.h>7 W, V6 C/ a: A. [$ B# v
- " Q- w& p5 |+ a
; q" Q8 B3 q, R7 I0 T- , M# I4 |& b8 @" W, o
- extern uint16_t a;
1 p5 a& c; x: p/ d" R - 1 A; I, o0 t8 z( F
- extern uint16_t max(uint16_t i, uint16_t j);
/ ?8 y/ W: ]" I - , l' U& i5 K8 \3 _; {
5 e. R+ T0 T; N0 U6 A# M- ) o3 Z9 |7 Z' X, h* b# U$ W+ l
- void main(void)* L6 j8 O& } `5 \
5 |, _0 w% p3 e, ^2 m0 l) f/ ]- {2 x5 y5 K7 I2 ~4 A8 y- \0 I
' a4 t5 r5 V: Y( Y% ~; B, D- printf("a=%d\r\n", a);
+ b% v8 a/ n3 @3 W. |0 H% F
% H' O$ Z8 r+ c2 N+ |- printf("Max number between 5 and 9: %d\r\n", max(5, 9));
* h9 L: ^; t9 n6 N6 ]' b
1 z0 D8 Y/ Z) W, z- }
extern关键字还有一个重要的作用,就是如果在C++程序中要引用C语言的文件,则需要用以下格式:! K% E4 Z8 u( e* y
9 Z! m* J. U& H* Z. f9 G- #ifdef __cplusplus
+ p0 O7 a1 l% t) O' J* m
0 W" W/ g1 w7 K: `; F E- extern "C"{" i1 v1 ~, d: ^0 R
+ V3 U9 _4 x- F& {, \0 i: ~9 I- #endif /* #ifdef __cplusplus */ J2 o$ \$ U% E8 l3 B! `
- + A. ]! e( W# F& E5 w% W+ I/ Q! }
- ......* S/ l" ^) @4 i
- I# V9 j7 ]: r; S& ^- #ifdef __cplusplus5 _$ c: |8 f3 u% N5 r$ Q X* L
y& N" @: h/ ]8 J Z: V) x- }: x* I. c1 s+ ~8 A1 S+ H
- ! L" i! ~& i* n
- #endif /* #ifdef __cplusplus */
这段代码的含义是,如果当前是C++环境(_cplusplus是C++编译器中定义的宏),要编译花括号{}里面的内容需要使用C语言的文件格式进行编译,而extern “C”就是向编译器指明这个功能的语句。: L& \' e+ @2 d+ j0 {' _
! o" g- _, f* ] }
5.3.6 volatile用法
2 Z8 l* [" W( q3 g P" w$ Y1 bvolatile原意是“易变的”,在嵌入式环境中用volatile关键字声明的变量,在每次对其值进行引用的时候都会从原始地址取值。由于该值“易变”的特性所以,针对其的任何赋值或者获取值操作都会被执行(而不会被优化)。由于这个特性,所以该关键字在嵌入式编译环境中经常用来消除编译器的优化,可以分为以下三种情景:
8 H& q. h$ o% z
g* n9 G: g/ W) M' ]9 b; O3 @+ H/ z1) 修饰硬件寄存器;
8 L/ |- U! q- D0 `& q" [! H2 d: X9 D( X- L6 c
2) 修饰中断服务函数中的非自动变量;* U4 W8 y) C4 }2 ]0 D
% H, J1 Y" C% C3 k
3) 在有操作系统的工程中修饰会被多个应用修改的变量;
3 d% ~+ P! ]2 @$ O/ z) \
8 x2 j2 p: y- r# p- a$ b' g
! Q2 i8 M; s$ a V. [* q6 C, k, A修饰硬件寄存器
: K, e2 Y$ O1 z* O
3 B3 S- w0 E1 h3 c+ b以STM32F103的HAL库函数中GPIO的定义举例,如下为HAL库中GPIO寄存器定义:0 {) H5 v; w9 Z$ x# b @
5 Q( i2 c9 _8 H. G4 @: _6 A. t
- /**) S* y( \) z/ r( u/ u8 n
4 f |: u7 P6 f% t5 f5 B- * @brief General Purpose I/O
5 f- A- q; K, I& F4 i2 \2 y/ O G7 S
3 ] \+ N$ o7 @4 s# w1 R- */
! }2 _/ n$ n. k; \1 T& J" L - 2 j. Z8 k9 Q9 b8 Y
( T$ Y" p' K& c, ^- g, P- + |6 C+ u( Z5 T6 U5 ]5 c# w: ]0 B; e
- typedef struct
# ]2 G; m& V. n2 E1 |
) v2 o4 w7 m3 E' W- {
0 l1 A" ?6 E1 r8 Y" p4 m
, ~4 J$ l' z1 z: P) w- __IO uint32_t CRL;
5 ]' ]9 Q+ D; X* C' [ - , ` ~5 S2 M0 Q
- __IO uint32_t CRH;5 r" u1 G( w5 X: r! P* L* T9 j9 Q
- 9 I2 o* w- M# O5 [0 P, y: M7 [
- __IO uint32_t IDR;% v5 e# S4 j# L* v% U
& `" c2 X1 I' |: R- __IO uint32_t ODR;
. e9 m E/ V/ q1 a7 P - 2 p0 ~( [) Q; U* |/ u, d2 l: x
- __IO uint32_t BSRR;
0 U: `' t! c# r# E - , x! s- Y/ e1 z2 t: G) j
- __IO uint32_t BRR;; i* p6 z5 J A2 ~- _$ b
- 9 Z6 t1 c$ [/ g6 [0 W. p, ?
- __IO uint32_t LCKR;
: T% f) `5 }9 [% j% ~& X - 4 q/ K! l) T6 Y- M/ f- b$ P& s8 t
- } GPIO_TypeDef;
3 o# x5 v! |( [
其中__IO的定义是:
* _; C: s- h* j1 a) T, L
4 T; v: [: Q' M2 u7 G: v- #define __IO volatile /*!< Defines 'read / write' permissions */% G2 m/ ?, F+ t$ e
然后定义GPIO是:
1 e4 _& J; ?6 E6 A1 v- p6 J, m
0 T; c }) E( O% X- #define GPIOA ((GPIO_TypeDef *)GPIOA_BASE)
4 S7 u$ H0 H- I4 |: Z& F
3 A) M1 M7 _( c! Q3 l6 G- #define GPIOB ((GPIO_TypeDef *)GPIOB_BASE)
& D' H1 b) ]. k) R9 U# L R) q+ x( P - 7 N4 a! ]( C# P' @
- #define GPIOC ((GPIO_TypeDef *)GPIOC_BASE)
: ]$ N+ H O0 m! i - + w4 y1 c: i1 l3 O( C2 A
- #define GPIOD ((GPIO_TypeDef *)GPIOD_BASE)2 U' g& a- n3 m2 n1 ?2 X0 W
( P J, J7 t* P U" d4 Q& J9 j; B- #define GPIOE ((GPIO_TypeDef *)GPIOE_BASE)
( b2 m5 i3 p1 ~& j0 t& N - ! ?! X1 T: C$ ]6 O) w
- #define GPIOF ((GPIO_TypeDef *)GPIOF_BASE)* E! S! O3 }4 H" Y7 \% v. l
" D5 n, `$ F) e: m- #define GPIOG ((GPIO_TypeDef *)GPIOG_BASE)
5 E) s0 D2 Y. J' b+ `1 P0 U& ?6 |4 e8 R% n0 B
而GPIOx_BASE的定义是这样的:, m- b: Q/ \4 w- F8 k
# e h# Q) y7 [% ?3 \
- #define GPIOA_BASE (APB2PERIPH_BASE + 0x00000800UL)
8 `+ ~5 S1 J* p# N - ! q% h/ F: r$ N4 S8 l* t$ R
- #define GPIOB_BASE (APB2PERIPH_BASE + 0x00000C00UL)
6 j, N; f1 f5 S: y/ M* j - ! V" Z. _: O: L% A/ j
- #define GPIOC_BASE (APB2PERIPH_BASE + 0x00001000UL)
- O2 C6 L* U+ E& h - / |6 ^* k: z/ M' p+ s
- #define GPIOD_BASE (APB2PERIPH_BASE + 0x00001400UL)
7 y. Q* Z) o6 y% d# U. }) A
0 ~/ _9 `/ m. J6 g- #define GPIOE_BASE (APB2PERIPH_BASE + 0x00001800UL)
* e% P; m7 J5 H: }0 x. b' | i+ ~ - 5 X( M# z2 h: i7 \/ `
- #define GPIOF_BASE (APB2PERIPH_BASE + 0x00001C00UL)
( ]- K: q. V' e: ~) T) ^; w - ! P8 h- V0 f, T0 g$ [+ C; Q, [
- #define GPIOG_BASE (APB2PERIPH_BASE + 0x00002000UL)
其中APB2外设基地址的定义:/ t& [& w ^: z
! I3 H# z9 J1 _. P. K" R8 Z% z- O, w8 U
- #define APB2PERIPH_BASE (PERIPH_BASE + 0x00010000UL)
8 D9 ^+ }$ X. q/ h# p最后再来看外设基地址的定义:
; H+ a$ r/ m: o" m8 g
3 k! S2 I' |3 x. ]- #define PERIPH_BASE 0x40000000UL /*!< Peripheral base address in the alias region */
综合起来,将宏定义一一展开,仅用GPIOA来看,其它的以此类推:+ H5 {* v, @' s# J. r
0 O, F9 m, M: ]3 L) S
- #define GPIOA ((GPIO_TypeDef *)(0x40000000UL + 0x00010000UL + 0x00000800UL))
如此定义之后,那么GPIOA的CRL的地址就是:
5 c o( y' [1 q, H, C( r$ ~8 x6 B' K1 P& a2 X& s# F# V
- (volatile uint32_t *)(0x40000000UL + 0x00010000UL + 0x00000800UL)
CRH的地址就是:
1 c( m* e* q' O: q- |/ s+ I
I/ h9 J9 O" r$ ~' Y$ I- (volatile uint32_t *)(0x40000000UL + 0x00010000UL + 0x00000800UL + 2)
后面的寄存器以此类推,因而在程序中使用:' L8 ~1 b, K8 C3 i' w3 \
: v& P! o7 t1 G! v
2 {$ p/ {4 w! L$ J9 L6 h$ Q0 S那么实现的功能就是对GPIOA的CRH的寄存器的最低位拉高。如果在定义GPIO的寄存器结构体里面没有使用__IO uint16_t,而是仅使用uint16_t,那么在程序中再用语句:
8 I; C" x6 P# f6 s$ [. Q& v- Z" [. ]. k+ ^* [
" d8 h. [. _3 t6 S
就有可能会被编译器优化,不执行这一语句,从而导致拉高CRH的最低位这个功能无法实现;但是库函数中使用了volatile来修饰,那么编译器就不会对此语句优化,在每次执行这一语句的时候都会从CRH对应的内存地址里面去取值或者存值,保证了每次执行都是有效的。
8 p$ b" g6 h: z0 J5 E
. h' L) ~' J' o$ s在有操作系统的工程中修饰会被多个任务修改的变量 H) D, } m# c% h4 h9 r$ B+ \
) k9 i& U( m* I. }" m
在嵌入式开发中,不仅仅有单片机裸机开发,也有带有操作系统的开发,通常两者使用C语言开发的较多。在有操作系统(比如RTOS、UCOS-II、Linux等)的设计中,如果有多个任务在对同一个变量进行赋值或取值,那么这一类变量也应使用volatile来修饰保证其可见性。所谓可见即:当前任务修改了这一变量的值,同一时刻,其它任务此变量的值也发生了变化。1 ?4 [3 o0 i1 U) N/ B
/ v7 p0 Y0 \! Y$ d; h3 x N
0 B9 f |2 n" V; s. X# @
5.3.7 struct用法
+ V9 l" ]7 x/ a8 |3 I6 v设计程序最重要的一个步骤就是选择一个表示数据的好方法。在多数情况下,使用简单的变量甚至数组都是不够的。C使用结构变量进一步增强了表示数据的能力。C的结构的基本形式就足以灵活的表示多种数据,并且能够创建新的形式。( k7 k# b$ a- Y: u! o- B3 x- ]
( R, B) {9 Y g, U2 `C的结构的声明格式如下:
, K$ S9 w2 O" l, Y3 X# l
% z! i6 W; z$ ^1 x/ E4 |- struct [结构体名]$ ^5 m0 z( G- [- z
4 i* q4 l3 ]0 W( Q- {, b0 q1 W: Z1 h9 m9 X2 k" {9 z
% @. m+ M) v' ~. u0 v. {7 a6 T% h$ R- 类型标识符 成员名1;
$ \, V$ A* ]" u - . Y% H [- ?. T& k" D4 L
- 类型标识符 成员名2;0 A% d4 A5 V' @* p) c
- 2 ?) Y6 z9 `) Y# y6 R
- ., B4 N# w }$ i4 l
# D) Y4 n0 ^$ j l5 B- .
! b" P' d9 Y. C& k
5 @* f3 c& A5 m) O) e- .
3 b4 R5 H8 m7 n. C( `
2 }: f* V |9 ^+ ?* y) [' ~2 [- 类型标识符 成员名n;% j$ ~9 l6 y1 ^. {( j3 w
- 0 r4 h8 J! A' ^; ~" T
- };
, d0 C9 w3 }& C3 G9 `6 `此声明描述了一个由n个数据类型的成员组成的结构,它并未创建实际的数据对象,只描述了该对象由什么组成。分析一下结构体声明的细节,首先是struct关键字,它表明跟在其后的是一个结构,后面是一个可选的标记,后面的程序中可以使用该标记引用该结构,因而我们可以在后面的程序中可以这样声明:
% q4 M3 X) X, l. M* i7 I. o
" f% a) F& E* M+ `+ Wstruct [结构体名] 结构体变量;
- ]8 V1 P. r% }( b3 Z在结构体声明中用一对花括号括起来的是结构体成员列表。每个成员都用自己的声明来描述。成员可以是任意一种C的数据类型,甚至可以是其它结构。右花括号后面的分号是声明所必需的,表示该结构布局定义结束,例如:
( t8 [! ~: L: I7 G! J$ v( @0 W5 ]' g& ?/ Q* b
- struct students
1 u2 p( Z$ q! y" y - ( h2 P8 v' n7 H$ `
- {
6 j+ r5 ?/ x! `1 a2 i! c! N - ' S; O7 s% }* |/ S7 O
- char name[50];
+ E3 J# n# ^* | r+ m/ ^7 m' f
& m: S* \/ a& n R- char sex[50];
( I9 \4 l; D9 p' g5 B9 X - 4 T7 [" I; N& n: T+ Z0 T
- int age;
5 |( \5 G* h# Y0 H
" a7 Q2 f% X6 P; k- float score;
- L5 i5 Q& D3 E o# S - $ j; t' o% K: X. F
- };6 P+ q6 o8 r6 m) G9 S! W, M
- 3 U! |1 G8 {% F( d
- + {: {1 Y4 t S( H5 `6 r
8 f8 A5 E3 |1 z. } _6 O- int main(void); ]6 C* ]. |* d6 M' z; O1 |' {
- - }/ Y- P' r! i, C- f+ A; A: p
- {
' I3 v7 T1 B3 ?* u6 @7 ] - 8 r2 s: H: Y9 V1 u
- struct students student;
) [, y+ b" o) K- I# N4 T! |; n5 ~ - ; o; B3 H( I( s, }0 J
- printf("Name: %s\t",student.name[0]);
1 _5 h9 B" ^6 e; o( Q
, x+ F$ E; u+ R" ^4 Z- printf("Sex: %s\t", student.sex);3 S8 B8 p; k5 O! x$ E4 B
/ r4 ]4 D( a! V- printf("Age: %d\t", student.age);
+ x, }6 a$ j+ m2 s, i; S4 Q - 8 M4 c' H: t+ v% e4 x
- printf("Score: %f\r\n", student.score);
( f# F8 I$ ]! F - 3 A- A( |( z% B
- , C' _- A6 j8 G# I# o. ^' c
- + t4 f5 b" R/ b9 Y, ^/ d
- return 0;" p6 R/ g9 A# Z6 c# r
- ( A' v3 v8 g1 ]0 W0 y. Z
- }
可以把结构的声明放在所有函数的外部,也可以放在一个函数的内部。如果把一个结构声明在一个函数的内部,那么它的标记就只限于函数内部使用;如果把结构声明在所有函数的外部,那么该声明之后的所有函数都能使用它的标记。
, j! p3 }; o, o6 D5 }. u, o. s, Q" E! {' B8 E! Q$ \0 K
结构有两层含义,一层含义是“结构布局”,如上述例子的struct student{…};告诉编译器如何表示数据,但是它并未让编译器为数据分配空间;另一层含义是创建一个结构体变量,如上述例子的struct students student;编译器执行这行代码便创建了一个结构体变量student,编译器使用students模板为该变量分配空间:内含50个元素的char型数组1、50个元素的char型数组2,一个int型的变量和一个float的变量,这些存储空间都与一个名称为student结合在一起,如图 5.3.3 所示。# \5 F5 i; D- `0 v( W3 |
/ j* `2 y6 r3 q9 _+ {# }& v! V
![9O$AGKAY8Q]AB4HW{`5%URM.png](data/attachment/forum/202204/27/112408sus1968p139whkj3.png "9O$AGKAY8Q]AB4HW{`5%URM.png")
2 G# }+ l( Q# p
0 Y3 X( F$ \, ^( j图 5.3.3 结构体存储示意4 `- g3 S1 J' F7 b1 n6 J9 `
& V, J" Y+ K) v
% H4 F! l. V" f/ L' n在内存中这个结构中的成员也是连续存储的。在通常程序设计中,struct还会与typedef一起使用,具体的会在后面的《typedef用法》一节介绍。
, z6 {% e3 t: m) f& m o+ j. ?8 w* @
) `$ q# b0 V5 a/ w- \
5.3.8 enum用法
0 J6 a9 }* G- @! nenum是C语言中用来修饰枚举类型变量的关键字。在C语言中可以使用枚举类型声明符号名称来表示整型常量,使用enum关键字可以创建一个新的“类型”并指定它可具有的值(实际上,enum常量是int类型,因此只要能使用int类型的地方就可以使用枚举类型)。枚举类型的目的是提高程序的可读性,其语法与结构的语法相同,如下:
& J" x% A+ V7 g* `2 O4 b5 i ?2 I: n! b' N6 p7 m
- enum [枚举类型名]; i! A# I" u& y5 V1 Y
- \& S2 c v: e3 Z( r: Q7 c- {
$ ?' Z& u) v7 g1 O: U) L
' X5 h+ c, B4 B- 枚举符1,. Y' ]" E, T! f% ?* T% j
- 1 o! s& W- z+ L) x8 E
- 枚举符2/ V0 l7 p& s e }7 Y: _: l2 Y
- . L' b+ q. O, ?+ ]; @4 H1 D W d
- .
% V5 S8 K# V2 E. |) F& }+ Q1 q: { - 1 @: `% M; N; `; v
- .
0 Y' T; D( t4 i4 J7 l0 ^0 e1 |
+ ^# W1 T* ~5 z* }. `# x- .
. @' G- g& C9 b( `& g6 G% L+ z T
5 b/ c9 C5 ^! \# [4 u- 枚举符n,; O: a! A: K4 I) E6 K8 @, f
- * B" j/ ^ B1 b+ o/ R
- };
# n) l& F8 I7 U# L# b/ D例如:7 K: S& G, ^2 M2 ?
$ R. i; ?( p- w( V% O0 U
- enum color
) z, A. S$ ?% a4 X i9 B' l
( q5 c& i. D0 }: L+ V- {
6 F, c( D! n) [4 m: E
$ h5 q: Q j1 @! H- red,) q- Q& Z- W0 e8 U3 N( I
! q0 Y; D5 B" j2 \! p& P) O- green,
/ y/ G' j/ L1 M( U3 J; s - ) Q! e% I1 E! s0 O# N/ T
- blue,; @- K! Z) n* e7 B0 o8 k! `
6 a! L, D: f( z) c1 w3 }6 W4 x9 R- yellow$ F) O6 }! G1 ~5 Y/ i+ _2 Z
+ F! g6 Q7 E' L) f. R9 e4 g! m- };$ [3 d/ ?# i( H9 V
2 D& T5 R' U) T8 r+ N7 }) lenum常量
! e. M6 l) J9 W* M2 J: p+ K# q; ~; M2 [0 ?, x2 Z7 o: Y
在上面的例子中,red, greeb, blue, yellow到底是什么?从技术层面来讲,它们是int类型的整型常量,例如可以这样使用:
9 j9 M, {) y" g# z) A! Z1 Q
, Q$ l7 n& X) J4 p% o, j- printf("red=%d, green=%d", red, green);
8 F. r: ?6 ?$ ?; G可以观察到最后打印的信息是:red=0,green=1。
2 A. g% \) O% @- ?5 G& ^( J" b9 X0 U1 {9 k/ F, o: y6 _
red成为一个有名称的常量,代表整数0。类似的,其它的枚举符都是有名称的常量,分别代表1~3。只要是能使用整型常量的地方就可以使用枚举常量,例如,在声明数组的时候可以使用枚举常量表示数组的大小,在switch语句中可以把枚举常量作为标签。8 G B8 k/ c, r, A! K; e% X3 N( K
+ z5 n0 g- w! }/ [" m7 b
; l3 {2 F9 j6 A/ y
enum默认值9 Y# i: Z3 v" w# b6 f' g$ V) |* X
6 _1 U2 O% J4 y. g. @$ P
默认情况下,枚举列表中的常量都被赋予0,1,2等,因此下面的声明中,apple的值是2:- enum fruit{banana, grape, apple};
# E+ {7 z- K. u0 Tenum赋值
3 i0 V0 K4 A$ Z, O- T# o7 F* i3 z9 l5 `6 z/ x- H4 c2 a
在枚举类型中,可以为枚举常量指定整数值:) K1 y# ?( R* ~2 v! [, |" h
; w. a+ m; @" a
- enum levels{low=90, medium=80, high=100};
( I) ~! S# ^ L9 V z, ]% v如果只给一个枚举常量赋值,没有对后面的枚举常量赋值,那么后面的常量会被赋予后续的值,例如:
, C8 g3 U O3 e$ {6 N# n! b9 P8 D3 u, i
- enum feline{cat, lynx=10, puma, tiger};
' I! r/ l; \. b/ f( ]/ ~0 [, V那么cat=0,lynx、puma、tiger的值分别是10、11、12。
7 Y, l" R; f9 b2 H( C- f p+ i4 g+ J, W- j; N
5.3.9 typedef用法
* i$ U) {' c: E! L, Rtypedef工具是一个高级数据特性,利用typedef可以为某一类型自定义名称。这方面与#define类似,但是两者有三处不同:
! ~9 V- f. K! m0 I, N0 P. D
6 x8 t1 R, i. e; H8 q. @, w- z1) 与#define不同,typedef创建的符号只受限于类型,不能用于值;1 f' \9 P+ A0 p/ b
" U6 L# _3 e; ]1 ?, b2) tyedef由编译器解释,不是预处理器;
' u3 X; h8 a9 s0 f
1 z$ y* C( \/ A- _9 O j' I3) 在其受限范围内,typedef比#define更灵活;
) q4 j3 S- F6 m
4 u/ ` H e+ x8 `5 d8 c$ `假设要用BYTE表示1字节的数组,只需要像定义个char类型变量一样定义BYTE,然后再定义前面加上关键字typedef即可:
( P7 l" E3 u6 S6 n' C' Z6 x* A
6 M* z2 r* T% \6 Y( x! ^- typedef unsigned char BYTE;
随后便可使用BYTE来定义变量:2 O( G7 o# i/ {( k. X6 g/ A$ p
, q( w4 W. k# T/ t$ d
, I9 |7 P# @. M i. m该定义的作用域取决于typedef定义所在的位置。如果定义在函数中,就具有局部作用域,受限于定义所在的函数。如果定义在函数外面,就具有文件作用域。
5 d# h R+ {; i1 v1 Y8 ]3 k% L$ |
$ e; P3 b a: C为现有类型创建一个名称,看起来是多此一举,但是它有时的确很有用。在前面的示例中,用BYTE代替unsigned char表明你打算用BYTE类型的变量表示数字而不是字符。使用typedef还能提高程序的可移植性。
0 h$ B9 ?+ |. d3 H. R }
* |1 t4 v1 k% i: C; b2 h用typedef来命名一个结构体类型的时候,可以省略该结构的标签(struct):- T: u. {; X/ A& x: l: `, R5 }
% p6 e# ?. \" D; R- typedef struct* c& B# Z: ^, D
* k" ^, C1 f" P7 i% v' }- {: P1 X; n, _4 N) A5 v, y
( E5 K7 z/ ?( i" I. ?- char name[50];
* c9 v0 J D& Q9 X2 i" a# | c
+ j$ X$ v" o# k- unsigned int age;
) M& w7 Y5 [; m1 ?) U
6 i0 a2 l- L4 ~4 v& T+ \- float score;
; a: R) ^ U" x4 v1 W. P - : T( \3 }" ]9 }
- }student_info;! x& A2 o3 S, \$ t9 E( U
- ' R; Y- U/ v" F( t0 ~9 y' M
0 c, w* g6 N, ^2 Q' Z J, }: Z- 8 Z4 a% m9 m, U: ]% @; D9 k9 o
- student_info student={“Bob”, 15, 90.5};
这样使用typedef定义的类型名会被翻译成:( h; U" y8 v; o' X- @" I0 X' M
+ l$ K- {: R! ]$ K+ l4 L- struct {char name[50]; unsigned int age; float score;}
7 K$ h" T Y7 R1 D- Q9 F4 a5 e - : W1 \' P- K) J Z/ P7 Q9 U q
- student = {“Bob”, 15, 90.5};
5 t6 A: G- P( j3 ]3 }+ A2 c6 `( u使用typedef的第二个原因是:tyedef常用于给复杂的类型命名,例如:% \6 ^3 C% ~ @/ X$ N- X+ B1 H
9 L, M. n3 e" @7 N
- typedef void (*pFunction)(void);
把pFunction声明为一个函数,该函数返回一个指针,该指针指向一个void型。
9 J* v/ Y0 @( Z2 L0 s2 k2 q- l4 E% M
使用typdef时要记住,typedef并没有创建任何新类型,它只是为某个已有的类型增加了一个方便使用的标签。
8 |: d/ g0 ^! r2 N* D
- d, G' N4 j* @4 u
2 i6 h9 i0 q9 e* o6 a- F$ a0 r5.3.10 预处理器与预处理指令) O% V i; f3 {* K: B6 p0 x' ?8 {+ E
本节将简单介绍C语言的预处理器及其预处理指令。首先是预处理指令,它们是:
" P/ g! C r) S& f0 d; b, _. W+ J o
- #define、#include、#ifdef、#else、#endif、#ifndef、#if、#elif、#line、#error、#pragma
$ _+ a4 F& q5 A- Y在这些指令中,#line、#error、#pragma在基础开发中比较少见,其它的都是在编程过程中经常遇到和经常使用的,所以我们在后面的章节将主要介绍这些常用的指令。2 R- Y5 o0 y3 P3 [/ b5 t
) B# ~* R% Y) b7 ?; `: _C语言建立在适当的的关键字、表达式、语句以及使用他们的规则上。然而C标准不仅描述C语言,还描述如何执行C预处理器。1 W6 p9 O, L; @3 I) _+ G$ J
! f& `' w; k7 b% c1 u" J
C预处理器在执行程序之前查看程序,因而被称之为预处理器。根据程序中的预处理指令,预处理器把符号缩写替换成其表示的内容(#define)。预处理器可以包含程序所需的其它文件(#include),可以选择让编译器查看哪些代码(条件编译)。预处理器并不知道C,基本上它的工作是把一些文本转换成另外一些文本。" o7 `8 n4 X& Z/ l) M
3 O- B& W3 n( o% p2 H由于预处理表达式的长度必须是一个逻辑行(可以把逻辑行使用换行符‘\’变成多个物理行),因而为了让预处理器得到正确的逻辑行,在预处理之前还会有个编译的过程,编译器定位每个反斜杠后面跟着换行符的示例,并删除它们,比如:& ^& j) L! `" j: h7 Q
) t- s4 M# T$ U5 q2 s! \
- printf(“Hello, Chi\
. G7 }2 y2 Y/ E - 3 E q z6 r$ l6 K; y. \
- na”);
转换成一个逻辑行:4 \% R/ V7 ~, V; U( _
; p' I# d( _8 t( Z' L! v6 A
" V) |4 p5 f m
另外,编译器把文本划分成预处理记号序列、空白序列和注释序列(记号是由空格、制表符或换行符分割的项),需要注意的是,编译器将用一个空格字符替换每一条注释,例如:
# \% e5 k4 x) K6 G: Y. c- V% q7 ?; z. C4 G& S; ?$ @/ V
# D$ x: n/ y0 Z2 C- i5 p2 K将变成:
: ~/ z# Q0 `& I) L6 l
* X' x4 \8 e8 b; | d8 {
, A Y* [6 M! `- I3 W+ S9 {% G这样编译处理后,程序就准备好进入预处理阶段,预处理器查找一行中以#号开始的预处理指令。然后我们就从#define指令开始讲解这些预处理指令。
@- w% b! W1 e( W& Z. a9 A9 o) L' T) N5 U. N" t) T" A
5.3.11 #define与#undef用法
& R* b* |/ u4 m7 Z" H. ~#define预处理器指令以#号作为一行的开始,到后面的第一个换行符为止。也就是说,指令的长度仅限于一行。然而在预处理开始前,编译器会把多行物理行处理为一行逻辑行,例如:- #define STRING “I am Chinese, \7 u; J" }. }8 ~; y) k6 ]
% B/ ^3 d" x8 ]' t& @- f- I love China.” /* 反斜杠把该定义延续到下一行 */
每行#define(逻辑行)都由3部分组成。第1部分是#define指令本身;第2部分是选定是缩写,也称为宏,有些宏代表值,例如:
2 v2 T; W: S+ U4 Q8 t8 q' z K m# X
- #define PX printf(“x=%d”, x)
& q }9 R0 b5 k. I这些宏被称为类对象宏。C语言还有类函数宏,在后面介绍。宏的名称中不允许有空格,而且必须严格遵循C变量的命名规则:只能使用字符、数字和下划线字符,且首字符不能是数字。第3部分称为替换列表或替换体。一旦预处理器在程序中找到宏的示例后,就会用替换体代替该宏。从宏变成最终替换文本的过程称为宏展开。例如上例我们如果使用:8 O: ]" H& o/ O2 N* |
- ^8 U; _" o" \; c
- int x=2;2 j" c: M: I4 c k5 c
2 o- r- i: U' S- PX;
3 D+ n2 @, ?: y8 c0 ^( i1 E就会被预处理器展开成:
! I5 z I8 n. O
+ O+ k# W& h4 h# z: U% b- int x=2;% F7 w% h' b3 d- M: [
- 3 e. i* X; z! w2 ~. N. w. y- Z
- printf(“x=%d”, x);
7 \. F& s l. S' W! n4 b' C) R9 \最后输出的结果是x=2。, {/ C9 z/ x( ?) F6 ^' q: w
5 J) j1 L! i7 C6 G可以看到宏可以表示任意字符串常量,甚至可以表示整个C表达式,例如下面整个取绝对值的宏定义:
) G5 z5 R& {* A$ D; K0 O/ S
5 A2 V6 b6 G# O' G1 e7 u8 f" {3 D- #define ABS(x) ((x>0)?(x):(-x))
J) H9 L- t3 o宏展开有个值得注意的点是:预处理器会严格按照替换体直接替换,不做计算不做优先级处理,例如下面求取平方值的宏定义:
/ u* _) w) q3 L5 e |& l5 A1 r6 K1 e& }
& t2 `$ ~0 z; c5 I& b$ b
我们假设这样使用:
8 v+ d. L% O- r- i
8 Q- i! l% r5 w, J- printf(“2的平反:%d”, sqr(2));
输出的结果为4。
) `' W/ b4 x+ v+ M: g9 D' p2 G9 y- D& L! g
但是如果我们这样使用:
# b% E2 d( g* ~. s. a6 w$ j+ X% `: S+ s% e8 l- w6 T; j" v
- printf(“2+2的平方:%d”, sqr(2+2));
那么与编译器就会这样展开:+ {' h8 L8 X% j' J1 A9 o6 x
; s0 {5 b9 g1 I) V0 o- printf(“2+2的平方:%d”, 2+2 * 2+2);
1 U0 B8 |$ N# @ j) i- W8 g: a! c输出的结果为8。, u6 N/ w) P0 N* ^# ]2 c5 E: @7 P
3 i5 {- Y3 _ c, J+ J* M, _* r但是实际按照逻辑2+2的平方是16,得到8的结果是因为前面所说的预处理器不会做计算只会严格按照替换体的文本进行直接替换,因而为了避免类似的问题出现,我们应该这样改写平凡宏定义:
2 a; ^9 }& B) _: p0 ^% w
- y1 S: H" d; q m. e
6 o! \, s) U7 u- g9 h0 I这样上述的2+2的平方的例子就会被展开成这样:
) h5 H, b7 |! w) F" F! O9 p% B0 ~" o7 [7 a) _7 a" f0 ]( R# \
- printf(“2+2的平反:%d”, ((2+2)*(2+2)));
就会得到正确的输出16。+ a0 S( V( c$ Y& Q/ J
% X$ m. K, v. }; Z
上述的求取绝对值的宏定义或者求取平方值的宏定义中我们可以看到其形式与函数类似,此类宏定义就是前面所说的类函数宏。类函数宏定义的圆括号可以有一个或多个参数,随后这些参数出现在替换体当中。
, m6 j1 Z" b n. N' m4 v* q% H1 Q3 z8 o! i" o
#undef指令用于取消已定义的#define指令。7 k# v' q' b0 H0 q1 s) H E& Y
0 J. @. B; D3 j; j" e
5.3.12 文件包含#include
: f9 e( w' K& x. e o- h9 d当预处理器发现#include预处理指令时,会查看后面的文件名并把文件的内容包含到当前文件中,即替换文件中的#include指令。这相当于把被包含文件的全部内容输入到源文件#include指令所在的位置。/ N5 a6 f3 o0 P2 o4 K9 z
9 N [- _2 A [* A) b8 I- #include指令有两种形式:+ H) X" e* a$ U- s
- 6 K1 S, d7 w( v
- #include <stdio.h> // 文件名在尖括号内
' z; y; x3 O' u+ f" ?1 X - ; J. p- \& ~- N
- #include “myfile.h” // 文件名在双引号内
在UNIX中,尖括号<>告诉预处理器在标准系统目录中寻找该文件,双引号“”告诉预处理器首先在当前目录(或指定路径的目录)中寻找该文件,如果未找到再查找标准系统目录:
( r" Y% y3 s/ F+ Z) i, Y3 c& n- j7 B) S( W) b+ V
- #include <stdio.h> // 在标准系统目录中查找stdio.h文件
7 D. d. x3 x( j - 4 }9 u8 \8 c4 a2 W4 r# X# V
- #include “myfile.h” // 在当前目录中查找myfile.h文件; L) G l3 r+ W- ^8 N% M9 x* g
- / \1 @6 D$ g8 D% H4 d- P
- #include “/project/header.h” // 在project目录查找6 b1 H. T) Q, G2 j) w8 f
! M9 t9 S7 ?1 [+ }; c, q T6 H- #include “../myheader.h” // 在当前文件的上一级目录查找
集成开发环境(IDE,比如开发板的开发环境keil)也有标准就或系统头文件的路径。许多集成环境提供菜单选项,指定用尖括号时的查找路径。0 o- P: e4 [& h
) U% A. B3 l4 c v* C# u3 s" f" _
为什么我们要包含文件?因为编译器需要这些文件中的信息,例如stdio.h中通常包含EOF、NULL、getchar()和putchar()的定义。此外,该文件还包含C的其它的I/O函数。而对于我们自定义的文件,对于嵌入式开发来说,可能这些文件就有需要使用到的某些引脚宏定义、简单的功能函数宏定义等,以及某个源文件的全局变量和函数的声明等。
' n; A& Y( ^3 }3 G2 W# H/ \% Y5 w+ a0 D) w
C语言习惯用.h后缀表示头文件,这些文件包含需要放在程序顶部的信息。头文件经常包含一些预处理指令,有些头文件由系统提供,也可以自定义。, Q4 o/ H! r$ a' o0 q; G
! ~6 K" b1 q1 k( b
下面是一个子自定义一个头文件的示例:gpio.h, main.c
* H/ c" m/ S. W! S/ i1 @
. p9 J K! h" Z4 p. {- y! r$ J- /*gpio.h*/
- h% E. Q. |) p d/ [ - ! u: n" A9 s) R5 w2 R1 _
- #ifndef __GPIO_H
' p5 f6 `* a+ H$ Q+ m3 a8 U! a3 V; u: i- s
* o2 V$ R6 w" W& ]- #define __GPIO_H7 { m$ J2 h8 N# c7 M4 ^0 V
4 a/ b S' {% l) x3 N N4 v- #include <stdio.h>
) y8 G: B S6 L# X - : L' U5 Q7 [+ R% b
, T0 O" @6 k. G5 A w! d. x- % @) |0 q2 @# |6 Q9 p8 r6 A& x. \+ S
- typedef struct( H, e0 l9 \! z( [- g+ U/ G
- ; U; j/ l2 D; c8 a# N2 Z! U
- {
4 P5 A) C) c- Y
, G& d! m7 ]) T$ M# P- uint8_t cnt;$ \: a% S( Z j) Y0 |4 T) G* I
; F" X# f$ i! c5 E4 C8 `- uint16_t sum;; u7 n: f& @' V
- / ~, F+ {+ e% }
- float result;, x# ^/ r7 _; o8 ?, _) S. r: x
$ g, C5 _+ n8 S' v+ O2 t! y- }MyStruct;
: m! ?& `% E+ U- R
9 \/ ~% ~9 Y) m! X' o- + O ?$ ^8 O- k- ?
0 q7 P' B* R, z, @3 s* R: ?. u- typedef enum
' e2 ?4 y& y/ Q8 G: D7 r
4 g8 \5 }% ~4 K9 e) u4 ]- {
! l/ ^$ x" A* S( A - " K& m: m' w# y# I2 ]2 o
- GPIO_RESET = 0,) B, |* \# R% {1 C7 @5 B) {
9 ^. _3 T; R, H0 t l( v- GPIO_SET = 1,+ X) L5 c/ y6 c* v
- $ H' { |3 c3 h
- }GPIO_STATE;
& L) N- l6 {: X6 r9 T
3 {8 y9 H2 Y% N6 n
9 A3 o' O; [& n2 T5 P
7 y1 Q- }% C$ n5 }: g6 F- #define ABS(x) ((x>0) ? (x) : (-x))5 G. d6 _. H" g
5 `' U# L) v' ~9 z+ N$ H/ ^. J- #endif
- /* main.c */( b. ^+ n7 c& T7 H6 u. Q( V
) S% n6 |$ l" R- N, V5 P7 Z- #include “gpio.h”
' D; k- Z& u8 w* a. S
* E4 K- E% K7 V7 @- int main(void)7 b0 f7 ~7 J- f* i4 q6 e( ~! v4 ]
+ V! r( V9 Y2 j O- {
2 c( d& J) u4 s+ v3 l$ z - 5 K4 E0 j0 [. U# a2 o6 f+ K* J
- MyStruct my_struct = {0, 25, 3.14};7 u ?/ ^" J" x. f6 X
6 K+ Q- W5 ]* Q' C- GPIO_WritePin(GPIOA, GPIO_PIN_0, GPIO_SET);
2 P& ?8 Z* k u: Y - . t5 u, H7 Y' A8 a6 P, I; n
- printf(“cnt=%d, sum=%d, result=%f\n\r”, my_struct.cnt, my_struct.sum, my_struct.result);. l4 d) L5 U; {% i
9 y+ m/ d% Z- z8 u; b R- }
#include指令也不是只包含.h文件,它同样也可以包含.c文件。
& X0 j3 U; P8 d' j1 `; K6 K5 v8 r" H' F; }/ m
5.3.13 条件编译1 J! Y- i: U* {! B+ [* N
可以使用预处理指令创建条件编译,即可以使用这些指令告诉编译器根据编译时的条件执行或忽略代码块。
* J5 a+ s6 l' q) |% l6 I/ {/ `; h8 T' c- G, ]4 a2 K
1) #ifdef、#else和#endif指令0 x* x; q, ^! S0 j7 f8 j# f
5 E& w1 O- M. }( W8 U9 G# X' W0 \ ~
我们用一个示例来看这几个指令:8 @ j' a( R1 C- u d8 o
" ~2 z% k: A8 W
- #ifdef HI /* 如果用#define定义了符号HI,则执行下面的语句 */
1 Q8 v2 O7 D4 P# N* X; O' J
5 \5 r& C) `( p; X' r- #include <stdio.h>% E+ J1 w3 u( @5 n6 o2 j
) @7 w7 S3 q3 Y4 L& N6 X- #define STR "Hello world"
' ?9 N* d. L* S' p - # Q. w. f% F: i, D! w/ b
- #else /* 如果没有用#define定义符号HI,则执行下面的语句 */
! b9 P- A$ l$ t8 C' }6 J3 l; E: Z - 9 @% y0 I- h# w' B* P. M1 Q( S
- #include "mychar.h": V9 A( i) m/ W( e
. x/ _" P/ z# X0 w- #define STR "Hello China"
* z: q2 f5 @/ {: W) N
# D j) M; z8 i# D5 o$ g- W! N# `- #endif
' t1 Y6 P" ~# Q" Z: \% a( ?/ n#ifdef指令说明,如果预处理器已定义了后面的标识符,则执行#else或#endif指令之前的所有指令并编译所有C代码,如果未定义且有#elif指令,则执行#else和#endif指令之间的代码。
( j4 J; B I; Y+ M+ N7 U- q3 g& l6 h" y0 o, N' f5 w* p* e# [! g# o
#ifdef、#else和C和if else很像,两者的主要区别在于预处理器不识别用于标记块的花括号{},因此它使用#else(如果需要的话)和#endif(必须存在)来标记指令块。
9 t, C2 R4 U/ ?8 \) _1 p4 i- z9 r" _
+ _" \9 A; x1 Z* m( {2) #ifndef指令
' ?, N: M8 z, s3 r
( Q9 y% w% T5 e! C4 c#ifndef指令与#ifdef指令的用法类似,也可以和#else、#endif一起使用,但是它的逻辑和#ifdef指令相反。
/ X' e+ X' |4 V/ |8 X ?4 Z$ |1 u5 Y% V
5 x7 O9 x" R, G* I9 q1 V
3) #if和#elif: q* g1 ^- H' [
+ B$ x r1 v) E# ]& o( x T
#if指令很像C语言中的if。#if后面紧跟整型常量表达式,如果表达式为非零,则表达式为真,可以在指令中使用C的关系运算符和逻辑运算符:% V* [1 a2 ^: R% p$ F
! m" l7 s3 h3 ]* u- #if MAX==1
" y# c. o# M: i! q0 t" i+ E - 0 [3 M8 @5 x. P1 ^8 ?0 y0 b/ n2 q2 i
- printf("1");2 P5 r( G2 K; M5 c5 |* a
+ F- r; I9 K; r1 X4 r- #endif
- |9 V* I0 R* i; C: g. g. o1 [/ r
$ {/ _$ t( V' m+ u/ r0 j% @/ I- 可以按照 if else的形式使用#if #elif:' l( U' { z: o! j5 g( s% b
- $ c3 [ D6 b Z$ ^$ g5 g g' b
- #if MAX==1) S0 X7 K8 o9 w* f
- ) ^4 X7 j. U" _/ s9 S2 v
- printf("1");& q1 x2 k$ w& A8 i5 z) h$ X$ K
- 8 e" A; F1 S. v
- #elif MAX==23 ?/ P+ S: J! [/ L7 u
- 5 ?8 P3 N3 J5 h: N2 p4 D$ q) S! f
- printf("2");
/ I+ w/ W7 s1 B! V( V
1 Z4 R- `) E U0 H* i. @- #endif
条件编译还有一个用途是让程序更容易移植。改变文件开头部分的几个关键的定义即可根据不同的系统设置不同的值和包含不同的文件。
5 B& S% K4 E% p3 I8 W; v; V$ a1 P9 a9 P4 H
p* f$ h% H0 s8 d. h- \
4 p2 ~) l7 q% x3 r" V
5.3.14 指针用法9 o, H- F8 Q4 W/ x
什么是指针?从根本上看,指针是一个值为内存地址的变量。正如char类型变量的值是字符,int类型变量的值是整数,指针变量的值是地址。
2 f, m; O/ T; L0 {9 J, X4 ?
) N4 n6 K1 x" J! M3 ^7 Y. y: L5 d+ X Y因为计算机或者嵌入式设备的硬件指令非常依赖地址,指针在某种程度上把程序员想要表达的指令以更接近机器的方式表达,因此,使用指针的程序更有效率。尤其是指针能够有效地处理数组,而数组表示法其实是在变相的使用指针,比如:数组名是数组首元素的地址。+ |; d3 h8 n+ v8 m8 R
: i% m* C: Q. y9 b4 k
要创建指针变量,首先要声明指针变量的类型。假如想把ptr声明为储存int类型变量地址的指针,就要使用间接运算符*来声明。5 a* |; _, P6 }9 q9 Q
/ L. _* q! H; _9 k$ V
假设已知ptr指向bah,如下表示:/ o6 e1 X2 H8 R$ I f8 {
! z$ j# H( a( ]- J# Y7 ]
( D6 v- H9 U# Z: G2 h: O然后使用间接运算符*找出储存在bah中的值:value = *ptr;此运算符有时也被称为解引用运算符。语句ptr=&bah;value=*ptr;放在一起的效果等效于:value=bah;7 z7 I% W; I1 o% z; @
+ [7 I9 v8 T1 e: ]0 ~$ T. P n& ?2 N
那么该如何声明一个指针变量呢?是这样吗:/ |6 s% E* H: Z7 B7 W9 q: C2 y
4 ]! F7 [7 S% t1 l+ `- pointer ptr; // 不能这样声明一个指针变量
8 ~0 o: F5 |4 N, @& I/ n) ]为什么不能这样声明一个指针变量呢?因为声明指针变量时必须指定指针所指向变量的类型,不同的变量类型所占据的储存空间是不同的,一些指针操作需要知道操作对象的大小。另外程序必须知道储存在指定地址的数据类型。例如:, O# a& V% T* I) F( t
" C+ N% {6 ]; F9 |) b' a- int *pi; // pi是指向int类型变量的指针; \6 K4 {) u( ~" t0 J# K2 _
" N. T1 x3 l/ N \! l! H- char *str; // str是指向char类型变量的指针
( d$ f0 ]* z' O6 |- r0 u( A& n - ' f$ h7 H. ~4 G& w F
- float *pf, *pg; // pf, pg都是只想float类型变量的指针
类型说明符表明了指针所指向对象的类型,解引用符号*表明声明的变量是一个指针。int *pi声明的意思是pi是一个指针,*pi是int类型,如图 5.3.4 所示。
4 I% {3 m2 M9 }0 ~. y# [( P5 W: I- \! c/ @5 h
![5L2DUOZP4D03L]K2B6F%3~N.png](data/attachment/forum/202204/27/112409a5uacb2kaa5pbfpf.png "5L2DUOZP4D03L]K2B6F%3~N.png") " _3 B( [ J5 o+ C) w1 o
) f" c3 _- `3 X$ b: E" l: Y
图 5.3.4 声明并使用指针
" F1 n/ X1 j7 R7 v+ ~* W7 F( C" T
这仅仅是指针的简单使用,实际指针的世界千变万化,丰富多彩,纵使多年C语言开发的老手,有时在面对指针的使用也会出错,后继者更应谨慎求索,后面将会对指针常见的应用和注意事项进行介绍。% s* j# b! i+ K, W
" h1 x+ `4 E6 H" J8 w
1) 指针与数组! |8 i/ }/ A5 V. A6 x# B0 c
! a |1 j) A1 B* j前面提到可以使用地址运算符&获取变量所在的地址,而在数组中同样可以使用取地址运算符获取数组成员中任意成员的地址,例如:
& n/ t9 O! n) J& z- J' T) M) M9 l8 o( A+ d; N. M; W
- int week[7] = {1, 2, 3, 4, 5, 6, 7};
9 e6 s( E. b. [6 g# F8 @% g n - 6 J( F' w5 q0 I3 T
- int *pw;8 I9 a. \: q/ y" p
- 3 F9 v1 U& m6 i* ~
- pw = &week[2];
( |. T: t8 _. `7 R2 g) F
# c5 p% ^0 g4 q, `5 y: n w( p- printf("week is: %d", *pw);
3 C4 N8 b' y" `; C输出的结果是:week is 3。对这段代码的释义参照上图 5.3.3。
5 V- w. L# L0 P4 }! I6 W% L
; ]8 Z+ f, O* C, w; X7 o2) 指针与函数1 B% X( P( }7 l
0 e# f) m& |' ]9 ^ R( p
指针在函数中的使用最简单的是作为函数的形参,比如:- int sum(int *pdata)% ^2 a/ H3 ?! R6 [+ v# l( o
0 `' Y& g- s$ {9 K- {
4 {4 K; {6 n; |) V* f7 \ - ! u: z( g- W+ K5 P
- int i = 0;( L/ T% ]1 i) F; Z
# V/ D- u7 k1 s- L0 c- int temp = 0;" m: i, ~% j- g7 c" e7 J
- 6 }5 F# Q" @4 c' x' {) |5 t) \
- for(i=0;i<10;i++)
3 E, V, z0 d0 S2 x A- s% `' w - ; h' b2 q; K+ @5 x. x% h( Q6 Q
- {; \0 r( q' v# K0 M
2 f. z0 i5 T0 X' |: ^4 V2 J- temp = temp + (*pdata);
% j8 ^& d6 @1 B% Z; H( n* P - / |: }! a. O& t; W9 S8 Y
- pdata++;
- z' `8 r' r# L1 `
+ i L" w/ o' _9 L1 R. C- }' R+ b: ^" Q$ J% k6 X6 v' ~+ K8 {
- % E* n9 C3 ?& j9 u! v8 g g1 U
* i3 V7 A! N) @0 \ F- ' U- S3 N3 B: A7 f* A+ @
- return temp;% ^% W# q. Q# l8 f9 s
3 r1 F) u$ r, P- }
% y# o1 t! }# Q/ z- i" j# k这个例子有几点值得讲解的地方,第1点指针pdata是作为函数的形参存在,指向一个储存int类型变量的地址;第2点指针pdata++;语句执行后,pdata只想的地址自增的不是1,而是int类型所占的大小,加入pdata最初的值是0,int类型占2个字节,那么pdata++;语句执行后,pdata的值就变成了2,而不是1,而*pdata的值是地址2所在的值不是地址1所在的值;第3点这个函数有个危险,即函数实现的是从pdata最初指向的地址开始往后的10个int类型变量的和,假如我们这样使用:
" ]' |' Q2 U4 `/ Z5 k6 V* `& g4 H* L7 g: t1 ]9 a
- int data[5] = {1, 2, 3, -1, -2};
1 ^2 F6 T1 @9 j* e9 N - ! {4 l1 N! o% P5 I- u; F2 q
- int x = sum(data);
0 f( D- k$ A/ J! \) Z) a7 B' ~0 `可以看到数组data的数组名即数组的首地址作为参数输入到函数sum里,而数组的大小只有5个int,函数sum计算的却是10个数的和,因而就会出现地址溢出,得不到正确的结果甚至于程序跑飞。为了避免这个问题,通常的解决方法是加一个数量形参:- int sum(int *pdata, int length); D3 Y/ U# ^+ S L# S
4 g& t3 |9 ~( d/ a% Z- {0 [6 C2 b" F$ s4 h3 }7 t6 M9 ^! a
. v* r b' a0 Y# m+ g( |2 m- int i = 0;. U" }: U9 U( D% p. |5 S
. {- z3 l4 E9 |4 M! ~" j8 L- int temp = 0;7 H/ Z0 L8 }8 e; v
- + V9 S, x3 Z$ m' d! O
- for(i=0;i<length;i++)
6 U. \% e& D& o( M% g! F% W
9 h% \- D- Q- K0 q" Q- {
' y" }. b% b* |+ W
$ J/ U* w% u$ X6 y- temp = temp + (*pdata);
6 k& B9 a% C! H' |
. ?& r- V' v9 n$ ~) z Q( t5 F6 }- pdata++;4 P- I9 ?2 J$ P+ t% R0 h$ }
- % P# ]5 P$ Y% l: Z4 L1 ~, R- A
- }4 n; P" W3 V! m/ W8 N3 V9 v+ I
- ) C$ { T% P: I# p
1 _( q9 @! O' F9 |$ w6 |; P0 j- 0 o5 ]6 k& ^2 t* @9 p
- return temp;+ U1 }( C! U6 H& E9 ^! w6 a2 }
0 T0 w! D9 L+ r9 ]* }* k& a' a- }; j. E/ r2 I2 V. n
% g- M2 ?0 V9 w2 Y# p0 s- x = sum(data, 5);
或者给出指针范围:- int sum(int *pStart, int *pEnd) W! V& s q! C2 B0 ^; G
2 ?2 L* l. A0 d9 O) n( R6 c: i- {
s; v' L8 N" H
) U9 \$ V# X/ ]6 W- int i = 0;6 A6 B* W# ]4 }- Z
8 g: `' n1 S4 l4 x3 Z- int temp = 0;
- s$ i6 n/ W W# _ - , ?$ @ f$ H) p
- int length = (pEnd - pStart)/2; // 假设一个int占2个字节9 V7 W- I5 w8 V" y7 H: M3 L3 q2 k
( ^0 a z/ n2 |7 U/ a- for(i=0;i<length;i++)
, F2 }' n& {+ C! C - 4 m5 S/ w s7 Z/ ] o. j5 E
- {
' r: l$ r `+ F5 C3 x2 z - 7 O& \5 @8 E5 F) |# m! D3 V' v
- temp = temp + (*pdata);
1 R) f. O: q: L
* K" N% [5 S3 m/ h- pdata++;
4 [- x& a& U. n- S5 a
6 R" m4 D$ i! o" _6 C5 ^% c: d- }
+ K" y, M& Z" i' ]' L6 { - % v& q! A, Q; L0 V! w; c% f( v
; O$ z- \& M0 a) Y! `' }
+ l- ~% |# J" j* z6 J. X- return temp;: ]9 x4 D8 q6 r4 s* C
5 P* K g' U$ u3 I" p* C# x; D- }7 f/ o* ~- d0 l' s
- . n; n4 F, u/ @& d. [
- x = sum(data, &data[4]);
, l8 `* H. o; F# }- P$ N8 d& y指针与函数的关系除了指针作为函数形参外还有另一个重要的应用,那边是函数指针,比如在typedef用法章节的那个例子:
4 z6 I$ A% G, H) `# y
% y% R; T1 @: v1 Q5 @1 Y1 }- typedef void (*pFunction)(void);
) t+ R, q3 C$ G在这个例子中,首先*表明pFunction是一个指针变量,其次前面的void表示这个指针变量返回一个void类型的值,最后括号里面的void表明这个函数指针的形参是void类型的。如何使用函数指针调用函数呢?看下面这个例子:
0 F U9 M+ @3 f7 G- ]
& r* i4 C" `' |4 f9 G6 x7 W1 A- int max(int a, int b)
( a& ~; _# U5 S9 M3 ] - 0 d5 G& `. P& E; a5 a
- {
9 F4 w2 w0 ^: \6 E - , e V! `+ o3 S" i% \
- return ((a>b)?a:b);# F, o3 c* h9 H- B2 d6 p
- * @/ H& Y7 l4 z/ F5 k) D5 D! y
- }1 M/ e) e- {: i, N
- * b# u2 R! x' i6 T$ K s
) c/ H" @. H$ c6 O& D% a# D9 R- 4 N9 d: B5 t. `9 [8 s5 I
- int main(void)
, F( }9 S* \8 |) g: w - : w! Z/ j t* p
- {1 U2 \- `9 D- _0 I | g) ~
! Z, a, [+ Q1 F- int (*pfun)(int, int);: j5 f E9 K/ U; r+ F) p5 D) e( f
- 9 n6 g; I, D6 U0 I
- int a=-1, b=2, c=0;- l0 S( v5 v& Z; r
/ T7 v+ Q+ x0 m; P- pfun = max;
6 m. g) c* A k: ~! ~1 o
1 r* v6 d! C; M* m. Q- c=pfun(a, b);' H: w6 F. @7 b2 I
. r* \$ ]( ?* u+ W' g* l- printf("max: %d", c);, @$ h+ R* ^4 E- i8 {" q
) x: M1 M6 `2 G) o
2 f: ~" ]# ]% ]' r4 c9 a, B( h- : D3 r& C/ h0 d+ b2 u
- return 0;$ k, J8 G3 f9 D8 `7 Z( G6 a6 Q
# G+ `2 X- [. Q+ @. u2 l- }
$ s2 r1 R* u1 W' ^ E! ~输出的结果是:2。
( z; L7 N$ a/ K4 ?8 O( G3 \; r
$ S, N. c% k3 z3) 指针与硬件地址
* ~2 R1 {, i5 \* f) {/ z! m% q: V" ? Q m, M; S1 @
指针与硬件地址的联系在volatile用法章节的例子中惊鸿一现,没有详细介绍,下面做详细说明。比如在STM32F103C8T6中内部SRAM的基地址是0x20000000,我们想对这片空间的前256个字节写入数据,就可以使用指针指向这个基地址,然后开始写:" m" H) R7 M% j* K' ^
0 a% Y3 M7 |) V0 G/ z6 e9 P- volatile unsigned char *pData = (volatile unsigned char *)(0x20000000);3 R& g' y+ @ [) w/ r" A. R
- # H7 h8 L8 v5 I/ m
- int main(void)& h# H$ M% w% S. F- D5 C" _
- ) D# @& R9 T. m; ^; C+ ]% }
- {6 I& X. G1 M0 S& W3 J/ }) B
' O) O5 l6 D" P# L2 w. a& J7 f- int i = 0;
; { G) k4 ]; I2 c! f! ` - ' X" k7 h6 ^9 @& ?" X6 S
- for(i=0; i<256; i++)
8 P% I1 h: q; z' J/ u! B
8 |/ t; o/ d2 P' c- {
/ x @& E9 w/ ^9 Z. F5 v) P
7 c8 m; Z ^' I4 B8 E5 r- pData<i> = i+10;) K# U1 ?# {4 U
5 K. n$ z7 I- `; t. A- }
! ^* m( f) ?& D7 Y3 C
) @4 Y' {. W" I& t- / G3 H& Z- O Z( k6 |" v
% p9 O) |; ~! g- return 0;
# g9 B! k$ h4 T) T6 L* |8 h - / k: a7 F- j8 c% j. _! T9 k N
- }</i>
除了内存地址,还可以指向硬件外设的寄存器地址,操作方式与上述例子类似。( g' y0 l! W9 W* s9 v; o, c
. j8 J, Q7 U, d, _5 B; p: b5 L
指针应用的基本原则:
! n& P% Z& y, j5 D7 x) r
4 }8 |; F& e' [0 N首先必须要指定指针的类型;
" Y$ A" O. v) T0 Z/ {, Z
. n2 k$ z4 R4 D2 m如果是普通指针变量,非函数形参或者函数指针,必须要给指针变量指定地址,避免成为一个“野指针”; g2 |; _; G, R. l k& Y8 O/ \9 S
5 ]$ J+ u* C: b/ ^8 o
5.3.15 回调函数
# Q) r; g/ w: \+ G在C语言中回调函数是函数指针的高级应用。所谓回调函数,一个笼统简单的介绍就是一个被作为参数传递的函数。从字面上看,回调函数的意思是:一个回去调用的函数,如何理解这句话呢?从逻辑上分析,要“回去”,必然存在着一个已知的目的地,然后在某一个时刻去访问;那么回调函数就是存在一个已知的函数体A,将这个函数体A的地址即函数名“A”(函数名即是这个函数体的函数指针,指向这个函数的地址)告知给另外某个函数B,当那个函数B执行到某一步的时候就会去执行函数A。0 n* n4 C4 r( l; E: l. m
1 Z$ }0 s3 P1 D& h回调函数的应用有很多,因之后的程序都是在STM32的HAL库下编写的,因而此处我们仅从HAL库出发来看其中的回调函数。& w4 b: w4 ~; `1 o
# P2 N0 l3 X. F0 j! {8 v$ n* A2 y# s
我们仅以GPIO的HAL库函数来看,文件名“stm32f1xx_hal_gpio.c”。我们用逆分析的方法来看这个回调函数。
7 R% C& T- q. l, D: N0 e+ R Q! |8 u, q
首先是GPIO的回调函数声明:. ]) C/ k, ]0 w |8 W; n. p! ], s
. |/ q$ L: E/ `! J3 V3 |, S- __weak void HAL_GPIO_EXTI_Callback(uint16_t GPIO_Pin)
% f) q0 Z7 m8 m. B可以看到其函数名是:HAL_GPIO_EXTI_Callback,形参是GPIO_Pin表示引脚号(Px0~Px15,x=A,B,C,D,E,F,G),从这个函数的名称出发,可以大致明确这是一个引脚的外部中断(EXTI)的回调函数。然后大家看到前面还有个“__weak”,这是“弱函数”的修饰符,告诉编译器如果用户在其它地方用void HAL_GPIO_EXTI_Callback(uint16_t GPIO_Pin)重新定义了此回调函数那么优先调用用户定义的,否则调用这个弱函数修饰的回调函数。4 w6 i" Z6 J" h/ F2 Z& {
* P2 K& n7 Z3 s8 O0 e, Q. q紧接着我们来看此回调函数是在哪里被调用的:
! r5 M8 l0 }9 N' K
' q V! y& F+ Q' ^) V6 ~- void HAL_GPIO_EXTI_IRQHandler(uint16_t GPIO_Pin); m, W0 e t% d/ @ V
- ) p3 ~5 [+ x3 B2 W
- {6 A4 A* w, ?* V8 i1 Z
- 0 g5 N& S4 ~, d7 l1 z
- /* EXTI line interrupt detected */1 p" N. T7 J+ V2 H# L
7 c, @2 J! z+ z5 I9 J- if (__HAL_GPIO_EXTI_GET_IT(GPIO_Pin) != 0x00u)
/ y. g6 @% T5 i5 ` - 8 l; F1 p' q* J/ K7 ]6 M
- {9 v! G) q; Y& C$ v' P4 C8 P
! R: V: @% G$ u* K2 o8 a# _+ F, q- __HAL_GPIO_EXTI_CLEAR_IT(GPIO_Pin);
6 R. A: I7 J3 O7 k( k - a( ~0 P' I$ m2 p1 o1 U; ~+ ^
- HAL_GPIO_EXTI_Callback(GPIO_Pin);9 ?0 [; @4 H u6 c, t
- , L" v/ e0 M3 e. ~2 ]
- }. \) W% A! K, |: E4 ] t
- - e% X- U0 h- L+ g+ y- z, Z
- }
可以看到是在GPIO的外部中断服务函数中被调用的,与前面所说的这是一个外部引脚中断回调函数印证一致了。
6 M2 w& l% R. G) z& a9 `" S+ h6 w7 n
& O$ w w: q3 O2 f! gGPIO的回调函数到此就说完了。其实STM32的HAL库中其它大多数的外设的回调函数基本都是如此,用户如果设计需求,就自己重定义需求的回调函数,然后在中断中被调用。
! L: q" f: Y$ @2 z7 S6 z5 s. T& R3 _0 q- x! _9 g! @7 l
5.3.16 位运算% I0 Y* \$ F1 r/ d! l
位运算是指二进制位之间的运算。在嵌入式系统设计中,常常要处理二进制的问题,例如将某个寄存器中的某一个位置1或者置0,将数据左移5位等,常用的位运算符如表 5.3.1 所示。2 y" P1 Q2 A3 x/ P1 K
! ^6 b" v# _" H
![NZYBH9[%CTHV5WK[6)6X1.png](data/attachment/forum/202204/27/112409f7jkpkpr6j3jc6th.png "NZYBH9[%CTHV5WK[6)6X1.png") ( G& B4 c0 T k4 ]+ I6 }+ I& U
. ~ T1 d1 V' a8 M表 5.3.1 位运算符& D: X( S/ ^: r
, i) g* P6 e; r! U) p" ~
/ ~' ~5 W7 O( ^! s% i' j 1) 按位与运算符(&)
5 x! }; s$ h a9 Q$ c# p
- n' p K7 k: j! U0 ]' Z参与运算的两个操作数,每个二进制位进行“与”运算,若两个都为1,结果为1,否者为0。
p; t) R. @) M/ a* J' }0 m; M) B K0 S
例如,1011&1001,第一位都为1,结果为1;第二位都为0,结果为0;第三位一个为1,一个为0,结果为0;第四位都为1,结果为1。最后结果为1001。1 E8 X0 b* j* a" R5 q3 M
9 j; u# ?+ A0 {, w7 p0 V; u+ N: V5 `7 x9 C- _) t. k2 G
2) 按位或运算符(|)9 v$ W# L! ]5 T6 P8 J( K; S
' D# s+ g! W* U+ P* v, j3 H参与运算的两个操作数,每个二进制位进行“或”运算,若两个都为0,结果为1,否者为1。
3 n( Q0 w7 s# ]! d& {
/ }% ?3 m& C2 D" J/ p例如,1011 | 1001,第一位都为1,结果为1;第二位都为0,结果为0;第三位一个为1,一个为0,结果为1;第四位都为1,结果为1。最后结果为1011。
4 A2 ~/ [6 W, S( ~, d9 K9 J7 |
! R6 X+ y, o6 e! k7 f' A9 U, ~3) 按位取反运算符(~)6 @# }- m3 V6 p& L
" M) l7 N& G: `按位取反运算符用于对一个二进制数按位取反。. x" M/ q. P B
; \3 t/ e0 n8 d! d; k例如,~1011,第一位为1,取反为0;第二位为0,取反为1;第三位为1,取反为0,结果为1;第四位为1,取反为0。最后结果为0100。
7 A) V0 n8 j5 ?5 \6 Y5 p, q4 q" B& V) L1 Z7 [% ^
( _8 b: W8 l. A/ r8 B3 c* A
4) 左移(<<)和右移(>>)运算符4 k( M/ U) F, s1 ?1 n+ s4 T
5 s' ~0 S/ H. k
左移(<<)运算符用于将一个数左移若干位,右移(>>)运算符用于将一个数右移若干位。 J: \0 }2 |6 G4 _
& }/ U" \; y% n% ^: K Z* W' Z例如,假设val为unsigned char型数据,对应的二进制数为10111001。若val=va<<3,表示val左移3位,然后赋值给val,左移过程中,高位移出去后被丢弃,低位补0,最后val结果为11001000;若val=val>>3,表示val右移3位,然后赋值给val,右移过程中,低位移出去后被丢弃,高位补0,最后val结果为00010111。
9 ^( `* K6 Q4 Z1 Y9 r
: E. t0 V7 {) P) D% Z1 s" S. U& D8 g1 t" B8 u9 g% M4 c1 X( R8 N
5) 清0或置1
" n* {+ f+ Q) K( @ ]' w( s* ?: b# w5 U, h% q/ E, B
在嵌入式中,经常使用位预算符实现清0或置1。
3 M) |+ b/ C% u) {
$ G% {4 q9 g0 o" i% G: o9 r) o例如,MCU的ODR寄存器控制引脚的输出电平高低,寄存器为32位,每位控制一个引脚的电平。假设需要控制GPIOB的1号引脚输出电平的高低,设置该寄存器第0位为1,输出高电平,设置该寄存器第0位为0,输出低电平。
( i, M1 w& L* x( W8 V* s1 V, m# x
7 E. m; u5 S& h* b- #define GPIOB_ODR (*(volatile unsigned int *)(0x40010C0C))0 {- U ]/ _# Y. r- y
- 6 [9 R8 T* |* F# L# @6 j6 c
: \+ B5 R7 @4 s( p Y
* @9 U: J% ?( R6 N2 m- GPIOB_ODR &= ~(1<<0);) W& f$ w8 m( c" h- Z
9 d3 H/ a: K. S3 H+ c- GPIOB_ODR |= (1<<0);
- ]1 B2 r k$ y% f第一行:使用#define定义了GPIOB_ODR 对应的内存地址为0x40010C0C。该地址为MCU的ODR寄存器地址。
! P2 ^0 Q8 D) N/ G
+ T: n& F3 z7 |2 I: [3 @第三行:GPIOB_ODR &= ~(1<<0)实际是GPIOB_ODR = GPIOB_ODR & ~(1<<0),先将GPIOB_ODR和~(1<<0)的进行与运算,运算结果赋值给GPIOB_ODR。1<<0的值为00000000 00000000 00000000 00000001,再取反为11111111 11111111 11111111 11111110,则GPIO_ODR的第0位和0与运算,结果必为0,其它位和1运算,由GPIO_ODR原来的值决定结果。这就实现了,只将GPIO_ODR的第0位清0,其它位保持不变的效果,实现了单独控制对应引脚电平输出低。
5 c$ E- Z i2 e# b5 Z4 ^7 r7 ^% c4 K+ o$ ^; ^' o! l
第四行:GPIOB_ODR |= (1<<0)实际是GPIOB_ODR = GPIOB_ODR | (1<<0),先将GPIOB_ODR和(1<<0)的进行或运算,运算结果赋值给GPIOB_ODR。1<<0的值为00000000 00000000 00000000 00000001,则GPIO_ODR的第0位和0或运算,结果必为1,其它位和0运算,由GPIO_ODR原来的值决定结果。这就实现了,只将GPIO_ODR的第0位置1,其它位保持不变的效果,实现了单独控制对应引脚电平输出高。
# O& q' L/ h7 J! |
6 ?: w! h* C e% c( I3 e9 p$ d; W) h# O# l% Z6 j* @. L! r
|





 STMCU小助手
发布时间:2022-4-27 11:23
 微信公众号
 手机版