STMCU小助手
发布时间:2022-10-19 13:59
|
作为世界上领先的半导体公司之一,意法半导体一直积极参与快速发展的嵌入式人工智能技术研发。为了让经济实用型低功耗微控制器加速应用机器学习和深度神经网络,意法半导体开发了一款全面的Edge AI系统,支持嵌入式开发人员利用众多STM32微控制器产品上的AI,轻松添加新特性和强大的解决方案。# z0 L1 w" Z4 _# U |: W 如图1所示,意法半导体AI解决方案涵盖了整个STM32产品组合,借助预训练神经网络,嵌入式开发人员可以在任何基于Cortex M4、M33和M7的STM32上进行移植、优化和验证。STM32Cube.AI是STM32CubeMX的AI扩展包,让客户能够更高效地开发自己的AI产品。 您可以在STM32应用中运用深度学习的强大功能来增强信号处理性能和提高生产率。 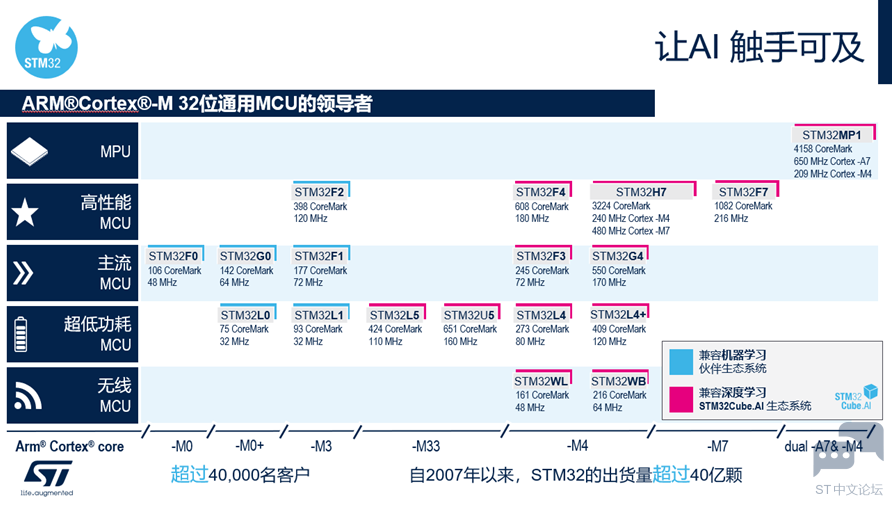
▲图1运行机器学习和深度学习算法的STM32产品组合 6 d7 n6 n- ^: e9 K3 a/ b本文概述了计算机视觉开发框架FP-AI-VISION1,附有在STM32H7上运行的视觉应用代码示例。 从FP-AI-VISION1代码示例起步,可以轻松实现运行在边缘的不同计算机视觉用例,比如:& h9 ]3 E8 q4 X4 z& d
概述* P- j1 {- n% c5 u9 y FP-AI-VISION1是一种STM32Cube功能包(FP),含有基于卷积神经网络(CNN)的计算机视觉应用实例。它由STM32Cube.AI生成的软件组件组成,与专门用于基于人工智能的计算机视觉应用的应用软件组件相辅相成。功能包中提供的应用程序示例如下:
FP-AI-VISION1运行在与STM32F4DIS-CAM相机子模块或B-CAMS-OMV相机模块套装相连的STM32H747I-DISCO板件上。它包括完整的应用固件,用于摄像头捕捉、帧图像预处理、推理执行以及后处理。它还提供浮点和8位量化C模型的集成示例,并支持数据存储器位置的几种配置,以满足应用需求。# i2 y: z9 F+ ]. F. Z5 c D6 T! s# I u# L. e 该FP最重要的主要优点之一是提供示例,描述如何有效地将不同类型的数据置于片上和外部存储器中。如此一来,用户便能轻松理解哪种内存分配最适合需求,并有助于创建运行在STM32系列产品(特别是STM32H747-disco板)上的自定义神经网络模型。0 y5 _8 R4 D4 {" X f b3 h 6 J, l$ V) z6 g; W, K# v1 e3 y) W" [ 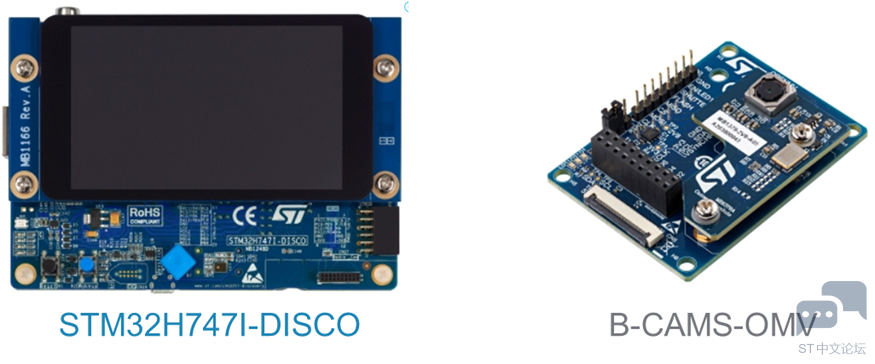
▲图2 用于评估FP-AI-VISION1示例的设备 . {7 R" X' S9 r8 q' KFP-AI-VISION1包括三个基于CNN的图像分类应用示例:
首先,让我们看看食品识别应用。 食品识别CNN是MobileNet模型的衍生模型。MobileNet是一种适用于移动和嵌入式视觉应用的高效模型架构。该模型架构由Google®提出。 MobileNet模型架构包括两个简单的全局超参数,可以有效地在延迟和精度之间进行权衡。原则上,这些超参数允许模型构建者根据问题的约束条件确定大小适当的应用模型。该FP中使用的食品识别模型基于STM32H747目标约束条件调整这些超参数,实现精度、计算资源和内存占用之间的最优权衡。 + A. u) i% S! H, A+ X 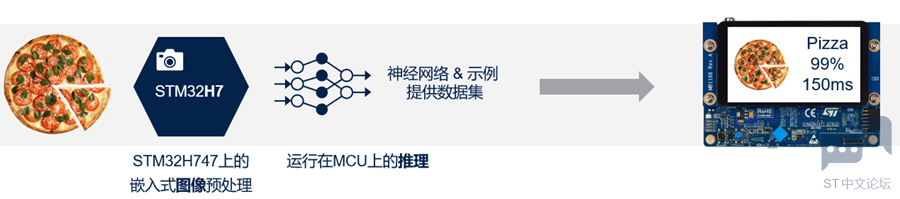
▲图3 食品识别模型的执行流程 图3为食品识别模型的执行流程。它在STM32H747上运行,大约需要150ms完成推理。 接下来,让我们看看人员在场检测应用。 @: x; }$ X# I1 ? FP-AI-VISION1提供了两个人员存在检测示例应用:
这里看到的是前一个模型。人员在场检测应用确定一个人是否出现在图像中。当我们在与STM32F4DIS-CAM连接的STM32L4R上运行此应用时,需要大约270 ms进行推理。flash存储器和RAM虽然小,但是仍然可以在微控制器上运行神经网络(NN),如图4所示。" x+ B0 T5 r7 L0 I2 I3 U! b 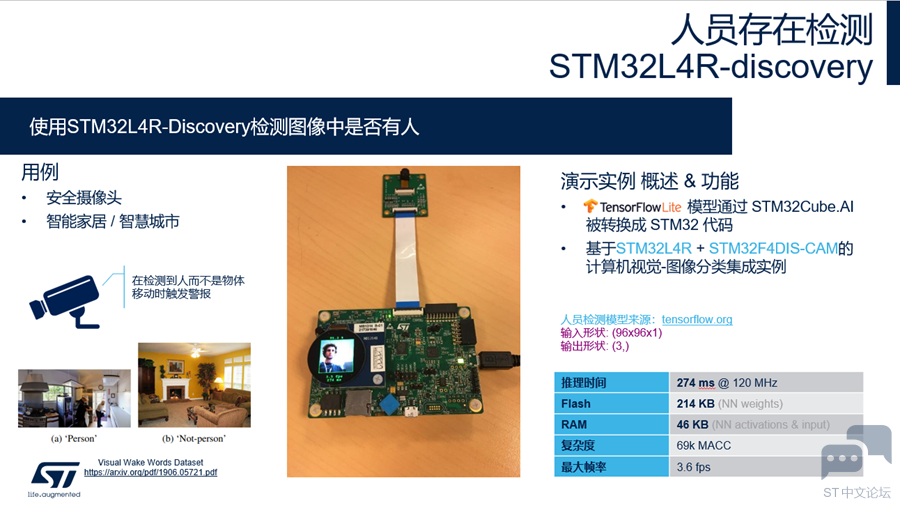
▲图4 人员存在检测概述 人员在场检测可用于从低功耗模式中唤醒。可能的用例是打开灯光、打开门,或任何其他自定义方法。典型实现通常基于被动式红外传感器,在检测到运动时触发事件。但这种PIR系统存在的问题是,可能会发生虚假检测,一只猫经过或树叶在风中飘过都可能触发该系统。人员在场检测应用将只检测人类,这样有助于轻松开发更智能的检测系统。4 s2 Q+ j: V5 `) l" o & P$ P& U. C# \5 j2 _$ [ 系统架构 * Y$ B `" H1 Z/ X: U; [1 H FP-AI-VISION1的顶层架构如图5所示。 # o: x2 w3 D' h2 q& n 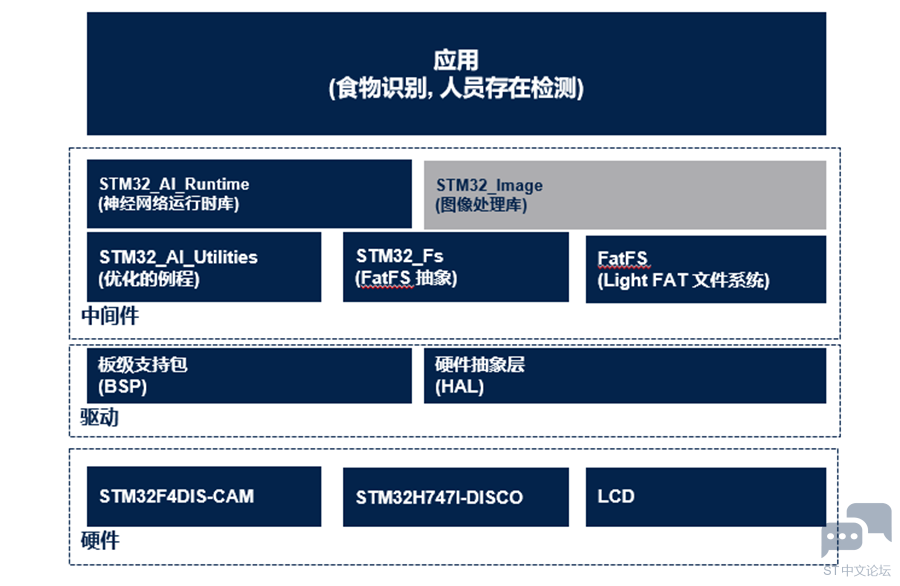
▲图5 FP-AI-VISION1架构 应用构建流程- W8 J$ Z0 s6 n5 C! p0 D& B; {9 b+ S/ ?: V 从浮点CNN模型(使用Keras等框架设计和训练)起步,用户生成优化的C代码(使用STM32Cube.AI工具),并将其集成到计算机视觉框架(作为FP-AI-VISION1的一部分)中,以便在STM32H7上构建计算机视觉应用。在生成C代码时,用户可以选择以下两种选项之一:
对于大多数CNN模型,第二种选择可以减少资源占用(Flash和RAM)以及推理时间。对最终输出精度的影响取决于CNN模型和量化过程(主要是测试数据集和量化算法)。 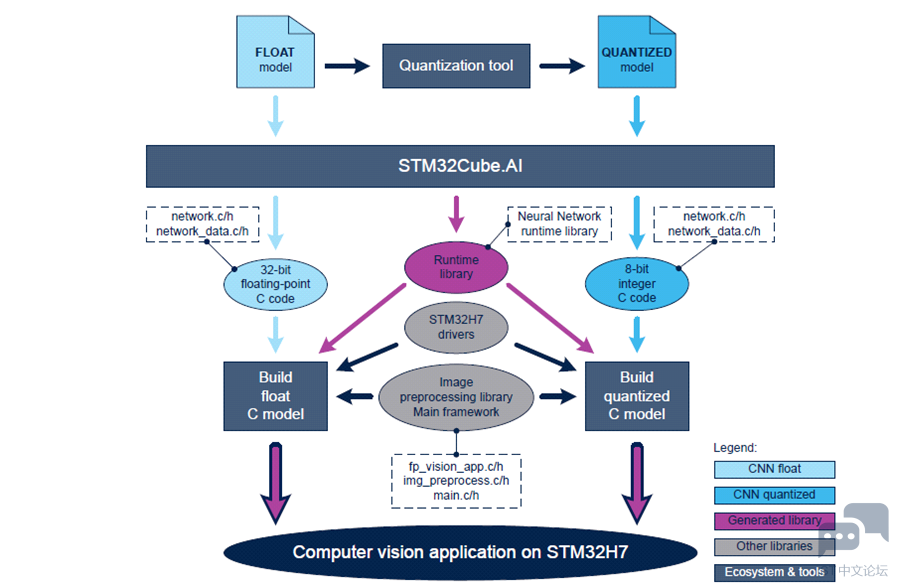
▲图6 FP-AI-VISION1运行架构 应用执行流程 6 K' Z2 v% \$ O+ K8 N 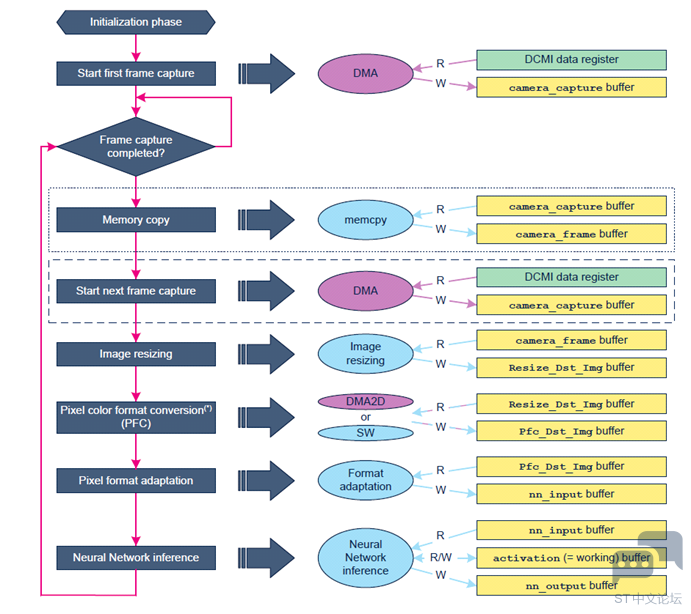
▲图7 执行流程中的数据缓冲区 在计算机视觉应用情景中,集成需要几个数据缓冲区,如图7所示。; _$ g/ y; ?7 w* k, e3 P$ P 应用依次执行以下操作:
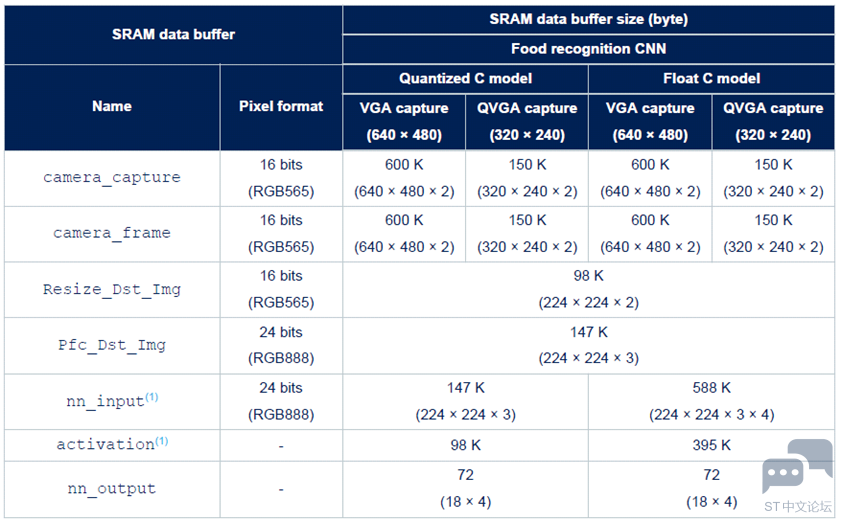
▲表1食品识别应用的SRAM内存缓冲区 转载自:意法半导体中国 8 a( Z9 t7 p6 z& f8 G, b |
【STM32H735G-DK 测评】STM32H735G-DK External Loder 编译和测试
Keil-MDK 在线调试设置断点的高级用法
请教下STM32N6570 怎么把分辨率改成320x240并可以全屏显示
【福利三:逢7发帖赢大礼】想要充分利用STM32H743VI片内的RAM空间(但并不顺利)
基于stm32平台上的IC-MU磁绝对值编码器SPI通讯和码盘数据处理
使用STM32 MCU和MPU连接PDM数字麦克风
分享STM32资料-采用 STM32U031R8 MCU 的 STM32 Nucleo-64 开发板,官方资料,数据手册等资料
HRTIM 指南
使用 STM32 的 DWT 单元监控内存
DAC,COMP,HRTIM Fault 功能的使用
 微信公众号
 手机版