




|
X-CUBE-AI是STM32生态系统中的AI扩展包。可自动转换预训练的人工智能模型,并在用户项目中生成STM32优化库。0 k) m( L7 a$ a* o6 x ' l+ M- j! t; W2 X9 L: a5 R 最新版的X-CUBE-AI v7.1.0在以下方面进行了三大更新:
我们通过提供更多用户友好的界面,不断增强STM32 AI生态系统的功能,并加强了神经网络计算中的更多操作。最重要的是,该扩展包由我们免费提供。6 P/ {4 r& n' O8 X2 D7 m 在介绍X-CUBE-AI v7.1.0的三大更新内容之前,我们先回顾一下X-CUBE-AI的主要用途。$ K0 D8 k# h# B* _! G2 U% ]: p 什么是X-CUBE-AI扩展包 X-CUBE-AI扩展包,也称STM32Cube.AI,装配优化模块,确保从精度、内存占用和电源效率方面为目标STM32生成最佳拟合模型。' E3 v6 Q- p( J/ @% C3 H+ r( L + h! x! N/ U v" `3 |* o 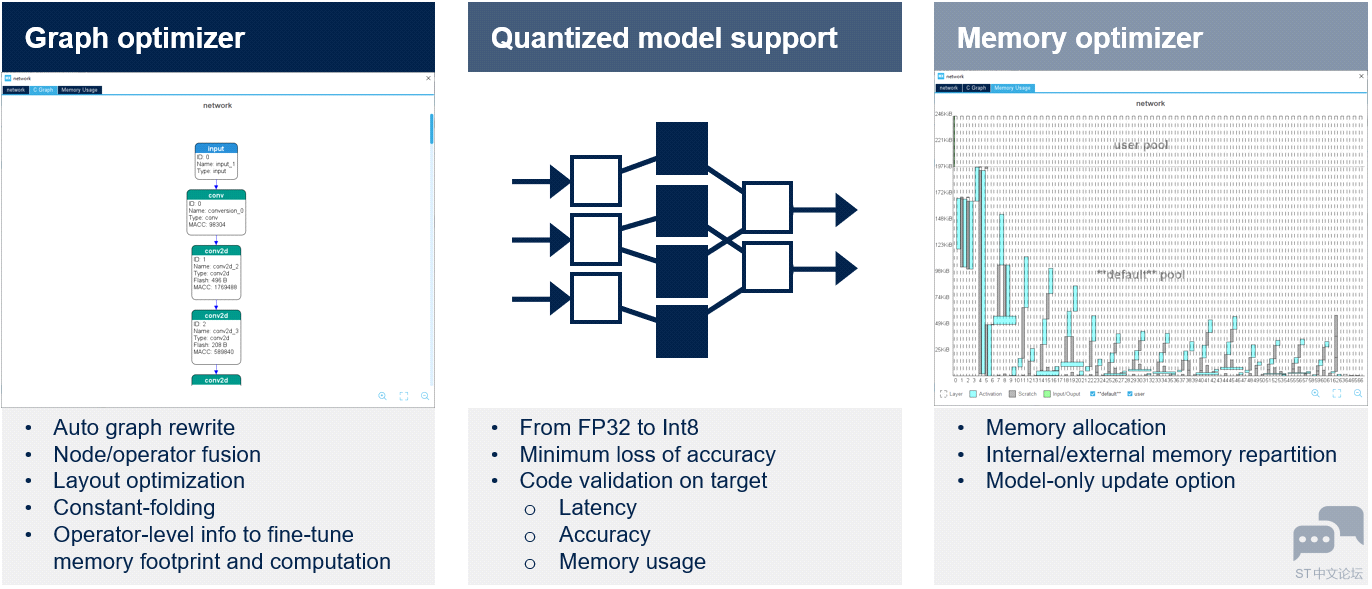
图形优化器 通过有利于STM32目标硬件架构的图形简化和优化自动提高性能。使用了几种优化技术,如计算图重组、算子融合、常数折叠等。 量化器 X-CUBE-AI扩展包支持FP32和Int8预训练模型。开发人员可以导入量化神经网络以兼容STM32嵌入式架构,同时通过采用文档中详述的训练后量化过程来保持性能。在下一个版本中,还将考虑Int1、Int2和Int3。成功导入模型后,可在桌面和目标STM32硬件上验证代码。& \8 m: Q$ I" A: P& b) Q3 [ & w) Q, ] f: e9 B. P, N) `4 L3 ]) G 内存优化器 内存优化器是一种高级内存管理工具。优化内存分配以获得最佳性能,同时符合嵌入式设计的要求。可在内部和外部资源之间实现内存分配的智能平衡,还可以为模型创建专用内存。开发人员可以轻松地更新模型。 + Z4 M$ M& M3 U8 D' n) o X-CUBE-AI v7.1.0的三大更新 在最新版本的X-CUBE-AI v7.1.0中,我们进行了三大更新。 " _+ ]; z* X! Y4 } V 支持入门级STM32 MCU$ R8 ^7 Y9 @( A1 O 为了让您的边缘设备在各个层面都支持AI,我们使X-CUBE-AI v7.1.0实现了对STM32 Arm® Cortex®-M0和Arm® Cortex®-M0+的全面支持。从现在起,用户可以将神经网络带至最小的STM32微控制器上。 开发人员不仅可以在以下产品组合中找到用于各种用途的匹配芯片,还可以拥有一款具有AI启发性的芯片。STM32的频谱范围从超低功耗到高性能系列和微处理器,均包含在内。无线MCU等不同用途也适合AI应用。+ g- S% _8 O' J: ~7 \0 m% w9 ? 6 \; ]8 o- J' s 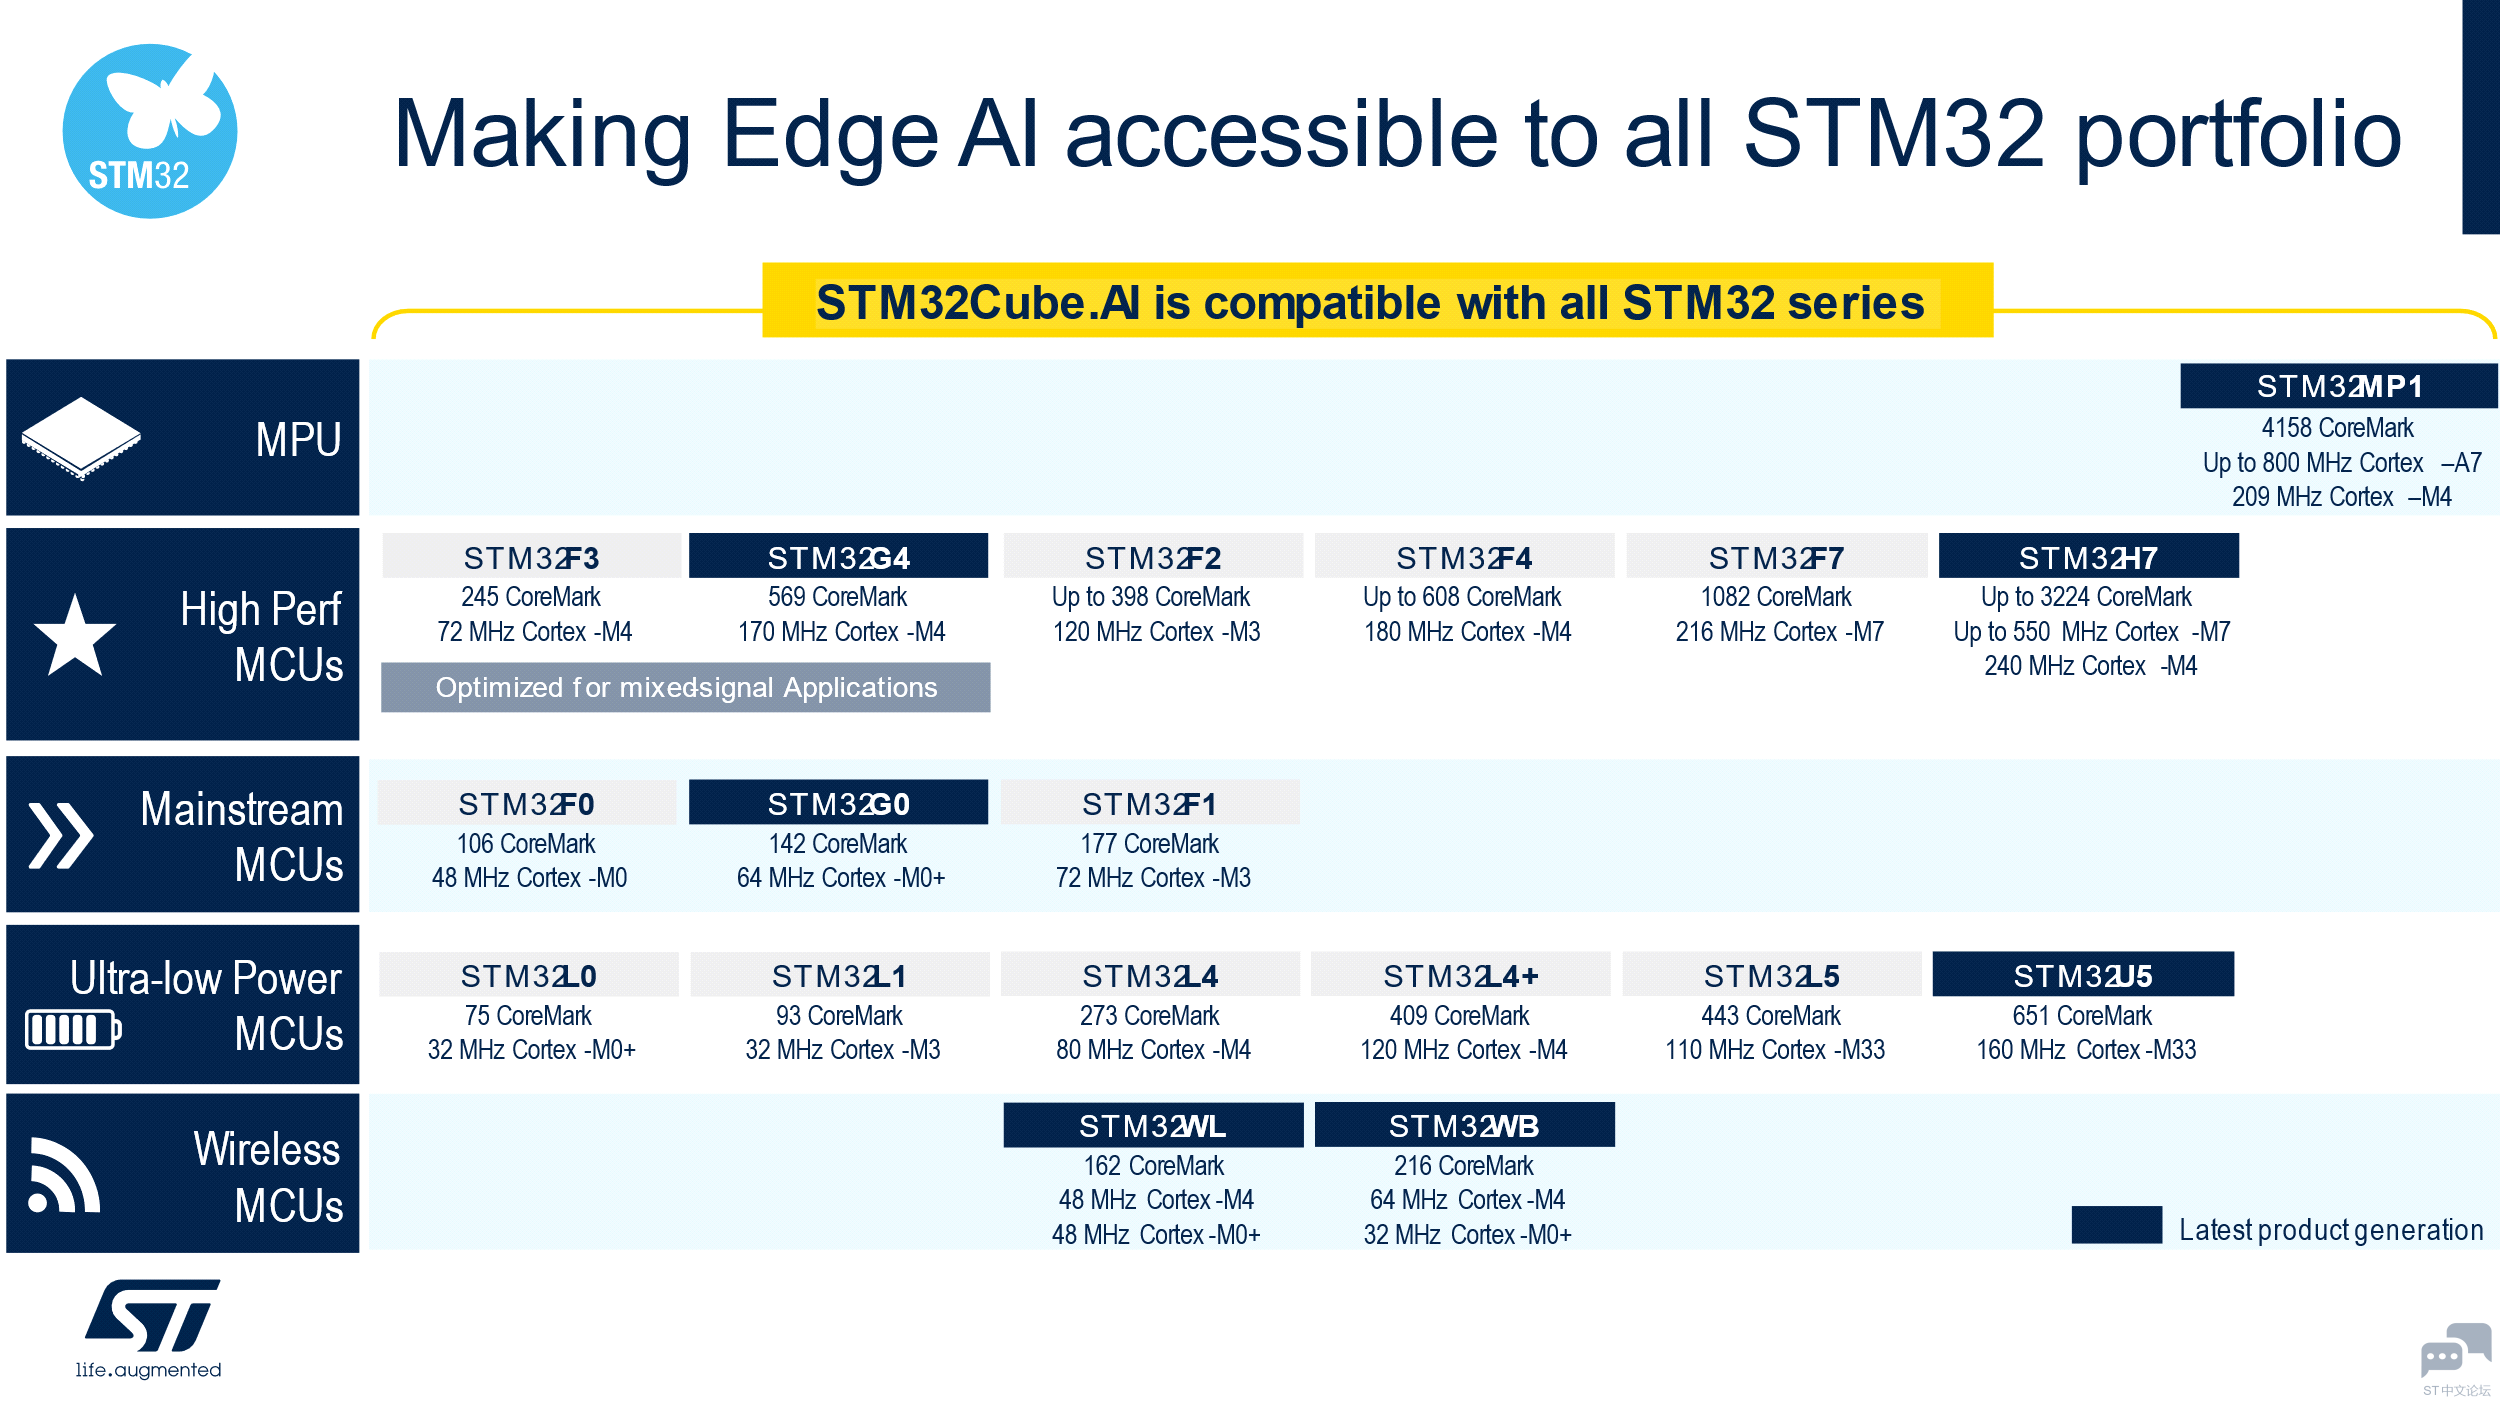
支持最新的AI框架& H, u) R9 _" J! F 最新版本的X-CUBE-AI v7.1.0在Keras和TensorFlow™等广泛使用的深度学习框架中添加了多种功能,并将TFLite runtime升级至2.7.0,将ONNX升级至1.9。 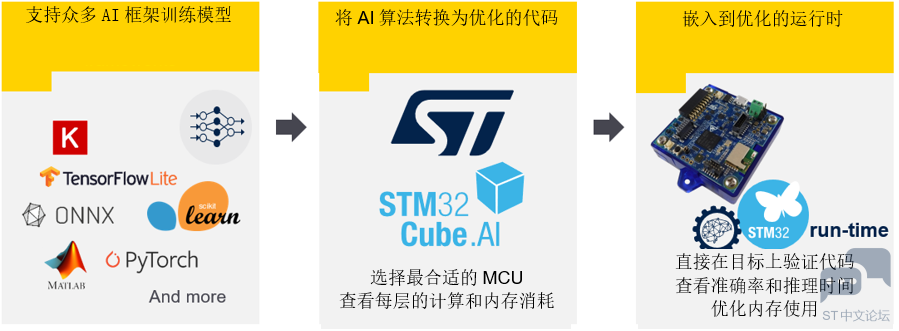
Keras通过Tensorflow™得到支持,支持的算子允许处理针对移动或物联网资源受限的运行时环境的大量经典拓扑。例如,SqueezeNet、MobileNet V1或V2、Inception、SSD MobileNet V1等。在X-CUBE-AI v7.1.0中最高可支持TF Keras 2.7.0。 x; I( u& _/ ~/ d- a, t Tensorflow™ Lite是在移动平台上部署神经网络模型的格式。X-CUBE-AI导入并转换基于flatbuffer技术的tflite文件。处理多个算子,包括量化模型和量化感知训练或训练后量化过程生成的算子。 $ m4 o5 o$ {0 m 对于其他可以导出为ONNX标准格式的框架,如PyTorch™、Microsoft® Cognitive Toolkit、MATLAB®等,X-CUBE-AI同样支持。 每个AI框架我们只支持所有可能层和层参数子集,这取决于网络C API的表达能力和特定工具箱的解析器。 我们提供STM32Cube.AI运行时,以便在执行AI应用程序时获得最佳性能。但是,开发人员可以选择TensorFlow™ Lite运行时作为一种替代方案,在多个项目中发挥作用。即使可能会降低性能,因为运行时针对STM32的优化程度较低。- M; U v1 J* A k 除了深度学习框架外,X-CUBE-AI还涵盖了来自著名开源库scikit-learn的机器学习算法,这是一个完整的Python机器学习框架,如:随机森林、支持向量机(SVM)、k-means聚类和k最近邻(k-NN)。开发人员可以构建大量有监督或无监督的机器学习算法,并利用简单高效的工具进行数据分析。" J! a3 P' t$ q* b# R8 p ' i/ U% y9 W" [: @) _, ]: q X-CUBE-AI v7.1.0不直接支持来自scikit-learn框架或XGBoost包的机器学习算法。在完成训练步骤后,这些算法应转换为ONNX格式,以便部署和导入。skl2onnx实用程序通常用于将模型转换为ONNX格式。可以使用带有ONNX导出器的其他ML框架,但请注意,X-CUBE-AI中ONNX-ML模型的导入主要使用 scikit-learn v0.23.1、skl2onnx v1.10.3和XGBoost v1.5.1进行测试。% N8 C. d! h7 B7 G ( X" d1 D" N% J+ \3 x9 n; q 改善用户体验和性能调节7 v n8 V8 [4 d: L6 s' N X' C X-CUBE-AI v7.1.0引入了多堆支持,开发人员只需单击即可轻松地将不同内容分配到碎片化的内存段上。 9 {5 i. T, K/ V) g+ Q: l 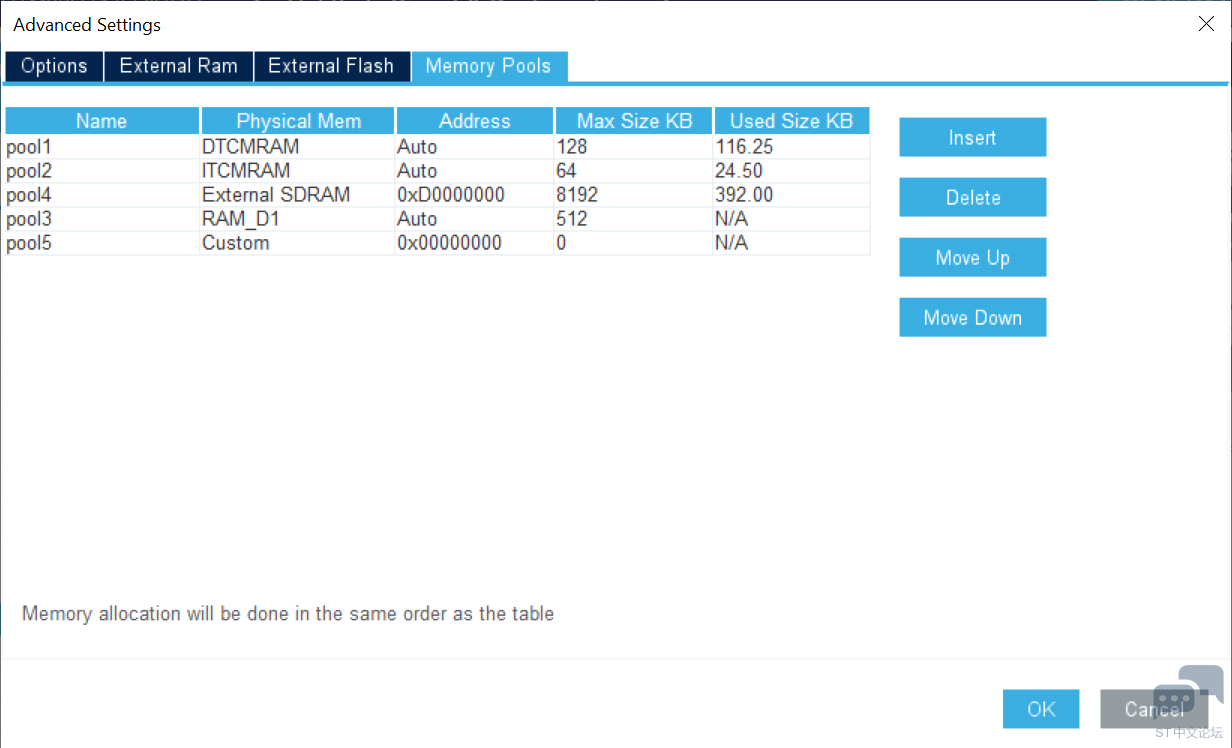
通过使用外部内存支持,开发人员可以轻松地在不同的内存区域分配权重。一旦模型存储在多个数组中,便可将部分权重映射到内部闪存,而其余的则映射到外部闪存。该工具使开发人员可以根据模型要求和应用程序内存占用使用非连续闪存区。: A; ]- |4 S% r G. f 3 z5 G* Q% x/ T# z8 F( g9 S 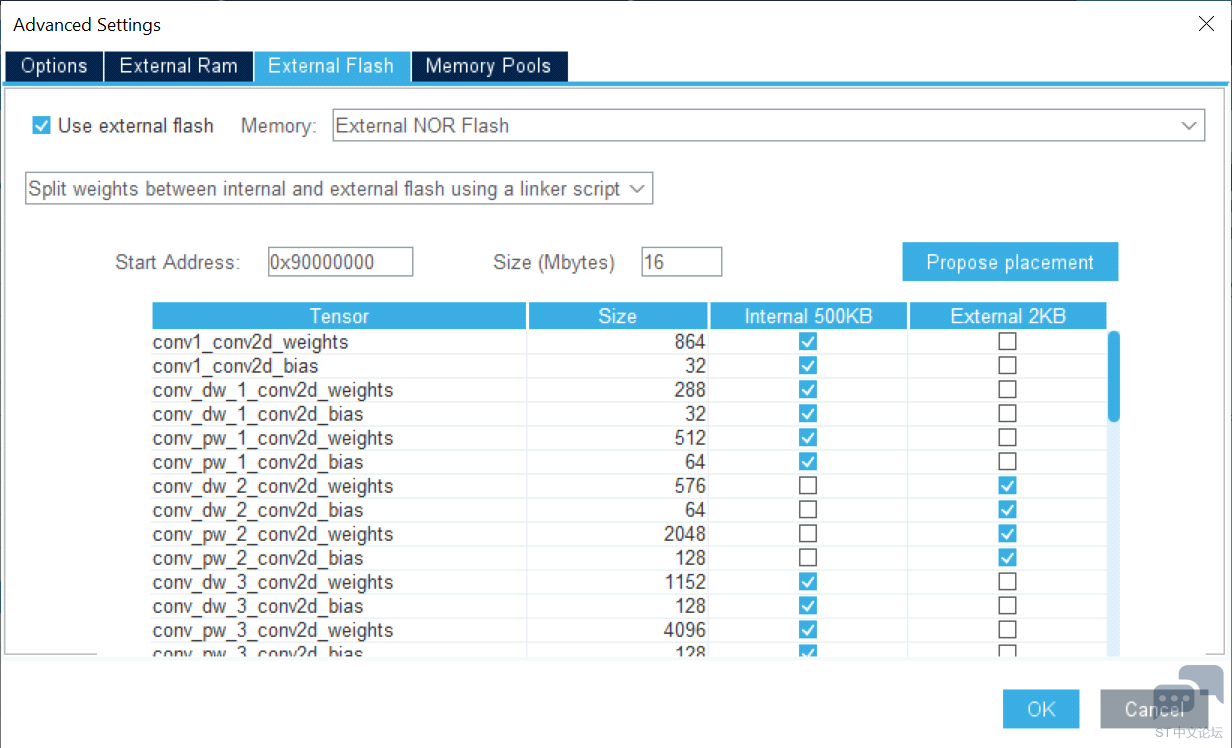
图形用户界面还提供了生成代码中使用的缓冲区的全面视图。一旦选择了模型,开发人员就可以通过直观地检查统计数据来评估整体复杂性和内存占用。模型中的每一层都清晰可见,开发人员可以轻松识别关键层。 : ~. C# w" e* W; F! ?# f: e 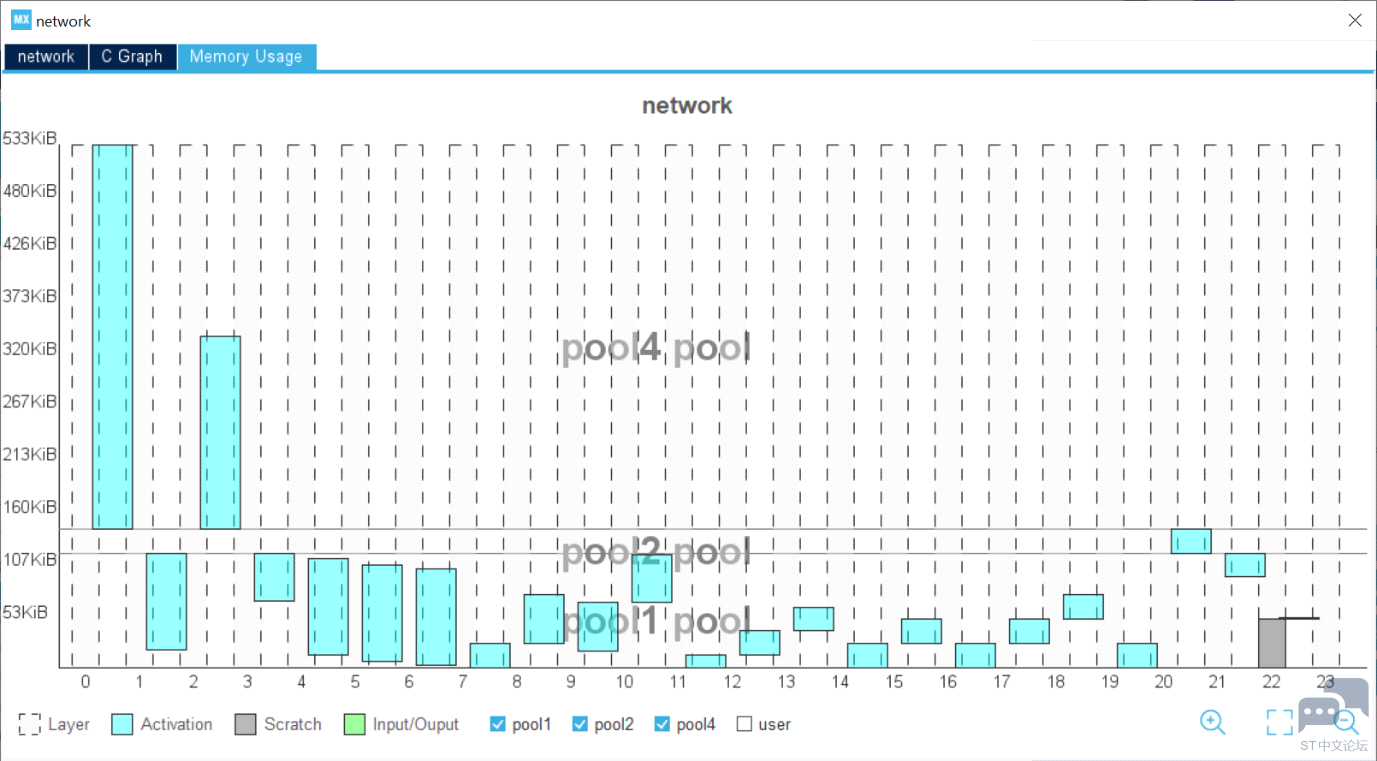
该工具可帮助开发人员加快速度,使我们能够在桌面上验证模型,进行快速基准测试并检测目标STM32设备的最终性能。4 X! i- n1 d; u, Y7 R& r 验证过程结束时,对比表总结了原始模型和STM32模型之间的准确性和误差。X-CUBE-AI还提供了每层的计算复杂度报告,以及运行时测量的推断时间。2 t. V5 b7 W7 J 0 K+ U/ [0 Q B6 n X-CUBE-AI只是意法半导体为STM32用户利用人工智能提供的广泛生态系统的一部分。使用X-CUBE-AI可确保高质量开发的长期支持和可靠性。每次推出新的主要版本时,都会有针对性地定期更新,确保兼容最新AI框架。敬请关注我们为您带来的更多有趣技术。4 L" @6 N8 f% z. o: \2 y ! b9 ^' q! ^+ X, Z- E 转载自:意法半导体中国 如有侵权请联系删除 |
【STM32H5 评测】7、运行FreeRTOS+TrustZone工程
从 CubeMX 到 MX2:这些关键变化必须知道
【STM32H5 评测】ADC 电压表
STM32Cube嵌入式软件更新(2026年8月)
【STM32H5 评测】基础硬件加密与随机数性能 - STM32H5E5实测硬件AES加解密、HASH运算、TRNG真随机数输出速率与稳定性
【STM32H5 评测】NUCLEO-H5E5ZJ 使用 TrustZone 安全分区系统实践测试
【STM32H5 评测】CPU核心性能 - STM32H5E5跑 RTOS,观察任务切换速度、中断响应快慢
【STM32H5 评测】介绍、环境搭建、工程测试
#双节活动 1.在CubeMX中引用touchGFX出现的问题与解决
如何将STM32CubeMX生成的CMake工程导入STM32CubeIDE
 微信公众号
 手机版


