 STMCU-管管
发布时间:2026-9-17 08:47
|
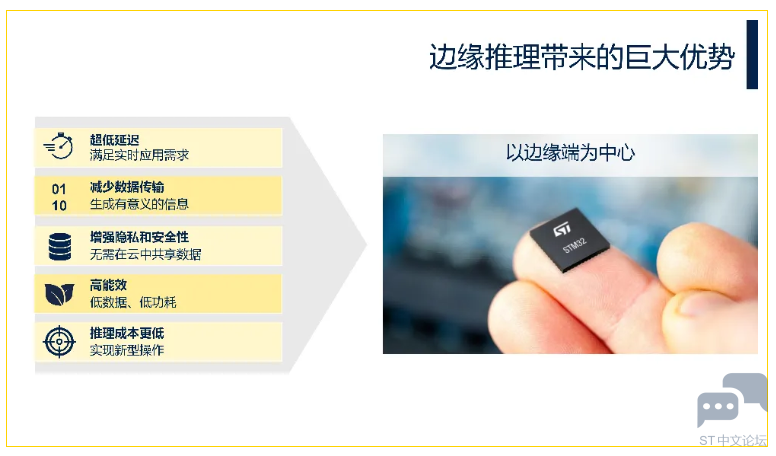
人工智能设备正在快速增长,算法推理也由以云为中心,逐步转向以设备和边缘端为中心。对STM32而言,这场迁移促使ST围绕不同算力需求,构建一套覆盖硬件平台、开发工具和应用资源的完整体系。 从云端到边缘:AI推理范式正在迁移 推动AI推理下沉的,是硬件与模型的同步演进:边缘侧芯片算力持续提升、成本逐步下降,AI模型也在保持准确率的同时变得更加轻量。过去需要上传云端处理的数据,如今可以直接在设备侧完成推理。
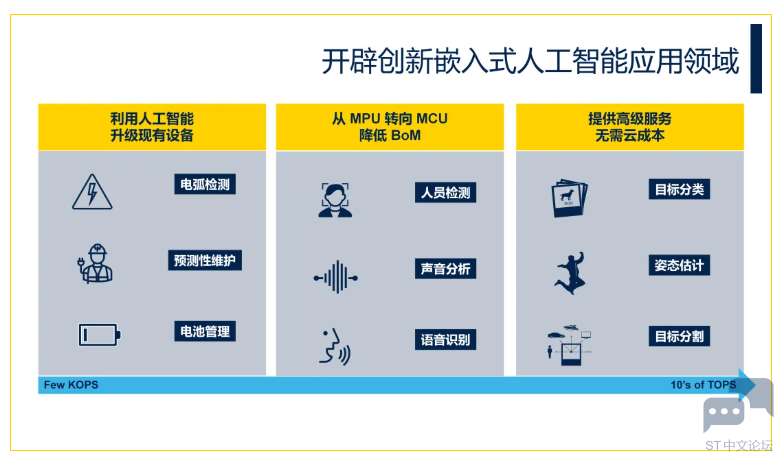
数据在本地处理,可以带来五项直接价值:更低的响应延迟、更少的数据传输、更高的能源效率、更强的隐私与安全保障,以及更低的推理成本。对于实时控制、移动设备和隐私敏感型应用,这些特性尤其关键。 这并非以边缘端取代云端,而是形成“云端协同”:边缘端以低功耗、高效率处理现场数据,云端承担需要集中统筹的任务。STM32边缘AI的布局深耕,正是围绕推理向设备端迁移的趋势展开。 STM32边缘AI能做什么? STM32边缘AI应用可为嵌入式人工智能应用打开三类创新空间:
首先,是利用AI升级现有设备。电弧检测、电池管理、预测性维护等传统场景,可以借助机器学习提升检测和判断能力。以电弧检测为例,相关方案已升级多个版本,逐步加入模型自动搜索、调参优化、迁移学习、基准测试、部署与验证等能力;风机堵转与不平衡、水泵流量检测,以及电池SOC、SOH预测和老化检测,也已形成相应实践。 其次,是把原先运行在MPU或SoC上的应用下沉到MCU。随着高性能MCU和NPU的出现,人员检测与追踪、声音分析、声纹检测、VAD和语音识别等任务可以在MCU侧完成,在满足功能需求的同时降低系统BoM。 再进一步,过去更多依赖云端的视觉推理也开始进入设备端。目标分类、姿态估计和目标分割等应用,可以依托STM32N6等器件在边缘侧部署。 STM32 Edge AI的应用跨度从Few KOPS延伸至数十TOPS:轻量传感任务、音频处理和复杂视觉任务,可以分别匹配不同层级的算力平台。 STM32 Edge AI地图: 硬件芯片、软件工具链及应用案例协同运用 STM32 Edge AI地图有三个层次:最基础的是覆盖不同算力的STM32芯片,即硬件层;中间层是把数据或模型转化为可部署方案的软件工具层;最上面是应用层,可分为传感(时间序列)、音频和视觉三个路径方向。
硬件层:通用MCU/MPU和带硬件加速的MCU/MPU 硬件层是边缘AI能力落地的基础。所有STM32 MCU和MPU都可以部署边缘AI,并可按照是否具备硬件加速IP,分为通用MCU/MPU和带硬件加速的MCU/MPU两类。
第一类是不带专用AI硬件加速的通用STM32 MCU/MPU,AI算法主要运行在CPU内核上。这类产品涵盖STM32H7/F7、STM32H5、STM32G4/G0/C0、STM32F4/F2、STM32F0/F1/F3、STM32U5/U3/U0、STM32L4+/L4/L0、STM32WBA/WB和STM32WL等系列。(STM32U3部分型号因搭载HSP,可归入带硬件加速的STM32平台。)STM32的全系列覆盖,使边缘AI不再局限于少数高端器件,开发者可以根据模型规模、实时性和资源需求选择合适的产品。 这类通用MCU主要用于相对轻量的传感与控制类任务,应用覆盖电力与能源、智能工业、家电和个人电子。例如,电弧故障检测、计量、电池SOC/SOH与热失控监测,电机和风机控制、自动化与人员计数,以及压缩机故障、洗衣机不平衡、姿态和手势识别等,都可以在通用MCU落地。
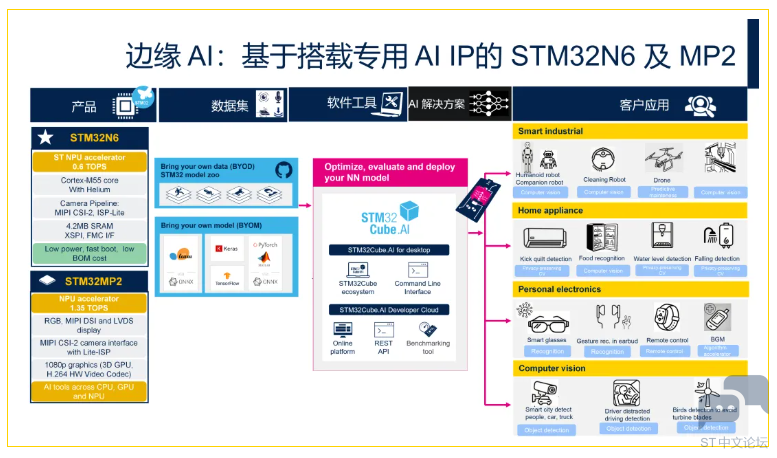
当任务需要更高算力,或者需要同时处理信号运算与AI推理时,硬件平台便需要集成NPU、HSP或Helium的MCU/MPU。其中,STM32N6和STM32MP2具有专用AI加速器NPU,STM32U3则通过HSP强化DSP和AI处理。 STM32N6集成0.6 TOPS NPU加速器,采用带Helium的Cortex-M55内核,具有低功耗、快速启动和低BoM成本的优势;STM32MP2集成1.35 TOPS NPU加速器,支持RGB、MIPI DSI和LVDS显示,以及包括3D GPU和H.264硬件视频编解码在内的1080p图形能力;其AI模型可以部署在CPU、GPU和NPU。 借助NPU,边缘应用可以进一步扩展到更复杂的音频和视觉任务,包括人形机器人、清洁机器人、无人机、食物识别、跌倒检测、智能眼镜、耳机手势识别场景等。
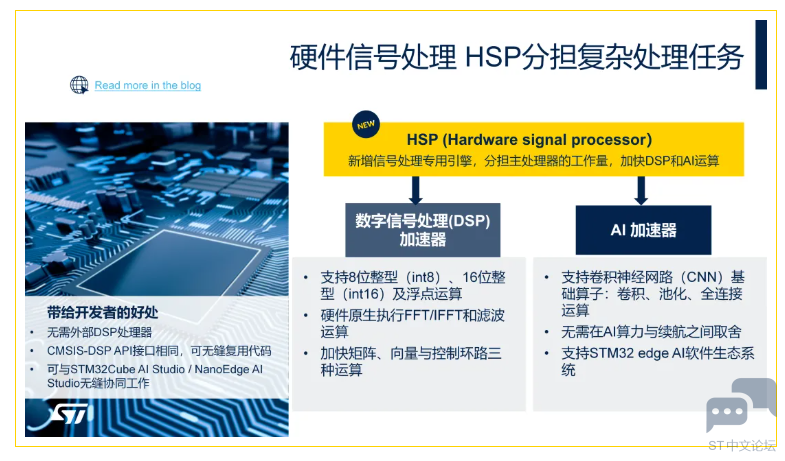
HSP(Hardware Signal Processor)提供了另一种加速思路。首款搭载HSP的MCU是STM32U3。HSP支持int8、int16和浮点运算,可原生执行FFT/IFFT和滤波,并加速矩阵、向量与控制环路运算;它还可以加速卷积、池化和全连接等卷积神经网络基础算子。这样,信号预处理与AI推理能够在同一硬件单元中协同完成,并可沿用CMSIS-DSP API和STM32 Edge AI软件生态。 软件工具层:从数据或模型走向部署 硬件决定AI任务运行在哪里,软件工具则决定模型如何落地。
按照开发者的边缘应用需求及是否需要搭建自有模型,STM32提供多条路径:通用MCU主要使用NanoEdge AI Studio或STM32Cube.AI;带NPU的STM32N6等器件通过STM32Cube.AI完成模型编译与部署;面向STM32 MPU,则由X-LINUX-AI提供覆盖传感、音频和视觉的AI框架。
对于从数据出发的开发者,NanoEdge AI Studio提供AutoML路径。即使不具备专业AI算法能力,也可以导入自己的数据,由工具自动搜索合适的机器学习算法,完成分析、选择和验证,并生成可部署到STM32 MCU或智能传感器的库。这条路径主要服务于异常检测和时间序列分类等传感器场景。 对于已经拥有模型的开发者,STM32Cube.AI可以把在Python环境中训练的神经网络模型转换为可在STM32上运行的代码与库,并完成优化、评估和部署。对于不带NPU的通用MCU,生成的推理库可直接部署到CPU内核上运行。
当选用STM32N6或STM32MP2等带NPU的STM32平台时,软件开发路径会在此基础上增加针对NPU的处理。开发者既可以从数据出发,在Model Zoo中选择模型,并通过Python脚本完成训练、预处理和后处理;也可以直接导入已有模型。模型随后进入STM32Cube.AI进行优化、评估和转换,并采用训练后量化(PTQ)或训练感知量化(QAT)适配NPU。量化完成后,工具会生成设备端推理内核,再通过桌面端、STM32Cube生态、命令行接口完成验证与基准测试,最终部署到STM32N6或STM32MP2上,用于运行算力需求更高的音频和视觉算法。
围绕STM32Cube.AI,Model Zoo与Model Zoo Services进一步补齐模型和开发资源。Model Zoo提供不同模型在通用MCU或带NPU器件上的基准信息,包括Flash、RAM占用量和推理时间;Model Zoo Services则提供覆盖预处理、神经网络训练、后处理、基准测试与量化等环节的Python脚本。开发者可以参考其中的模型、利用脚本训练自己的模型,或直接部署已有模型。 STM32Cube.AI Developer Cloud进一步把评估能力延伸至云端硬件平台。模型上传后,可以在服务器连接的远程开发板上运行,并快速获得推理时间、Flash和RAM占用等结果。 至此,ST经过多年深耕,软件工具链覆盖从数据处理、模型选择与训练,到优化、量化、部署、验证和基准测试的完整开发周期。 围绕这些工具,STM32还提供Wiki、安装包支持文档和哔哩哔哩视频等学习资源,让开发者更快速更便捷掌握基于STM32开发边缘AI应用的技巧。 欢迎访问以下相关网页: >> B站(意法半导体中国) >> ST边缘AI页面 |
从家电到机器人:STM32边缘AI应用案例拆解
STM32U3B5/U3C5:为超低功耗设计带来高性能 DSP 与边缘 AI
【NUCLEO-U3C5ZI 测评】+ 手写数字识别
【STM32U3 评测】MNIST 数字识别
AI玩具爆发前夜:技术拐点、体验鸿沟与破局路径
STM32 AI Model Zoo,现支持PyTorch的最大规模MCU AI模型集合
经验分享 | STM32 AFCI 方案 TensorBoard 使用指南:AI 模型调优可视化终极方案
STM32F334运行超轻量级神经网络推理框架TinyMaxi进行端侧推理
【DIY-STM32N6570-DK-MINI板子功耗测试】
兔哥的边缘AI【001】——DIY-STM32N6全IO扩展板
 微信公众号
 手机版