很高兴收到了 NUCLEO-H5E5ZJ 开发板,参与评测。
1 C( p" ]. m/ E" k4 a
! R0 x7 a8 w; {: | r8 c这个新的开发板我遇到过两个问题:
, \5 k$ U7 H' e1 G% r1. STlink无法识别连接# |8 n1 I4 N+ h# B+ Y# ]
stlink
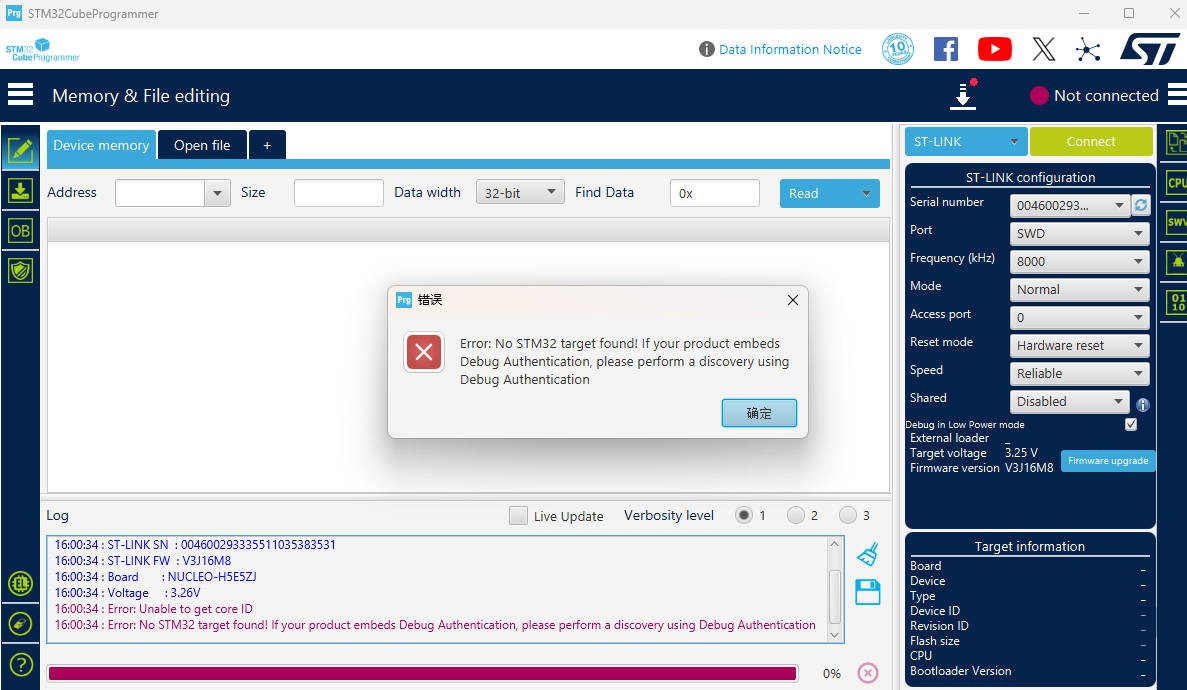
4 d& p3 E9 }8 d3 H2 i刚开始遇到这个问题我还以为是板子坏了,后来一想新板子怎么会坏呢,会不会是芯片太新了导致没识别到,后来升级了CubeProgrammer版本之后可以成功连接了
7 q# k% Z. k" U# C$ J! W2. 代码无法编译
$ N N2 M7 r' e- Y$ J8 X
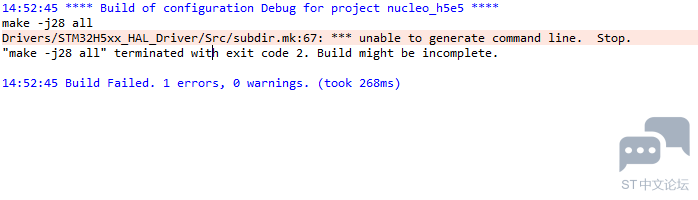
" _ w$ ^7 _2 K: t/ I# D- x# r4 c编译报了一个故障,这里同样也是升级了CubeIDE版本之后解决的。$ A g. a S3 ^
7 E, |: F7 W( s
用ThreadX作为RTOS测试: q7 n L- |- `7 P: j
- 接下来进行测试,首先创建工程代码:
5 `0 v4 f- W$ P/ M5 q4 }2 R: X
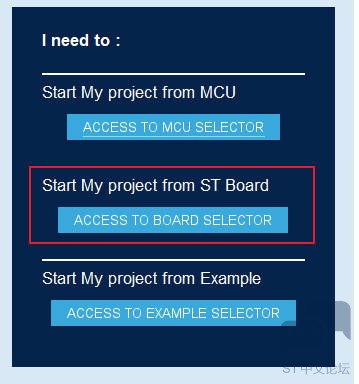
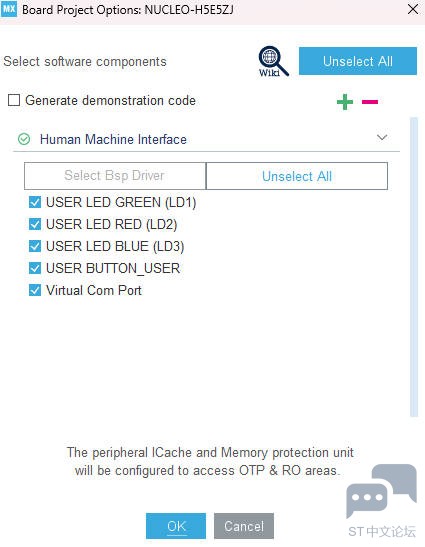
2 w7 ~) O# |3 F* u9 Y4 |" N: X$ Q打开CubeMX工具,选择Board,这里选择H5E5ZJ板子,然后Without TrustZone,默认外设都选上。
3 g! H0 T4 p" y/ i
; n- e e t" E* J, m6 E- `
 6 i7 Y, r4 p$ @* y5 n8 n, \
因为要用的RTOS,所以这里我选择了ThreadX作为测试用的RTOS。! S8 F: t' \* w" L

$ e& Y" D. v1 p配置的话修改了两个地方,一个是RTOS内存大小为10240,另外就是打开了初始化APP任务5 { I2 R) Q: T8 l8 y

7 E& k% o# g7 a7 m& q3 O2 f+ L9 IRTOS会用到systick中断,所以HAL原有的时基需要修改,这里改成TIM6为HAL使用
2 y, w4 y X9 {" Z" |+ V! f; _
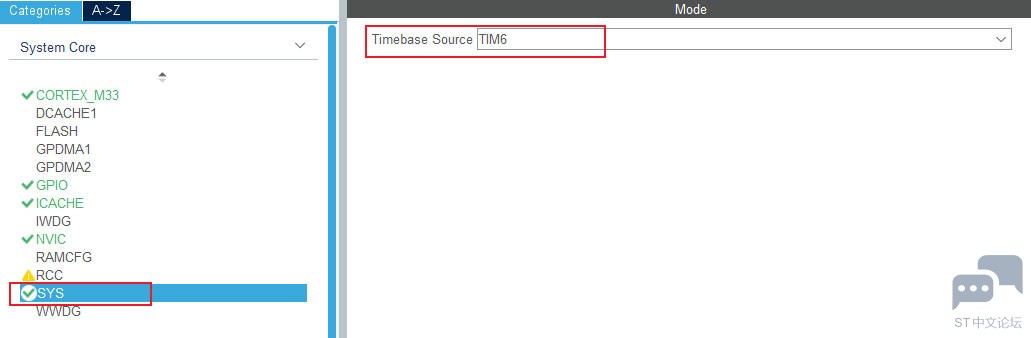 2 `* A: Q9 ?5 X9 g
最后就是需要修改时钟为250Mhz,这里填写250之后会自动解决时钟问题
8 [; w' T. ~. h1 @! }8 r3 @% o
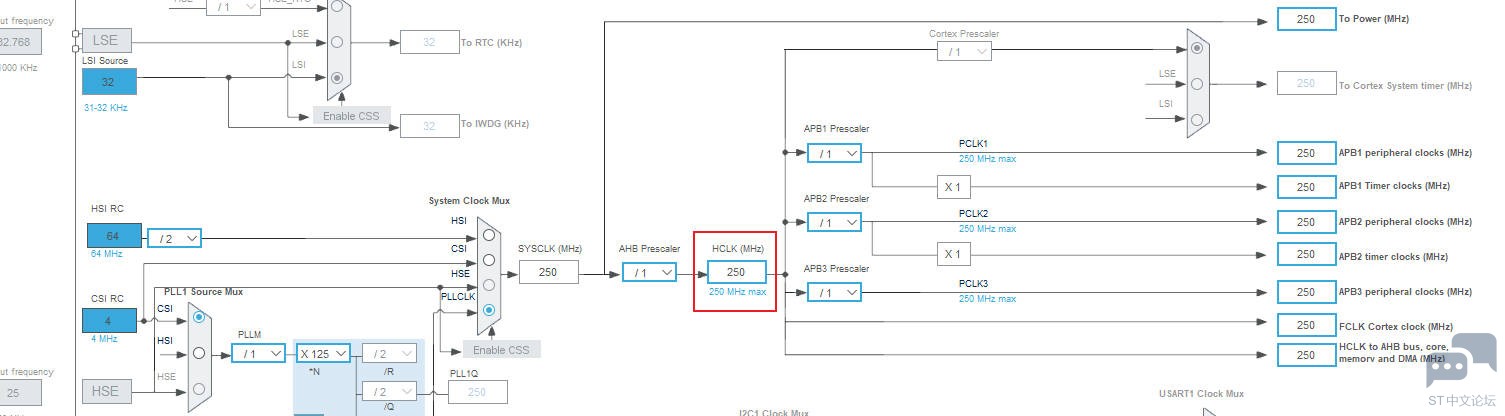 6 z: W3 o* a4 U) }( _
我是生成的CubeIDE代码,生成完之后打开工程进行了一下编译,通过之后就可以写代码了。 D! ]) B+ D/ B$ p. S+ m/ }6 g
: h$ a3 C. E1 ~2 O: K W' `" m
- 第一项测试:任务切换速度
' {# J& o1 i% x! Z1 V. D: n6 X
9 n [/ O. e! ?- r# M
核心思路: 用两个任务 + 两个信号量,构造一个"乒乓"结构,精确测量从一个任务放弃CPU到另一个任务真正开始运行之间的时间,使用DWT计时。8 t z& H1 }# L1 o
DWT 计时是 Cortex-M 内核自带的 Data Watchpoint and Trace (DWT) 模块中的 CYCCNT 周期计数器来实现的高精度计时方法。8 K: m! y ?: n
' M& k" S# x9 cCPU 主频 = 250MHz
" }; K8 n; K3 Q: D% j5 q1 个周期 = 4ns
# n4 q+ @0 m; j- Z& u& u/ Z
9 x0 s0 ]1 N; G% m; v- static void task_a_entry(ULONG arg)
) }9 ~" H8 |* ^$ _ r0 ?" S - {+ O' i3 j3 ]: Q( c
- (void)arg;
: l' A; e1 v8 U: [+ J - while (switch_count < SWITCH_ITERATIONS)
* ]" I0 k/ x& Q2 o2 L Q0 f) g - {! n: D0 b z( D, [* r- P
- switch_start_cycle = DWT_GET();8 D |2 L% t$ f
- tx_semaphore_put(&sem_a2b);, a! g0 S0 Q; K$ s! Q
- tx_semaphore_get(&sem_b2a, TX_WAIT_FOREVER);% D* F% f9 Z* o
- }2 P7 Z4 l0 N( r
- tx_thread_suspend(&task_a);% @" _) _, U# b7 o- s$ `
- }
( T; E7 ~0 }. t5 B% Y' b/ S u& ] - ( Y& T2 Q s0 l- }5 g
- static void task_b_entry(ULONG arg): ^1 c9 b( }7 c
- {8 M- [% R8 `$ O3 N0 S8 Q( r
- (void)arg;
/ W: R( O" k* `2 ` - while (switch_count < SWITCH_ITERATIONS)- p/ {2 U# ^; l7 j8 U
- {) F! Z+ m$ o; A, n. s
- tx_semaphore_get(&sem_a2b, TX_WAIT_FOREVER);
) I. h# t: \% n& t3 B( A, R% O4 ]4 U - switch_samples[switch_count] = DWT_GET() - switch_start_cycle;
/ D' v* c4 o! _9 D4 g! o# x* c - switch_count++;8 X/ }; |" X- e v8 I
- tx_semaphore_put(&sem_b2a);0 v! p, g' p% ^+ T
- }# E9 y& o. r7 e
- tx_thread_suspend(&task_b);
! t: ~2 A4 w' f, t0 X+ G1 P - }
: p/ r7 ?6 V3 p
; `" P, U, Q1 s/ N: u% x- 第二项测试:中断响应速度
" \' ]! Q- d5 Q7 _1 O: Z; v4 `
- u, ]% O4 H) B7 I H2 u主要测试的是从触发中断的那条指令执行完到ISR 第一条指令开始执行之间的时间,同样使用DWT计时。
, z2 D5 K0 U+ N$ G! t4 z& V, c这里直接使用NVIC_SetPendingIRQ,写 NVIC 的 pending 寄存器,绕过外设,测出来的是纯粹的 CPU 中断响应时间,更干净。
% W( f( n T: g* [: y4 v( ]- #define TEST_IRQ_NUM TIM7_IRQn /* 软件触发,TIM7 未被项目使用 */
% P+ {/ w3 a# k+ A: p# v$ o9 n
h# C: N% e* Y- void TIM7_IRQHandler(void)" } o2 R; I/ N( Z# ?
- {
0 t4 R6 E8 W2 X1 N - irq_samples[irq_count] = DWT_GET() - irq_trigger_cycle;
# V1 `. A7 |( {; g - irq_count++;# b6 ^0 L+ b4 k, H% f
- NVIC_ClearPendingIRQ(TEST_IRQ_NUM);% O9 U. ]9 B5 f! u4 E
- }
7 v/ L7 V+ V1 l - static void run_irq_test(void)2 l1 ~& E M% g- l; C
- {5 B R8 H- K1 T& X" G
- irq_count = 0;. w# ~1 `9 Y3 k |# a
4 K4 N) V6 Z4 ^% Y0 P4 T- NVIC_SetPriority(TEST_IRQ_NUM, 0);
* E) G y m" X8 D. g. B3 Q- a - NVIC_EnableIRQ(TEST_IRQ_NUM);
+ a2 Q3 _8 i3 s/ E. \9 q - for (uint32_t i = 0; i < IRQ_TEST_ITERATIONS; i++)
0 D1 o* J) n, y, J. [- H - {2 W9 u( o1 T% Z# `* T
- irq_trigger_cycle = DWT_GET();
9 X/ I& T! ^1 o$ d9 j5 p - NVIC_SetPendingIRQ(TEST_IRQ_NUM);. z( |5 H6 n/ Q# r# S
- while (irq_count <= i)
/ e, a) p; X/ C- ^$ i - __NOP();
/ b" ~9 Q4 O( k9 S7 N - }5 K7 q% o& R/ V2 \) [( b, | ~* J9 U
- NVIC_DisableIRQ(TEST_IRQ_NUM);
6 _7 Z$ J# Y/ J, ?4 M - print_percentiles("[2] IRQ Latency", irq_samples, IRQ_TEST_ITERATIONS);
$ Y1 q! N t4 J4 K; ^1 F' C9 z - }
( e1 O5 U; Y0 b4 U* r2 {' H
然后编译运行结果如下:3 t7 i) D3 r& T6 t, F4 _: h+ h. P/ c2 Z
0 Q) M4 I4 U/ ?- p# g- g' z. |
========================================
7 N, v }4 ^+ w0 W9 M3 A' b STM32H5E5 CPU Performance Test
: k% ]3 Y$ L0 h Core: Cortex-M33 @ 250 MHz& l( d6 l1 }- N5 G8 d- m- _, u3 }
RTOS: Azure RTOS ThreadX8 n! m! ~- P+ u+ y& ~
========================================/ w3 T2 g' A% r' O
% b& v" H; F8 X[1] Task Context Switch Test (1000 iterations)...+ P! G7 k8 X, q; Y- S
[1] Task Switch (n=1000):
* [9 k% r1 I8 @ P50 = 656 cycles = 2624 ns6 v0 _& r, p% F6 Q& q. x
P95 = 656 cycles = 2624 ns: {; Y, {, C+ D4 @! S9 b( @% {
P99 = 656 cycles = 2624 ns' p9 e# [2 X' F; E) o1 `
MAX = 6586 cycles = 26344 ns
; r7 x# a s, Q, g+ @4 p9 p" d1 |4 x, P0 c% [* f4 b0 n2 Q4 R
[2] IRQ Response Latency Test (1000 iterations)...
; i. a) Q1 C/ w! c) F* e[2] IRQ Latency (n=1000):
% @% p2 ]3 e6 o# e! h4 `4 J! T P50 = 47 cycles = 188 ns
9 v: d5 b# u% @/ d4 Z) e: E6 G- k P95 = 47 cycles = 188 ns6 W# p1 Q+ d- Z% ]# \7 x
P99 = 47 cycles = 188 ns
5 |3 M5 u4 R8 ]: C- ^- { `/ E# B0 t( e MAX = 90 cycles = 360 ns& V5 N- w' J/ ^7 _
* n% H" b& g, d) f1 p8 q A- r
: X+ j# ^$ f7 U: S. V: p; T/ D这里P50/P95/P99表示在这1000个点中有百分之多少的值小于等于后面的值,比如P50 = 656cycle,也就是有50%的值小于等于656cycle。
3 y& y2 l# T- u3 v* a所以数据看着还是很稳定的,99%的值都是稳定的,MAX这个值就是异常值,我猜测可能是systick中断插入其中导致的,这个可以忽略。' A! i) |- X! }
8 M/ K" j; N2 \2 N3 ~3 }
但是这个测量值会不会有点长,任务切换需要2.6us,以前也没测过这个,看看能不能优化一下,比如改改编译配置什么的。
( Z; y3 Z. D! O* H$ u& l* C
* L& E! X p s/ X* z于是我尝试修改编译优化,关闭FPU,因为FPU上下文保存会占用cycle,修改如下:
3 n" k" s% p4 r3 z" r, c
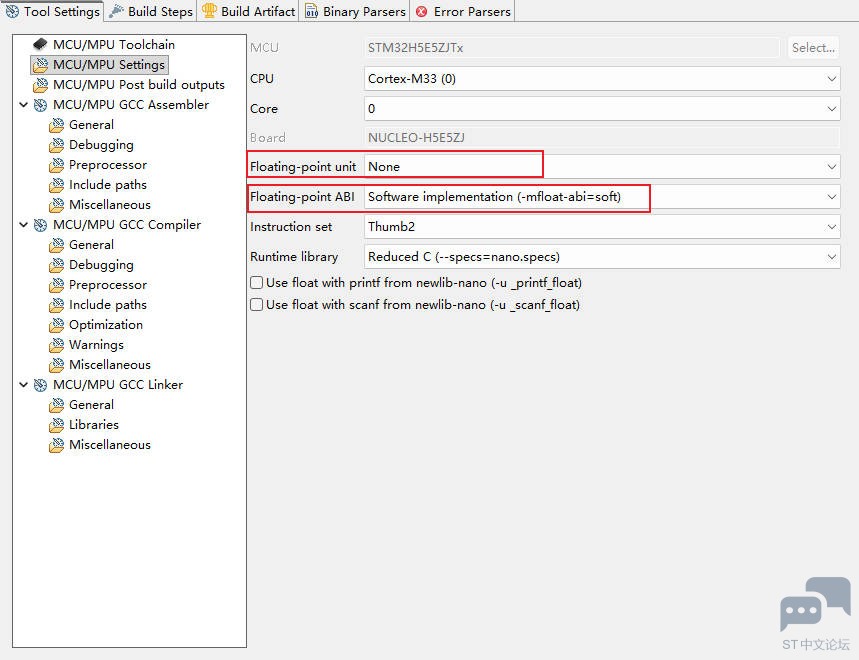
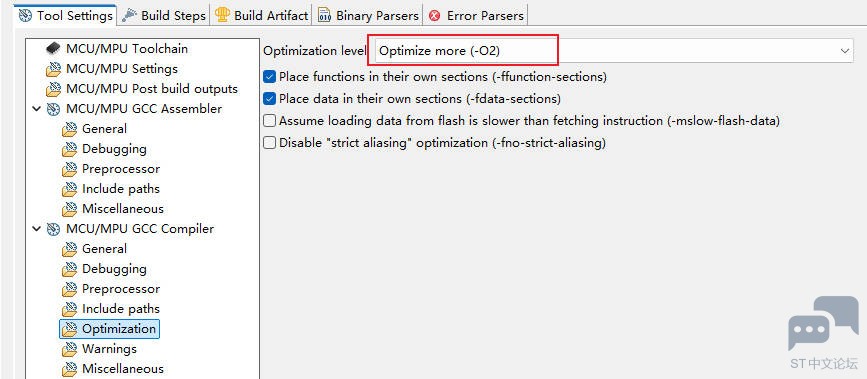
+ n6 b/ }8 ~+ @- j8 h+ V7 B1 R1 j然后重新编译烧录运行结果如下:: r; A8 f+ I- p3 l
/ S" s, i" j% Q$ _& x
========================================
2 I, W9 F+ h+ M- e% A STM32H5E5 CPU Performance Test
# f; Y% M1 ?% w4 Z Core: Cortex-M33 @ 250 MHz4 |) x7 o, J8 R/ o: P" Q' f! P
RTOS: Azure RTOS ThreadX
8 e6 \, |& }, e7 ?! e1 q, P========================================
$ c0 G3 Z( _6 Q# h/ |
3 [- ?, w4 K6 R) Z! Y/ w8 N. q[1] Task Context Switch Test (1000 iterations)..." z$ L. z9 ~: e S
[1] Task Switch (n=1000):
+ a4 E& X7 C& ]1 |7 g; H3 H P50 = 380 cycles = 1520 ns; K' r- Y5 V. |) j
P95 = 380 cycles = 1520 ns
0 a8 d1 g1 }* p% {/ t3 c P99 = 380 cycles = 1520 ns
, c) H- k$ |& z) V6 A- _: X MAX = 5833 cycles = 23332 ns7 K# K* }/ ?. Z3 i' d1 Y
: }+ I, e" n0 m; e6 z
[2] IRQ Response Latency Test (1000 iterations)...
4 x+ W+ G$ X0 B1 u[2] IRQ Latency (n=1000):
; A6 E; I$ w8 A6 D. x0 J0 P1 Z P50 = 22 cycles = 88 ns
9 h" A7 h% _ `+ t/ p8 l P95 = 22 cycles = 88 ns
3 T' x; U( p. \$ ]. [, o. |( J l P99 = 22 cycles = 88 ns+ `, G! l, B2 N: c( K* b: n8 L4 i
MAX = 41 cycles = 164 ns
8 x( U" E. t' D
5 g3 v' |' L$ j
' b. E' b8 e' @5 I" i# A修改之后确实快了很多啊,P99就能看出性能还是非常稳定的。
& d& O1 B1 a' C! r/ U整个测试还是比较简单,当然应该还有不同的测试方法,可能还可以继续优化提升性能。+ N" d% F" _0 H: R5 c
; p3 a: _2 q* [6 G5 z% Z% r9 J6 h4 Z
9 A% F# g. X% G ?* _ |





 微信公众号
 手机版


