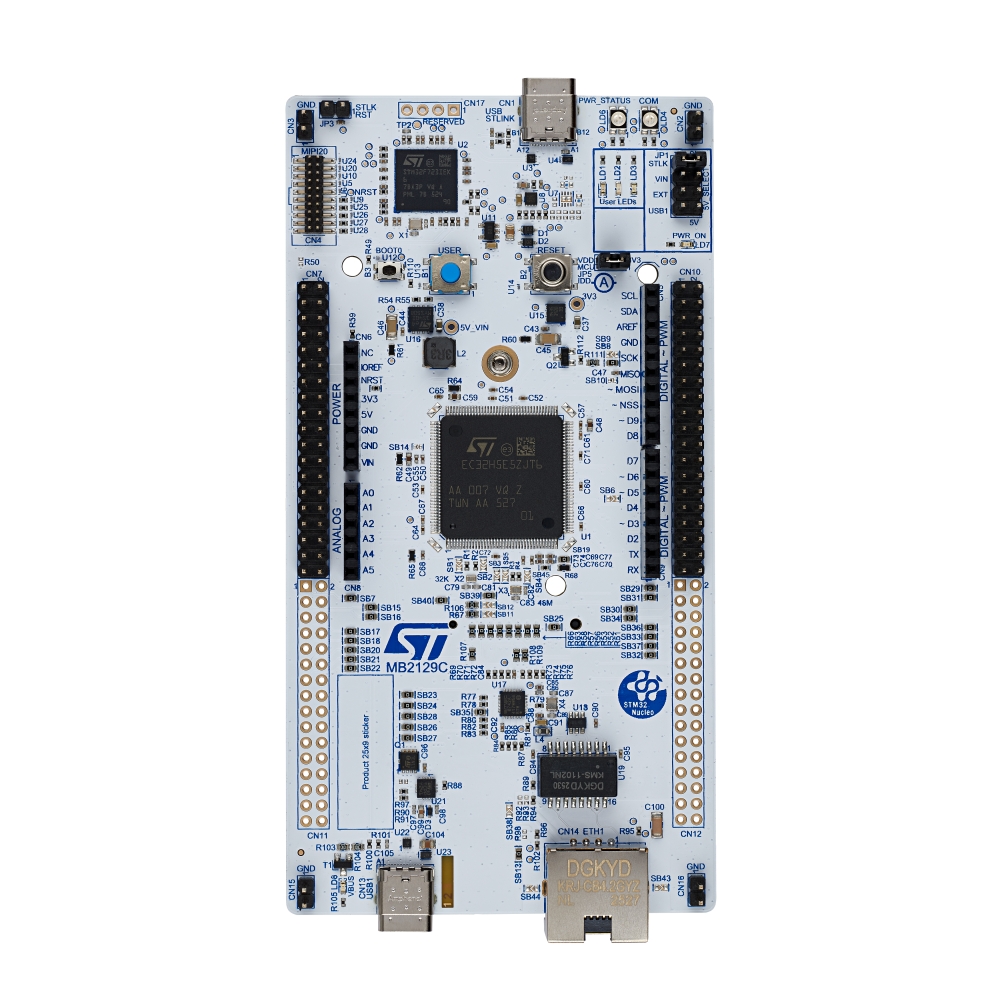
在上一次的测试CPU性能的工程基础上修改,来测试存储读写性能。去掉CoreMark组件,写一个存储测试案例。$ t, ^5 w6 z! B* [( A: [
H# G+ v; F; h- d( O3 E- e# v 计数仍然使用DWT,这是Cortex M的便利用法。所有测试共用同一套计时骨架:每项连续跑 10 轮,DWT CYCCNT 计取每轮周期数,报 min / avg / max 三个值。单次计时受总线仲裁、Flash 等待周期抖动影响很大,只报单次数字的内存跑分基本不可信。32 位 CYCCNT 在 250MHz 下约17 秒回绕一次,无符号减法天然处理回绕。带宽换算公式:MB/s = 字节数 × 主频(MHz) ÷ 周期数。4 @6 `( Y, V! Y! `1 H% q1 W% P
- a s5 L/ [+ x9 g4 u' }
- bench_stat_reset(&st);
0 M6 a, |8 W( Q, G- v! Z# t* m0 ?- A - for (r = 0; r < MEM_ROUNDS; r++) { /* MEM_ROUNDS = 10 */
1 ?4 _5 c- G2 @% d; p - uint32_t t0 = perf_cycles();
0 M3 z+ v5 ^* q9 m5 g F- | - fn(words); /* 单轮:完整扫过 256KB */
, G3 V0 n5 K, g: K: D( ? - bench_stat_add(&st, perf_cycles_elapsed(t0, perf_cycles()));
- k& n c* J, Q1 j - }
0 h$ H0 v3 B& W: V6 `6 O+ E* M& f
; K6 ?" N( T' d, Z1 @6 V
8 ~ U, R; U& ?7 J! \$ s2 {- stat ic void pass_sram_read(uint32_t words)
. d7 _6 F/ q" d r - {8 `" C3 s: p) u
- uint32_t a0 = 0, a1 = 0, a2 = 0, a3 = 0;( R7 S; j5 D1 h R* K
- for (uint32_t i = 0; i + 4 <= words; i += 4) {$ `6 K# l2 Q0 q
- a0 += s_src[i]; /* 4 组累加器:读带宽由总线决定 */ o/ Z6 o& D/ [, x. Y8 E& U
- a1 += s_src[i + 1]; /* 而不是被加法依赖链卡住 */2 l+ r9 |3 j0 j: e7 u) }/ l! o4 m
- a2 += s_src[i + 2];" `& V5 l7 y+ b0 }" A9 `
- a3 += s_src[i + 3];
' I/ t2 f$ P* v# v3 y3 @7 o" J - }* c$ W @( g3 i& Q6 j# U" Q
- s_sink ^= a0 ^ a1 ^ a2 ^ a3; /* 结果被消费,循环不可删 */
: \% g* E5 T+ | - }
4 ~! g8 B% q/ k# Z: M, A
- }* f6 ^2 H( ^7 K% r: X- while (left > 0) {
# Z( A {1 ~ p% k, q" M- R7 u- _ - uint32_t n = (left > DMA_CHUNK_BYTES) ? DMA_CHUNK_BYTES : left; /* 32KB */
% q. c4 K% p3 j+ A3 G a1 m1 j) r - HAL_DMA_Start(&s_hdma, (uint32_t)sp, (uint32_t)dp, n); /* n 单位=字节 */
9 u K$ r+ b- y& z- S - HAL_DMA_PollForTransfer(&s_hdma, HAL_DMA_FULL_TRANSFER, 100);
- w4 y' N3 P, N- A8 J - sp += n; dp += n; left -= n;
. V$ G! I K: R0 B/ v - }! b* B, F4 }5 U t( K
; G9 i, v, B2 o( ?: I! R
- HAL_FLASH_Unlock();
" }, s" O4 P" w( E/ ]6 r8 n" t - HAL_FLASHEx_Erase(&erase, §or_err); /* 擦 1 个 8KB 扇区 */
1 Z8 A' o v7 \1 a - for (i = 0; i < FLASH_SECTOR_SIZE; i += 16) { /* quadword 编程 */2 ` }0 b6 ~- m( X2 P
- HAL_FLASH_Program(FLASH_TYPEPROGRAM_QUADWORD,7 n2 s; G- `$ H' [+ }2 _4 Q
- FLASH_TEST_ADDR + i,/ ^9 V2 ?3 c u2 o+ d
- (uint32_t)((const uint8_t *)s_src + i));
2 n/ ?0 E+ Y; e9 U3 t i' C5 x8 b - }* K) g" n6 S. M
- HAL_FLASH_Lock();
* U4 K* ]! x$ y; I) n9 Q
" S! J# x }" p
; m* j$ [$ D C3 U! ~0 S4 W- [M1]
8 K" Y; z2 p Y9 ^ - [14:35:14.760]收←◆CPU streaming access BW (256KB x 10 rounds, min/avg/max)0 D: g7 p; C6 r: p, z8 q4 V
- SRAM write : 166.54 MB/s (best) 166.49 MB/s (avg) 166.43 MB/s (worst). n, r; @% b! [2 m
- SRAM read : 307.51 MB/s (best) 307.34 MB/s (avg) 307.28 MB/s (worst)
2 [" U1 G2 L# f - Flash read : 190.21 MB/s (best) 189.74 MB/s (avg) 189.54 MB/s (worst)4 _( \' u3 Z( e9 R
6 i' ?# e) l! e1 n2 s( l- [M2] CPU copy BW (SRAM->SRAM 256KB)* C9 {# A0 I3 z) \
- 8 f# c% ]0 U0 w! f! ]6 J6 X/ I
- [14:35:14.872]收←◆ hand loop : 41.62 MB/s (best) 41.62 MB/s (avg) 41.61 MB/s (worst)7 d C, H$ R3 P2 ]6 d" D
- ) }- h1 N. a4 @
- [14:35:14.942]收←◆ libc memcpy : 41.62 MB/s (best) 41.62 MB/s (avg) 41.61 MB/s (worst)! o& W( |4 O+ Q! c
- ; c2 i3 O* j6 w& ^! X
- [M3] GPDMA1_CH0 transfer BW (word width, 32KB polled chunks)! x; d) `7 r7 {
- DMA SRAM->SRAM: 376.81 MB/s (best) 376.77 MB/s (avg) 376.69 MB/s (worst)
" T' |2 m) \1 H) Y- L& _# t% C d1 x - DMA Flash->SRAM: 265.73 MB/s (best) 265.73 MB/s (avg) 265.69 MB/s (worst)6 |" ] s R9 i. A" e1 b3 h& b- D
- integrity check : PASS2 e+ h6 g. ~/ y( \4 _
- ) h0 S) d$ d, w
- [M4] GPDMA data width impact (SRAM->SRAM 256KB)
: @; y$ A% L* y" }4 O" @$ e' l7 _ - byte width : 161.83 MB/s (best) 161.82 MB/s (avg) 161.81 MB/s (worst)
9 e# O& S/ a f7 ]' O/ O; w - word width : 376.81 MB/s (best) 376.78 MB/s (avg) 376.73 MB/s (worst)3 _' n2 j( a7 s( l3 v8 H( U
- ' _7 W% K4 s/ S* v- n* T
- [M5] Copy BW vs block size (avg of 5 runs)3 ~0 D# Y6 ]: I$ z0 ] a* V
- block(kB) CPU hand-loop GPDMA(word)8 A( B, Z. F3 p2 |. h( T
- 1KB 41.54 MB/s 339.52 MB/s0 M% M. P* V" R
- 4KB 41.63 MB/s 382.08 MB/s
9 r; V( P/ v$ R# b: J - 16KB 41.65 MB/s 386.96 MB/s
3 M$ i( V6 ]) @ h7 r* G+ x3 z - 64KB 41.63 MB/s 372.01 MB/s, Q- }( J9 t, _6 u: c5 Z
- % x: G. I% l' I) F0 e( M( |: q
- [14:35:15.101]收←◆ 256KB 41.62 MB/s 376.87 MB/s( ]# j" W$ w6 x/ S
- # Y4 E/ }; ~: T8 ] G/ F* S( m5 w
- [M6] FLASH program test (Bank1 Sector200 @0x08190000, 8KB)
2 P" W) }- L2 m' Y - erase (8KB sector) : 1.658 ms8 S" _+ b1 q4 M0 V
- program 8KB time : 16.469 ms -> 497.39 KB/s0 m9 i( |. r1 n9 z/ m. J
- read-back verify : PASS
& @, m$ v# z; U3 G$ b2 U
8 N* ~, Z4 w9 E+ I% G7 x
1、CPU 从 Flash 读(189.7 MB/s)明显慢于 DMA 从 Flash 读265.7 MB/s,CPU 取数要多付循环与流水线开销。 2、普通情况下的手写拷贝和newlib memcpy性能一致 3、GPDMA 搬运几乎不受 CPU侧干扰,SRAM→SRAM可达376.81 MB/s, Flash→SRAM可达265.73 MB/s,性能很好 4、DMA带宽配置越高则搬运速度也越高,直接使用可考虑冗余操作 3 X8 T6 m- m" ?: `5 n% {
|





 微信公众号
 手机版