STMCU小助手
发布时间:2022-6-5 21:00
|
Cortex-M3缩略语 AMBA:先进单片机总线架构 ADK:AMBA设计套件AHB:先进高性能总线 AHB-AP:AHB访问端口APB:先进外设总线 ARM ARM:ARM架构参考手册ASIC:行业领域专用集成电路 ATB :先进跟踪总线BE8:字节不变式大端模式 CPI:每条指令的周期数DAP:调试访问端口 DSP:数字信号处理(器)DWT:数据观察点及跟踪 ETM:嵌入式跟踪宏单元FPB:闪存地址重载及断点 FSR:fault状态寄存器HTM:Core Sight AHB跟踪宏单元ICE:在线仿真器 IDE:集成开发环境IRQ:中断请求(通常是外中断请求)ISA:指令系统架构 ISR:中断服务例程ITM:仪器化跟踪宏单元 JTAG:连接点测试行动组(一个关于测试和调试接口的标准)LR:连接寄存器LSB:最低有效位MSB:最高有效位LSU:加载存储单元MCU:微控制器单元MPU:存储器保护单元MMU:存储器管理单元MSP:主堆栈指针NMI:不可屏蔽中断NVIC:嵌套向量中断控制器PC:程序计数器PPB:私有外设总线数值 1. 4''hC , 0x123 都表示16进制数 ( J& p/ s& F; y 2. #3表示数字3 (e.g., IRQ #3 就是指3号中断) 3. #immed_12表示一个12位的立即数 4. 寄存器位。通常是表示一个位段的数值,例如 bit[15:12] 表示位序号从15往下数到12,这一段的数值。 寄存器访问类型 R :表示只读 9 C4 r& \$ T$ E" B3 T% O: u) S W:表示只写 RW :表示可读可写(前3条好像地球人都知道) ' Z& x0 ^+ S- R6 x! I7 S7 x R/Wc :表示可读,但是写访问将使之清 0 Cortex-M3芯片简介 芯片的基本结构如下图:( e& b3 P" N* R. d. V9 {5 U: F( v+ a0 Q1 V( R ( z1 E2 l5 b( y8 u t' }% n# w) f/ g, c$ z2 k " ^# A" a- e0 u9 } K- Z! A7 C8 o6 ^ 在这个版本中,内核架构首次从单一款式变成3种款式:
介绍:
高性能+高代码密度+小硅片面积,使得CM3大面积地成为理想的处理平台,主要应用在以下领域:
(1)简介7 d! \# w/ `" C0 m6 G$ T Cortex-M3是一个 32位处理器内核。内部的数据路径是 32位的,寄存器是 32位的,存储器接口也是 32 位的。CM3 采用了哈佛结构,拥有独立的指令总线和数据总线,可以让取指与数据访问并行不悖。这样一来数据访问不再占用指令总线,从而提升了性能。为实现这个特性, CM3内部含有好几条总线接口,每条都为自己的应用场合优化过,并且它们可以并行工作。但是另一方面,指令总线和数据总线共享同一个存储器空间(一个统一的存储器系统)。 比较复杂的应用可能需要更多的存储系统功能,为此CM3提供一个可选的MPU,而且在需要的情况下也可以使用外部的 cache。另外在CM3中,Both小端模式和大端模式都是支持的。0 p+ v7 |& E% a % Q( D* J% @2 k3 ?( v9 N) [$ A (2)Cortex-M3的简化图 & ~/ u1 `: l; ^" k+ F3 A8 Y1 N (3)寄存器组 处理器拥有R0-R15的寄存器组,其中R13最为堆栈指针SP,SP有两个,但是同一时刻只能有一个可以看到,这就是所谓的“banked”寄存器。# b7 K3 @" S% {! L( o% u $ h4 H3 l( G4 k# m" W4 \ ; p! I* A" Z3 V3 S1 |- M2 D: Q$ r
0 P( M. A; r9 h9 b Cortex-M3处理器支持两种处理器的操作模式,还支持两级特权操作。 两种操作模式分别为:处理者模式和线程模式(thread mode)。引入两个模式的本意,是用于区别普通应用程序的代码和异常服务例程的代码——包括中断服务例程的代码。 Cortex-M3 的另一个侧面则是特权的分级——特权级和用户级。这可以提供一种存储器访问的保护机制,使得普通的用户程序代码不能意外地,甚至是恶意地执行涉及到要害的操作。处理器支持两种特权级,这也是一个基本的安全模型。 ~! z# I2 S5 M# m/ Y . l7 f& k; j& I" m& P 9 J) I" |2 j$ I& q8 \ y1 b 在 CM3 运行主应用程序时(线程模式),既可以使用特权级,也可以使用用户级;但是异常服务例程必须在特权级下执行。复位后,处理器默认进入线程模式,特权极访问。在特权级下,程序可以访问所有范围的存储器(如果有 MPU,还要 在MPU规定的禁地之外),并且可以执行所有指令。 在特权级下的程序可以为所欲为,但也可能会把自己给玩进去——切换到用户级。一旦进入用户级,再想回来就得走“法律程序”了——用户级的程序不能简简单单地试图改写 CONTROL寄存器就回到特权级,它必须先“申诉”:执行一条系统调用指令(SVC)。这会触发SVC异常,然后由异常服务例程(通常是操作系统的一部分)接管,如果批准了进入,则异常服务例程修改 CONTROL寄存器,才能在用户级的线程模式下重新进入特权级。 事实上,从用户级到特权级的唯一途径就是异常:如果在程序执行过程中触发了一个异常,处理器总是先切换入特权级,并且在异常服务例程执行完毕退出时,返回先前的状态。 0 q9 S9 V8 }; p" E6 g ) j: D& Y6 X5 x0 j5 M 0 n$ f" A8 [- Y2 C% e @ 通过引入特权级和用户级,就能够在硬件水平上限制某些不受信任的或者还没有调试好的程序,不让它们随便地配置涉及要害的寄存器,因而系统的可靠性得到了提高。进一步地,如果配了 MPU,它还可以作为特权机制的补充——保护关键的存储区域不被破坏,这些区域通常是操作系统的区域。 (4)内建的嵌套向量中断控制器 Cortex-M3 在内核水平上搭载了一颗中断控制器——嵌套向量中断控制器 NVIC(Nested Vectored Interrupt Controller)。它与内核有很深的“亲密接触”——与内核是紧耦合的。NVIC提供如下的功能:
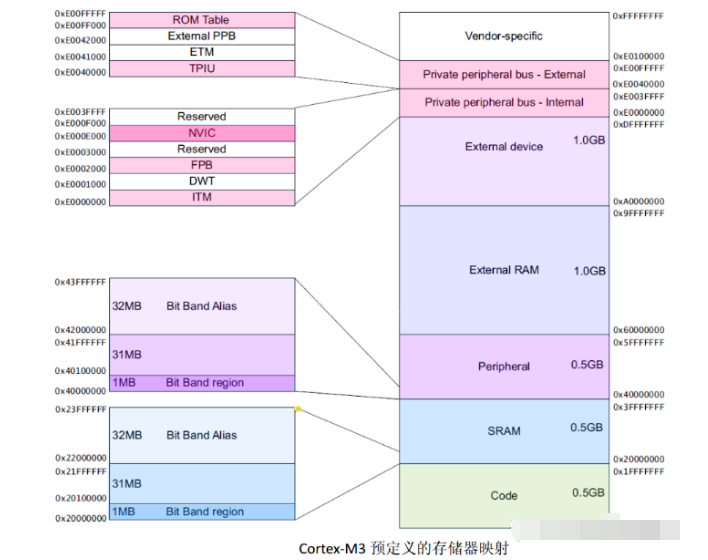
向量中断支持: 当开始响应一个中断后,CM3会自动定位一张向量表,并且根据中断号从表中找出 ISR的入口地址,然后跳转过去执行。不需要像以前的 ARM那样,由软件来分辨到底是哪个中断发生了,也无需半导体厂商提供私有的中断控制器来完成这种工作。这么一来,中断延迟时间大为缩短。$ n1 s {8 [/ d) I1 ` ( m6 d) u+ {/ K% T E0 } (5)存储器映射 Cortex-M3支持4G存储空间,具体分配如下图: 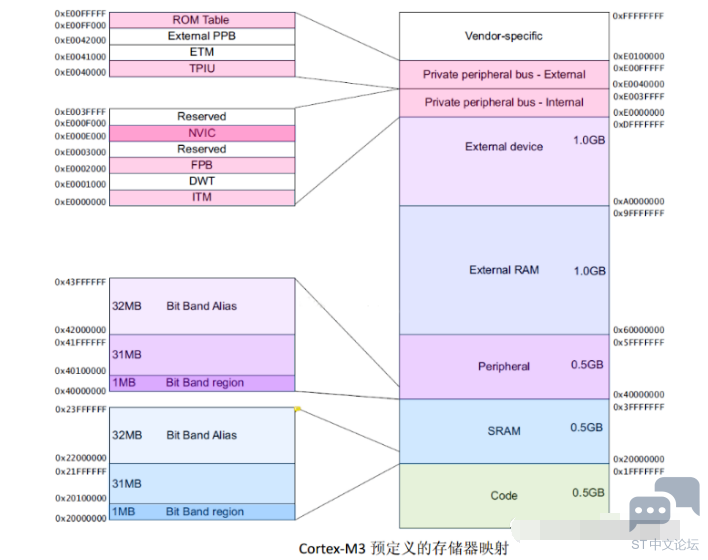
5 s" |+ [! O% }) ^7 R( T3 v8 q- P (6)总线接口 Cortex-M3内部有若干个总线接口,以使 CM3能同时取址和访内(访问内存),它们是: # L/ D( C( ~* ^8 }7 F& ~. h6 i: A
有两条代码存储区总线负责对代码存储区的访问,分别是 I-Code 总线和 D-Code 总线。前者用于取指,后者用于查表等操作,它们按最佳执行速度进行优化。 系统总线用于访问内存和外设,覆盖的区域包括 SRAM,片上外设,片外 RAM,片外扩展设备,以及系统级存储区的部分空间。 私有外设总线负责一部分私有外设的访问,主要就是访问调试组件。它们也在系统级存储区。 (7)存储器保护单元(MPU) : D5 y+ h) R9 i1 e1 r Cortex-M3有一个可选的存储器保护单元。配上它之后,就可以对特权级访问和用户级访问分别施加不同的访问限制。当检测到犯规(violated)时,MPU 就会产生一个 fault 异常,可以由fault异常的服务例程来分析该错误,并且在可能时改正它。 MPU 有很多玩法。最常见的就是由操作系统使用 MPU,以使特权级代码的数据,包括操作系统本身的数据不被其它用户程序弄坏。MPU在保护内存时是按区管理的。它可以把某些内存 region设置成只读,从而避免了那里的内容意外被更改;还可以在多任务系统中把不同任务之间的数据区隔离。一句话,它会使嵌入式系统变得更加健壮,更加可靠。 很多行业标准,尤其是航空的,就规定了必须使用 MPU来行使保护职能。: R6 I B6 x3 a+ q, h (8)Cortex-M3的简评
Thumb-2的到来告别了状态切换的旧世代,再也不需要花时间来切换于 32位 ARM状态和16位Thumb状态之间了。这简化了软件开发和代码维护,使产品面市更快。 ' T2 e: e( i' [' X1 |0 X Thumb-2指令集为编程带来了更多的灵活性。许多数据操作现在能用更短的代码搞定,这意味着 Cortex-M3的代码密度更高,也就对存储器的需求更少。 取指都按 32位处理。同一周期最多可以取出两条指令,留下了更多的带宽给数据传输。 Cortex-M3的设计允许单片机高频运行(现代半导体制造技术能保证 100MHz以上的速度)即使在相同的速度下运行,CM3的每指令周期数(CPI)也更低,于是同样的 MHz下可以做更多的工作;另一方面,也使同一个应用在 CM3上需要更低的主频。 # f0 s. W$ K$ J/ i4 v" r: }
Cortex-M3在进入异常服务例程时,自动压栈了 R0-R3, R12, LR, PSR 和PC,并且在返回时自动弹出它们,这多清爽!既加速了中断的响应,也再不需要汇编语言代码了。 1 Z" {6 b4 L1 ^7 h$ ]$ I NVIC支持对每一路中断设置不同的优先级,使得中断管理极富弹性。最粗线条的实现也至少要支持 8级优先级,而且还能动态地被修改。7 \ F( d) s4 f3 R, H& c; W9 A 优化中断响应还有两招,它们分别是“咬尾中断机制”和“晚到中断机制”。 * q- }# r, e2 w. x$ x$ e/ d8 m& {8 o 有些需要较多周期才能执行完的指令,是可以被中断-继续的——就好比它们是一串指令一样。这些指令包括加载多个寄存器(LDM),存储多个寄存器(STM),多个寄存器参与的PUSH,以及多个寄存器参与的 POP。" x' x3 S% S( |7 F 除非系统被彻底地锁定,NMI(不可屏蔽中断)会在收到请求的第一时间予以响应。对很多安全-关键(safety-critical)的应用,NMI都是必不可少的(如化学反应即将失控时的紧急停机)。 5 m' i% q) r# M2 { 总结 - b/ n0 e0 m8 X+ ?- ] 以上内容总结了STM32的一些基本知识,希望能为STM32的学习打好基础。9 e- h% n6 d; C5 Z3 B8 |1 D, b! h+ I2 g |
【经验分享】STM32语音识别的智能蓝牙音箱(源程序+原理图+PCB+设计说明书+PPT)
想找个ST芯片
[GPIO] 使用新型抽象开始C++嵌入式编程,从GPIO开始
技术手册stm32f1xx中的一个小问题
【经验分享】STM32 HAL库移植FreeModbus详细步骤
【逢7发帖赢大礼】STM32开发之IC门禁卡UID读取方法!
实战经验 | Keil工程使用NEAI库的异常问题
经验分享 | FDCAN数据段波特率增加后发送失败的问题分析
STM32几种流行开发环境的优缺点
好用软件推荐-TouchGFX Designer
 微信公众号
 手机版