STMCU小助手
发布时间:2022-10-17 22:14
STM32Cube.AI是意法半导体AI生态系统的一部分,是STM32Cube的一个扩展包,它可以自动转换和优化预先训练的神经网络模型并将生成的优化库集成到用户项目中,从而扩展了STM32CubeMX的功能。它还提供几种在桌面PC和STM32上验证神经网络模型以及测量模型性能的方法,而无需用户手工编写专门的C语言代码。
本文将更深入地介绍它的一些高级特性。将涉及以下主题:
STM32Cube.AI支持两种针对不同应用需求的运行时环境:Cube.AI和TensorFlow Lite。作为默认的运行时环境,Cube.AI是专为STM32高度优化的机器学习库。而TensorFlow Lite for Microcontroller是由谷歌设计,用于在各种微控制器或其他只有几KB存储空间的设备上运行机器学习模型的。其被广泛应用于基于MCU的应用场景。STM32Cube.AI集成了一个特定的流程,可以生成一个即时可用的STM32 IDE项目,该项目内嵌TensorFlow Lite for Microcontrollers运行时环境(TFLm)以及相关的TFLite模型。这可以被看作是Cube.AI运行时环境的一个替代方案,让那些希望拥有一个跨多个项目的通用框架的开发人员也有了选择。1 ^( g9 u9 @9 t; a% e $ y0 A, s; f0 }& ?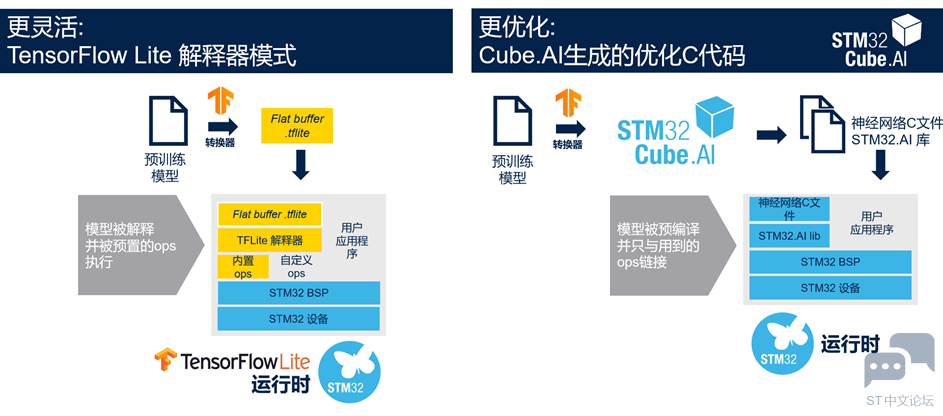
虽然这两种运行时环境都是为资源有限的MCU而设计,但Cube.AI在此基础上针对STM32的独特架构进行了进一步优化。因此,TensorFlow Lite更适合有跨平台可移植性需求的应用,而Cube.AI则更适合对计算速度和内存消耗有更高要求的应用。 下表展示了两个运行时环境之间的性能比较(基于一个预训练的神经网络参考模型)。评价指标是在STM32上的推断时间和内存消耗。 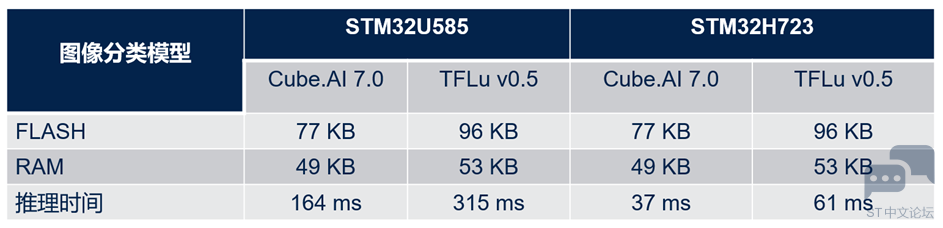
如表中所示,对于同一模型,Cube.AI运行时环境比TFLite运行时环境节约了大概20%的flash存储和约8%的RAM存储。此外,它的运行速度几乎比TFLite运行时环境快了2倍。 对于TFLite模型,用户可以在STM32Cube.AI的网络配置菜单中对2个运行时环境进行选择。 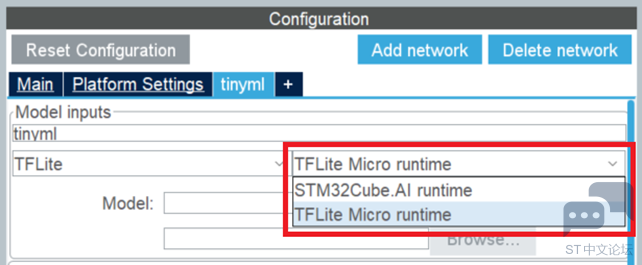
量化支持8 F* N0 Z! p" w; ]* D, l 量化是一种被广泛使用的优化技术,它将32位浮点模型压缩为位数更少的整数模型,在精度只略微下降的情况下,减少了存储大小和运行时的内存峰值占用,也减少了CPU/MCU的推断时间和功耗。量化模型对整数张量而不是浮点张量执行部分或全部操作。它是面向拓扑、特征映射缩减、剪枝、权重压缩等各种优化技术的重要组成部分,可应用在像MCU一样资源受限的运行时环境。7 c& D6 M0 }) O1 d 通常有两种典型的量化方法:训练后量化(PTQ)和量化训练(QAT)。PTQ相对容易实现,它可以用有限的具有代表性的数据集来量化预先训练好的模型。而QAT是在训练过程中完成的,通常具有更高的准确度。3 ?5 a y" g" G. @7 O/ Q STM32Cube.AI通过两种不同的方式直接或间接地支持这两种量化方法:/ Q! Z( q- S6 M a: W
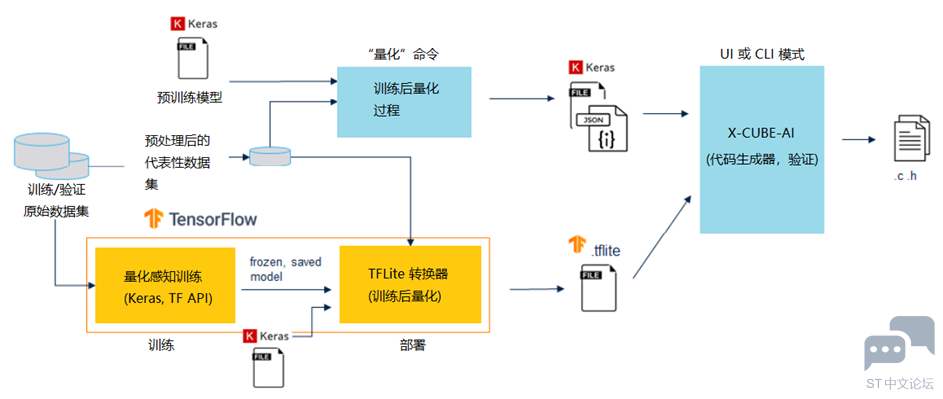
下表显示了在STM32上部署量化模型(与原有浮点模型相比)的好处。此表使用FD-MobileNet作为基准模型,共有12层,参数大小145k,MACC操作数24M,输入尺寸为224x224x3。 w9 U5 @) d/ H- G 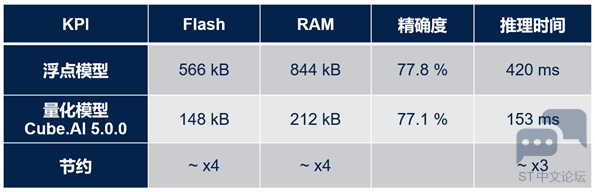
从表中很容易看出,量化模型节省了约4倍的flash存储和RAM存储,且运行速度提高了约3倍,而精确度仅仅下降了0.7%。" O1 [. ^! g4 d1 q0 A; U8 `5 c5 _ 在文档的末尾还附上了一个快速实践示例:“量化一个MNIST模型”。 图形流与存储布局优化$ g( o' s$ y! _1 N; C* T+ P# M 除了量化技术,STM32Cube.AI还通过使用其C代码生成器的优化引擎,针对推理时间优化内存使用(RAM & ROM)。该引擎基于无数据集的方法,无需验证或测试数据集来应用压缩和优化算法。: U; ~- N& h C 第一种方法:权重/偏置项压缩,采用k -均值聚类算法。该压缩算法仅适用于全连接层。其优势是压缩速度快,但是结果并不是无损的,最终的精度可能会受到影响。STM32Cube.AI提供“验证”功能,用于对所生成的C模型中产生的误差进行评估。 “压缩”选项可以在STM32Cube.AI的网络配置中激活,如下图所示: 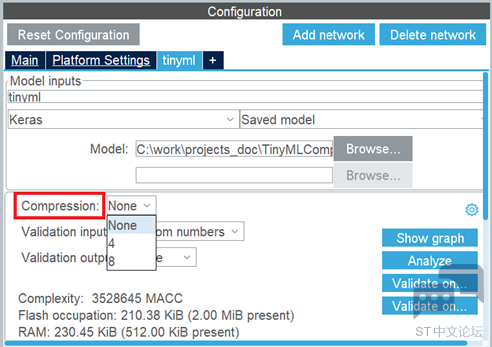
" K+ S4 r2 f8 F0 K8 \ 第二种方法:操作融合,通过合并层来优化数据布局和相关的计算核。转换或优化过程中会删除一些层(如“Dropout”、“Reshape”),而有些层(如非线性层以及卷积层之后的池化层)会被融合到前一层中。其好处是转换后的网络通常比原始网络层数少,降低了存储器中的数据吞吐需求。/ d8 v" l# z, o1 }: x, l! {" |9 Z 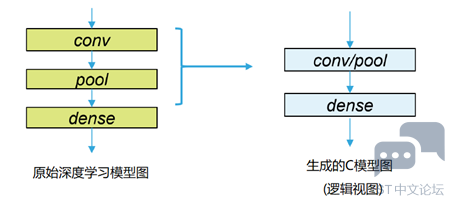
/ v0 {0 x3 J9 g 最后一种方法是优化的激活项存储。其在内存中定义一个读写块来存储临时的隐藏层值(激活函数的输出)。此读写块可以被视为推理函数使用的暂存缓冲区,在不同层之间被重复使用。因此,激活缓冲区的大小由几个连续层的最大存储需求决定。比如,假设有一个3层的神经网络,每一层的激活值分别有5KB, 12KB和3KB,那么优化后的激活缓冲区大小将是12KB,而不是20KB。 可重定位的二进制模型支持! q1 n6 W3 |9 d$ e. `; u 非可重定位方法(或“静态”方法)指的是:生成的神经网络C文件被编译并与最终用户应用程序堆栈静态链接在一起。 如下图所示,所有对象(包括神经网络部分和用户应用程序)根据不同的数据类型被一起链接到不同的部分。在这种情况下,当用户想要对功能进行部分更新时(比如只更新神经网络部分),将需要对整个固件进行更新。% B4 M0 X7 z# R( | ` ( A0 q- _4 U, u* q& I 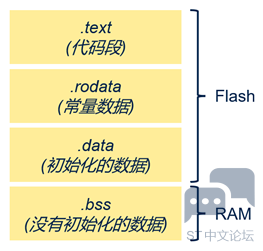
生成的二进制对象是一个轻量级插件。它可以从任何地址(位置无关的代码)运行,其数据也可放置于内存中的任何地方(位置无关的数据)。- p& `+ `" L9 N STM32Cube.AI简单而高效的AI可重定位运行时环境可以将其实例化并使用它。STM32固件中没有内嵌复杂的资源消耗型动态链接器,其生成的对象是一个独立的实体,运行时不需要任何外部变量或函数。 下图的左侧部分是神经网络的可重定位二进制对象,它是一个自给自足的独立实体,链接时将被放置于终端用户应用程序的一个单独区域中(右侧部分)。它可以通过STM32Cube.AI的可重定位运行时环境被实例化以及动态链接。因此,用户在更新AI模型时只需要更新这部分二进制文件。另外,如果有进一步的灵活性需求,神经网络的权重也可以选择性地被生成为独立的目标文件。 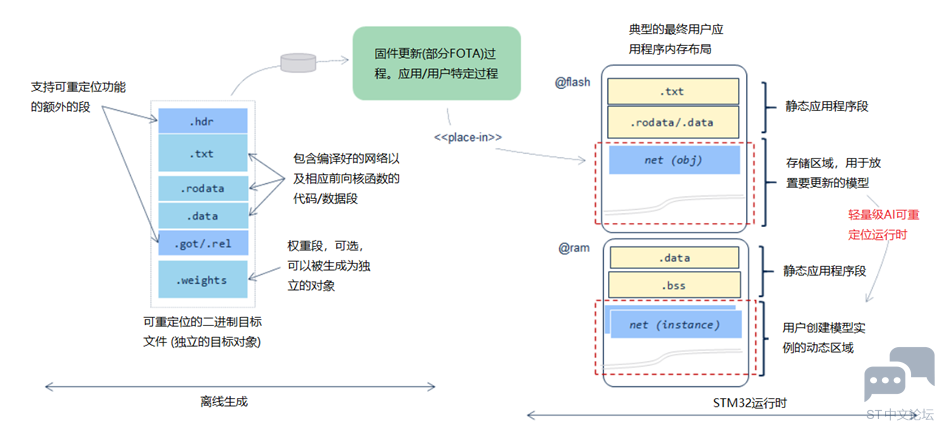
可重定位网络可以在STM32Cube.AI的高级设置中激活,如下图所示: 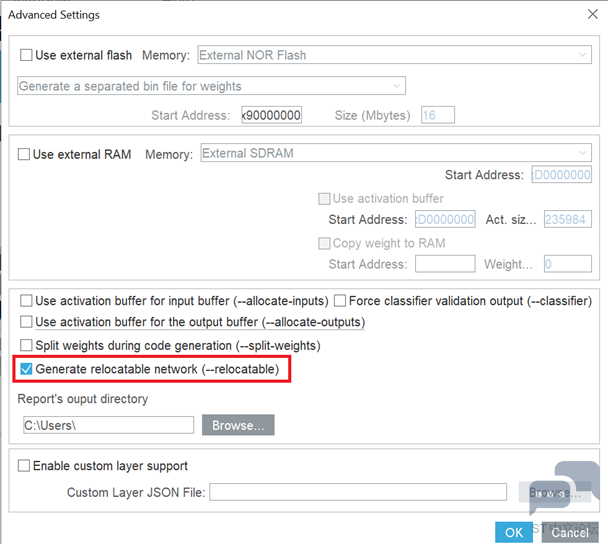
最后,作为意法半导体人工智能生态系统的核心工具,STM32Cube.AI提供许多基本和高级功能,以帮助用户轻松创建高度优化和灵活的人工智能应用。9 q- U( k3 a- Y7 M9 V! m, l |
【STM32H5 评测】ADC 电压表
【STM32H5 评测】基础硬件加密与随机数性能 - STM32H5E5实测硬件AES加解密、HASH运算、TRNG真随机数输出速率与稳定性
【STM32H5 评测】NUCLEO-H5E5ZJ 使用 TrustZone 安全分区系统实践测试
【STM32H5 评测】CPU核心性能 - STM32H5E5跑 RTOS,观察任务切换速度、中断响应快慢
【STM32H5 评测】介绍、环境搭建、工程测试
#双节活动 1.在CubeMX中引用touchGFX出现的问题与解决
如何将STM32CubeMX生成的CMake工程导入STM32CubeIDE
【 逢7发帖赢大礼】1、利用CubeMX生成正点原子H7R7开发板的STM32CubeIDE工程
STM32CubeCLT 1.22.0新版本发布
【下载问题解决】关于ST官网下载软件问题解决
 微信公众号
 手机版