8 S' c2 y' j5 M2 |
01引言
( k$ X9 g; T: f" ?3 U7 L客户在使用 STM32G474 时,希望使用 FPU 进行浮点运算,并最大化其性能。本文 从 STM32G474 系统的角度、ARM DSP Lib、编译选项的影响等几个方面探讨如何提升整体性能,并介绍如何使用 KEIL 工具进行测量。' R- c3 j3 J P$ Y/ U) f
5 ~ o4 s0 X. \. B
02STM32G474 FPU 运算性能优化
5 k; \' ?8 h. N& @ P4 O& P2.1. STM32G474 系统性能优化 ) @2 H/ N. l$ n1 e! Z1 R7 N8 u9 V" c
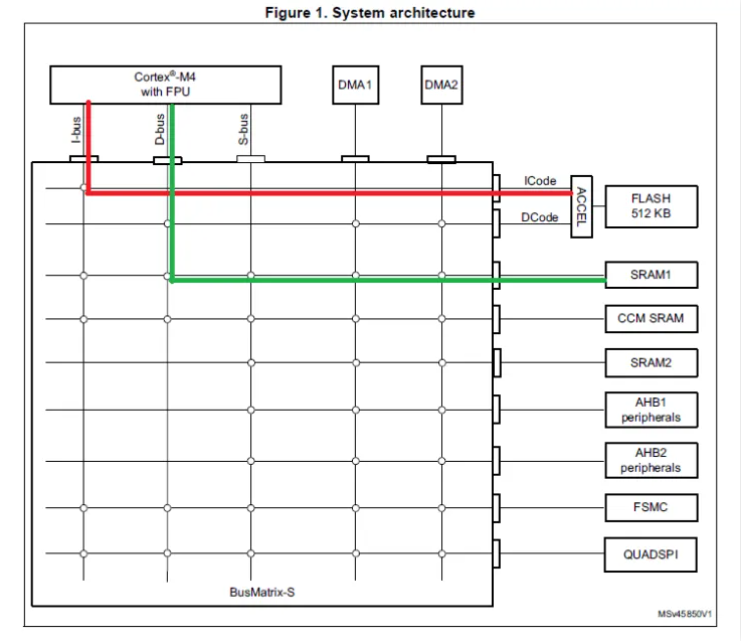
" p5 y% E' H Y3 @+ M+ TSTM32G474 使用的是 ARM Cortex-M4 内核(+FPU)。一般代码会放在 FLASH 区, 通过 I-Bus 读取。这里 STM32G474 有 FLASH 预取指及 CACHE Line, 无需放入 IRAM 或 CCM。因为 Cortex-M4 DSP 指令中没有运算指令与加载指令并行的混合指令,所以数据 存放区域及 Bus 的选择理论上对性能的影响不大。如下图 1 所示,可将 FPU 运算数据放 在 SRAM1。另外还需尽量避免 SRAM 的并发访问,如使能了 DMA,DMA 传输目的地 可以使用 SRAM2,从而减少潜在的 SRAM 并发访问产生的性能下降。应用则需要根据实 际情况,合理使用内存区域。* \* m6 Y" r) A8 @
▲ 图1. STM32G474 架构 / Q8 o. R' ]( x
6 C! q3 y# @/ d2.2. ARM DSP Lib 的使用 / V% U6 j% G5 f6 a; D
在 ARM DSP 库实现了很多 math 算法,可进行浮点乘加、点积、卷积、FFT、NN 等 多种算法 API,可以使用 ARM DSP 库高效使用 FPU。ARM DSP 代码位置如下:
( f0 j: R! v' r5 w. N; c5 n; x4 ?$ N
2.3. 示例代码 7 d& w* u& B4 U: O
下面示例代码中对浮点乘法运算进行了测试。用户可以使用 STM32CubeMX 生成 STM32G474 KEIL 工程,在 main.c 文件中加入如下示例代码:
9 b l$ @' I2 } n5 J4 o; _, s- 7 \7 W5 S8 D0 d
- __attribute__((section (".TEST_INPUT_A"))) float32_t testInputA[1024] =
* K7 u/ m1 m0 Y) i1 a9 D3 H. u, y - {
: K7 `7 g4 S" b - 0.623234f, 0.799049f, 0.940890f, -0.992092f, 0.212035f, 0.237882f, -9 m1 J' d' t7 R
- 1.007763f, -0.742045f,
$ ?0 y, `! C1 a" Q7 Y+ _ - ~~ 这里数组使用动态生成的float数据,数据量较大,略- d' l8 r" `- o6 V; h. T) K
- -0.417470f, -0.205806f, -0.174323f, 0.217577f, 1.684295f, 0.119528f,# w% Z* `! a. A2 ]# b
- 0.650667f, 2.080061f
, A; ]6 d. e+ Z( O% z; I! K - };$ s# L, B2 ?) b- @8 @! C
- __attribute__((section (".TEST_INPUT_B"))) float32_t testInputB[1024] =
; Y0 r% Q; N6 u - {+ I$ M9 g, \ ^7 h7 X
- -2.423957f, -0.223831f, 0.058070f, -0.424614f, -0.202918f, -1.513077f, -
0 f8 r! J/ G' w r2 o' B* F - 1.126352f, -0.815002f,' G9 f6 S) p2 e+ \
) S( ]$ K* v* I7 t6 r- ~~ 这里数组使用动态生成的float数据,数据量较大,略
8 t4 A( O0 U5 y0 U; [ - -0.447001f, -0.725993f, 0.354045f, -0.506772f, -2.103747f, -0.664684f, 1.450110f, -0.329805f
8 [) m% ?0 k+ m - }; $ Y' w6 O4 D3 n
- ( h; @' L$ a7 ?+ J4 X. U: Y
- __attribute__((section (".TEST_RESULT_D"))) float32_t testResult[1024];
2 M. ]% B9 \, r4 q" U6 @
! L! H/ ]8 B, v" s( d/ @, ^' K0 ^- float32_t* pA;2 ~; v. i% a/ f) d" d# [( _ D
- float32_t* pB;
$ a s& s+ q' }# P( @/ g W( m+ e - float32_t* pR;
0 d; x: m1 o; [/ o - /* Private user code --------------------------------------------------*/
+ c9 J; |( o5 f; B1 b* z - /* USER CODE BEGIN 0 */ & J ~8 f& a6 d* H9 ~
- void test_normal_mul(uint32_t kLoops, float32_t*
3 W3 ?5 D k% I" Z - pSrcA, float32_t* pSrcB, float32_t*
4 t) N6 m1 v+ n$ m- i - pResult, uint32_t lenVector) # Z" m$ C) R7 L
- {
/ J: ?0 Y* }. ]% } - for (uint32_t j = 0; j < kLoops; j++) , i9 C7 {$ X5 ^2 T8 ^2 z
- { + S9 S% [5 ~- \
- pA = pSrcA;
& G& e0 a# A& L) I/ ]8 r - pB = pSrcB;
; k1 |# D1 o" I# d+ o# w& ^ - pR = pResult; 4 b0 _( ^8 [& n4 g" T* p. ?
4 D P* H# [9 |% ~% ~+ x- for (uint32_t i = 0; i < lenVector; i++) " F9 C- R) m/ H; j& }0 k7 o5 R3 o
- { *pR++ = (*pA++) * (*pB++) ;
# c4 B: d) E+ q$ G; ~4 Z! V - }
" t: V( Z) ?3 D1 d$ y G - }
/ C3 m" ? u3 v - } ' l9 S! Y1 I+ X
/ b# S% O# I9 x2 i0 ?# E8 [- #if defined (__FPU_USED) && (__FPU_USED == 1U)
- o7 ^2 b! a/ b, K* F - /* Use arm dsp lib to test basic operation Multiply, FPU enabled */ ' M6 r; o1 y/ j
- void test_arm_math_mul(uint32_t kLoops, float32_t* pSrcA, float32_t* pSrcB, float32_t* + Y O; W& I0 O. `6 `* O
- pResult, uint32_t lenVector) 5 m4 s5 g6 q9 C! c" c' a7 c
- {
- O) A3 H: u" S! M2 ] - for (uint32_t j = 0; j < kLoops; j++)
+ |. x4 L; c+ X, W' g - {
$ h2 c6 T0 z( |9 o - pA = pSrcA; //Code alignment with the function without FPU ' d5 { z- m% [ s B5 ]2 R3 _
- pB = pSrcB;
; o5 \2 h; B) r+ s q - pR = pResult;
2 Y% I7 c" g, Q5 d - arm_mult_f32(pA, pB, pR, lenVector); . E9 a2 f! C! U# B/ u
- }
) W5 L2 I6 b- x# z, y- R - } 8 R9 J9 x7 A* C7 z. w }8 A# p- @/ n
- #endif # @4 _2 n9 e5 y# { a6 r6 ?1 D
. m& F T3 w/ ~% T- /** / A0 u1 g% p9 P+ j
- * @brief The application entry point. % f- Q7 M* J2 z0 q1 K' s
- * @retval int
* g, B2 g- `+ W+ B5 d2 |' O: s3 t - */
4 V( x; F) O; q$ q: I1 Q# Q - int main(void)
- |- q4 G6 V7 t9 [8 D - { 3 u7 k& v3 c. I
- /* MCU Configuration------------------------------------------------*/ 1 a. ]0 d8 B. Q/ t; R
. W+ C$ }% B% d- /* Reset of all peripherals, Initializes the Flash interface and the Systick. */
3 g/ t& N) \6 d7 f" M5 k4 X - HAL_Init();
* C D6 ]. {. {* g. R, m - $ p' }1 N4 N5 W% s# |0 O$ X
- /* Configure the system clock */ $ T& R+ x, @) j7 y4 P
- SystemClock_Config();
7 r- U1 }. x, k9 o/ X - # ` b5 x) D6 n$ {; C, o- F9 s
- … 0 H( `3 [0 s6 g' Q
- " o4 ^6 h7 L; P. J5 q
- HAL_Delay(100);
* B6 |8 e Y+ f; Z - + X. _, K c4 E% u1 p7 ]
- /* USER CODE BEGIN 2 */ 7 `& C2 X8 T% S- ]
- test_normal_mul(10, testInputA, testInputB, testResult, 1024);
4 g( Z3 l" I" g; n" x9 Y9 U - test_normal_mul(10, testInputA, testInputB, testResult, 1024); ; O1 m$ O; f1 @
- $ g' p9 M+ O/ F& Z7 V4 X4 z
- #if defined (__FPU_USED) && (__FPU_USED == 1U) ; j3 C. P" [% x5 U' n- Z$ |! [/ E% K
- // Multiply calculation with arm dsp lib * }# Z9 U E0 G4 D/ Y: B; b) c
- test_arm_math_mul(10, testInputA, testInputB, testResult, 1024);
, U, ?0 l0 }8 G- ^8 D - test_arm_math_mul(10, testInputA, testInputB, testResult, 1024); 0 H8 \2 h4 X9 H: D+ u9 y# B. t, I
- #endif
2 u: g) T g4 i. d - $ D" k ?# [! v5 T; V1 F
- /* USER CODE END 2 */
& g6 @3 Q. x5 J# g+ [+ e0 o
0 R5 R+ L7 K, j. K6 I2 n8 n- /* Infinite loop */
) P) t' }5 c e" D8 S1 \$ } - /* USER CODE BEGIN WHILE */
0 e7 j1 E" {$ p - while (1)
% x) m: s6 ?) ~1 Q& {: \ - {9 B# O$ s7 j. Y- G
- /* USER CODE END WHILE */ % A% @, I1 N# L0 i
- 3 ~9 O! o6 z% s- ~7 ^3 W8 w4 O" V
- /* USER CODE BEGIN 3 */
5 n9 w& R) t( j2 ` x - } , z0 }) g6 o1 C' C& Q& W/ D5 y
- /* USER CODE END 3 */ # P6 x* F, q0 x+ U# }! x: ^
- }
通过 KEIL 工程 Options / Target, Floating Point Hardware, 确定 FPU On/Off。
3 O, d. w1 [+ S' ?" D" W5 a/ F6 f, C/ Y I
- z# U) R/ T9 D f) q7 D% s' n▲ 图3. KEIL 项目工程 FPU 单精度浮点设置 通过 STM32G474_FPU_TEST.sct 文件配置 Data 存放区域,如下例,将测试数据置 于 SRAM2。/ \, u8 Q% k! r+ H
- 8 K; }# f; {: b+ u
- RW_IRAM1 0x20000000 0x00014000 { ; RW data9 M3 V6 B o: c+ G8 G% L
- .ANY (+RW +ZI)
; { W1 a" L: L0 o6 x - }/ W! J$ a7 L$ j
- RW_IRAM2 0x20014000 0x00004000 {
5 Q/ q/ e' p8 h9 l) [ - *(.TEST_INPUT_A)2 I0 v @0 C1 P
- *(.TEST_INPUT_B)& d. N" U7 ^" L/ N
- *(.TEST_RESULT_D)( z# {: S, _3 [2 {$ e
- }
8 t! P3 W7 U! l/ G2 ~ p% ] - RW_CCM 0x20018000 0x00008000 { I% o0 b1 }1 G. {5 o% h
- }
1 G! P, v$ p( J) F# n( a2.5. 编译选项 : c L* k4 V" }( R/ i+ Q
本文中我们使用的是 KEIL IDE,设置使用的是 KEIL Compiler V5。为了获得代码最 大程度上优化,我们使用了-O3 优化选项,与-Otime(Optimize for Time)结合使用。该组合选项意味着会进行更多代码优化,如循环展开,更激进的函数内联和自动函数内联 (-O3 默认使用--autoinline)等,当然副作用是二进制代码大小会有所增加。另外,增 加设置 --loop_optimization_level=2 来控制循环展开的优化等级。(注意:-- loop_optimization_level=2 选项只能与-O3 -Otime 一起使用。)如果您对 FPU 架构比 较熟悉,也可以尝试增加—fpu=fpv4-sp(Cortex-M4F FPU 实现的是 FPv4-SP 浮点运 算扩展)等选项,不过一般使用默认即可。
3 T$ [, a$ z! ^; ]- ~$ W/ n" e▲ 图4. KEIL 工程,编译选项设置 03使用 KEIL Trace 工具进行测量
9 n- M1 A' a4 `. W9 O3.1. KEIL 工程设置 4 j9 |2 b- P! A( w
6 r' t3 t+ L; a2 M5 g0 d
KEIL 工程下,首先选择工程选项设置,在 Debug 选项页中,右上部使用 Debugger 工具栏中选 Settings,如下图 5 和图 6 设置。注意 KEIL Trace 设置的时钟必须要与实际 STM32 使用的系统时钟相一致,如图 6 中,STM32G474 使用了 170MHz 的系统时钟, KEIL Trace 中也要相应设置为 170MHz。
* M8 P9 o. S$ M. Z5 B1 ^- _▲ 图5. KEIL 工程,Debugger 设置入口 ▲ 图6. KEIL 工程,Cortex-M Trace 功能设置 运行KEIL debugger,如下图7所示,将断点设置在要测量的语句前及其后,执行 代码,当Debugger停在断点时,其状态栏中t1指示的即为当前代码的已执行时间。测试代码起止时间差即为代码执行用时。该Trace功能计时是比较准确的。当然如果您希望掌控更多,也可以通过代码来实现,如增加诸如如下代码:. ~% Y: ^" k+ Y
nStart = DWT->CYCCNT; * Z- ~/ I& Y6 m; z @
~~~需测试执行时间的代码~~~ , j9 T3 u0 d$ \& F. e: B
nStop = DWT->CYCCNT;
6 y0 a3 o% d/ B7 z5 z. i然后用(nStop – nStart)/系统时钟,换算成时间即可。(我们这里没有考虑中断,一 般测量前需要禁用中断)
4 B' v/ j- [, l9 w7 c8 Q▲ 图7. KEIL 工程,Debug 模式下 Trace 程序执行时间 3.2. 测试结果
/ t+ S# }# ~( h5 w下表列出了STM32G474 10K次 浮点“乘”用时统计。( H) m l' m9 C) `
▲ 表1. STM32G474 10K 次 浮点“乘”用时统计表 10 X 1024次浮点乘% Y0 k, |/ |3 t# l8 Q
$ `- @( R6 o* c; X$ @
增加--loop_optimization_level=2 编译选项
4 J! q+ U, _+ N& s# U# {' d$ w4 V. C" _+ x8 t
FPU 核心汇编代码的比较,见图8和图9。& ?) v* s O4 o" l& e1 u' l9 `
▲ 图8. 使用--loop_optimization_level=2 编译选项的常规代码汇编 ▲ 图9. ARM DSP 库 arm_mult_f32 函数汇编 ; m2 j: w" C% }
6 h; V9 c! n1 n$ I2 c# K1 k
使用loop_optimization_level=2, 常规代码使用KEIL compiler V5编译结果与 arm DSP Lib 的核心汇编基本相同。如果不使用loop_optimization_level=2编译选项, 则可以看到其主要区别在于KEIL Compiler V5 与ARM库对loop的unroll 处理程度不 同。在实际应用时,需要根据应用自身需求判断是否需要使用ARM DSP Lib,基本上 ARM DSP Lib是很高效的。3 l( L3 I, j. p6 o7 ~4 ~/ M
3 f, g, |$ X' o04小结
8 a. ]) ^; ^5 N, j p本文介绍了使用 STM32G474 FPU 进行浮点运算,从系统的角度、ARM DSP Lib、 编译选项的影响等几个方面探讨如何提升整体性能,并介绍了如何利用 KEIL Trace 工具进 行测量。以供在系统性能方面有需求的客户参考借鉴。
7 f; z# e+ g( r5 D
0 j' b6 y% C* R
* T1 H8 o" c0 p6 p1 p9 d如果你有其他想要的实战笔记,可评论区留言,管管来跟工程师沟通!0 s/ f. _4 I/ Z, G6 m' o# G0 o) W
2 N, N. \+ G5 J3 w8 X8 {! N
: w- b) ~6 ?3 |( u7 @1 Z5 D/ g0 z
8 ], U. @: M8 {1 E
& \* G8 Z1 v) n) p) P2 r1 t3 k' c) _
0 K" D: B" o( a7 o8 v4 P
1 z+ Z+ H4 {1 b) z& W7 a2 v$ j0 t/ L$ N
' _" U" L! C x1 k
$ u$ Z: P9 j% D' E# W" {0 g0 ?. x. ~
4 T; Z, ^+ O: Z |





 STMCU-管管
发布时间:2024-10-30 16:57


 微信公众号
 手机版