




 STMCU-管管
发布时间:2025-2-8 17:12
|
2 B* v( @' t- x9 `0 }3 }; \4 ~ 7 b, O$ v/ R4 M9 | i2 L 018 G3 \# p% W* f5 `& X+ B 简介 基于监督学习的神经网络算法需要大量数据作为输入,模型完全由数据驱动,数据质量是算法模型有效的必要条件。如何高效的采集到数据,以及正确的标注及分析是极其重要的,如果第一步有问题,后续的所有工作都是徒劳。 本文将介绍AFCI数据采集板,AFCI上位机数据采集工具,和简单分析数据质量的一些方法,以及需要注意的一些事项。7 l, o5 A" M" u: L, c8 G0 F 
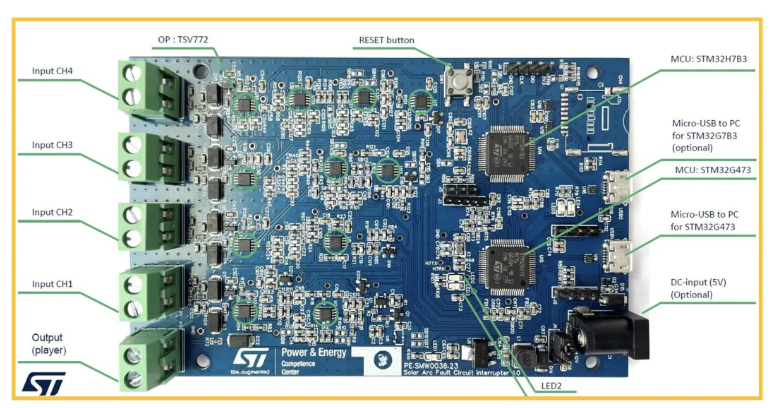
▲ 图1. AFCI硬件V1.0 02" }* t" {$ u% y% H9 h数据采集与清洗 
▲ 图2. 上位机主界面 2.1. 打开串口, v0 ` ]* s. L6 v& c+ U, ] 单击①找到相应的串口号,并通过②选择合适的波特率,点击③打开串口。4 g0 W5 u7 h/ T, Z( E0 {! i 注意: 1. 如果连接设备是串口+USB虚拟串口,则需要选择正确的波特率才能正常通讯。 2. 如果连接设备是USB虚拟串口(比如AFCI开发板),则波特率可以任意选择。 2.2. 数据采集0 a2 J( t: |- f3 B 通过④设置标签,⑤设置采样率(最高400KHz),⑥设置采样时间,⑦选择通道(目前 AFCI 开发板与上位机支持四个通道),选择⑧开始数据采集。 数据采集原则: 1. ④中设置的是文件标签,也可以理解为文件保存路径,上位机工具会根据保存的文件路径来给数据进行打标签。 # X0 \# w" R. J- J9 b5 P$ f$ ]4 V1 P 2. 默认情况下,工具会判断路径中是否含有“Arc”和“Normal”关键字(大小写均可), “Arc”:表示该文件夹及其子目录下的数据全为有弧信号;“Normal”:表示该文件夹及其子目录下的数据全为无弧信号。注意不要同时包含“Arc”和“Normal”, 如果想自定义标签,请参考2.3数据标注一节。 " j) i+ j8 A. J _$ K A, t$ J" o 3. “Normal”信号的采集:无弧信号采集相对比较简单,重点需要注意在不同的采集条件采集数据,让数据分布更广泛。为了确保无弧,所有接线连接部分必须保证充分接触,防止出现由于接触不良导致接头内部产生微小电弧,而肉眼无法看到的情况发生。拉弧机两端最好使用示波器检测,电压必须保持为0V,以确保拉弧机接头内部没有肉眼无法看到的电弧。 6 ~: b) T9 c. s, k 4. “Arc”信号的采集:为了确保采集到的数据全部为有弧信号,需要先打开拉弧机产生电弧,再点击⑧开始采集,待上位机采集完成,再断开拉弧机。, M- u1 M" _6 b6 }6 F) d$ H 5. 由于拉弧与非常多的因素相关,所以数据采集时应当在各个不同条件下采集。目前已知能影响拉弧效果的因素包括且不限于:是否有关断器,是否有优化器,电流等级,逆变器通道,硬件采集电路,拉弧距离等等。在数据标注时,需要对这些情况进行相应的标注,方便以后分析。这里电流等级可以以2 - 3A为一个步长采集所有电流等级内的数据。- \$ `0 ?9 S. A: [3 k# L% D8 L* \ 6. 采集时长或数据大小:没有明确规定的采集时长,建议每个电流等级总时长不低于30s。同一条件下也不建议太长,因为数据量太多可能导致内存不足,无法训练或训练时间过长。 * z! q, m3 p! `- }7 _9 N" K: y 7. 数据的分布和包含条件应该尽可能广,同质化的大量数据远远不及不同环境条件下的较少数据的数据质量高。% K' \/ h1 H; Z4 z" l 8 I# m/ i. d- H8 J3 o' Y! Z* t1 j 8. 测试环境应当尽可能和采集数据时环境保持一致。 4 b+ a8 l, L |/ z* |: [* q! G 其他信息:& S" K- y( ?/ d6 @. z8 K1 a 1. 文件夹设置好后,采集数据时,会自动在上位机相同目录下生成数据文件。- D6 a1 a( [* w- ` 2. 在File页面下,左键点击文件夹会将相应文件夹路径更新到④中,方便路径选择。4 s* p# v$ M( D( l+ I9 P% A 3. 采集到的数据文件格式为:[采集时间]_[采样率]_[通道]_[bit数].csv 4. 采集数据有错误(数据饱和)的文件格式为:BAD_Saturation_[时间]_[采样率]_[通 道]_[bit 数].csv。小部分数据饱和可忽略,大量数据饱和,需要检查硬件。; L: Y% |0 n( V2 J# q 5. 采集数据有错误(数据丢失)的文件格式为:BAD_Lost_[时间]_[采样率]_[通道]_[bit 数].csv。& a3 R r. j T* k8 m1 R 6. Log信息会自动保存在上位机同目录下,以当前时间作为文件名,以.log结尾。 7. 如果Log信息中,出现了丢包或其他错误信息,建议删掉采集保存下来的相关数据。& i d V7 O# ]. X 8. AFCI开发板的供电:AFCI开发板使用USB供电,可以连接笔记本,但是USB供电会引入工频噪声,在数据采集阶段和验证阶段,必须保证环境的一致性,所以在数据采集和验证阶段都需要使用统一的设备进行供电,不能切换电脑或电源。(建议使用同一台笔记本进行数据采集和验证,使用电池供电,不使用电源适配器。) 9. 一种数据文件夹的命名方式:图3. 一种文件夹命名方法,供参考。 
▲ 图3. 一种文件夹命名方法,供参考 10. 数据采集log的举例说明:
▲ 图4. 数据采集Log 说明:①:400KHz采样率下,数据有丢包。(可以在File页面下,找到该条数据,点击delete 删除). v0 e3 ?$ r+ t& L* a ②:400KHz 正常的数据采集Log。# `/ d# F2 a! q1 P8 T! T 目前,STM32G4使用Full Speed的USB进行数据传输,仅在400KHz采样率下,发现小概率有丢包情况,其他情况未发现,STM32H7使用High Speed USB通讯,不会有类似问题,不过如果采用串口通讯仍然会有误码率较高的可能性。 2.3. 数据标注 
▲ 图5. 数据标签设置 0 _8 v1 p/ E' K# C% X# S @( k) c) J! u0 ]9 I$ h% g' v 如果想要设置新的标签,比如不仅需要区分normal和arc,还需要添加noise数据,那么可以在上图标签栏,点击进行修改,以逗号‘,’作为间隔符。上位机工具,将检测文件路径中是否含有[标签]中的关键字,如果有则进行标记。注意标签间不要冲突。) S3 b* o! {8 q* Z4 ^( \7 I 8 c4 g4 K7 C# C) G- g 如果对标签进行了修改,比如从之前的2类变成了3类,训练完成后,相应的固件代码部分也要进行修改。) I: _6 j) D, y+ l w7 y5 E, k* t 2.4. 数据分析 
▲ 图6. 绘图页面 说明:1. 在绘图页面,点击采集到的数据①,会在右侧页面绘制出相应的波形图。 2. ②:时域图形,横坐标表示采样点数,纵坐标表示ADC值。③:频域图形,横坐标表示采样率,如果采样率为250KHz,则0.5表示125KHz,纵坐标表示幅值,使用dB进行显示。: T* J3 ^9 n4 ~* [) u4 Q7 c 3. 设置帧长⑤,拖动④可以看到不同帧长窗口中的时域和频域图形。" h2 B% z) c( A 4. 在频域图中,可能会看到不连续有间断的情况,这是由于为了在绘图的时候加快绘图速度,使用了简便方法进行绘图导致的,不是数据问题。 
▲ 图7. 上位机软件的时域和频域对比功能 说明:5 j3 x. B3 l4 l; b# F4 ~6 o 1. 勾选①痕迹后,再选择其它数据文件,则可以对比不同数据的波形,上图7为有弧和无弧信号的对比。 2. 检查②时域图形:查看是否有异常点,是否有样本点超过最大幅值的情况,中心点是否在2048附近(12位ADC最大值为4095,中心点为2048),可以看出硬件是否有设计问题,比如放大倍数不正确,或者中心点不正确。还可以和示波器进行对照,查看采集到的数据是否和示波器上的一致,来检查硬件或固件是否正常。 3. 检查③频域图形:查看滤波器的滤波范围是否正确,限波点是否正确等。从上图7中可以看到拉弧数据在相对低频部分有比较明显的特征。 2.5. 数据清洗 3 i. N, N7 L0 N7 Q& M 低质量的数据会严重影响模型的准确率,以下情况均会影响数据质量: 1. 固件Bug。 2. 噪声干扰。. j- h5 \$ y$ k, c, b9 C* M 3. 硬件问题。0 X& N# I9 _6 K+ V! R7 {+ T$ \2 h 8 f5 E: r1 T& D) ^! T, u1 \# N6 f AFCI 工具提供了一种方法帮助进行数据筛选: 
▲ 图8. 数据清洗 ' r( A- j. z4 k0 ?: t7 W+ o1.选中一个文件,上图是标记为有弧的文件。& [3 P; q5 e0 q# E1 i8 z 2.勾选①,点击②可以绘制该文件的所有帧,例如上图8中帧长为1024,工具会以 1024 的长度对原始文件进行分帧,然后将每一帧图片绘制在图中。 3.从图8中可以看到,④这个信号就不是很好,可能是固件的问题,可能是干扰,则可以通过单击④位置的信号,将其移除。1 x/ M/ }( ?3 q 4. 上图 8可以看到⑤位置的情况,某些帧抬升比较明显,某些帧抬升不是很明显。正常情况下,拉弧机拉弧后的频谱图也不是稳定在某一水平的,一般会上下波动,可以通过频谱仪看到类似现象。在实际处理中,我们可以将抬升不是很明显的信号去除掉,这样可以一定程度上避免误报。 $ W4 k+ h7 i/ l1 V) ` 通过简单处理后的图像如下图9: 9 `. h! o2 f# v4 ~ 
▲ 图9. 清洗后进行保存 : f+ F9 I& m. X3 x% J! U7 W清洗完成后,请点击上图的①进行保存,保存成功后,会在②这个位置(原文件所在目录),新建一个带有前缀Cleaned_的文件,该文件就是清洗之后的数据,建议将所有数据都进行清洗,并将清洗后的数据放在一个新的目录里面,因为AFCI工具在创建数据集的时候不会检查是不是清洗过后的数据,而是遍历目录下所有的csv文件,进行数据集的创建。% b$ w! \3 l5 A/ _: x 030 C; h b( i9 j* \% w) V0 c7 } 数据预处理 8 L+ }+ b% F! v* y1 j. h. Y+ c7 ] 采集好的数据文件格式为csv,数据预处理模块会根据一定的规则将这些csv文件重新整理成固定的格式,供后续模型训练使用。 
▲ 图10. 预处理过程 说明:" F6 T# E3 P6 F5 W; { I1. 点击①,然后点击②处的添加按钮,将文件夹添加到列表中,支持多文件夹。 2. 上位机会遍历所有文件夹列表中的目录及子目录,查找所有csv结尾的文件。根据文件路径中是否出现[标签]中的关键字,将文件标记为不同的类别。 3. 在读取csv文件后,会根据配置中的内容进行分帧: a. 采样率:是否需要降采样(一般选择默认即可), \) s3 P. Y6 W" l/ d! O( b( u7 P b. 帧长:10249 r; n: e% V; @* P6 ^6 M$ E c. FFT:是否使能FFT! q8 E' R- B1 u* ~5 j3 s d. 如果使能FFT,是否需要滤波,上图10中帧长为1024,进行FFT后数据长度为512,滤波带最小2最大258的设置意味着截取2~258中的256 个元素用于训练,其余丢弃。 e. 保存为csv文件:默认情况下保存为pkl文件格式,后续训练也是使用pkl 文件格式,csv文件格式仅用于方便查看处理后的数据,方便和MCU FW 端的数据流处理相匹配。3 y2 j( d3 y" N5 M6 y' P 4. 点击③开始创建数据集,创建过程会自动跳过有BAD标记的文件,创建完成后在 ④Log中会显示正常信号和拉弧信号的个数,他们的数量大体相当即可,不可以相差太多,也不需要完全相等。4 f* f2 S0 H7 @: j 5. 在⑤处的目录下,会自动生成Dataset目录,[xxx]_X.pkl文件表示是分帧处理后的数据,[xxx]_Y.pkl 表示对应的数据标签。0 c. q; ?5 ]: X( `2 v$ L5 s 6. 如果使能FFT,将生成mean.csv和scale.csv,注意需要将该数组替换固件代码 common_table.h 中的mean和scale数组。 F' N5 S: T; d6 a$ M' f# @ 7. 该数据预处理过程表示了数据从ADC采集的原始数据到进入神经网络训练数据的 过程,大致上描述为:ADC —》 分帧:1024 —》 FFT —》滤波:256 —》归一 化处理—》NN。/ s' p" W, g* k! J 8. 上述过程中有任何参数的修改,均需要和MCU固件保持一致,MCU中的数据流 需要和PC端预处理过程中的数据流保持一致。 ! F, e- h" v% `5 K4 Q/ l0 ~ 040 T' I/ c# I1 s7 v3 l! B1 J; I9 s+ ] 模型训练和验证 4.1. 训练模型 7 H5 G9 r {# L8 u, w 在创建好数据集后,可以使用训练模块进行训练,如下图: 
▲ 图11. 模型训练界面 1. 选择①中的文件夹,添加到②的列表中,上位机会自动遍历目录下的_X.pkl和 _Y.pkl 后缀的文件,X和Y必须成对出现,列表中只显示了_X.pkl,但训练过程中 会用到_Y.pkl。0 P+ \% |. n: O! c 2. 参数的配置: a. Optimizer:优化器类型选择。6 X" E1 s/ p- t! C0 P# Y' G b. Learn rate:学习率设置。 c. Early Stop:是否使用早停,当patience次迭代无法提升模型性能后,停止训练,可以防止过拟合。! s4 V7 s+ D, V+ i1 j d. Dynamic lr:动态学习率,当patience次迭代后对学习率按factor进行降低,可以防止模型不收敛。 K) N& j m; ^ e. Batch size: 在多少样本上进行梯度下降更新。/ d3 `$ ?; n' Y# w2 ~7 x f. Epoch: 迭代次数,默认100,在使用Early stop的情况下,可以大一点。; O- Y& n* J4 p: m9 u9 v* p! _ g. Metrics: 模型性能评估指标。 : I& L$ G0 b$ p& t' b 3. 参数的配置和选择取决很多因素,请自行查询相关学习资料,学习如何调整和配置参数,这里不再赘述。$ M) \4 J( `- j/ e 4. 模型配置:: `$ M) Q) [" G6 _ a. 下拉菜单③中可以添加不同的网络层的结构。/ F5 Z- ~" p8 ^! {. y9 B* n9 v b. 默认使用conv_block的卷积块,该卷积块比传统2D卷积占用ram会更小一点。; d, q" u$ a# J/ N c. 模型修改的原则:网络的层数和filter等参数越大,模型越大,越容易达到更好的效果,但是flash和ram会变得更大,推理时间也会变得很长,需要进行取舍,建议原则上是先从小模型开始,看看是否可以达到模型性能的目标,如果不行再考虑逐渐增加网络大小。3 V& T/ y: J! u d. 其他支持的结构包括:conv1d,conv2d,dense,dropout等等,具体使用方法和效果,不在此赘述,网络上有很多相关介绍可以参考。使用默认的配置,简单更改层数和filter数目可以满足绝大部分需求。6 z B3 X( j7 {9 O6 d 1 u& i% t- W- j3 Z+ [/ } 5. 训练完成后,会将模型转化为.c & .h文件,并保存在⑤目录下,将生成的.c和.h 替换到AFCI固件中,即可完成模型的更新。 8 A. R& r, a z% Z 4.2. 开始识别+ \% m# \4 }; a& v4 R# f . c% p+ E* r6 a, z+ K 完成模型的更新后,重新编译下载固件,可以进行相应的拉弧识别测试,如下图:* Z/ `) V% h3 J T; Q 
▲ 图12. 拉弧识别结果 # X4 `* C; t2 {) j; A. D$ _9 T& @. U, Z* f6 c 说明:3 N; `' I6 p {% R& i 选择好①采样率和③通道后,点击开始识别,就可以让开发板进入AFCI识别模式,识别中会输出图中④类似的Log信息,表示采样率已经设置为250KHz,CH2通道已经打开,并输出了 normal和arc的百分比信息,分别代表无弧和有弧的概率,判断有弧或无弧的阈值可以在AFCI 固件中自行定义。& G$ U' E/ [' M- @ F 4.3. 文件验证 1 F2 |- H6 P% q6 r( J. u 文件验证功能指的是将采集到的csv格式的原始数据文件,下载到开发板中,进行验证,从而判断开发板固件部分AI功能是否正常。如果固件和模型正确,输出结果应当和标记的内容一致。操作请见下图13所示。 7 b. i) {% h+ t 8 a+ x8 b! l/ k0 G9 Q! u |1 B) o 
▲ 图13. 选择需要验证的文件,双击会弹出对话框 - S' k3 T ]/ B0 J 
▲ 图14. Log信息 如上图14所示,这里显示的输出结果信息,以及剩余验证数据,其中通道信息可忽略,因为数据是从上位机下载的和通道无关。 055 [( ]: ?' v- z2 a X 通讯协议 4 x1 ]) O& j- v+ {3 e5 | 在Note界面下,可以查阅工具串口通讯协议和Release信息。 
▲ 图15. Note界面 06总结0 N7 s4 T, ]* A' f+ G 数据采集和标注是做好神经网络的第一步,需要格外仔细,不然其中如果有脏数据混入, 通过肉眼是十分困难加以清理的,脏数据过多会导致模型泛化能力变差。) i/ P( z0 f7 R) o8 F; D# I0 { ) U+ z6 V# w$ p5 t/ h 数据清理的一个办法是用模型对所有数据进行验证,然后挑选出验证结果失败的数据, Plot 出来后通过肉眼分辨剔除,其工作量是非常巨大和繁琐的,最好的办法是在数据收集的过程中就保证数据的有效性。5 i9 A, Z" g) E3 y6 E& Y 对于数据流的处理上位机必须和固件保持一致,如果有问题,需要将两边的数据处理流 dump出来进行比较和调试。另外,训练过程中使用GPU将明显提升训练速度,可以参考上位机的Readme安装 cuda 库。& u* f( t; C6 S5 d - z" p5 J. p, N/ b5 h4 [$ w |
经验分享 | 基于STM32G4芯片TIM+SPI+DMA应用示例
《STM32CubeMX2 实战课程》学习笔记+安装
《MCUBoot课程》学习笔记+数据与镜像的烧录
《MCUBoot课程》学习笔记+工程BuildActions示例
《MCUBoot课程》学习笔记+工程的BuildActions
《MCUBoot课程》学习笔记+安全启动秘钥存储
《MCUBoot课程》学习笔记+Memory布局
《MCUBoot课程》学习笔记+平台初始化与驱动
ST全新高功率AI服务器电源设计学习记录
经验分享 | LAT1422 STM32 AFCI 方案 TensorBoard 的使用介绍
 微信公众号
 手机版



请问,您有AFCI数据采集板的购买方式吗