




|
锦鲤不能白拿啊,回馈社区写三篇cubeMX的AI教程 。最终实现前几天所发布的图片(https://www.stmcu.org.cn/module/forum/thread-620501-1-1.html),先介绍CNN和LeNet。2 ^# {% ^0 ^4 X* } CNN并不复杂,主要是由卷积操作(对于电子出身的我们,这个不熟起码也听说过)+激活和池化(pooling),,几个层不断连接。最后输出到全连接和softmax,产生一个输出,这个输出是一个向量,向量长度和我们的分类个数一致。 先介绍卷积操作: 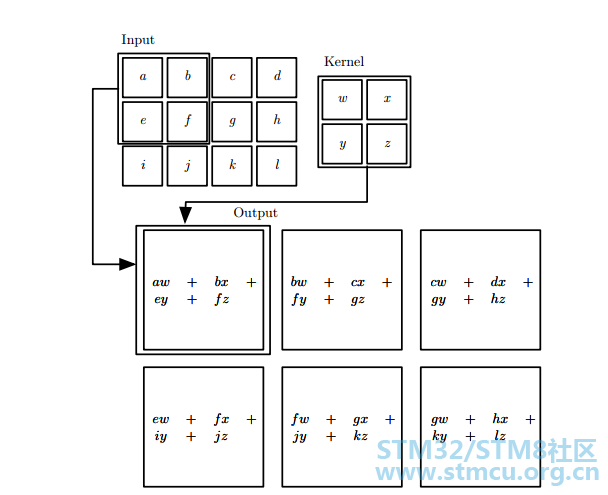
注意卷积操作改变了输入矩阵的大小(4x3 -> 3x2),少了一行一列。在这里会有另外一个操作 补零(padding),在缺少的一行一列上补零。0 X7 @, x+ k* i; h6 a 激活函数,整流线性单元 (ReLU)。一个图就可以看清楚。 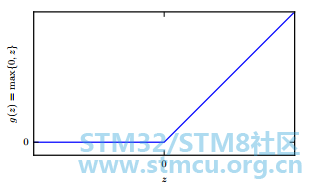
池化:池化很容易理解, 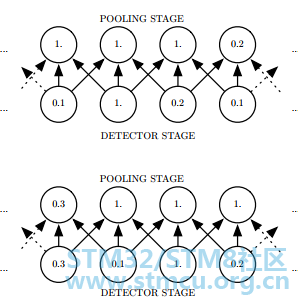
全连接和softmax都比较容易理解,大家可以参考博客等。图片均来自网络和deep learning book(深度学习圣经级教科书) 2 v& h4 C0 G! I7 n' l2 e p 0 W2 M$ m/ i' O- q+ \& P6 M: g ) y1 f$ ~! w5 B LeNet-5(没记错的话是lecun所创建的网络)是一个较简单的卷积神经网络。下图显示了其结构:输入的二维图像(28x28 8bits gray),先经过两次卷积层到池化层,再经过全连接层,最后使用softmax分类作为输出层。) M; t: t1 Y/ `) i6 V8 P5 f! Z1 O 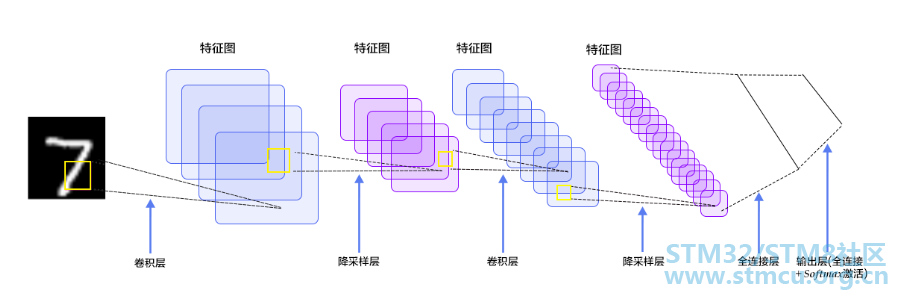
! k E0 a8 t& c5 | f. m+ _ & t' O6 J$ N* G" W; U! _0 E u& U 本次AI model移植采用了caffe 训练模型,cubemx ai组件来翻译,需要caffemodel和lenet网络结构描述文件(prototxt)。 下篇跳过caffe(网上大量教程资源,不赘述),直接来到移植和代码详解。, V/ i/ i7 C) j" u |
【STM32H5 评测】MNIST 数字识别
STM32在边缘AI的布局及能力版图
从家电到机器人:STM32边缘AI应用案例拆解
STM32U3B5/U3C5:为超低功耗设计带来高性能 DSP 与边缘 AI
【NUCLEO-U3C5ZI 测评】+ 手写数字识别
【STM32U3 评测】MNIST 数字识别
AI玩具爆发前夜:技术拐点、体验鸿沟与破局路径
STM32 AI Model Zoo,现支持PyTorch的最大规模MCU AI模型集合
经验分享 | STM32 AFCI 方案 TensorBoard 使用指南:AI 模型调优可视化终极方案
STM32F334运行超轻量级神经网络推理框架TinyMaxi进行端侧推理
 微信公众号
 手机版




Tensorflow上手有点难度。
7 _$ [; q. @6 ]" M4 |
这个链接没内容了