




|
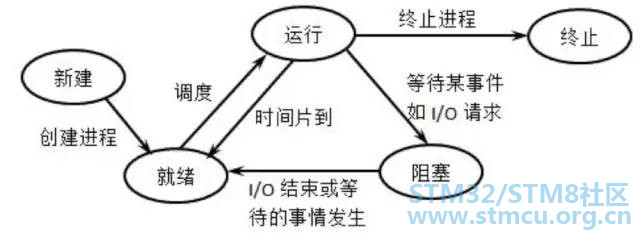
进程是我们开发同学非常熟悉的概念,我们可能也听说过进程上下文切换开销。那么今天让我们来思考一个问题,究竟一次进程上下文切换会吃掉多少CPU时间呢?线程据说比进程轻量,它的上下文切换会比进程切换节约很多CPU时间吗?带着这些疑问,让我们进入正题。 1进程以及进程切换进程是操作系统的伟大发明之一,对应用程序屏蔽了CPU调度、内存管理等硬件细节,而抽象出一个进程的概念,让应用程序专心于实现自己的业务逻辑既可,而且在有限的CPU上可以“同时”进行许多个任务。但是它为用户带来方便的同时,也引入了一些额外的开销。如下图,在进程运行中间的时间里,虽然CPU也在忙于干活,但是却没有完成任何的用户工作,这就是进程机制带来的额外开销。& X' r, M* |3 t& W* c 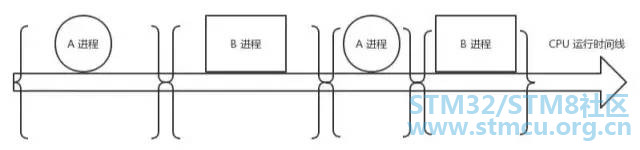
$ P. Q4 ^# R7 ~' E" s" M$ i # gcc main.c -o main& H7 o/ j) a" s- q# ./main./main Before Context Switch Time1565352257 s, 774767 us After Context SWitch Time1565352257 s, 842852 us 3 j5 m$ x$ F) S2 l 每次执行的时间会有差异,多次运行后平均每次上下文切换耗时3.5us左右。当然了这个数字因机器而异,而且建议在实机上测试。前文我们测试系统调用的时候,最低值是200ns。可见,上下文切换开销要比系统调用的开销要大。系统调用只是在进程内将用户态切换到内核态,然后再切回来,而上下文切换可是直接从进程A切换到了进程B。显然这个上下文切换需要完成的工作量更大。3进程切换开销分析那么上下文切换的时候,CPU的开销都具体有哪些呢?开销分成两种,一种是直接开销、一种是间接开销。直接开销就是在切换时,cpu必须做的事情,包括:1、切换页表全局目录2、切换内核态堆栈3、切换硬件上下文(进程恢复前,必须装入寄存器的数据统称为硬件上下文) 6 D$ h! y9 S9 N! k* B7 `; _+ t
Z4 @* y7 E2 X& p& b" b 4、刷新TLB5、系统调度器的代码执行1 N9 f* C: h2 z. s' w1 p0 j间接开销主要指的是虽然切换到一个新进程后,由于各种缓存并不热,速度运行会慢一些。如果进程始终都在一个CPU上调度还好一些,如果跨CPU的话,之前热起来的TLB、L1、L2、L3因为运行的进程已经变了,所以以局部性原理cache起来的代码、数据也都没有用了,导致新进程穿透到内存的IO会变多。其实我们上面的实验并没有很好地测量到这种情况,所以实际的上下文切换开销可能比3.5us要大。想了解更详细操作过程的同学请参考《深入理解Linux内核》中的第三章和第九章。4一个更为专业的测试工具-lmbenchlmbench用于评价系统综合性能的多平台开源benchmark,能够测试包括文档读写、内存操作、进程创建销毁开销、网络等性能。使用方法简单,但就是跑有点慢,感兴趣的同学可以自己试一试。这个工具的优势是是进行了多组实验,每组2个进程、8个、16个。每个进程使用的数据大小也在变,充分模拟cache miss造成的影响。我用他测了一下结果如下(下图需要横向滚动查看完全): ( A) H6 X4 p, s6 {3 I; F! a -------------------------------------------------------------------------Host OS 2p/0K 2p/16K 2p/64K 8p/16K 8p/64K 16p/16K 16p/64K. Z0 |) L; k: n0 e+ ~5 Q, S ctxsw ctxsw ctxsw ctxsw ctxsw ctxsw ctxsw* b' }5 _* r9 ?9 l --------- ------------- ------ ------ ------ ------ ------ ------- ------- bjzw_46_7 Linux 2.6.32- 2.7800 2.7800 2.7000 4.3800 4.0400 4.75000 5.48000 1 q Z3 Z# P* l2 _4 k% Z2 @# B 同一进程下的线程之所有getpid()看到的pid是一样的,其实task_struct里还有一个tgid字段。对于多线程程序来说,getpid()系统调用获取的实际上是这个tgid,因此隶属同一进程的多线程看起来PID相同。 4 a* p' t' b; L 我们用一个实验来进行另外一个测试。其原理和进程测试差不多,创建了20个线程,在线程之间通过管道来传递信号。接到信号就唤醒,然后再传递信号给下一个线程,自己睡眠。这个实验里单独考虑了给管道传递信号的额外开销,并在第一步就统计了出来。% ?9 O# F* K6 j7 v* T9 y$ n# q # gcc -lpthread main.c -o main1 R" D2 g* t* K0.508250) ]* V8 z4 c" r1 F, |' `9 x1 N 4.363495 $ r% ]5 Q. K5 |! t # vmstat 1procs -----------memory---------- ---swap-- -----io---- --system-- -----cpu----- r b swpd free buff cache si so bi bo in cs us sy id wa st8 C, b' V' z; N7 D7 ~7 u, n ]* G+ k 2 0 0 595504 5724 190884 0 0 295 297 0 0 14 6 75 0 4 5 0 0 593016 5732 193288 0 0 0 92 19889 29104 20 6 67 0 7$ @, `( V, s! B8 Q, E( k, X* w 3 0 0 591292 5732 195476 0 0 0 0 20151 28487 20 6 66 0 8 4 0 0 589296 5732 196800 0 0 116 384 19326 27693 20 7 67 0 7 4 0 0 586956 5740 199496 0 0 216 24 18321 24018 22 8 62 0 8 . Z5 c/ D' f7 d 或者是proc/s Total number of tasks created per second.( f" t8 s% Y, s7 r0 U/ {) J cswch/s; L- V$ l- [! b Q1 T! d Total number of context switches per second." e, Y+ o j6 i* [$ T2 `8 j 11:19:20 AM proc/s cswch/s' H$ x" A$ S% O1 e 11:19:21 AM 110.28 23468.22 11:19:22 AM 128.85 33910.58' n! C% x3 o4 _% a* _ 11:19:23 AM 47.52 40733.66$ r8 [- [" o! P& i$ _ 11:19:24 AM 35.85 30972.64 11:19:25 AM 47.62 24951.43 11:19:26 AM 47.52 42950.50) s0 A( T$ {) c. A8 k3 S) Y* Q ......# f7 U: B6 u2 R, t s# R6 y5 F4 r 上图的环境是一台生产环境机器,配置是8核8G的KVM虚机,环境是在nginx+fpm的,fpm数量为1000,平均每秒处理的用户接口请求大约100左右。其中cs列表示的就是在1s内系统发生的上下文切换次数,大约1s切换次数都达到4W次了。粗略估算一下,每核大约每秒需要切换5K次,则1s内需要花将近20ms在上下文切换上。要知道这是虚机,本身在虚拟化上还会有一些额外开销,而且还要真正消耗CPU在用户接口逻辑处理、系统调用内核逻辑处理、以及网络连接的处理以及软中断,所以20ms的开销实际上不低了。那么进一步,我们看下到底是哪些进程导致了频繁的上下文切换?(下图可能需要横向滚动查看完全)11:07:56 AM PID cswch/s nvcswch/s Command 11:07:56 AM 32316 4.00 0.00 php-fpm 11:07:56 AM 32508 160.00 34.00 php-fpm 11:07:56 AM 32726 131.00 8.00 php-fpm d% S# P! B6 B4 \ ......3 f: E+ T% e+ C( m voluntary_ctxt_switches: 573066* ? j# r( k# w4 M+ N4 I0 g nonvoluntary_ctxt_switches: 89260 |
 微信公众号
 手机版


