STMCU小助手
发布时间:2022-3-5 10:09
|
前言3 ^! x6 @7 [$ {; `! p ST 已经推出了三种库函数,用以方便客户快速开发 STM32 系列的 MCU。从最早的标准外设驱动库,到后来的 Cube HAL ,再到 Cube LL,还有直接写寄存器。这几种库的代码效率到底如何呢?本文将针对这个问题进行分析和对比,最后提供对比数据供大家参考。 ?$ {2 j8 S5 n) p$ `: k 问题分析8 q" J j% D$ k" X0 V7 S 我们以 GPIO 翻转、TIM PWM 输出、ADC DMA 数据采集和 DMA M2M 这四个常用功能,通过不同的库函数来实现,最终来对比各个库函数的性能。四个工程代码的内容简述如下:. p+ K+ Y: O3 Q8 e GPIO 翻转:切换 GPIO 的输出电平,其中包含了系统时钟初始化和 GPIO 翻转的代码。5 O; j0 k0 V* w3 B! ^5 a6 n TIM PWM 输出:通过 TIM1 的通道 1 输出频率是 36KHz 的 PWM,循环修改其占空比从 25%到 50%,其中包含了系统时钟初始化、TIM1 的初始化和切换占空比的代码。: v, H; O' @6 i! [5 e2 G ADC DMA 数据采集:通过 ADC 的模拟通道 1,采集 100 次 ADC 的结果,并使用 DMA 传输到到用户缓冲区,其中包含了系统时钟初始化、ADC 初始化和 DMA 的初始化的代码。 DMA M2M:使用 DMA1 的通道 1,从 Flash 中传输 100 字节的数据到片内的 SRAM 中。其中包含了系统时钟的初始化和 DMA的初始化代码。 主要对比三个参数:Flash 占用量、SRAM 占用量和执行代码的效率。% @6 l! ~, {) F; W# S: K( M4 V Flash 和 SRAM 的占用量可以通过查看 IAR 生成的*.map 文件了解到。- B" L2 t: y, k+ K' s 8 g5 L# c& J9 M6 I9 X9 F% S& R 
在*.map 文件中,会有如上图的内容,其中的 readonly code memory 加上 readonly data memory 的和,就是 Flash 的占用量。而 Readwrite data memory 的大小即为 SRAM 的占用量。那么上图所示的 Flash 占用量即为 3204=3174+30,SRAM 占用量即为 1032。因用户堆(Cstack)我们设置的为 1024,所以真正应用代码所占用的 SRAM 量为 8=1032-1024. 代码的运行效率部分,我们是通过 IAR 提供的内核运行周期数(CYCLECONTER)来计算的。在功能函数的开始处和结束处分别设置断点,两次内核运行周期数的差值,就是此处代码的运行周期。# _0 w; A5 t! U$ Q- ] 
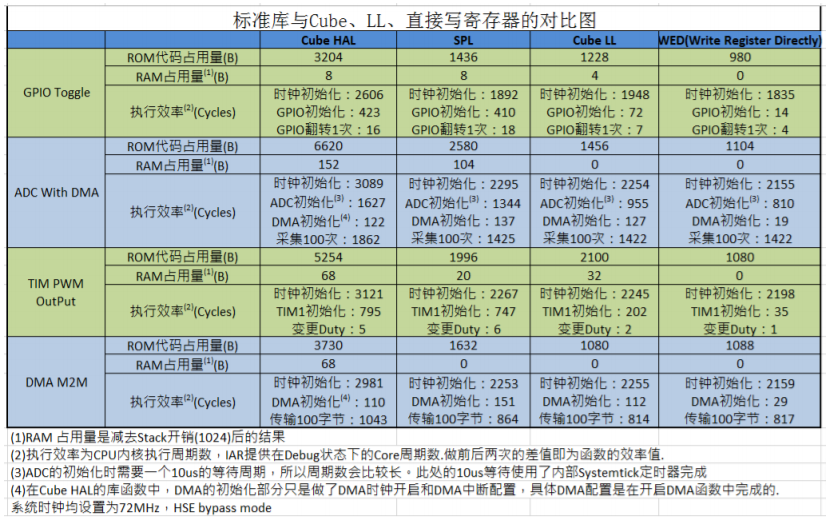
( o% C! \6 z" g# i6 M# f 测试硬件选用了 Nucleo-F302 评估板。& k, I2 t7 p0 } 软件环境和库函数详情如下: • IAR V7.60 • Optimizations Level High (Size)2 h4 f+ T( a7 A- N4 A K • STM32CubeMX V4.173 f5 h' b! Z+ q( ?9 h • Create Project with Copy the necessary library files5 A, s A" y4 I% J, k& M! {/ q+ o& ~8 e • STM32CubeF3 V1.607 }0 i2 ?1 K* l f9 m • STM32F30x_DSP_StdPeriph_Lib_V1.2.3 • STM32F3xx CMSIS V2.3.0 测试结果如下:# D- w& H7 g8 Z6 } 
- P( q7 X7 d8 K( C 总结: 总体来看,代码效率与移植性成反比的规律是明显的。但与 Cube HAL 相比, Cube LL 的效率优势还是很明显的,几乎和直接写寄存器的效率相差无几。而且目前 STM32cubeMX 已经开始支持直接生成使用 Cube LL 的工程,对于以后追求效率的开发应用人员来说,非常值得推荐给大家使用。 |
【经验分享】STM32语音识别的智能蓝牙音箱(源程序+原理图+PCB+设计说明书+PPT)
想找个ST芯片
[GPIO] 使用新型抽象开始C++嵌入式编程,从GPIO开始
技术手册stm32f1xx中的一个小问题
【经验分享】STM32 HAL库移植FreeModbus详细步骤
【逢7发帖赢大礼】STM32开发之IC门禁卡UID读取方法!
实战经验 | Keil工程使用NEAI库的异常问题
经验分享 | FDCAN数据段波特率增加后发送失败的问题分析
STM32几种流行开发环境的优缺点
好用软件推荐-TouchGFX Designer
 微信公众号
 手机版