STMCU小助手
发布时间:2022-7-5 19:14
|
1.ART加速 ) _9 t0 I! H4 ^# ~9 @% j 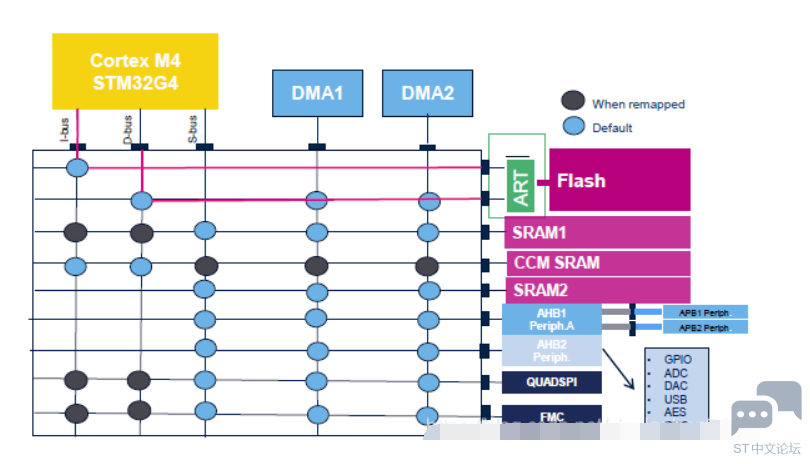
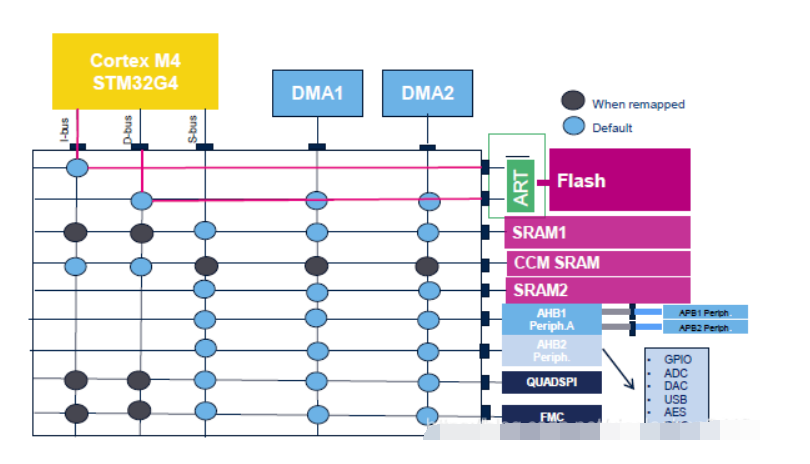
ART在Flash之前,ART加速可以提高Flash的读取运行速度。 1 k5 g7 K+ Z. _6 [* { ➢ 程序实现(任选一种):* r( p0 B, C1 N! R& ^/ `' N+ j 1,使用库函数(HAL): __HAL_FLASH_INSTRUCTION_CACHE_ENABLE(); __HAL_FLASH_DATA_CACHE_ENABLE(); ' X! Q/ g0 z8 z 2,寄存器操作:( X6 ?5 S$ k0 F* R% y FLASH->ACR |= (1<<9);//将第9位置1 FLASH->ACR |= (1<<10);//将第10位置1 & V5 o. q; ^" P4 v* H m: X; v ![0OIQ(]5ITKU}V}6U@)MNRF2.png](data/attachment/forum/202207/05/191506yw0ykzw88j8k1w87.png "0OIQ(]5ITKU}V}6U@)MNRF2.png")
' o; W/ S* W8 D) r 如果要将时钟跑到170MHz,需要设置到Rang1 Boost模式 ) d2 [" ^- h/ r4 Z) ~ 2.CCM SRAM& E7 [ J/ r |- N 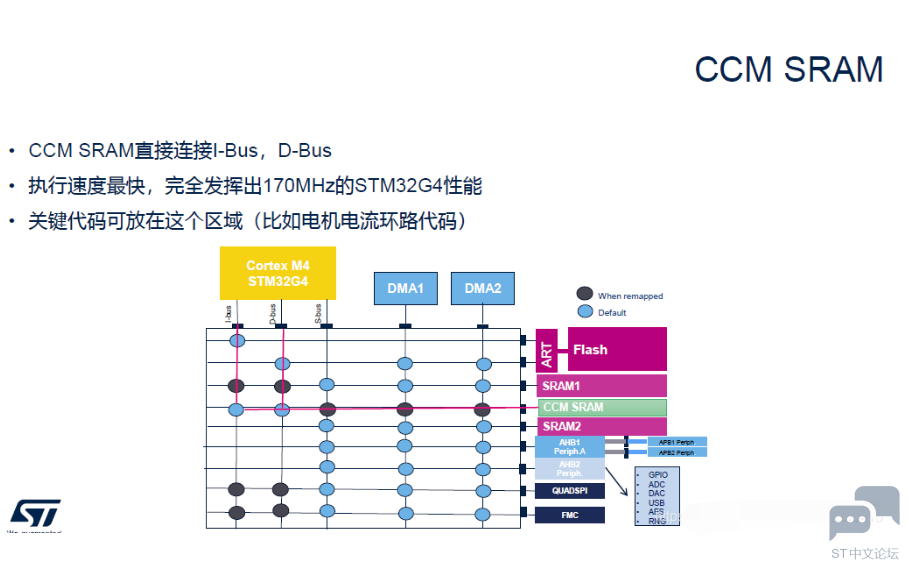
CCM SRAM直接连接到 I-Bus ,D-Bus中,可以提升关键代码的速度,建议可以将关键代码放在这个区域。% R. D/ h/ v0 V( j' N* G' f ! G) {; ?9 M1 E0 ]. x; X 3.CoreMark测试* ~+ E l l1 g7 b( Z • CoreMark是一项测试处理器性能的基准测试. {+ b3 s$ c J& F+ F5 o* ?( i4 x • 代码使用C语言写成,包含:列举,数学矩阵操作和状态及CRC等运算法则: b9 p( l$ c' m, g) d3 Z • 目前CoreMark已迅速成为测量与比较处理器性能的业界标准基准测试 • CoreMark的得分越高,意味着性能更高 7 T- p* m# B1 r0 A6 F2 { 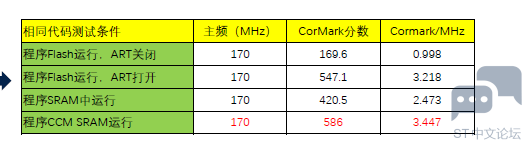
- N5 u2 c% U) }" i8 R- ]- S 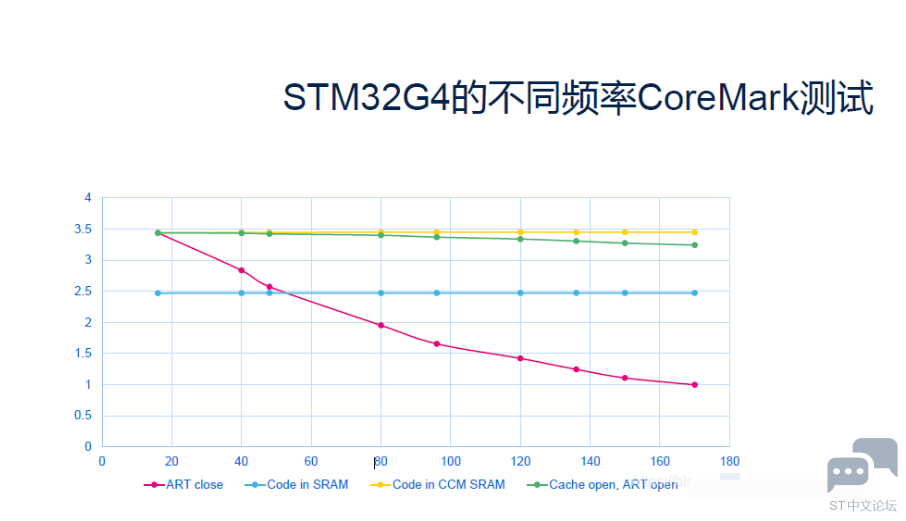
* n+ n6 I2 c2 b; g# x$ h 比较处理器的时候,不要单看主频,还需要了解综合的实力,有的处理器主频虽高,但是没有太大的用。7 Y3 J2 Z: i5 o1 @4 U1 n5 z . \+ @, \) `' R- R( E& g; o# c 4.浮点运算 能提高运算精度,减少运算转化之间的损失,做算法类的项目需要用到的比较多。& u) | H" ]! n' s$ q Q* [/ ^( @% J0 u; T ! U, f7 C1 L$ @" H/ F6 |, y 
注意:除法和开方的运算周期过长,如无必要,尽量不要用,尽量将其转化为运算周期较少的加减乘运算 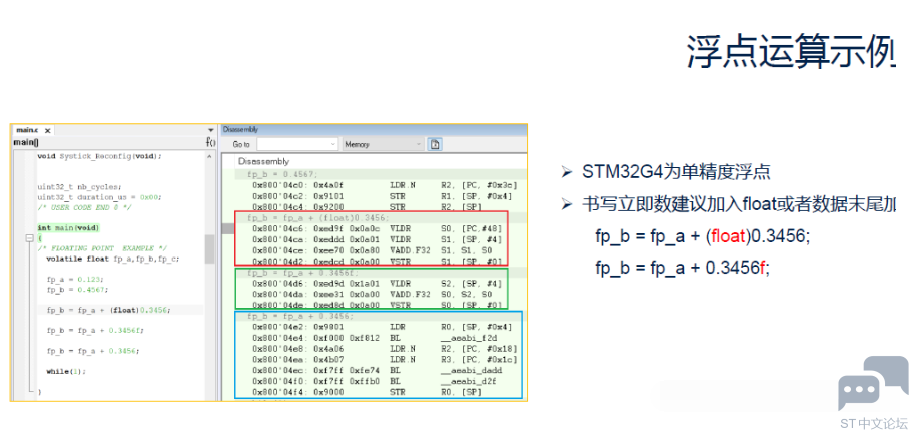
# t; {) [* R' I- C& H 浮点运算实例:' p5 H2 V7 P" i5 a/ a8 l/ F 一般需要在运算结果前写上(float)或者标注f,否则一律认为其为双精度,将会大大增加运算的时间。; b' e( q1 i" q& R. D 浮点运算-FIR(滤波运算)" @0 g2 o6 n( A3 ]. R7 o. s 在这里插入图片描述 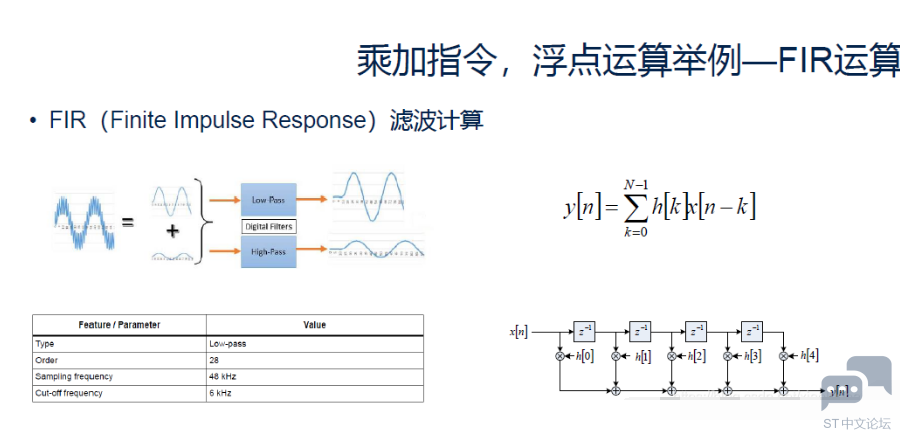
![COHZ4N[%_Q(8F@N[)SKJO)F.png](data/attachment/forum/202207/05/191508pcx7expgtmgqmeqe.png "COHZ4N[%_Q(8F@N[)SKJO)F.png")
先看内核再看主频,才能判断效率,比如F1和F3都是72M的主频,可是F3是M3的内核,比M1的FIR运算快了7倍!!!!2 w# T' C+ C& O% }- P9 O3 K; M0 [% t 9 N9 S" Y* K: ` k( D( V3 ~ K6 g% f: q4 l2 T+ V7 o1 u 7 h, T8 H2 m: T |
经验分享 | 基于STM32G4芯片TIM+SPI+DMA应用示例
STM32G47x 双 Bank 模式下在线升级
DMA 原理从 0 到 1:为什么它能解放 CPU?一文讲透 DMA 的工作流程
【经验分享】STM32G4之基本定时器
NUCLEO-G474RE 扩展 LSM6DSO 传感器数据融合实操演示全解析
经验分享 | STM32G474 高精度定时器同步功能全解析 从内部互联到多芯片协同的实现方案
经验分享 | STM32G4双BANK启动应用演示
STM32G4 LPTIM+DMAMUX 实现并行输出应用示例
实战经验 | LAT1578 SAU对NSC分区的影响
经验分享 | STM32G474 HRTIM Triggered-half模式实现两相交错电源180°相位同步方案
 微信公众号
 手机版