STMCU小助手
发布时间:2023-2-14 16:21
|
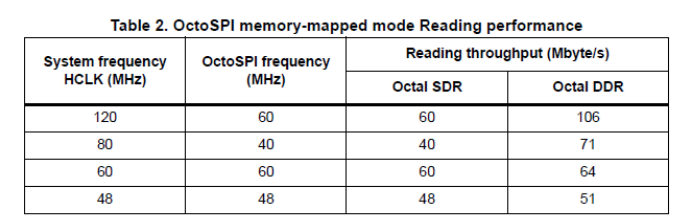
1. 引言 客户反应 STM32L4R9 同 QSPI Flash 通讯,测出来的读取速率为 10MB/s, 和理论值相差较大。6 B" i& I9 U6 A8 F 2. 问题分析 按照客户的时钟配置和 STM32L4R9 的数据手册中的数据,OSPI 读数速率为 10MB/s 肯定存在问题。同时我们也可以在 AN4760 应用手册中看到如下说明:& c9 G9 d5 _3 l1 [* W! q ( \$ i+ f3 \$ ^* }$ g 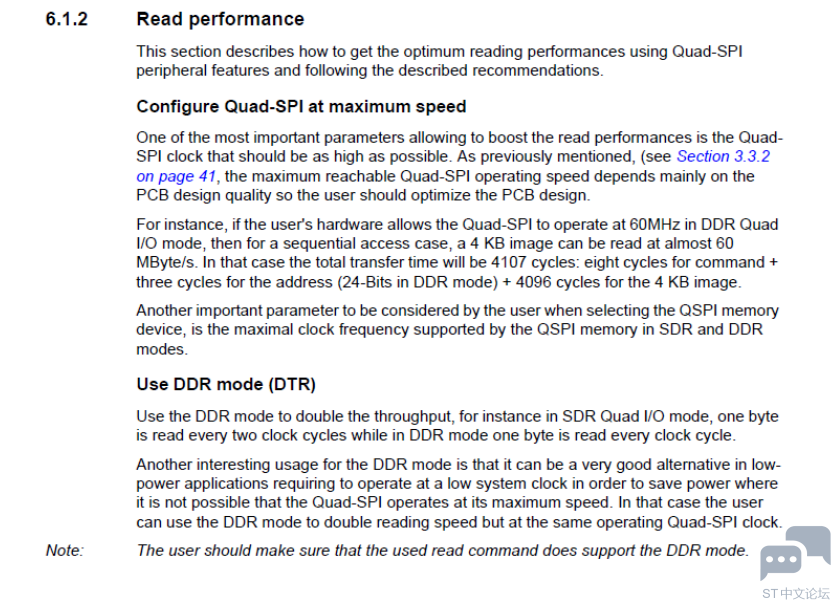
1 U9 C6 `6 W* f1 c ![J]4QWL0QKJ@A@L41Z8FGU~1.png](data/attachment/forum/202302/14/161645ynq6n7cpbsccpcav.png "J]4QWL0QKJ@A@L41Z8FGU~1.png")
4 C1 C" q4 h' a0 Y$ @: d 在客户系统中,IO0~IO3 的 4 线通讯模式下信号波形如下图,可以看出每经过 8 个CLK 周期就有很长一段时间的延时。如果提高 CPU 的主频,这个延时会缩短,但客户测到最短的延时也有 200ns,并且一直存在:( P2 ^" Z3 ], ^9 g! j4 G7 H . e" G3 w0 W2 D# l- ?, q& D S ![IR2~ST4W26[VL]]A9Z~HW`0.png](data/attachment/forum/202302/14/161645wsgex6uggz17p5pr.png "IR2~ST4W26[VL]]A9Z~HW`0.png")
f V, N* n" t: B 3. 问题解决 8 J) T1 h b; }1 ^ : S! c; g% K6 S9 N- x4 K! m- ? 从客户测试波形上看,由于是 4 条数据线,因此 8 个 clock 正好是 4bytes,也就是32bits 数据。怀疑 STM32L4R9 QSPI 在 DMA 通讯中,读到一个 word(32bits)数据后需要在内部做一定的数据处理,造成时间延迟。 8 l( G! Z( V) p4 X 分析代码发现,DMA 设置的是 byte 传输模式,如下面代码: #define BUFFERSIZE (COUNTOF(aTxBuffer) - 1) hdma.Init.PeriphDataAlignment = DMA_PDATAALIGN_BYTE; ]# X% A. z% C) f3 A hdma.Init.MemDataAlignment = DMA_MDATAALIGN_BYTE; ) Y2 x1 x, N+ Z7 Z, n STM32L4R9 是 Cortex-M4 内核,系统总线是 32bits 的,怀疑是在 32bit 总线上传输byte 数据会降低效率,造成延迟,于是修改代码如下: 9 B1 f2 u( w8 @) }( t; a8 i; J 示例代码在下面路径,需要使用附件中的 main.c 文件替换掉下面文件中的 main.c: \STM32Cube_FW_L4_Vxx\Projects\32L4R9IDISCOVERY\Examples\OSPI\OSPI_NOR_ReadWrite_DMA\EWARM 另外程序中做如下改动:: E. f4 `; p3 `0 R9 K, _! G n$ q* m #define BUFFERSIZE 1024 // (COUNTOF(aTxBuffer) - 1) ( K/ x* ^- L* R# n hdma.Init.PeriphDataAlignment = DMA_PDATAALIGN_WORD; hdma.Init.MemDataAlignment = DMA_PDATAALIGN_WORD; 配置时请留意 OSPIHandle.Init.FifoThreshold = 4;5 S. e* a% ]' o; m4 N- u //也需要 4 的倍数。修改代码后进行测试,代码读 4096bytes 的图像(1026 words),发现每个 word 数据中间的延迟已经没有了。之前速度提不上去的问题是 DMA byte 设置引起,因为STM32L4R9 是 32bits 系统,使用 8bits 传输会降低效率,需要改为 DMA 32bits 配置就OK 了。图形数据传输的总字节数也要设置为 4 的倍数,不足的需要补5 F# v1 H8 ^; O E4 P3 z, f - T% d0 ~ P0 K* S8 b- Y+ V' S 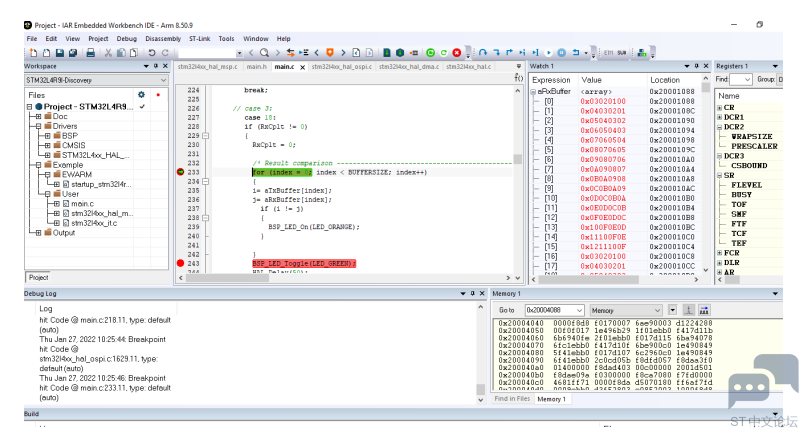
) x8 |- i! p6 k 完整版请查看:附件  LAT1180_QSPI flash 速率过慢问题_v1.0.pdf
(428.75 KB, 下载次数: 2) |
STM32L4R9 QuadSPI Flash通讯速率优化解析 32位总线的DMA传输适配核心方案
【STEVAL-STWINKT1B评测】运行Datalog固件并记录运行时间
【STEVAL-STWINKT1B评测】数字麦/模拟麦对比测试+音频配套上位机软件开发
【板卡评测】STEVAL-STWINKT1B读取 ACC/GYRO/MAG 实时数据
小白也能明白的STM32的低功耗与唤醒机制
【STM32入门学习路径指南】(四步走)
STM32和Arduino对比,谁更耐打?
STM32系统中2种数据掉电保护的方法
STM32 LL为什么比HAL高效?
STM32小白入门指南:从基础到OTA实现方案
 微信公众号
 手机版