|
引言 Linux Kernel Development 一书中,关于 Linux 的进程调度器并没有讲解的很全面,只是提到了 CFS 调度器的基本思想和一些实现细节;并没有 Linux 早期的调度器介绍,以及最近这些年新增的在内核源码树外维护的调度器思想。所以在经过一番搜寻后,看到了这篇论文 A complete guide to Linux process scheduling,对 Linux 的调度器历史进行了回顾,并且相对细致地讲解了 CFS 调度器。整体来说,虽然比较啰嗦,但是对于想要知道更多细节的我来说非常适合,所以就有了翻译它的冲动。当然,在学习过程也参考了其它论文。下面开启学习之旅吧,如有任何问题,欢迎指正~) ^* S6 m" q! G, A
需要注意的是,在 Linux 中,线程和进程都是由同一个结构体(task_struct,即任务描述符)表示的,所以文中会交叉使用进程、线程和任务等术语,可以将它们视作同义词。当然,也可以将线程(任务)称为最小执行单元。但 Linux 的调度算法(如 CFS)可以应用更加通用的调度单元(如线程、cgroup、用户等)。总之,不要过度纠结这里的术语,重要的是了解每种调度算法的思想!
. X9 V0 K p( z J/ D, k8 N* `8 T j
为什么需要调度 Linux 是一个多任务的操作系统,这就意味着它可以「同时」执行多个任务。在单核处理器上,任意时刻只能有一个进程可以执行(并发);而在多核处理器中,则允许任务并行执行。然而,不管是何种硬件类型的机器上,可能同时还有很多在内存中无法得到执行的进程,它们正在等待运行,或者正在睡眠。负责将 CPU 时间分配给进程的内核组件就是「进程调度器」。
7 ]% Q# M& D4 j& \9 I6 k调度器负责维护进程调度顺序,选择下一个待执行的任务。如同多数其它的现代操作系统,Linux 实现了抢占式多任务机制。也就是说,调度器可以随时决定任意进程停止运行,而让其它进程获得 CPU 资源。这种违背正在运行的进程意愿,停止其运行的行为就是所谓的「抢占」。抢占通常可以在定时器中断时发生,当中断发生时,调度器会检查是否需要切换任务,如果是,则会完成进程上下文切换。每个进程所获得的运行时间叫做进程的时间片(timeslice)。+ L1 s( f: f& M* C$ I: W! |* V1 R
任务通常可以区分为交互式(I/O 密集型)和非交互式(CPU 密集型)任务。交互式任务通常会重度依赖 I/O 操作(如 GUI 应用),并且通常用不完分配给它的时间片。而非交互式任务(如数学运算)则需要使用更多的 CPU 资源。它们通常会用完自己的时间片之后被抢占,并不会被 I/O 请求频繁阻塞。当然,现实中的应用程序可能同时包含上述两种分类任务。例如,文本编辑器,多数情况下,它会等待用户输入,但是在执行拼写检查时也会需要占用大量 CPU 资源。 |2 l9 }' q+ U1 F* y! x
操作系统的调度策略就需要均衡这两种类型的任务,并且保证每个任务都能得到足够的执行资源,而不会对其它任务产生明显的性能影响。 Linux 为了保证 CPU 利用率最大化,同时又能保证更快的响应时间,倾向于为非交互式任务分配更大的时间片,但是以较低的频率运行它们;而针对 I/O 密集型任务,则会在较短周期内频繁地执行。
2 a: D( x( O) v9 n
调度有关的进程描述符 进程描述符(task_struct)中的很多字段会被调度机制直接使用。以下仅列出一些核心的部分,并在后文详细讨论。
0 p0 l$ C0 j$ f/ G" \- struct task_struct {; Q* a {" l" F) f* c/ ]' P
- int prio, static_prio, normal_prio;. x' S8 K( s- {9 c; l X; ]# t, l
- unsigned int rt_priority;) h- S8 z" I5 k* L; d* j! {* W7 x
- const struct sched_class *sched_class;* A" \4 j1 B e1 v- x7 f
- struct sched_entity se;% r$ e' _* j+ s `1 C: \7 D& s
- struct sched_rt_entity rt;+ x8 d* I9 i+ ~6 t3 C
- …5 U8 G" h7 a5 L1 A/ d/ z
- unsigned int policy;
8 K4 z1 z Q8 ^0 e - cpumask_t cpus_allowed;, D0 _+ q" M: {& m' ~9 ]5 S
- …; Z3 }4 q) T1 h8 V% { o
- };
, |$ k; ?- K0 O; G/ E! U' o @
关于这些字段的说明如下:- prio 表示进程的优先级。进程运行时间,抢占频率都依赖于这些值。rt_priority 则用于实时(real-time)任务;
- sched_class 表示进程位于哪个调度类;
- sched_entity 的意义比较特殊。通常把一个线程(Linux 中的进程、任务同义词)叫作最小调度单元。但是 Linux 调度器不仅仅只能够调度单个任务,而且还可以将一组进程,甚至属于某个用户的所有进程作为整体进行调度。这就允许我们实现组调度,从而将 CPU 时间先分配到进程组,再在组内分配到单个线程。当引入这项功能后,可以大幅度提升桌面系统的交互性。比如,可以将编译任务聚集成一个组,然后进行调度,从而不会对交互性产生明显的影响。这里再次强调下,**Linux 调度器不仅仅能直接调度进程,也能对调度单元(schedulable entities)进行调度。这样的调度单元正是用 struct sched_entity 来表示的。需要说明的是,它并非一个指针,而是直接嵌套在进程描述符中的。当然,后面的谈论将聚焦在单进程调度这种简单场景。由于调度器是面向调度单元设计的,所以它会将单个进程也视为调度单元,因此会使用 sched_entity 结构体操作它们。sched_rt_entity 则是实时调度时使用的。
- policy 表明任务的调度策略:通常意味着针对某些特定的进程组(如需要更长时间片,更高优先级等)应用特殊的调度决策。Linux 内核目前支持的调度策略如下:1 K7 e7 `0 l( T' Y7 z0 Y D
- SCHED_NORMAL:普通任务使用的调度策略;
- SCHED_BATCH:不像普通任务那样被频繁抢占,可允许任务运行尽可能长的时间,从而更好地利用缓存,但是代价自然是损失交互性能。这种非常适合批量任务调度(批量的 CPU 密集型任务);
- SCHED_IDLE:它要比 nice 19 的任务优先级还要低,但它并非真的空闲任务;
- SCHED_FIFO 和 SCHED_RR 是软实时进程调度策略。它们是由 POSIX 标准定义的,由 <kernel/sched/rt.c> 里面定义的实时调度器负责调度。RR 实现的是带有固定时间片的轮转调度方式;SCHED_FIFO 则使用的是先进先出的队列机制。
5 p) ?) K+ i# l; y6 P! j
- cpus_allowed:用来表示任务的 CPU 亲和性。用户空间可以通过 sched_setaffinity 系统调用来设置。) p+ j; Z* n" Y: g& l
, Q Y" c" d4 ^5 ^0 h* K% H
优先级 Priority 进程优先级:普通任务优先级: 所有的类 Unix 操作系统都实现了优先级调度机制。它的核心思想就是给任务设定一个值,然后通过该值决定任务的重要程度。如果任务的优先级一致,则一次重复运行它们。在 Linux 中,每一个普通任务都被赋予了一个 nice 值,它的范围是 -20 到 +19,任务默认 nice 值是 0。" t# B# m& |6 J# w
nice 值越高,任务优先级越低(it's nice to others)。Linux 中可以使用 nice(int increment) 系统调用来修改当前进程的优先级。该系统调用的实现位于 <kernel/shced/core.c> 中。默认情况下,用户只能为该用户启动的进程增加 nice 值(即降低优先级)。如果需要增加优先级(减少 nice 值),或者修改其它用户进程优先级,则必须以 root 身份操作。# X, t, P" s+ |2 ], z: Z/ F
实时任务优先级:在 Linux 中,除了普通任务外,还有一类任务属于实时任务。实时任务是确保它们能够在一定时间范围内执行的任务,有两类实时任务,列举如下:- 硬实时任务:会有严格的时间限制,任务必须在时限内完成。比如直升机的飞控系统,就需要及时响应驾驶员的操控,并做出预期的动作。然而,Linux 本身并不支持硬实时任务,但是有一些基于它修改的版本,如 RTLinux(它们通常被称为 RTOS)则是支持硬实时调度的。
- 软实时任务:软实时任务其实也会有时间限制,但不是那么严格。也就是说,任务晚一点运行任务,并不会造成不可挽回的灾难性事故。实践中,软实时任务会提供一定的时间限制保障,但是不要过度依赖这种特性。例如,VOIP 软件会使用软实时保障的协议传来送音视频信号,但是即便因为操作系统负载过高,而产生一点延迟,也不会造成很大影响。无论如何,软实时任务总会比普通任务的优先级更高。 [/ z8 B! l) ? y8 }: r
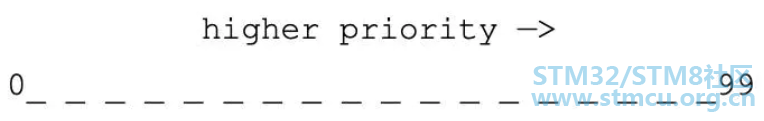
Linux 中实时任务的优先级范围是 0~99,但是有趣的是,它和 nice 值的作用刚好相反,这里的优先级值越大,就意味着优先级越高。' k6 R% A# T f; h" o- P& B
1 o5 |1 f# I8 o3 v类似其它的 Unix 系统,Linux 也是基于 POSIX 1b 标准定义的 「Real-time Extensions」实现实时优先级。可以通过如下的命令查看系统中的实时任务:
, N& o7 I l( q7 p
4 Z9 A& w9 e ` s" d s6 S- $ ps -eo pid, rtprio, cmd0 Y& C! M+ ~& J$ J5 R8 L6 z7 W
0 }, W+ e" O: Q" Y6 w
也可通过 chrt -p pid 查看单个进程的详情。Linux 中可以通过 chrt -p prio pid 更改实时任务优先级。这里需要注意的是,如果操作的是一个系统进程(通常并不会将普通用户的进程设置为实时的),则必须有 root 权限才可以修改实时优先级。& h' O" A+ W/ N
内核视角下的进程优先级:$ w8 ?: ^+ v1 \
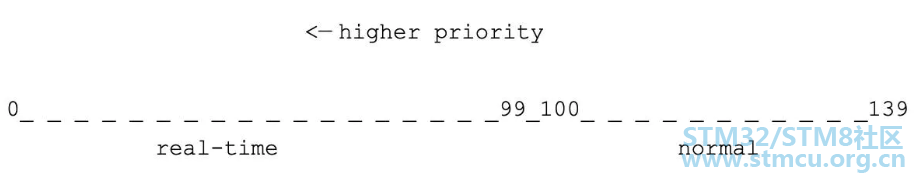
实时上,内核看到的任务优先级和用户看到的并不相同,在计算和管理优先级时也需要考虑很多方面。Linux 内核中使用 0~139 表示任务的优先级,并且,值越小,优先级越高(注意和用户空间的区别)。其中 0~99 保留给实时进程,100~139(映射成 nice 值就是 -20~19)保留给普通进程。! Y! m( S7 p8 a9 @8 q+ U5 u; O
3 x+ L" G# `$ f$ Q' g' J
我们可以在 <include/linux/sched/prio.h> 头文件中看到内核表示进程优先级的单位(scale)和宏定义(macros),它们用来将用户空间优先级映射到到内核空间。
* v/ j1 o4 d6 T* u! A# N- 0 ~6 H8 v8 Y% J u
- #define MAX_NICE 19/ Y1 i* b0 U# o
- #define MIN_NICE -207 W- K' `8 C0 _- q+ X3 h8 v
- #define NICE_WIDTH (MAX_NICE - MIN_NICE + 1), i9 n" P6 S* M/ X# W- q `0 U3 }
- …3 }0 J# S: t7 v; Q& \+ Y
- #define MAX_USER_RT_PRIO 100
! V' i" K0 R2 s/ l& b/ c6 \ - #define MAX_RT_PRIO MAX_USER_RT_PRIO- ^1 s; V+ j" m1 B* J' L( F3 Y9 e- {
- #define MAX_PRIO (MAX_RT_PRIO + NICE_WIDTH)' t# g7 \# ~2 W* K1 h+ ~' d
- #define DEFAULT_PRIO (MAX_RT_PRIO + NICE_WIDTH / 2)
+ O' E4 v/ B9 |7 K) v - /*2 k" G) U0 a6 b" C9 W
- * Convert user-nice values [ -20 ... 0 ... 19 ]; C' @/ Z; w6 A$ z% f' i2 H
- * to static priority [ MAX_RT_PRIO..MAX_PRIO-1 ],* e0 o1 ~$ J& G' T0 i; I
- * and back./ Z. ~( ^( y. d3 O
- */
1 K2 L2 ]: p1 _2 H' `, H1 j/ h - #define NICE_TO_PRIO(nice) ((nice) + DEFAULT_PRIO)
5 A; ~: T- ]9 k- [+ f - #define PRIO_TO_NICE(prio) ((prio) - DEFAULT_PRIO)
- u6 P+ z) q1 w* u8 i - /*3 Y5 d& ?3 J @9 L
- * 'User priority' is the nice value converted to something we
7 k1 X, E& g5 s; W! n l - * can work with better when scaling various scheduler parameters,' _6 K: u8 A8 v" F' E& { [$ T
- * it's a [ 0 ... 39 ] range.3 D$ i! Q' K5 ?2 F( X4 v9 m
- */
" d: n4 R/ T$ }9 p' j) z; `. ` - #define USER_PRIO(p) ((p)-MAX_RT_PRIO)$ D9 |4 l* [7 m' W6 f m! |- l
- #define TASK_USER_PRIO(p) USER_PRIO((p)->static_prio)
) } ?* @ ?0 p. ^, G' F - #define MAX_USER_PRIO (USER_PRIO(MAX_PRIO))
5 @- k, n7 c5 P
优先级计算: 在 task_struct 中有几个字段用来表示进程优先级:
6 X% K' B6 ^0 f3 c. L4 o
4 f1 o8 V; ~1 B5 w( [) J- {, e% i- int prio, static_prio, normal_prio;4 ~' Y& t& W4 Z
- unsigned int rt_priority;
1 m6 J4 U+ b$ A7 J _static_prio 是由用户或系统设定的「静态」优先级映射成内核表示的优先级: - p->static_prio = NICE_TO_PRIO(nice_value);
% M. ]9 J8 Z" m' i' s1 f
normal_prio 存放的是基于 static_prio 和进程调度策略(实时或普通)决定的优先级,相同的静态优先级,在不同的调度策略下,得到的正常优先级是不同的。子进程在 fork 时,会继承父进程的 normal_prio。
- P+ C* |! `+ \+ W- Y7 R" U3 \
prio 则是「动态优先级」,在某些场景下优先级会发生变动。一种场景就是,系统可以通过给某个任务优先级提升一段时间,从而抢占其它高优先级任务,一旦 static_prio 确定,prio 字段就可以通过下面的方式计算: : T* A1 f' v* k( J- Z3 e" |
( O0 C3 T5 a6 N, _, ]. N! T, @9 v- p->prio = effective_prio(p);0 e& {0 V2 _; V! @- L
- // kernel/sched/core.c 中定义了计算方法
~$ N, v/ x) }7 h J) h1 C6 w - static int effective_prio(struct task_struct *p)
( l3 o% O- E: h - {
& c. b4 i9 S3 ?: f6 E4 c5 K - p->normal_prio = normal_prio(p);
0 L! o Y& ~ M7 G - /*
' I8 h# X! K4 ^ - * If we are RT tasks or we were boosted to RT priority,
+ q6 m2 p* ^4 w# L+ M( W- h - * keep the priority unchanged. Otherwise, update priority; {* ^# ?2 u- c) `* Z# C, {, }+ _/ c
- * to the normal priority:
6 W9 B* b) `3 u0 m2 [' p - */
# n M% ]/ m! w8 w+ T: p% ` - if (!rt_prio(p->prio))
6 l. K9 e8 L7 ~$ F - return p->normal_prio;
' A; U2 C, H! B6 T+ ?% U - return p->prio;
' V: L! y5 O5 S4 N4 k- Y - }6 ]; a1 [8 l- ^& x ~
- 2 i2 @% a: E5 }% S: n0 u; x+ b% x
- static inline int normal_prio(struct task_struct *p)0 [2 p: {! P2 U' U( {) n
- { h+ ?1 |" g3 Y
- int prio;& q+ Y) |% p3 y! A X2 V, d
- if (task_has_dl_policy(p))7 K/ ?+ f- }: O1 w- ^2 j+ l4 ^9 y
- prio = MAX_DL_PRIO-1;
7 G$ n. c2 L. {7 k0 d - else if (task_has_rt_policy(p))
2 @0 q5 r$ O& j N5 U. D - prio = MAX_RT_PRIO-1 - p->rt_priority;3 I; c1 j/ B8 o# h9 j3 f
- else ( Q) H) D+ n% @: O
- prio = __normal_prio(p);
* X$ r; m# G! h: Q! U% }3 q5 r - return prio;
1 J g) v3 `# N# d* z: n - }
- k7 o3 { ]# H' D
. h, ?6 T/ v$ t- static inline int __normal_prio(struct task_struct *p)
' v5 s* A3 I/ O) x; M6 z - {/ R- S0 p6 E5 P+ p' C* r
- return p->static_prio;4 ~6 n0 j( ~/ P! E+ ]
- }
负载权重(Load Weights):优先级会让一些任务比别的任务更重要,因此也会获得更多的 CPU 使用时间。nice 值和时间片的比例关系是通过负载权重(Load Weights)进行维护的,我们可以在 task_struct->se.load 中看到进程的权重,定义如下:$ s W! \- ^: }
- 3 n; x' _3 s. @, M! I! U( A5 a$ _
- struct sched_entity {
) w8 B, u- d) J* O8 S! \ - struct load_weight load; /* for load-balancing */* C6 X: e4 u8 |4 w$ ?% g& a4 K. |
- …. L9 Y3 F4 |8 E% G4 g# L! x& i
- }
) X- u' l! h% Y - struct load_weight {
- T, S8 [1 u6 E/ m) u - unsigned long weight;
$ `' l+ U, z B/ o - u32 inv_weight;
& V# Z$ O9 I9 c/ e$ n - };
$ X: ~. w/ v9 I为了让 nice 值的变化反映到 CPU 时间变化片上更加合理,Linux 内核中定义了一个数组,用于映射 nice 值到权重:
/ O- n; m8 Z, t- w, r) P- static const int prio_to_weight[40] = {0 c( o# }; g# |( R1 x2 Q D+ X
- /* -20 */ 88761, 71755, 56483, 46273, 36291," E6 V+ s# x/ }- v: Q& Q# h
- /* -15 */ 29154, 23254, 18705, 14949, 11916,
) ]3 C, z, _3 @ - /* -10 */ 9548, 7620, 6100, 4904, 3906,
2 ?( ]; T& k" p( y- ~+ c+ z5 U - /* -5 */ 3121, 2501, 1991, 1586, 1277,
2 i8 i H/ y0 a0 G4 f! ] O* \ - /* 0 */ 1024, 820, 655, 526, 423,7 F; v% E1 o% K" ~4 M" @6 s
- /* 5 */ 335, 272, 215, 172, 137,$ y' q. Z# j/ ?! i& u8 R
- /* 10 */ 110, 87, 70, 56, 45,
: @- |- U, n$ T; {, z% e - /* 15 */ 36, 29, 23, 18, 15,8 p6 g5 C+ I' }
- };
来看看如何使用上面的映射表,假设有两个优先级都是 0 的任务,每个都能获得 50% 的 CPU 时间(1024 / (1024 + 1024) = 0.5)。如果突然给其中的一个任务优先级提升了 1 (nice 值 -1)。此时,一个任务应该会获得额外 10% 左右的 CPU 时间,而另一个则会减少 10% CPU 时间。来看看计算结果:1277 / (1024 + 1277) ≈ 0.55,1024 / (1024 + 1277) ≈ 0.45,二者差距刚好在 10% 左右,符合预期。完整的计算函数定义在 <kernel/sched/core.c> 中:
4 o0 W k5 }4 g; ~0 e+ W8 g- static void set_load_weight(struct task_struct *p)
" m2 T `1 c3 Y/ O! C5 o' j5 M - {
: w1 e+ f# P2 k" h2 t4 J$ i - int prio = p->static_prio - MAX_RT_PRIO;$ B* j- \! S6 ]7 u+ R
- struct load_weight *load = &p->se.load;
0 w5 {8 B4 [' Q/ ~( \2 [3 d - /*4 r B7 e* ~3 s4 e1 I4 j3 G& w, N0 L. f
- * SCHED_IDLE tasks get minimal weight:
/ M& c" x. t) k" o$ O$ t+ j/ ^4 C - */
& l1 s# q: {4 k* e+ _ - if (p->policy == SCHED_IDLE) {
4 H/ {, `5 o" [ w+ v4 q - load->weight = scale_load(WEIGHT_IDLEPRIO);/ q3 J$ d& S p+ u$ e
- load->inv_weight = WMULT_IDLEPRIO;' K, P0 G* S0 p/ p
- return;
9 t5 c) X& d1 I! u: ^ - }' H1 ~8 A% { ^) h2 O2 _
- load->weight = scale_load(prio_to_weight[prio]);% W; o- Q: t: v
- load->inv_weight = prio_to_wmult[prio];
' d- a2 o; F6 x: }1 A - }
! n6 n3 L. F, t" ]6 z
调度类 Scheduling Classes 虽说 Linux 内核使用的 C 语言并非所谓的 OOP 语言(没有类似 C++/Java 中的 class 概念),但是我们可以在内核代码中看到一些使用 C 语言结构体 + 函数指针(Hooks)的方式来模拟面向对象的方式,抽象行为和数据。调度类也是这样实现的(此外,还有 inode_operations, super_block_operations 等),它的定义如下(位于 <kernel/shced/sched.h>):6 F5 Y3 I( n% o) G5 q
- 3 E- g( A8 F, z& X4 a) H
- // 为了简单起见,隐藏了部分代码(如 SMP 相关的), y# D& q$ y7 X A/ A+ w
- struct sched_class {
4 K( H. S9 V1 d& s/ O$ u5 \. @& g - // 多个 sched_class 是链接在一起的
" {* j0 z+ j' A4 E$ h( M" @ - const struct sched_class *next;
$ i0 M/ A+ L; z1 O/ i T4 @ - // 该 hook 会在任务进入可运行状态时调用。它会将调度单元(如一个任务)放到; ]$ [% g5 g1 B" M6 A, n$ G$ X
- // 队列中,同时递增 `nr_running` 变量(该变量表示运行队列中可运行的任务数)
% u) J/ R. A$ p2 ~ - void (*enqueue_task) (struct rq *rq, struct task_struct *p, int flags);
3 v) S! p7 M$ d: Y4 K* C - // 该 hook 会在任务不可运行时调用。它会将任务移出队列,同时递减 `nr_running`" b& @" d% K) b1 n2 I/ Z
- void (*dequeue_task) (struct rq *rq, struct task_struct *p, int flags);
: Q8 j4 D4 b% f" {$ | - // 该 hook 可以在任务需要主动放弃 CPU 时调用,但是需要注意的是,它不会改变2 n: D/ B0 U" D, j0 ]! f* X$ u
- // 任务的可运行状态,也就是说依然会在队列中等待下次调度。类似于先 dequeue_task,
4 Q6 O6 @) l- x - // 再 enqueue_task3 T( G8 p/ j. Q
- void (*yield_task) (struct rq *rq);# G" N/ W! }+ \ N, c
- // 该 hook 会在任务进入可运行状态时调用并检查是否需要抢占当前任务
" W' ?. V; \; B. R; }2 R; N7 Q - void (*check_preempt_curr) (struct rq *rq, struct task_struct *p, int flags);( O0 u+ D; Y! G- z- D C/ ~! a
- // 该 hook 用来选择最适合运行的下一个任务
- t6 V. H# E/ R8 H - struct task_struct * (*pick_next_task) (struct rq *rq, struct task_struct *prev);( t: S' q( k1 x' Z& L, n. H
- // 该 hook 会在任务修改自身的调度类或者任务组时调用
* N2 k. P5 v) z! c - void (*set_curr_task) (struct rq *rq);) ]4 c! a2 D' B! b9 C, o% e: U
- // 通常是在时钟中断时调用,可能会导致任务切换
& h3 s+ E) k1 O- c" J6 x - void (*task_tick) (struct rq *rq, struct task_struct *p, int queued);
' ]' u/ x; k% o3 |: P+ @ - // 当任务被 fork 时通知调度器
4 d* t1 m; y1 H3 \ - void (*task_fork) (struct task_struct *p);8 w! r; Z+ W, l w/ Z0 [
- // 当任务挂掉时通知调度器( ^ s9 n. ]) c
- void (*task_dead) (struct task_struct *p);
) p/ B0 V. u- X# p, M* k/ I0 A - };
- core.c 包含调度器的核心部分;
- fair.c 实现了 CFS(Comple Faire Scheduler,完全公平任务调度器) 调度器,应用于普通任务;
- rt.c 实现了实时调度,应用于实时任务;
- idle_task.c 当没有其它可运行的任务时,会运行空闲任务。
2 V$ B& X& r: W( E/ o8 M内核是基于任务的调度策略(SCHED_*)来决定使用何种调度类实现,并会调用相应的方法。SCHED_NORMAL, SCHED_BATCH 和 SCHED_IDLE 进程会映射到 fair_sched_class (由 CFS 实现);SCHED_RR 和 SCHED_FIFO 则映射的 rt_sched_class (实时调度器)。
- T4 @* O% u) f8 J
! L6 ~$ x2 W6 I% ~
运行队列 runqueue 所有可运行的任务是放在运行队列中的,并且等待 CPU 运行。每个 CPU 核心都有自己的运行队列,每个任务任意时刻只能处于其中一个队列中。在多处理器机器中,会有负载均衡策略,任务就会转移到其它 CPU 上运行的可能。3 P6 v7 z, |' P8 h
运行队列数据结构定义如下(位于 <kernel/sched/sched.h>):7 ] r) T' ?5 E% u4 s' r, P
- ; X; Z. x- b9 g2 f* T v
- // 为了简单起见,隐藏了部分代码(SMP 相关)
* i' n% { x% L - // 这个是每个 CPU 都会有的一个任务运行队列1 b; ~ d# G3 j9 f6 s1 g( a* k
- struct rq
: ?7 L; Q$ |( N' s" f* t - {
. P9 O3 s, D" m( J9 h" l3 f1 s8 d - // 表示当前队列中总共有多少个可运行的任务(包含所有的 sched class)
8 g+ C L( y/ V+ A4 V8 i( t) \ - unsigned int nr_running;$ ]! P: g9 `' _* v
- #define CPU_LOAD_IDX_MAX 51 G2 N( m; n2 `& X
- unsigned long cpu_load[CPU_LOAD_IDX_MAX];; S4 W# o4 X" r7 e8 m( s0 |; H
- // 运行队列负载记录
& o0 ?' g! T+ b( l5 X3 x# L - struct load_weight load;$ C; k9 p8 H5 z/ a; p
- // 嵌套的 CFS 调度器运行队列
7 r0 ~9 K+ D) [2 a: J - struct cfs_rq cfs;- O; M) M C3 i" U
- // 嵌套的实时任务调度器运行队列% e0 t9 `3 o8 L! U/ Z) s1 x; J
- struct rt_rq rt;
& T. j C% n6 F2 h) R- m - // curr 指向当前正在运行的进程描述符
8 S: Q/ v% k3 Y' y" A+ {- ~5 A - // idle 则指向空闲进程描述符(当没有其它可运行任务时,该任务才会启动)
( j# j9 e$ |6 F; T - struct task_struct *curr, *idle;0 K Q2 f/ Q. \" P8 ^% [
- u64 clock;) g) E' e$ o. [% I
- int cpu;. ]8 _4 F# _0 N8 f6 o
- }
1 y4 u) ~/ B$ }( v何时运行调度器? 实时上,调度函数 schedule() 会在很多场景下被调用。有的是直接调用,有的则是隐式调用(通过设置 TIF_NEED_RESCHED 来提示操作系统尽快运行调度函数)。以下三个调度时机值得关注下:+ w- |4 o0 K8 L0 q }% l+ Y( T$ M$ M
9 e& M+ ~0 Q% g9 q, ?' v- @9 h( A4 V
Linux 调度器 早期版本:Linux 0.0.1 版本就已经有了一个简单的调度器,当然并非适合拥有特别多处理器的系统。该调度器只维护了一个全局的进程队列,每次都需要遍历该队列来寻找新的进程执行,而且对任务数量还有严格限制(NR_TASKS 在最初的版本中只有 32)。下面来看看这个调度器是如何实现的吧: - % n* L2 r& t7 \8 m$ X* h
- // 'schedule()' is the scheduler function. 4 N2 \& n/ J# h9 x5 P
- // This is GOOD CODE! There probably won't be any reason to change 2 w+ i0 T' `2 O) m
- // this, as it should work well in all circumstances (ie gives
0 k, C2 ^+ K6 I; G, }4 ] - // IO-bound processes good response etc)...1 g3 S7 l$ t% G, @3 ?! x
- void schedule(void)) b Y0 ]; F( S" g% }3 g1 G5 ]+ k
- {
( U2 Q& h7 H" W8 h6 N1 Z1 q - int i, next, c; }- U5 @& p7 H6 x$ W4 F' X
- struct task_struct **p;- ~0 `7 u2 w+ m' a
- // 遍历所有任务,如果有信号,则需要唤醒 `TASK_INTERRUPTABLE` 的任务
- N" _, x* [% _ - for (p = &LAST_TASK; p > &FIRST_TASK; --p)
# f- @; I8 H5 T/ l. V- L, k - if (*p) {
) }; M! i C ~* N, f! Z+ F' m0 l - if ((*p)->alarm && (*p)->alarm < jiffies) {
! q3 J$ A# [9 c4 w - (*p)->signal |= (1 << (SIGALRM - 1));3 V( N' y' V/ m1 @7 N( u
- (*p)->alarm = 0;- B- Y7 J& j3 G1 I8 ~/ T
- }
: X; r: B# |& g - if ((*p)->signal && (*p)->state == TASK_INTERRUPTIBLE)
0 a# S( j" m8 l$ w1 O8 f+ \ - (*p)->state = TASK_RUNNING;
) {( {, C1 s/ ]5 y( O - }
$ i5 p, m! A; T( J8 u8 { - while (1)3 Q5 F( I+ u, b; M
- {3 y+ N$ f# a" z! X% q* h
- c = -1;
2 D3 M! d% u$ K - next = 0;
) C+ G* b2 q' _' @' K* \ - i = NR_TASKS;
+ ?! v! \# S0 X" R k- x - p = &task[NR_TASKS];3 h" I; g3 w6 S, w2 Y+ t; g
- // 遍历所有任务,找到时间片最长的那个# z' @% h% `* j9 w
- while (--i) {. k3 ~# `7 D; J2 y7 d" b
- if (!*--p)
1 t& Y. }6 y* R# z8 Z: P) A0 y- s - continue;- B( u5 N! D* d+ K$ A2 C
- if ((*p)->state == TASK_RUNNING && (*p)->counter > c)& E- {/ j- S' g, @, D$ _
- c = (*p)->counter, next = i;% j1 B; h8 t. L* T" u0 u; l
- }
; L }& ]4 T' u, s" d( ^. Q9 J. K - if (c)
: q4 J F# B% ]1 O" i" _0 n$ K; [ - break;
5 }! r& w; z& o1 X, f - // 遍历任务,重新设值时间片
+ B3 E; q8 T% {7 q& z X( z - for (p = &LAST_TASK; p > &FIRST_TASK; --p): Q! D2 v! Q! Y4 Y
- if (*p)
( _* \: r- U5 s# [+ n. [+ i5 c - (*p)->counter = ((*p)->counter >> 1) + (*p)->priority;2 _" r6 O) P7 H+ L/ r+ B
- }
* r$ U- h" I5 n' |# A4 { - // 切换到下一个需要执行的任务4 s- P4 q! F* x! I( O
- switch_to(next);
3 @( T3 u9 J/ T9 @ - }
% U+ b( f# V0 W
O(n): 2.4 版本的 Linux 内核使用的调度算法非常简单和直接,由于每次在寻找下一个任务时需要遍历系统中所有的任务(链表),因此被称为 O(n) 调度器(时间复杂度)。
; O1 {, b* S* n& T: F2 m. h; q" j/ Y& L" c# h E) |- w# S/ a
当然,该调度器要比 0.01 版本内核中的调度算法稍微复杂点,它引入了 epoch 概念。也就是将时间分成纪元(epochs),也就是每个进程的生命周期。理论上来说,每个纪元结束,每个进程都应该运行过一次了,而且通常用光了它当前的时间片。但实际上,有些任务并没有完全用完时间片,那么它剩余时间片的一半将会和新的时间片相加,从而在下一个纪元运行更长的时间。 w3 H4 ]# d6 e4 x& ?
我们来看下 schedule() 算法的核心源码:( ]3 B2 N$ L! v7 {( G, n3 d
- 8 v# u, j+ A/ x$ L
- // schedule() 算法会遍历所有的任务(O(N)),并且计算出每个任务的+ K1 z! M' h2 B2 D% z% B
- // goodness 值,且挑选出「最好」的任务来运行。
/ x4 r* d, U/ F: G. m0 W* }; m2 \ - // 以下是部分核心源码,主要是了解下它的思路。0 q& `7 X: k( F6 a" E' |+ z
- asmlinkage void schedule(void)
% C, r% _, G5 g- r - {. T9 y7 a u' a0 S- x; e7 ~& u6 P4 S j
- // 任务(进程)描述符:1 U4 w) I6 O: {5 |
- // 1. prev: 当前正在运行的任务
+ l; d2 L4 |$ y1 T* q$ e - // 2. next: 下一个将运行的任务
5 M! J3 @( D9 M; j& |$ a - // 3. p: 当前正在遍历的任务& i6 p9 C7 u# h8 I5 @5 h5 L
- struct task_struct *prev, *next, *p;6 b: K% i. C6 \: W: n# U! S- Q
- int this_cpu, c; // c 表示权重值$ H7 A9 \) s9 r( L2 W7 v" ?
- repeat_schedule:( W2 s( }" V, N# u' K9 n0 {& P- ~
- // 默认选中的任务
- x$ a/ ?+ ^# M) e. l7 t* K - next = idle_task(this_cpu);
" a0 |7 p* L" |$ {6 a" Q( W - c = -1000;4 Q1 M8 J4 P4 _! ~- [
- list_for_each(tmp, &runqueue_head) {
0 k4 c, S$ { D- S6 [, f - p = list_entry(tmp, struct task_struct, run_list);; ~% h# x3 ?0 H6 V0 E4 o F
- if (can_schedule(p, this_cpu)) {. b! F5 ` t$ p1 {6 t
- int weight = goodness(p, this_cpu, prev->active_mm);6 `9 r* F8 [/ x! }
- if (weight > c)
$ {& D2 Z; @& X( J' Q+ i - c = weight, next = p;
/ R4 A4 N% W% H; d* t. c% R3 e - }
C/ l4 K9 S+ n$ X! T# ?- Y2 ] - }& h: c1 y* c8 s0 \- w1 Z
- }
源码中的 goodness() 函数会计算出一个权重值,它的算法基本思想就是基于进程所剩余的时钟节拍数(时间片),再加上基于进程优先级的权重值。返回值如下: - -1000 表示不要选择该进程运行
- 0 表示时间片用完了,需要重新计算 counters(可能会被选中运行)
- 正整数:表示 goodness 值(越大越好)
- +1000 表示实时进程,接下来就要选择它运行1 D% \& Y5 `5 D
+ _+ N& u" ~' G" f最后,针对 O(n) 调度器做下总结:- 算法实现非常简单,但是不高效(任务越多,遍历耗费时间越久)
- 没有很好的扩展性,多核处理器怎么办?
- 对于实时任务调度支持较弱(无论如何作为优先级高的实时任务都需要在遍历完列表后才可以知道)
3 j% y3 T: T9 t5 @1 r% c
! F0 ~3 {5 l: G/ @4 g2 u, D9 }. k5 {6 [; t0 P' }
O(1): Ingo Molnár 大佬在 2.6 版本的内核中加入了全新的调度算法,它能够在常数时间内调度任务,因此被称为 O(1) 调度器。我们来看看它引入的一些新特性:" v- H% w3 G5 }% }' ?3 W# n* N4 L8 Y
- 全局优先级单位,范围是 0~139,数值越低,优先级越高
- 将任务拆分成实时(099)和正常(100139)两部分。更高优先级任务获得更多时间片
- 即刻抢占(early preemption)。当任务状态变成 TASK_RUNNING 时,内核会检查其优先级是否比当前运行的任务优先级更高,如果是的话,则抢占当前正在运行的任务,切换到该任务
- 实时任务使用静态优先级
- 普通任务使用使用动态优先级。任务优先级会在其使用完自己的时间片后重新计算,内核会考虑它过去的行为,决定它的交互性等级。交互型任务更容易得到调度" ^* I p" \6 H+ V3 `& a
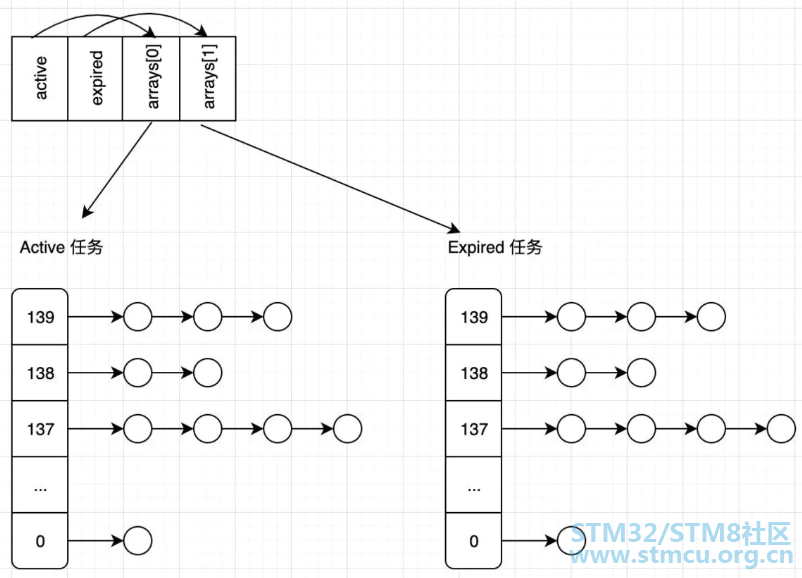
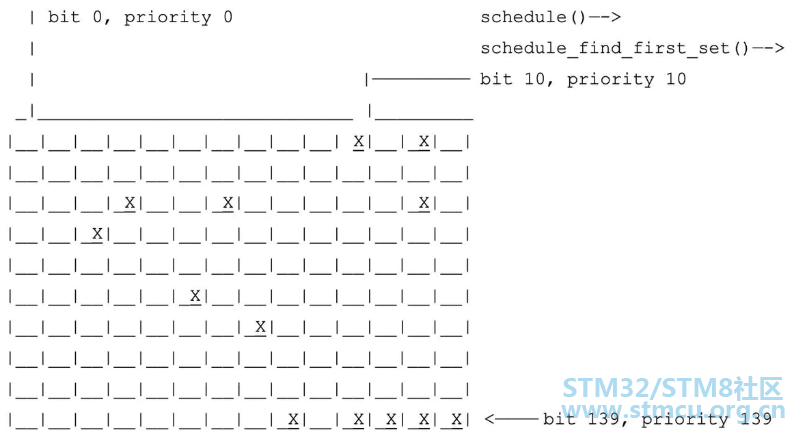
7 x- I8 b& p& w7 \7 ] L8 yO(n) 的调度器会在每个纪元结束后(所有任务的时间片都使用过),才会重新计算任务优先级。而 O(1) 则是在每个任务时间片配额用完后就重新计算优先级。O(1) 调度器为每个 CPU 维护了两个队列,即 active 和 expired。active 队列存放的是时间片尚未用完的任务,而 expired 则是时间片已经耗尽的任务。当一个任务的时间片用完后,就会被转到 expired 队列,而且会重新计算它的优先级。当 active 队列任务全部转移到 expired 队列后,会交换二者(让 active 指向 expired 队列,expired 指向 active 队列)。可以看到,优先级的计算,队列切换都和任务数量多寡无关,能够在 O(1) 时间复杂度下完成。! F/ N. y- {8 x+ l
: }) }; c5 u7 ~( x: U在先前介绍的调度算法中,如果想要取一个优先级最高的任务,还需要遍历整个任务链表才可以。而 O(1) 调度器则很特别,它为每种优先级提供了一个任务链表。所有的可运行任务会被分散在不同优先级队应的链表中。$ t3 [9 o5 A; `
接下来看看全新的 runqueue 是怎么定义的吧:
1 ]3 r) U0 i2 j8 o+ ?% k1 Y- - d/ t. x' _$ G+ r% H9 k
- struct runqueue {* A, x6 {) Z$ o1 S9 H& ~/ |3 P+ U
- unsigned long nr_running; /* 可运行的任务总数(某个 CPU) */, c/ I# M' R) h8 W
- struct prio_array *active; /* 指向 active 的队列的指针 */
6 ?/ H' p# p* Q+ Q - struct prio_array *expired; /* 指向 expired 的队列的指针 */
3 L; U( l/ b% g; ?/ B3 Y" T$ p D - struct prio_array arrays[2]; /* 实际存放不同优先级对应的任务链表 */2 z! D1 j' P. p/ i6 k7 q+ }& J
- }
* ?: v6 V* k5 ?9 F% L4 ?, g& A; A9 D0 W3 ]" s% ~* C5 V
通过下面的图可以直观感受下任务队列: ; {& ~3 t& x1 L' ^
8 t, V4 P" g! L- g; x
接下来看看 prio_array 是怎么定义的:
! o# \3 q8 l5 F! y$ j- struct prio_array {
8 F4 I2 |% s5 D& P5 j - int nr_active; /* 列表中的任务总数 */
- u# L, o! w$ \- F y, J, K ] - unsigned long bitmap[BITMAP_SIZE]; /* 位图表示对应优先级链表是否有任务存在 */0 M8 |7 o! |' s1 W2 q9 c
- struct list_head queue[MAX_PRIO]; /* 任务队列(每种优先级对应一个双向链表) */
$ r2 Q9 k6 O6 T6 ~8 ^" A3 y: ]6 n - };
* L0 f6 a0 f2 q% g5 F6 [& s3 n$ z3 y. K; F
可以看到,在 prio_array 中存在一个位图,它是用来标记每个 priority 对应的任务链表是否存在任务的。接下来看看为何 O(1) 调度器可以在常数时间找到需要运行的任务: - 常数时间确定优先级:首先会在位图中查找到第一个设置为 1 的位(总共有 140 bits,从第一个 bit 开始搜索,这样可以保证高优先级的任务先得到机会运行),如果找到了就可以确定哪个优先级有任务,假设找到后的值为 priority;
- 常数时间获得下一个任务:在 queue[priority] 对应的任务链表中提取第一个任务来执行(多个任务会轮转执行)。
$ }6 T, d* \3 q- Q& W8 L$ W, \
4 R6 j y# x6 C3 P. P* n/ c
好了,是时候总结下 O(1) 调度器的优缺点了:- 设计上要比 O(n) 调度器更加复杂精妙;
- 相对来说扩展性更好,性能更优,在任务切换上的开销更小;
- 用来标记任务是否为交互类型的算法还是过于复杂,且容易出错。
' a5 d S: t. ]! L/ y1 P4 P& S
, f7 @2 |5 v8 WCFS:单核调度:CFS 的全称是 Complete Fair Scheduler,也就是完全公平调度器。它实现了一个基于权重的公平队列算法,从而将 CPU 时间分配给多个任务(每个任务的权重和它的 nice 值有关,nice 值越低,权重值越高)。每个任务都有一个关联的虚拟运行时间 vruntime,它表示一个任务所使用的 CPU 时间除以其优先级得到的值。相同优先级和相同 vruntime 的两个任务实际运行的时间也是相同的,这就意味着 CPU 资源是由它们均分了。为了保证所有任务能够公平推进,每当需要抢占当前任务时,CFS 总会挑选出 vruntime 最小的那个任务运行。
4 `6 C6 X4 B4 j# R内核版本在 2.6.38 之前,每个线程(任务)会被当成独立的调度单元,并且和系统中其它线程共享资源,这就意味着一个多线程的应用会比单线程的应用获得更多的资源。之后,CFS 不断改进,目前已经支持将一个应用中的线程打包到 cgroup 结构中,cgroup 的 vruntime 是其中所有线程的 vuntime 之和。然后 CFS 就可以将它的算法应用于cgroup 之间,从而保证公平性。当某个 cgroup 被选中后,其中拥有最小 vruntime 的线程会被执行,从而保证 cgroup 中的线程之间的公平性。cgroup 还可以嵌套,例如 systemd 会自动配置 cgroup 来保证不同用户之间的公平性,然后在用户运行的多个应用之间维持公平性。
0 y4 o1 S4 V8 m# ?0 O. X2 [
CFS 通过在一定时间内运行调度所有的线程来避免饥饿问题。当运行的 线程数在 8 个及以下时,默认的时间周期是 48ms;而当多于 8 个线程时,时间周期就会随着线程数量而增加(6ms * 线程数,之所以选择 6ms,是为了避免频繁抢占,导致上下文切换频繁切换的开销)。由于 CFS 总是会挑选 vruntime 最小的线程执行,它就需要避免某个线程的 vruntime 太小,以至于其它线程需要等待很久才能得到调度(会有饥饿问题)。所以在实践中,CFS 会保证所有线程之间的 vruntime 之差低于抢占时间(6ms),它是通过如下两点来保证的: 4 l @5 G% |; Y; e: v6 J6 [
CFS 还引入了启发式调度思想来改善高速缓存利用率。例如,当线程被唤醒时,它会检查该线程的 vruntime 和正在运行的线程 vruntime 之差是否非常显著(临界值是 1ms),如果不是的话,则不会抢占当前正在运行的任务。但是这种做法还是以牺牲调度延迟为代价的,算是一种权衡吧。
. J/ E; Z' Y* Z! o6 W! e1 I8 _
多核负载均衡: 在多核环境中,Linux CFS 会将工作(work)分摊到多个处理器核心中执行。但是这不等同于将线程均分到多个处理器。比如,一个 CPU 密集型的线程和 10 个频繁睡眠的线程可能分别在两个核上执行,其中一个专门执行 CPU 密集型线程;而另一个则处理那 10 个频繁睡眠的线程。7 l. l7 F1 U- _
为了多个处理器上的工作量均衡,CFS 使用了 load 指标来衡量线程和处理器的负载情况。线程的负载和线程的 CPU 平均使用率相关:经常睡眠的线程负载要低于不睡眠的线程负载。类似 vruntime,线程的负载也是线程的优先级加权得到的。而处理器的负载是在该处理器上可运行线程的负载之和。CFS 会尝试均衡处理器的负载。 ' K; b I: s1 n, O" N# P
CFS 会在线程创建和唤醒时关注处理器的负载情况,调度器首先要决定将任务放在哪个处理器的运行队列中。这里也会涉及到启发式思想,比如,如果 CFS 检查到生产者-消费者模型,那么它会将消费者线程尽可能地分散到机器的多个处理器上,因为多数核心都适合处理唤醒的线程。
& B: `* f+ S* L Y0 {4 k. y
负载均衡还会周期性发生,每隔 4ms,每个处理器都会尝试从其它处理器偷取一些工作。当然,这种 work-stealing 均衡方法还会考虑机器的拓扑结构:处理器会尝试从距离它们「更近」的其它处理器上尝试窃取工作,而非距离「更远」的处理器(如远程 NUMA 节点)。当处理器决定要从其它处理器窃取任务时,它会尝试在二者之间均衡负载,并且会窃取多达 32 个线程。此外,当处理器进入空闲状态时,它也会立刻调用负载均衡器。
8 t7 B2 `, u* V9 A3 ]- W+ d( d/ {( K) ~
在大型的 NUMA 机器上,CFS 并不会粗暴地比较所有 CPU 的负载,而是以分层的方式进行负载均衡。以一台有两个 NUMA 节点的机器为例,CFS 会先在 NUMA 节点内部的处理器之间进行负载均衡,然后比较 NUMA 节点之间的负载(通过节点内部处理器负载计算得到),再决定要不要在两个节点之间进行负载均衡。如果 NUMA 节点之间的负载差距在 25% 以内,则不会进行负载均衡。总结来说,如果两个处理器(或处理器组)之间的距离越远,那么只有在不平衡性差距越大的情况下才会考虑负载均衡。 $ A% F4 d/ N; N2 s9 }
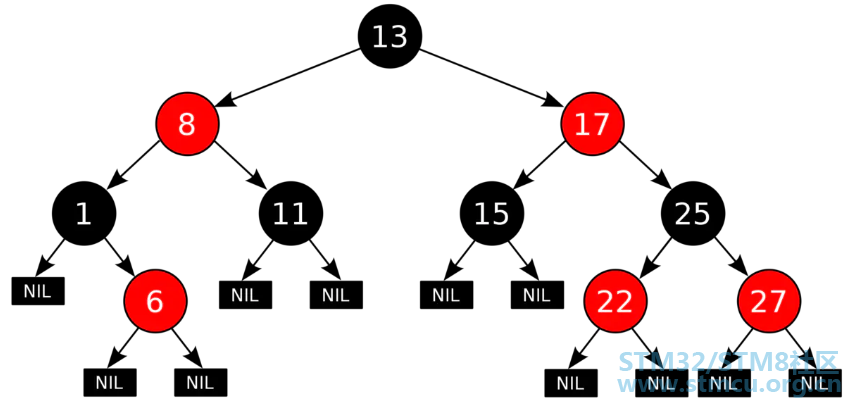
运行队列: CFS 引入了红黑树(本质上是一棵半平衡二叉树,对于插入和查找都有 O(log(N)) 的时间复杂度)来维护运行队列,树的节点值是调度单元的 vruntime,拥有最小 vruntime 的节点位于树的最左下边。 ' L+ W e6 |/ x- K X w
" p# M# U) U! R8 i
接下来看看 cfs_rq 数据结构的定义(位于 <kernel/sched/sched.h>):
2 ^- t- B2 x, z. s& E4 g- struct cfs_rq
3 N2 d* B8 K) w9 Z& S - {0 O; x; ~$ i) g6 i7 M
- // 所有任务的累计权重值; f6 u7 q" p8 `& t5 y
- struct load_weight load;! M* z9 A- t' e1 H6 y
- // 表示该队列中有多少个可运行的任务& g7 n: @* J+ L
- unsigned int nr_running;+ ]% R! Z3 t1 f$ A+ h \ P) E9 H
- // 运行队列中最小的 vruntime
y- F V: Q- G. e' c - u64 min_vruntime;+ W: b6 k! v+ Q5 Y" T+ ?
- // 红黑树的根节点,指向运行任务队列' f. j% |" Z- k8 D- P" y) h2 {
- struct rb_root tasks_timeline;
/ Q! ~ M4 \4 Z- V. m' ^: v( o+ z - // 下一个即将被调度的任务
5 S. z1 E. q6 u6 J8 I" {9 q# ~" m - struct rb_node *rb_leftmost;9 M& z% t6 c& q5 G
- // 指向当前正在运行的调度单元
9 @5 W" ] W. [' p, X! C% s - struct sched_entity *curr;! X4 V7 n* m1 i3 m3 Q* @
- }
1 O& l8 A+ n7 T# }& [+ \$ fCFS 算法实际应用于调度单元(这是一个更通用的抽象,可以是线程、cgroups 等),调度单元数据结构定义如下(位于 <include/linux/sched.h>): - * o' ~- x5 }, g9 U& J4 T# E2 a0 G
- struct sched_entity
5 F+ f- N& U4 |& X7 M - {5 Y& c* e7 [; X4 K: d. I
- // 表示调度单元的负载权重(比如该调度单元是一个组,则该值就是该组下所有线程的负载权重的组合)5 F( P A& L9 K" K$ ^: ?9 _: S
- struct load_weight load; /* for load-balancing */- M) V' w$ F$ ]& q/ `. u$ f& C4 M
- // 表示红黑树的节点7 n* g `- v) X# C& @; R, T2 ~
- struct rb_node run_node;# u+ ~/ v2 L6 A
- // 表示当前调度单元是否位于运行队列1 c3 A* j- H. F9 U, F) K
- unsigned int on_rq;0 {) Z) N" s! g* X: I* v% L
- // 开始执行时间
; K2 d6 `0 C; Q% l, a0 Q+ C6 p - u64 exec_start;
$ R& Q# Y. z7 Z# D1 L - // 总共运行的时间,该值是通过 `update_curr()` 更新的。
# w/ d& j' A! T5 `; w- |. @ ] - u64 sum_exec_runtime;
- q# z) U& r% ~/ P6 r- l - // 基于虚拟时钟计算出该调度单元已运行的时间
' L+ ~3 k, S4 w0 ]; f& a* l - u64 vruntime;
+ \5 o2 \& V& a- `. \ - / s$ ]& ~4 Z" h% }
- // 用于记录之前运行的时间之和+ \$ U! Z/ l$ l5 w& N: y( O$ W
- u64 prev_sum_exec_runtime;- z6 }4 M7 z% n& Q1 D
- };
) P) @0 _# G0 y8 g4 f0 Y! Z9 u$ I, D5 P) \& K' w
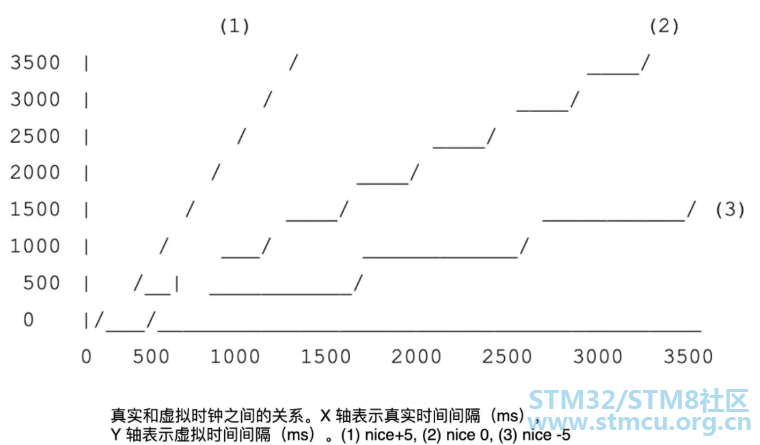
虚拟时钟: 前面提到的 vruntime 究竟是什么呢?为什么叫作虚拟运行时间呢?接下来就要揭开它的神秘面纱。为了更好地实现公平性,CFS 使用了虚拟时钟来测量一个等待的调度单元在一个完全公平的处理器上允许执行的时间。然而,虚拟时钟并没有真实的实现,它只是一个抽象概念。0 Q/ K" b8 g6 k
我们可以基于真实时间和任务的负载权重来计算出虚拟运行时间,该算法是在 update_cur() 函数中实现的,它会更新调度单元的时间记账信息,以及 CFS 运行队列的 min_vruntime(完整定义位于 <kernel/sched/fair.c>):1 X0 y+ g9 w5 \2 m6 `/ V
* [7 L2 @# G% n z b. _# ]- static void update_curr(struct cfs_rq *cfs_rq)
4 A* F4 t: Y( {1 R+ W5 Q/ o4 [ - {8 L K- {3 L; w+ T
- struct sched_entity *curr = cfs_rq->curr;
8 `; M$ x9 ]: j$ g - u64 now = rq_clock_task(rq_of(cfs_rq));
! ?: U& K2 o/ f. D" Z, d4 ` - u64 delta_exec;# G8 [. V9 o7 L6 |' J. C2 d
- if (unlikely(!curr))
; j; e8 {8 k! j$ J& r! y- X - return;
' c. ~1 l1 k) {: f/ z5 v - // 计算出调度单元开始执行时间和当前之间的差值,即真实运行时间
7 Y+ @# P! g9 {4 [; p - delta_exec = now - curr->exec_start;0 Y. G9 d" G1 E K
- curr->vruntime += calc_delta_fair(delta_exec, curr);
0 s1 o; ]2 ~4 H' h1 l. Y: z# B- j - update_min_vruntime(cfs_rq);% D! ]* W+ v. l. v# s
- }
; w: G; n! L3 h5 z* E - : o' _: j( L2 T; o$ s- e) _
- static inline u64 calc_delta_fair(u64 delta, struct sched_entity *se)
* F5 }/ F; [3 k! F - {/ s, |2 t4 _8 A+ x4 h8 t
- // 如果任务的优先级是默认的优先级(内部 nice 值是 120),那么虚拟运行时间
8 a9 ?2 y8 W; ?# k5 C; c4 d2 Z- Y - // 就是真实运行时间。否则,会基于 `__calc_delta` 计算出虚拟运行时间。
+ h; V; K. D. P- A, X! e - if (unlikely(se->load.weight != NICE_0_LOAD))
6 p- z5 U, {- W3 Y" g0 u, R4 h - // 该计算过程基本等同于:) V# G" S9 O1 Z
- // delta = delta_exec * NICE_0_LOAD / cur->load.weight;% w& D2 t" f7 S
- delta = __calc_delta(delta, NICE_0_LOAD, &se->load);
( F7 p/ ^( t2 u! ]9 s - return delta;0 y) ]# w" M$ q& d1 b) u
- }! @+ _2 {/ _; ^
$ e# B2 a5 G, N# g. {3 e5 K- static void update_min_vruntime(struct cfs_rq *cfs_rq)- e: b/ F) u8 b2 U5 Z$ s# M
- {
) |2 C* u" U1 u( \) o. S5 R - u64 vruntime = cfs_rq->min_vruntime;8 e" y3 }# w- y1 ]% Y( K
- if (cfs_rq->curr)# P, @4 W3 u! ]$ J4 ^
- // 如果此时有任务在运行,就更新最小运行时间为当前任务的 vruntime& c2 h; ]$ j- }
- vruntime = cfs_rq->curr->vruntime;. J' C* I% h' j K3 h5 A9 w
- if (cfs_rq->rb_leftmost)
( @, Y4 _ k! y& @: d! ?; W" W - {$ h1 {; I) H# S. K/ ?0 ]* M. f
- // 获得下一个要运行的调度单元
: h4 R6 m& u+ Y5 C: ~4 h - struct sched_entity *se = rb_entry(cfs_rq->rb_leftmost,. `" N- C3 _4 T2 b7 N! k$ _
- struct sched_entity,
$ D* S' v# f' D5 b3 e# L - run_node);! u; h! F ^1 ]( W& [9 {
- if (!cfs_rq->curr)! u) s$ `; e% r `' b" `
- vruntime = se->vruntime;
! [9 [& a- }& w5 Q - else
9 r( {( q: p% [# h0 } - // 保证 min_vruntime 是二者之间较小的那个值
2 C( u/ f, z0 W/ E - vruntime = min_vruntime(vruntime, se->vruntime);
3 G$ j0 T5 K6 q' ~+ P6 |5 Z - }! w6 E7 F7 }. G- P& C1 R
- # B, c0 Y. Y6 A( t' L- L
- // 这里之所以去二者之间的最大值,是为了保证 min_vruntime 能够单调增长4 F' f6 D5 {7 ~9 q R/ U
- // 可以想想为什么需要这样做?* R: N8 Z8 x7 A: r W0 [
- cfs_rq->min_vruntime = max_vruntime(cfs_rq->min_vruntime, vruntime);
& w5 H6 C: N& H# Y; G' I0 R5 n - }
7 R% M7 k, d7 t: @( m; u最后,来总结下使用虚拟时钟的意义:5 ~6 E9 n4 d* s2 @$ c8 n' m* U$ X
选择下一个任务: CFS 可以在红黑树中一直找到最左(leftmost)边的节点作为下一个运行的任务。但是真正实现 __pick_first_entity() 的函数其实并没有真正地执行查找(虽然可以在 O(log(N)) 时间内找到),我们可以看下它的定义(完整定义位于 <kernel/sched/fair.c>):% ?$ m2 o6 j4 p* `. t8 t
. Y7 q& i" [& n) i- struct sched_entity *__pick_first_entity(struct cfs_rq *cfs_rq), N: T: P0 ?5 T( E+ I1 t# O, @$ K
- {
; a+ ]6 [& A0 R8 Z4 b( _ - // 其实这里取的是缓存的 leftmost 节点$ m9 e$ g. f" `' S& F
- // 所以执行就会更快了" T- _6 Y% V& J" y
- struct rb_node *left = cfs_rq->rb_leftmost;6 @0 [/ f/ o1 _9 @6 _# E$ R& ^0 n
- if (!left)
) N Y' u' b( U - return NULL;) O$ E; }' a1 u% ]- @
- return rb_entry(left, struct sched_entity, run_node);% o! L3 K9 g1 G: N: r
- }
, r+ d- O' s7 `; G, E实时调度器: Linux 实时任务调度器实现位于 <kernel/sched/rt.c,对于系统而言,实时任务属于贵客,一旦存在实时任务需要调度,那就应当尽可能及时地为它们服务。对于实时任务而言,有两种调度策略存在: SCHED_FIFO: 这个其实就是一个先到先服务的调度算法。这类任务没有时间片限制,它们会一直运行直到阻塞或者主动放弃 CPU,亦或者被更高优先级的实时任务抢占。该类任务总会抢占 SCHED_NORMAL 任务。如果多个任务具有相同的优先级,那它们会以轮询的方式调度(也就是当一个任务完成后,会被放到队列尾部等待下次执行); SCHED_RR: 这种策略类似于 SCHED_FIFO,只是多了时间片限制。相同优先级的任务会以轮询的方式被调度,每个运行的任务都会一直运行,直到其用光自己的时间片,或者被更高优先级的任务抢占。当任务的时间片用光后,它会重新补充能量,并被加入到队列尾部。默认的时间片是 100ms,可以在 <include/linux/sched/rt.h> 找到其定义。
* G- z/ U& E- K0 O7 `9 B* ^. C
0 o% Q! l( Z2 ^7 U: U
实时任务的优先级是静态的,不会像之前提到的算法,会重新计算任务优先级。用户可以通过 chrt 命令更改任务优先级。 , B8 W0 V. r& x3 A) h" P& v5 Z" D
实现细节: 实时任务有自己的调度单元数据结构(位于 <include/linux/sched.h>),其定义如下:
' A+ g p k2 [- K; P# C
* D4 X( t5 C4 _! e& t# H- struct sched_rt_entity: u$ m1 h0 f. F( x% T# N8 |
- {4 f x" J( G: k3 {
- struct list_head run_list;4 x# p8 y2 K! @; F0 S5 @$ \ j
- unsigned long timeout;. {& r% G& y' e9 H% F
- unsigned long watchdog_stamp;: g( e, P& M0 k* d. U! D5 M
- unsigned int time_slice;$ J6 g; _" F O) V. n
- struct sched_rt_entity *back;# F2 w7 `# N! V
- struct sched_rt_entity *parent;0 i0 C7 Y) t3 Y# E+ U" T5 t! s
- /* rq on which this entity is (to be) queued: */4 w8 Z! ]. ]% ?$ C
- struct rt_rq *rt_rq;
# |) p" N3 U$ O. e0 v4 i: T6 h - };
* L# F5 x6 G! E) o$ ~3 K6 S5 nSCHED_FIFO 的时间片是 0,可以在 <kernel/sched/rt.c> 中看到具体定义: - ! C* s( p# [1 e; w$ A- i
- int sched_rr_timeslice = RR_TIMESLICE;
3 L- X/ w" ?0 H1 c - static unsigned int get_rr_interval_rt(struct rq *rq,
/ p% p0 V& P7 Q" e, u1 M; ?- e - struct task_struct *task), P4 G& X) X! Z4 S. N- b0 b
- {
+ i, j" p* U# H# A7 q: u6 M3 l9 r" W - if (task->policy == SCHED_RR)" {: b" Y- n$ |: d j1 j
- return sched_rr_timeslice;
6 j7 B( t5 l( V7 w o0 `/ W. Q - else+ _( M! J% Z" E; k2 Q& E
- return 0;. b- i# T* O3 V8 q- D( D! N
- }
- / O# U) c9 M' k
- /* Real-Time classes' related field in a runqueue: */
: U4 |5 E& V* T0 U" M0 j - struct rt_rq
$ [# G* p g- s( Y* e5 I; \2 q - {
+ w0 u5 J4 J2 u+ G - // 所有相同优先级的实时任务都保存在 `active.queue[prio]` 链表中$ p* g, u( C, s( V7 L3 v
- struct rt_prio_array active;- S' M+ r8 C* k1 c% L
- unsigned int rt_nr_running;
; _) w) b; p, K3 n4 q - struct rq *rq; /* main runqueue */
; m) ~% S8 C' M; J/ | N# j - };2 d, d* K r- p3 t+ h% v2 u7 L! v
% ^/ E8 E) r4 O2 s- /*
6 L" V# r! x' J1 x/ A& o) G. o - * This is the priority-queue data structure of the RT scheduling class:
* X2 k! x* T5 @. }) j3 ^; Z k8 f - */7 c% y7 z$ ^: l* F- E1 j, A
- struct rt_prio_array8 f- v9 l7 f- t
- {
4 @# ?1 h4 x; a9 r - /* include 1 bit for delimiter */& e* G6 X, V3 v1 g1 ~
- // 类似 O(1) 调度器,使用位图来标记对应优先级的链表是否为空! ]+ n4 P) z+ q, J
- DECLARE_BITMAP(bitmap, MAX_RT_PRIO + 1);2 C, S" \7 B+ n V( p9 v- ^" s; m
- struct list_head queue[MAX_RT_PRIO];0 i% Q3 c# m7 z
- };
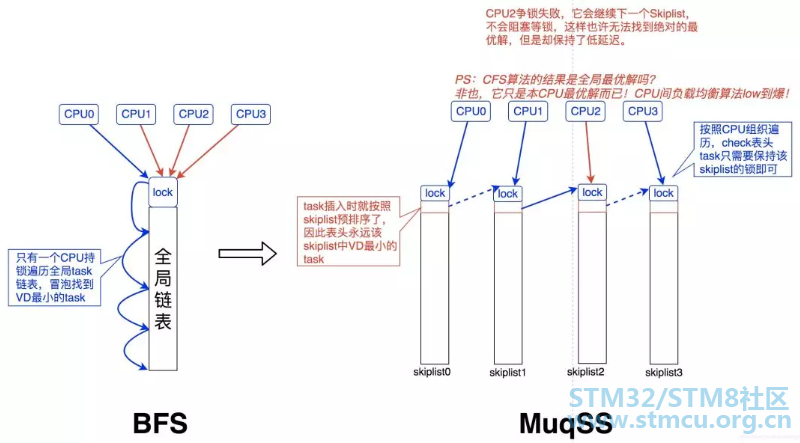
BFS & MuqSS调度器:总体来说,BFS 是一个适用于桌面或移动设备的调度器,设计地比较简洁,用于改善桌面应用的交互性,减小响应时间,提升用户体验。它采用了全局单任务队列设计,不再让每个 CPU 都有独立的运行队列。虽然使用单个全局队列,需要引入队列锁来保证并发安全性,但是对于桌面系统而言,处理器通常都比较少,锁的开销基本可以忽略。BFS 每次会在任务链表中选择具有最小 virtual deadline 的任务运行。
. ~0 I5 f3 y. u6 b
8 l! O3 z1 I8 ]MuqSS 是作者后来基于 BFS 改进的一款调度器,同样是用于桌面环境任务调度。它主要解决了 BFS 的两个问题:
* x$ Y' Q- `% C, {+ R5 @' t, r7 Y. i0 O4 E Q# s9 K& u6 H: x
4 d8 S' T+ x; V: }
|





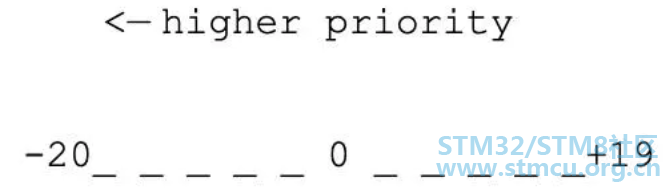
 微信公众号
 手机版


